


Python自动化测试脚本参数化设计:从Excel读取测试数据
深入讲解Python自动化测试中基于Excel的测试数据参数化设计,涵盖Excel用例表结构规范、openpyxl封装读取、pytest.mark.parametrize数据驱动结合及常见避坑要点。
一、数据驱动与参数化设计原理
传统的自动化测试脚本往往将请求参数、请求头以及断言阈值直接硬编码在测试函数中。这种方式在用例规模较小时看似简单直接,但一旦业务字段发生变更或需要覆盖大量同质化测试分支,维护成本将呈指数级上升。
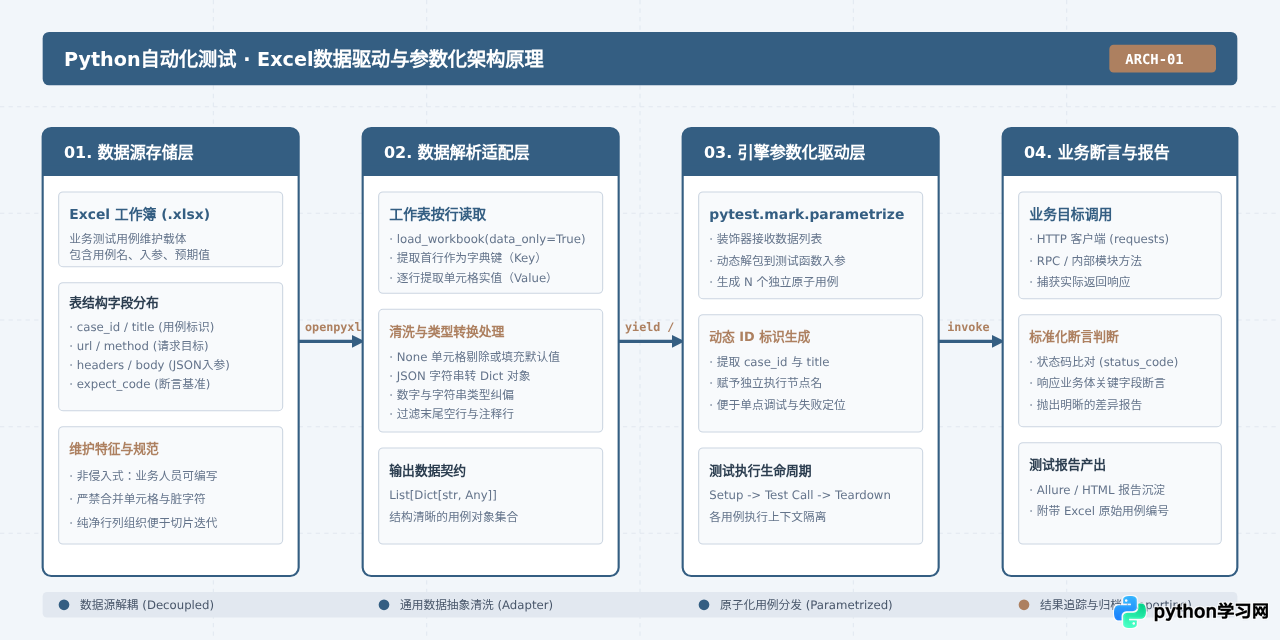
参数化设计(Data-Driven Testing,DDT)的核心理念是:一套测试逻辑,多组数据输入,分别独立运行并输出判定结果。测试框架将数据源视作外部配置,每次执行测试时循环提取单条用例数据,动态注入到测试函数的形参中。此时,自动化测试架构由四个清晰的层次构成:持久化数据源、数据适配解析器、测试执行引擎以及断言报告层。
二、Excel测试用例表结构规范设计
从 Excel 读取数据的前提是建立严格的数据契约。在工程实践中,测试表格式混乱是导致读取脚本崩溃的最常见根源。一个规范的接口测试数据表格应具备清晰的首行表头定义、明确的字段类型约束以及规范的缺省值规则。
| 字段列名 (Header) | 类型说明 | 是否必填 | 格式示例与填写说明 |
|---|---|---|---|
case_id |
字符串 / 整型 | 是 | 如 TC_USER_001,单工作表内唯一,用于生成 pytest 的 test id。 |
case_title |
字符串 | 是 | 如 正常手机号密码登录成功,简要阐明当前用例测试意图。 |
method |
字符串 | 是 | GET、POST、PUT、DELETE(建议大写)。 |
url |
字符串 | 是 | 如 /api/v1/login,支持相对路由或完整接口地址。 |
headers |
JSON 字符串 | 否 | 如 {"Content-Type": "application/json"},无特殊要求留空。 |
payload |
JSON 字符串 | 否 | 请求体内容,如 {"phone": "13800000000", "code": 1234}。 |
expected_status |
整型数值 | 是 | 如 200,对应 HTTP 响应状态码。 |
expected_code |
整型 / 字符串 | 否 | 如业务错误码 0 或 ERR_PARAM_INVALID。 |
None,破坏表格的矩阵规律。此外,JSON 字符串应采用合法的双引号("),避免中文全角引号导致解析失败。
三、参数化落地的标准实施流程
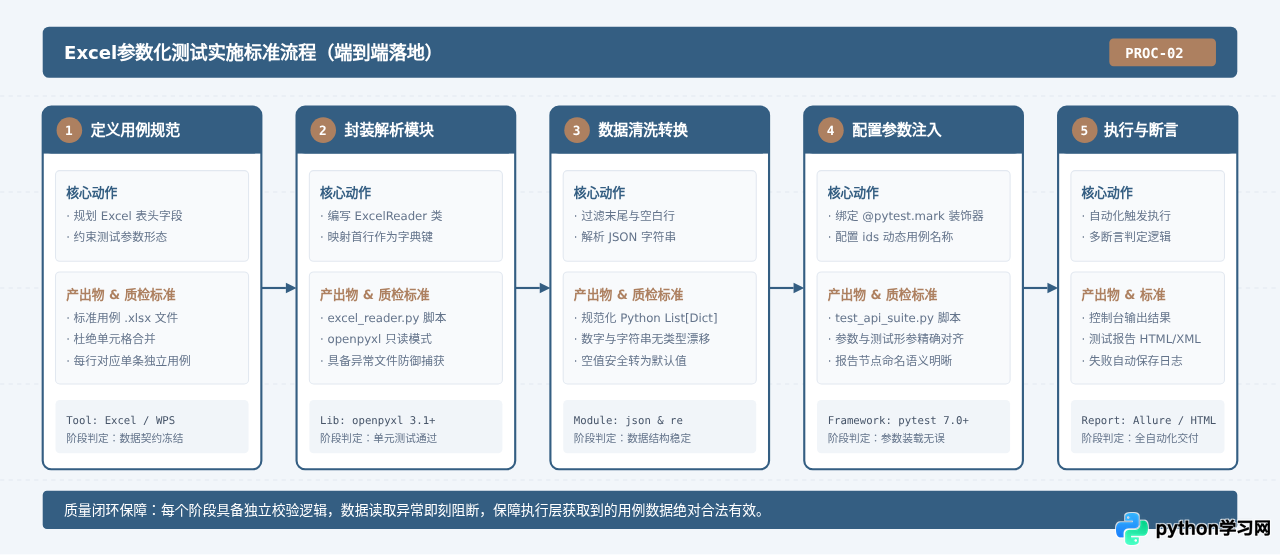
将 Excel 数据接入测试体系是一个标准的流水线过程。从创建工作簿到 pytest 控制台输出结果,整个工程实施流程可以划分为五个标准阶段。
四、封装 Excel 数据读取工具模块
Python 读取 Excel 的主流库包括 openpyxl、pandas 以及 xlrd。在自动化测试轻量级数据交互场景中,openpyxl 依靠纯 Python 实现、无复杂重量级依赖、全面支持 .xlsx 格式而成为行业首选。
为了保证通用性与健壮性,我们需要将读取逻辑封装为一个独立的 ExcelReader 工具类。该类应具备以下核心能力:
- 自动提取首行作为字典的键,后续每行数据映射为字典的值;
- 智能去除字符串前后的多余空格,避免不可见的空白字符干扰断言;
- 识别 JSON 格式字符串并自动反序列化为 Python 字典,免去在测试用例内部手动调用的繁琐;
- 跳过空行,防止在 Excel 末尾存在格式残留时产生脏用例。
以下为完整的封装代码示例:
# excel_reader.py
import json
import os
from openpyxl import load_workbook

class ExcelReader:
    """
    Excel 数据读取器:用于自动化测试用例数据驱动加载
    """
    def __init__(self, file_path: str, sheet_name: str = None):
        if not os.path.exists(file_path):
            raise FileNotFoundError(f"未找到指定的测试用例文件: {file_path}")
        self.file_path = file_path
        self.sheet_name = sheet_name

    def read_cases(self) -> list:
        """
        读取 Excel 指定工作表并转换为 List[dict] 结构
        """
        # data_only=True 确保读取公式单元格时获取计算后的最终数值而非公式文本
        wb = load_workbook(self.file_path, data_only=True)

        if self.sheet_name:
            if self.sheet_name not in wb.sheetnames:
                raise ValueError(f"工作表 '{self.sheet_name}' 不存在,当前可用: {wb.sheetnames}")
            sheet = wb[self.sheet_name]
        else:
            sheet = wb.active

        rows = list(sheet.iter_rows(values_only=True))
        if not rows:
            return []

        # 提取首行作为表头 keys,过滤 None
        headers = [str(cell).strip() if cell is not None else "" for cell in rows[0]]

        cases = []
        for row_idx, row in enumerate(rows[1:], start=2):
            # 过滤全空行
            if all(cell is None or str(cell).strip() == "" for cell in row):
                continue

            case_data = {}
            for col_idx, cell_value in enumerate(row):
                if col_idx >= len(headers):
                    break
                header_key = headers[col_idx]
                if not header_key:
                    continue

                # 数据预清洗
                cleaned_val = self._clean_value(cell_value)
                case_data[header_key] = cleaned_val

            cases.append(case_data)

        wb.close()
        return cases

    @staticmethod
    def _clean_value(val):
        """清洗单元格值:去除空格、转换 JSON 格式"""
        if val is None:
            return ""
        if isinstance(val, str):
            val = val.strip()
            # 尝试解析 JSON 格式(以 { 或 [ 开头)
            if (val.startswith("{") and val.endswith("}")) or (val.startswith("[") and val.endswith("]")):
                try:
                    return json.loads(val)
                except json.JSONDecodeError:
                    return val
        return val

if __name__ == "__main__":
    # 模块独立验证示例
    reader = ExcelReader("test_cases.xlsx")
    cases = reader.read_cases()
    print(f"成功加载用例总数: {len(cases)}")
    if cases:
        print(f"首条用例预览: {cases[0]}")
五、数据形态转换与映射机制
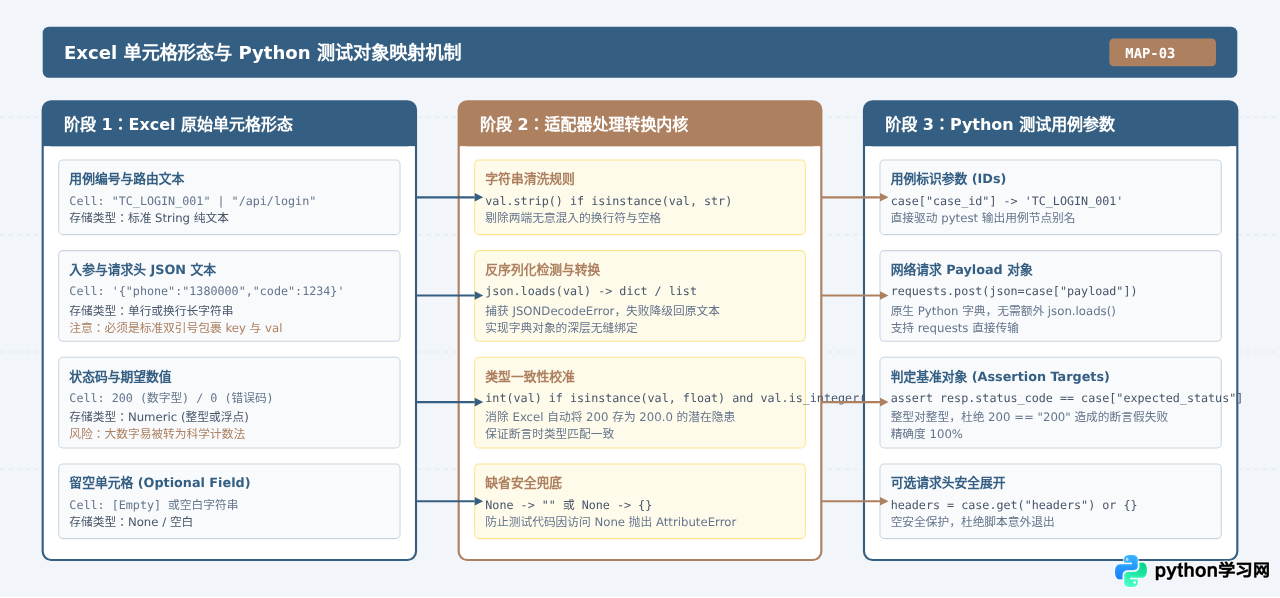
测试数据从 Excel 存储格式流向 Python 测试函数的过程中,会经历形态与内存结构的变化。正确理解这一映射机制,是规避类型错误(如长数字变浮点数、JSON 解析失败)的关键。
六、在 pytest 中实现参数化测试驱动
完成数据读取类的编写后,下一步是将数据接入测试脚本中。pytest 提供的 @pytest.mark.parametrize 是实现数据驱动的核心装饰器。
为了让测试报告中能够清晰展现每条用例的名称,而不是晦涩的 test_api[case0],建议使用 ids 参数动态提取用例标识。
# test_api_cases.py
import pytest
import requests
from excel_reader import ExcelReader

# 1. 预先加载 Excel 用例数据
BASE_URL = "https://api.example.com"
DATA_FILE = "test_cases.xlsx"

reader = ExcelReader(DATA_FILE, sheet_name="UserAuth")
case_list = reader.read_cases()

# 2. 构造动态用例标题生成器(使报告具有极高的可读性)
def generate_case_id(case_item):
    return f"{case_item.get('case_id')}-{case_item.get('case_title')}"

# 3. 参数化装饰测试函数
@pytest.mark.parametrize("case", case_list, ids=generate_case_id)
def test_user_api_suite(case):
    """
    通用接口自动化测试用例执行函数
    """
    # 提取请求要素
    method = case.get("method", "GET").upper()
    url = f"{BASE_URL}{case.get('url')}"
    headers = case.get("headers") or {}
    payload = case.get("payload") or {}
    expected_status = int(case.get("expected_status", 200))

    # 执行 HTTP 请求
    if method == "POST":
        response = requests.post(url, json=payload, headers=headers, timeout=5)
    elif method == "GET":
        response = requests.get(url, params=payload, headers=headers, timeout=5)
    elif method == "PUT":
        response = requests.put(url, json=payload, headers=headers, timeout=5)
    elif method == "DELETE":
        response = requests.delete(url, headers=headers, timeout=5)
    else:
        pytest.fail(f"不支持的 HTTP 请求方法: {method}")

    # 4. 执行业务断言
    # 断言 1:HTTP 状态码比对
    assert response.status_code == expected_status, (
        f"状态码不符!预期: {expected_status}, 实际: {response.status_code}, 响应体: {response.text}"
    )

    # 断言 2:可选业务错误码比对
    expected_code = case.get("expected_code")
    if expected_code != "":
        res_json = response.json()
        assert str(res_json.get("code")) == str(expected_code), (
            f"业务返回码不符!预期: {expected_code}, 实际: {res_json.get('code')}"
        )
执行命令与控制台输出示例
在终端中通过 pytest -v 命令执行上述脚本,pytest 会针对 Excel 中的每一行数据独立生成一条测试记录:
$ pytest -v test_api_cases.py

============================= test session starts ==============================
rootdir: /projects/qa-automation
collected 3 items

test_api_cases.py::test_user_api_suite[TC_USER_001-正常登录成功] PASSED   [ 33%]
test_api_cases.py::test_user_api_suite[TC_USER_002-密码错误登录失败] PASSED [ 66%]
test_api_cases.py::test_user_api_suite[TC_USER_003-手机号格式非法] PASSED   [100%]

============================== 3 passed in 0.42s ===============================
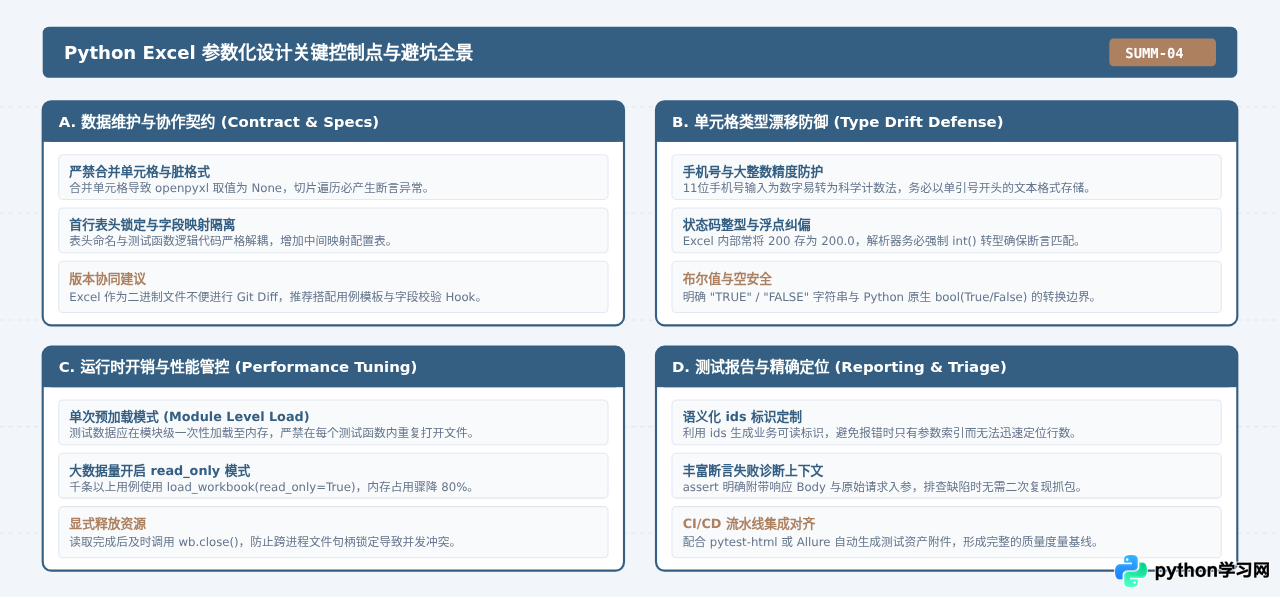
七、参数化设计核心控制点与工程避坑全景
在实际生产环境中,将测试框架与 Excel 结合使用时,往往会面临性能、稳定性与协作规范等挑战。以下总结四大核心控制要点,供架构选型与日常维护参考。
八、总结与技术选型建议
基于 Excel 的测试数据参数化是中小型团队践行数据驱动测试最为直观、协作门槛最低的实践路径。它通过表格形式降低了非技术人员参与编写用例的难度,同时利用 Python 强大的生态与 openpyxl 的灵活性,实现了用例逻辑与测试数据的清晰解耦。
在后续工程迭代中,如果团队用例规模达到数万条级别,或者需要频繁进行细粒度的并发版本控制与代码审阅,可以考虑平滑迁移至 YAML、JSON 或直接集成云端测试用例管理平台(如 TestRail、Jira)。但在大多数常规自动化测试项目中,严格遵循本文所述的表结构规范与读取适配流程,已经能够构建出一套高效、稳定且易于维护的自动化测试流水线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















