


Python获取文件名但不带扩展名的方法
详细讲解在Python中获取文件名但不带扩展名的实用方法,包括现代标准库pathlib.Path.stem、经典os.path.splitext方案、多重扩展名(如.tar.gz)与隐藏文件的边界处理及选型建议。
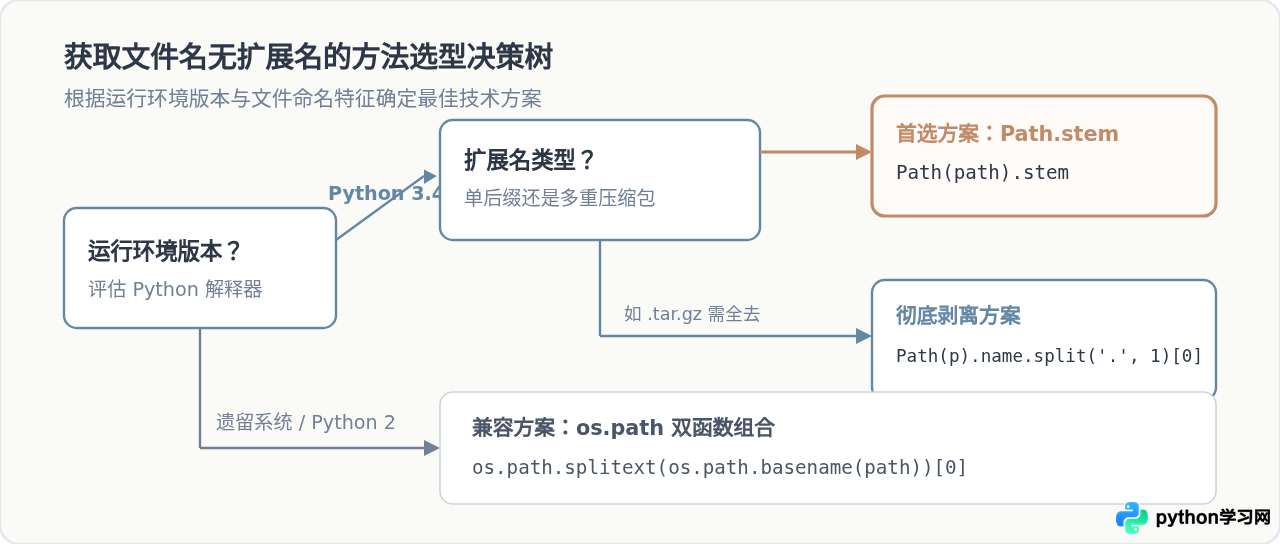
pathlib.Path(path).stem;而在需要兼容早期 Python 版本或延续经典路径操作时,使用 os.path.splitext(os.path.basename(path))[0] 是成熟稳健的方案。
在日常数据处理、自动化脚本或批量重命名任务中,经常需要从给定的完整文件路径中提取文件的纯名称。例如,将 /data/documents/annual_report_2026.xlsx 转换为 annual_report_2026,以便创建同名的输出目录、重构文件名或在数据库中建立索引记录。虽然可以通过字符串切割(如使用 split('.'))尝试解决,但在面对复杂路径或特殊字符时极易出错。下面系统解析 Python 中获取无扩展名文件名的规范方法与细节。
一、文件路径的组成结构与解析概念
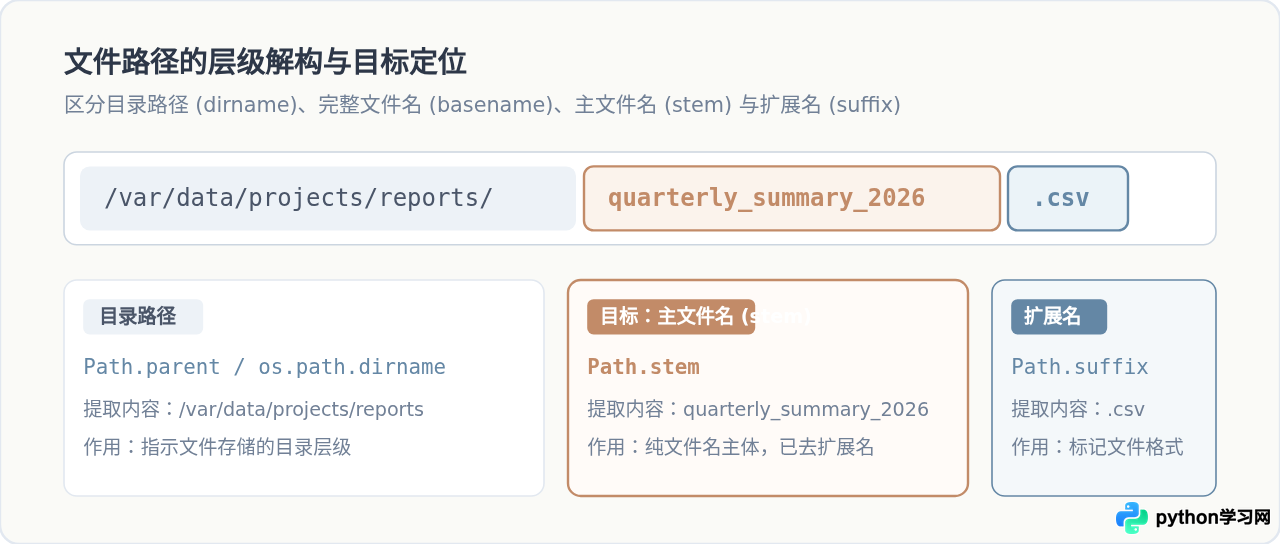
在操作文件路径前,理解路径的各段构成有助于准确选取处理工具。一个典型文件路径通常包含以下四个核心部分:
- 目录路径(dirname):文件所在的各级父文件夹路径。
- 基准文件名(basename / name):包含文件扩展名的完整文件名。
- 主文件名(stem / root):剥离了扩展名后的核心名称,即本文需要获取的目标。
- 扩展名(suffix / ext):从最右侧(或主要)点号开始的后缀部分。
二、使用 pathlib.Path.stem(现代 Python 首选方案)
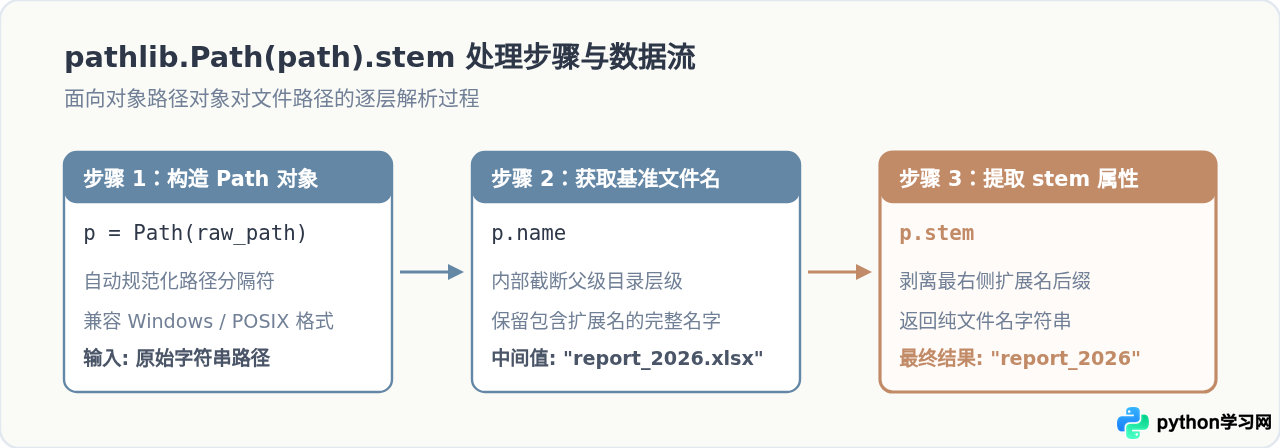
自 Python 3.4 开始引入的标准库 pathlib 提供了面向对象的路径操作方式。其中 Path 类的 .stem 属性专门用于返回文件的最终路径组件,并剥离掉扩展名。这种方式代码紧凑且具备良好的跨平台兼容性。
1. 基础用法示例
from pathlib import Path

# 传入完整绝对路径或相对路径
file_path = "/home/user/documents/report_2026.xlsx"
p = Path(file_path)

# 读取 stem 属性
file_name_without_ext = p.stem

print(file_name_without_ext)2. 原理解析与执行步骤
Path.stem 内部首先通过 .name 获取路径最底层的完整文件名(例如 report_2026.xlsx),随后在文件名内部查找最右侧的点号(.),将点号及其右边的部分剥离,返回左侧的核心名称。整个过程完全封装在对象属性访问中,无需手动编写分隔符处理逻辑。
三、使用 os.path 组合方案(经典传统方式)
在较旧的 Python 项目或完全以字符串流为主的代码中,使用 os.path 模块是另一种标准做法。需要注意的是,不能单独调用 os.path.splitext(),而必须将其与 os.path.basename() 配合使用。
1. 典型写法
import os

file_path = "/var/log/nginx/access_2026_03.log"

# 第一步:先提取带扩展名的基准文件名
base_name = os.path.basename(file_path)

# 第二步:切分文件名与扩展名,取第 0 个元素
file_name_without_ext = os.path.splitext(base_name)[0]

print(file_name_without_ext)os.path.splitext(file_path)[0],得到的结果是 "/var/log/nginx/access_2026_03",它依然包含前面的完整父目录。因此,必须先调用 os.path.basename() 剥离目录,或者对切分后的结果再做 basename 处理。
四、边界场景与复合扩展名处理
在实际工程中,文件命名可能会遇到多级扩展名、Unix 隐藏文件或无扩展名文件等情况。不同方法在处理这些边界情况时的表现各有特点。
1. 复合扩展名(如 .tar.gz / .tar.bz2)的处理
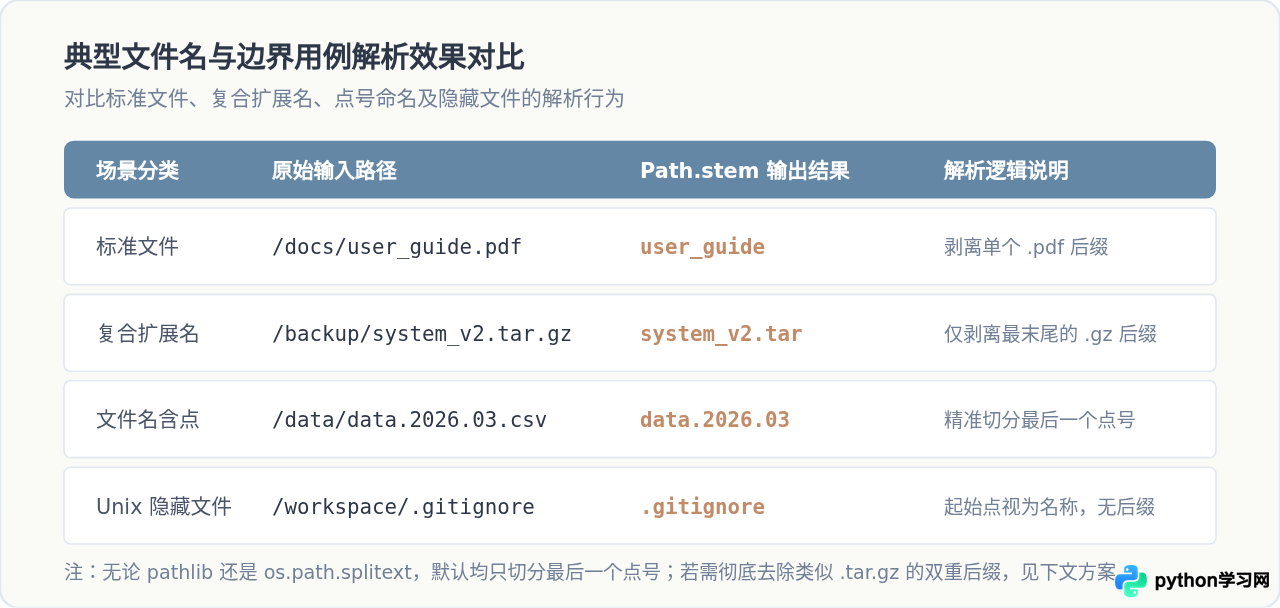
由于 Path.stem 和 os.path.splitext() 均遵循“仅剥离最后一个点号”的规则,对于 archive.tar.gz,单次调用得到的是 archive.tar。如果业务场景需要彻底剥离所有的扩展名以得到 archive,可以使用以下方案:
from pathlib import Path

file_path = "backup_2026.tar.gz"
p = Path(file_path)

# 方案 A:针对明确已知只有首段为名称的情况
clean_name = p.name.split('.', 1)[0]
print(clean_name)  # 输出: backup_2026

# 方案 B:利用 Path.suffixes 循环剥离,保持准确性
clean_stem = p.name
for ext in reversed(p.suffixes):
    clean_stem = clean_stem[:-len(ext)]
print(clean_stem)  # 输出: backup_2026
2. Unix 隐藏文件(如 .gitignore / .env)
在 Linux 和 macOS 环境中,以点号开头的文件表示隐藏文件。Python 的解析器能够识别这一规则:对于 .gitignore,Path.stem 返回完整的 .gitignore,并且 Path.suffix 为空字符串。这避免了将隐藏文件误判为“无文件名的纯后缀”。
3. 避免简单的字符串 split('.') 切割
初学者容易尝试使用 path.split('/')[-1].split('.')[0]。这种写法存在严重风险:一是 Windows 路径使用反斜杠 \ 会导致目录提取失败;二是如果文件名本身包含版本号或日期点号(如 dataset.v2.final.csv),直接以第一个点分割会导致主名称被错误截断为 dataset。
五、两种主流方法的对比与选型建议
为了在实际项目中做出合理的选择,下表对 pathlib.Path.stem 与 os.path.splitext 进行了全方位对比:
| 对比维度 | pathlib.Path.stem(推荐) | os.path.splitext + basename |
|---|---|---|
| 代码简洁度 | 极高(单行调用 Path(p).stem) |
中等(需嵌套调用两个函数) |
| 返回值类型 | 直接返回去除扩展名的纯字符串 | 返回元组,需要手动通过 [0] 切片 |
| 跨平台路径支持 | 原生自动处理不同系统的斜杠方向 | 依赖 os.sep,容易在跨系统路径时疏漏 |
| 链式调用能力 | 强(可方便结合 .parent、.with_suffix() 等) |
较弱(每次需要单独传参调用函数) |
| 版本要求 | Python 3.4 及以上(现代 Python 环境全支持) | 所有 Python 版本均支持 |
六、总结
获取文件名但不带扩展名是 Python 开发中的高频操作。总结核心结论如下:
- 首选方案:在现代 Python 项目中,优先使用
from pathlib import Path,通过Path(file_path).stem直接读取,代码语义清晰且避免了手动处理路径分隔符的繁琐。 - 传统兼容:如果受限于旧版本环境或需要与存量字符串函数库配合,使用
os.path.splitext(os.path.basename(file_path))[0],切记先剥离目录路径。 - 特殊格式:对于
.tar.gz等多重扩展名,明确业务是要保留次级扩展名(如.tar)还是全部剥离,根据需求配合split('.', 1)或Path.suffixes递归处理。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















