


TensorFlow和PyTorch哪个更适合初学者入门
对比TensorFlow与PyTorch在编程风格、调试难度、学习曲线和生态环境上的差异,为深度学习初学者提供切实明确的入门选择依据与学习路线。
一、核心机制差异:为什么学习体验截然不同
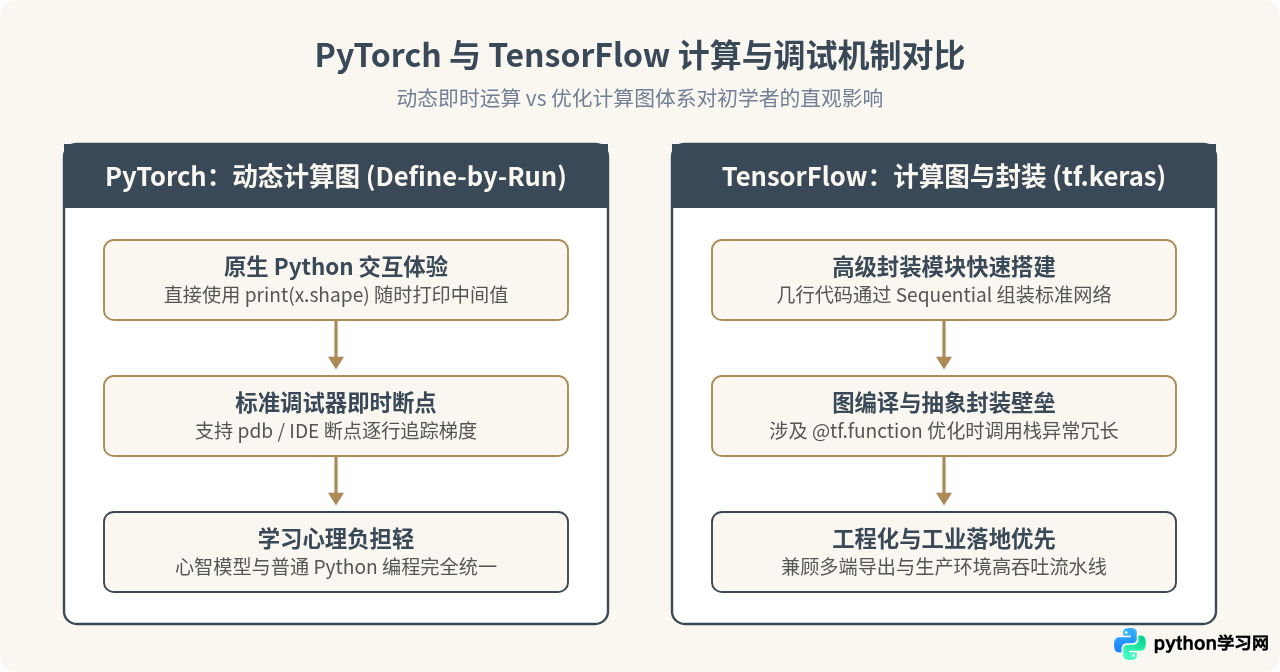
初学者在编写第一个神经网络时,最直观的体验来自于代码的执行机制与调试方式。TensorFlow 和 PyTorch 底层设计哲学的不同,直接决定了二者在编写与排错时的难度。
早期版本的 TensorFlow 采用静态图(Static Graph),要求先完整构建计算图结构再送入 Session 执行,调试极为抽象。尽管 TensorFlow 2.x 引入了 Eager Execution(即时执行),但其底层依旧保留了大量基于计算图优化和跟踪的机制;而 PyTorch 原生建立在动态计算图(Dynamic Graph / Define-by-Run)之上,代码运行到哪一步,计算图就动态构建到哪一步,张量的形状和数值可以直接打印出来查看。
二、代码风格对比:以全连接网络训练为例
为了直观感受二者的编写区别,我们以最常见的三层多层感知机(MLP)训练流程为例。初学者可以从语法逻辑中清晰看出两者在控制力与封装度上的倾向。
1. PyTorch 风格:明确透明的训练步
在 PyTorch 中,网络结构通过继承 torch.nn.Module 构建,前向传播与反向传播的每一步都必须在训练循环中明确写出:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 定义网络
class SimpleMLP(nn.Module):
    def __init__(self):
        super(SimpleMLP, self).__init__()
        self.fc = nn.Sequential(
            nn.Linear(28 * 28, 128),
            nn.ReLU(),
            nn.Linear(128, 10)
        )
    def forward(self, x):
        return self.fc(x)

model = SimpleMLP()
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)

# 2. 训练步 (单次迭代)
inputs = torch.randn(32, 28 * 28)
targets = torch.randint(0, 10, (32,))

optimizer.zero_grad()          # 梯度清零
outputs = model(inputs)        # 前向计算
loss = criterion(outputs, targets) # 损失计算
loss.backward()                # 反向传播求导
optimizer.step()               # 更新权重参数
这种写法的优势在于没有任何“黑盒”。初学者能清晰理解:先清空前一次累计的梯度,接着计算预测值与损失,再执行链式求导,最后让优化器更新参数。当张量形状不匹配时,Python 解释器会精准停在报错代码所在行。
2. TensorFlow (tf.keras) 风格:高阶集成与极简配置
TensorFlow 当前主推 tf.keras 接口,通常将编译、训练循环打包成高度封装的高层 API:
import tensorflow as tf
from tensorflow.keras import layers, models

# 1. 组装网络
model = models.Sequential([
    layers.Dense(128, activation='relu', input_shape=(28 * 28,)),
    layers.Dense(10)
])

# 2. 配置优化目标
model.compile(
    optimizer='sgd',
    loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
    metrics=['accuracy']
)

# 3. 极简训练
# model.fit(train_dataset, epochs=5)
使用 model.fit() 可以在几行内跑通训练,对于快速验证常见结构非常方便。但如果初学者想要在训练步骤中增加自定义逻辑(如对特定层加权、动态剪枝、自定义对抗损失),就需要重写 train_step 或使用 tf.GradientTape,复杂度会陡然上升。
三、初学者的核心考量维度
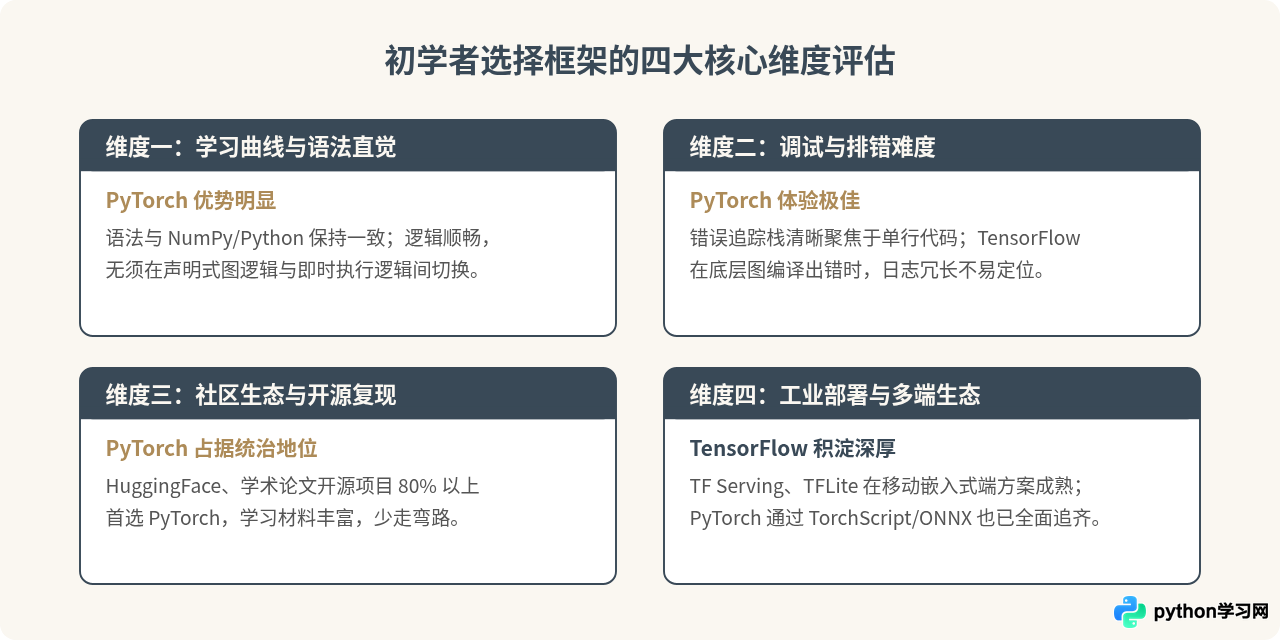
初学者面临的选择往往不是“哪个框架技术更强”,而是“哪种工具能让自己顺利学完基础而不半途弃坑”。我们可以从以下四个关键维度进行权衡:
四、初学者入门实操路径与推荐步骤
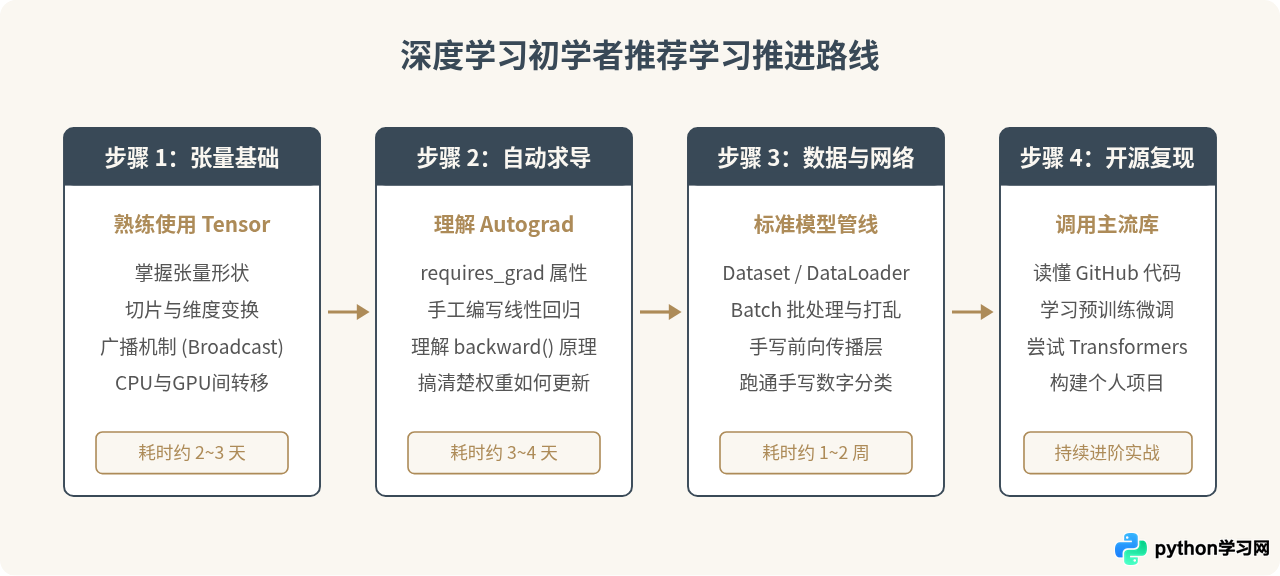
决定好方向后,初学者应采取科学的阶梯式学习策略,不要一上来就硬啃复杂的卷积神经网络(CNN)或大型语言模型(LLM),建议按以下四个递进步骤展开:
五、总结:哪类学习者该选哪一个
综上所述,TensorFlow 与 PyTorch 都是经过行业充分检验的工业级工具,二者之间不存在绝对的优劣,而是适应的场景阶段不同。初学者可以对照自身的目标情况快速作出选择:
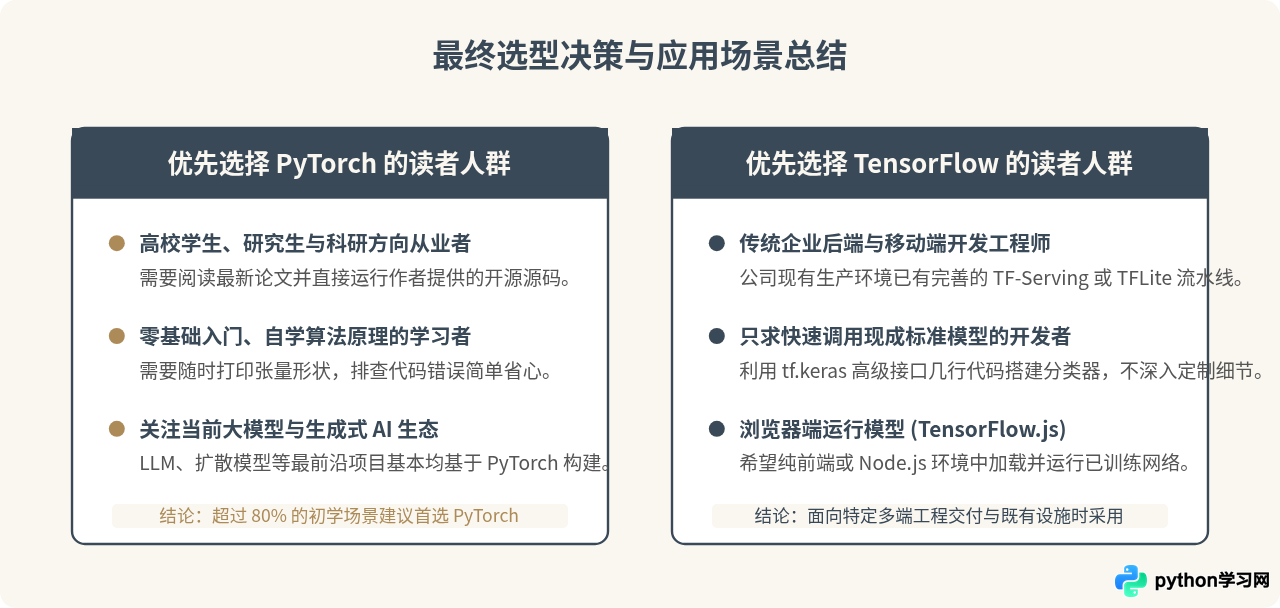
只要在一个框架中切实掌握了梯度下降、前向传播、损失函数和网络层构建的核心思想,日后若因工作要求切换到另一个框架,通常只需一到两周适应 API 差异即可。因此初学者不必担心“选错框架”,从阻力最小、排错最容易的 PyTorch 开始入手是当前最高效的路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















