


Python变量名可以用中文吗?Unicode标识符支持与兼容性风险
深入解析Python 3对中文变量名及Unicode标识符的原生支持机制(PEP 3131)、底层NFKC标准化原理、实测代码示例,以及在工程实践中面临的工具链、编码与协作兼容性风险。
核心答案非常直接:在 Python 3 中,变量名完全可以使用中文。 自 Python 3.0 正式引入 PEP 3131(Supporting Non-ASCII Identifiers)以来,Python 解释器在语法层面原生支持 Unicode 字符作为变量名、函数名和类名。然而,在真实工程与团队协作中,语法合法并不等同于工程可行。本文将从底层实现机制、语法检验方法、实际运行示例入手,全面解析中文标识符的运作原理,并客观剖析它在现代开发链条中引发的兼容性风险与适用边界。
一、底层机制:PEP 3131 与 Unicode NFKC 规范化
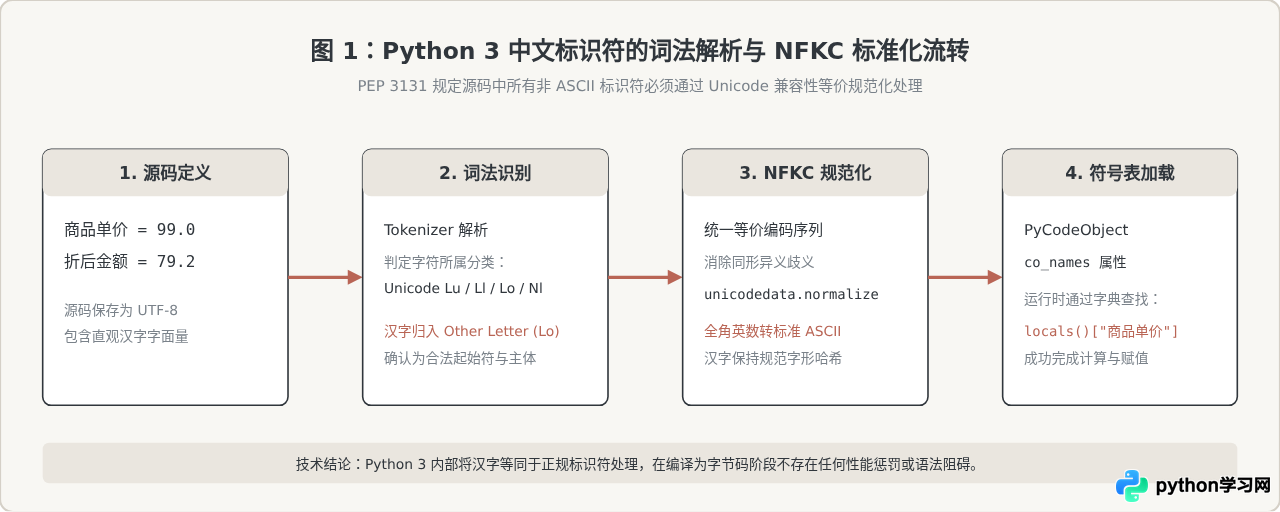
在 Python 2 时代,标识符被严格限制在 ASCII 字符集([a-zA-Z_][a-zA-Z0-9_]*)内。任何非 ASCII 字符作为变量名都会直接抛出 SyntaxError。而 Python 3 彻底改写了词法分析器,明确允许来自 Unicode 字符集中的特定类别字符作为变量名字符。
根据 PEP 3131 的规定,标识符的首字符必须属于 Unicode 字符分类中的“字母”(包含大部分汉字、希腊字母、西里尔字母等)或下划线;后续字符还可以包含数字或组合修饰标记。更关键的是,为了避免因 Unicode 存在同形异码字符而导致的逻辑混乱,Python 在解析所有标识符时,都会隐式调用 NFKC(Compatibility Decomposition followed by Canonical Composition) 标准化算法进行规范化转换。
二、实测验证:中文标识符的具体用法
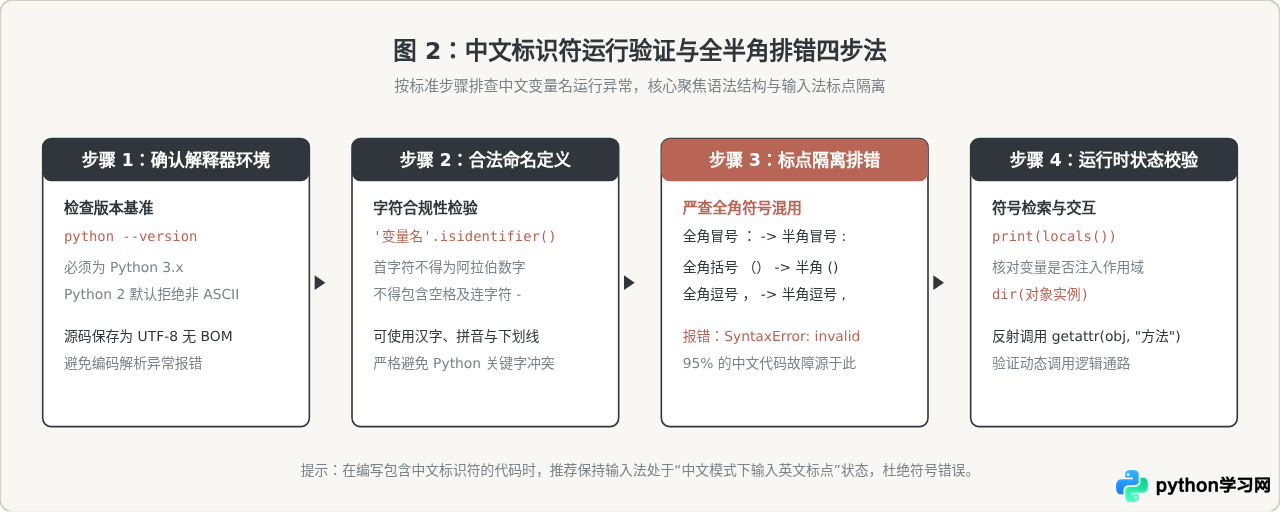
在 Python 3 中,我们可以像编写标准英文变量一样,在脚本中直接定义中文变量、中文函数、中文类,甚至是含有中文的异常处理逻辑。Python 内置的 str.isidentifier() 方法可以精准验证一个字符串是否符合当前解释器的合法标识符要求。
# 验证标识符合法性
print("用户名".isidentifier())     # 输出: True
print("订单_金额".isidentifier())   # 输出: True
print("2024年总计".isidentifier()) # 输出: False (不能以数字开头)
print("total-count".isidentifier())# 输出: False (减号不是合法标识符字符)

# 真实业务逻辑示例
class 银行账户:
    def __init__(self, 账户所有者: str, 初始余额: float = 0.0):
        self.账户所有者 = 账户所有者
        self.可用余额 = 初始余额

    def 存入资金(self, 金额: float) -> float:
        if 金额 <= 0:
            raise ValueError("存入金额必须大于零")
        self.可用余额 += 金额
        return self.可用余额

    def 查询状态(self) -> str:
        return f"户主 [{self.账户所有者}] 当前可用余额为: {self.可用余额:.2f} 元"

# 实例化与调用
张三账户 = 银行账户("张三", 1000.0)
张三账户.存入资金(500.0)
print(张三账户.查询状态())
# 终端正确输出: 户主 [张三] 当前可用余额为: 1500.00 元
上述代码在任意标准 Python 3.8+ 解释器上均可直接运行并正确输出。在运行时,张三账户.__dict__ 的键也是标准的 UTF-8 字符串 '账户所有者' 与 '可用余额',其行为与普通的英文字符串完全相同。
三、核心隐患:为什么生产环境极少使用中文变量名?
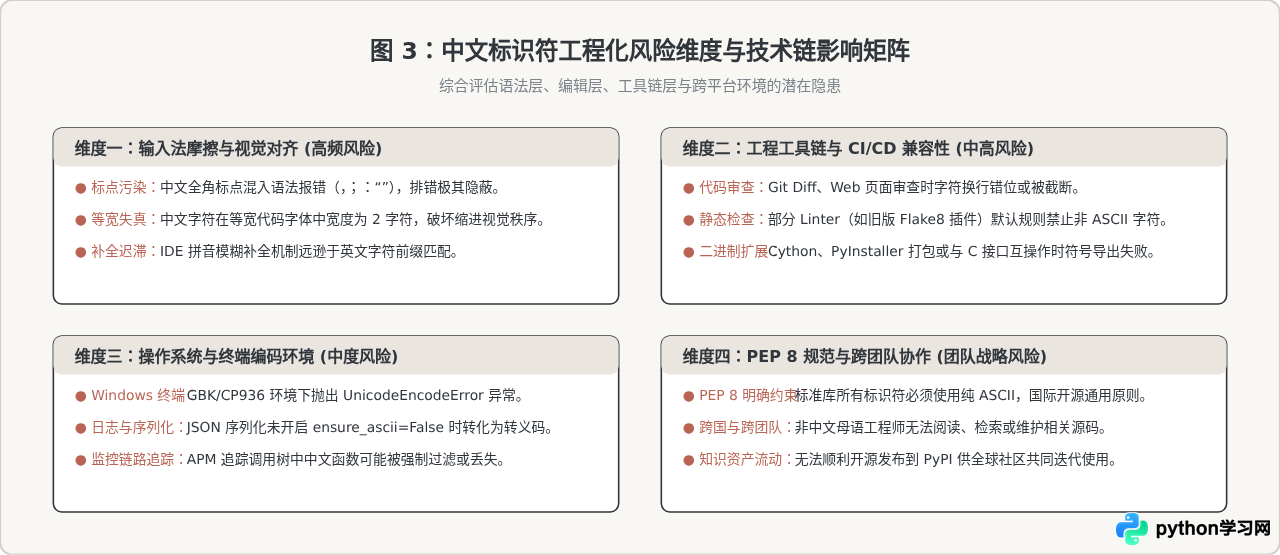
虽然语法支持无懈可击,但在工业级代码开发中,直接使用中文作为变量名却被普遍视作一种反模式(Anti-pattern)。这并非因为“崇洋偏好”,而是由整个现代软件工程技术栈的综合兼容性、输入效率与协作成本决定的。
1. 输入法频繁切换与全半角“隐形陷阱”
编程语言的主体结构由大量的标点符号构成(例如 :、=、(、)、[、]、"、'、.)。当使用中文命名时,开发者必须频繁在“中文输入态”与“英文符号态”之间切换。一旦不慎输入了中文全角标点(例如全角冒号 : 或全角逗号 ,),肉眼极难在编辑器中察觉,但在运行时会直接触发 SyntaxError: invalid character in identifier 语法异常。排查此类字符错误极其浪费时间。
2. 工具链支持参差不齐
现代 Python 开发高度依赖周边生态工具:
- 代码格式化工具(Formatter): 诸如 Black、Ruff 等格式化工具虽然支持 UTF-8,但针对等宽字体对齐(例如表格格式化、对齐等号)时,中文汉字占用两个英文字符宽度(East Asian Width),容易导致格式化后的缩进与对齐失真。
- 静态类型检查(Type Checkers): Mypy、Pyright 在绝大多数情况下能处理 Unicode,但在某些生成 stub 文件(
.pyi)或与 C/C++ 扩展(如 Cython、pybind11)绑定时,非 ASCII 符号容易引发编码断裂。 - 调试器与 Profiler: 某些轻量级调试工具、性能分析工具(如 cProfile)在向终端或 Web 界面导出调用图时,如果环境编码设置不是 UTF-8,中文函数名往往直接呈现为乱码或
\u4e2d\u6587转义串。
3. 操作系统控制台与日志编码差异
在 Linux 和 macOS 环境下,终端默认通常是 UTF-8,中文输出表现良好。但是在 Windows 操作系统的默认命令提示符(CMD)或部分企业内网服务器中,默认字符集可能仍是 GBK(代码页 CP936)。如果日志系统或监控探针(如 Sentry、Prometheus Exporter)在序列化未转义的中文属性名时发生编码冲突,可能导致监控指标丢失或日志写入阻塞。
四、什么场景下适合(或可以考虑)使用中文标识符?
尽管在常规后端服务、开源软件或核心底层库中严禁使用中文变量名,但这并不意味着中文标识符完全没有用武之地。在某些特定垂直领域,中文变量名能发挥极高的可读性价值:
1. 金融与财税领域特定计算规则(DSL / 规则引擎)
在复杂的税务政策核算、五险一金抵扣、精算模型中,政策条文本身完全由中文专业术语定义(例如“专项附加扣除”、“子女教育支出扣除”、“应纳税所得额”)。如果将这些术语硬性翻译成英文或拼音首字母缩写,不仅极其拗口,还会导致业务专家(财务/法务人员)无法直接审查代码。此时,直接以中文编写计算公式和规则函数,能够显著降低业务逻辑对齐成本。
2. 数据分析与教学演示
在 Jupyter Notebook、数据科学探索性分析(EDA)以及面向初学者的 Python 教学培训中,使用中文列名或中文变量能够消除语言壁垒,让学员把精力聚焦在算法逻辑、数组切片或模型训练本身,而非繁琐的英文单词记忆。
3. 自动化测试用例(BDD 行为驱动开发)
在编写自动化测试套件(如 Pytest)时,测试函数的名字通常很长,旨在描述具体的业务前置条件与预期行为。使用中文命名测试用例函数(例如 test_用户未实名认证时发起提现_应抛出权限异常()),不仅在测试报告(Allure / JUnit XML)中清晰明了,还能让产品经理与 QA 团队零门槛阅读测试资产。
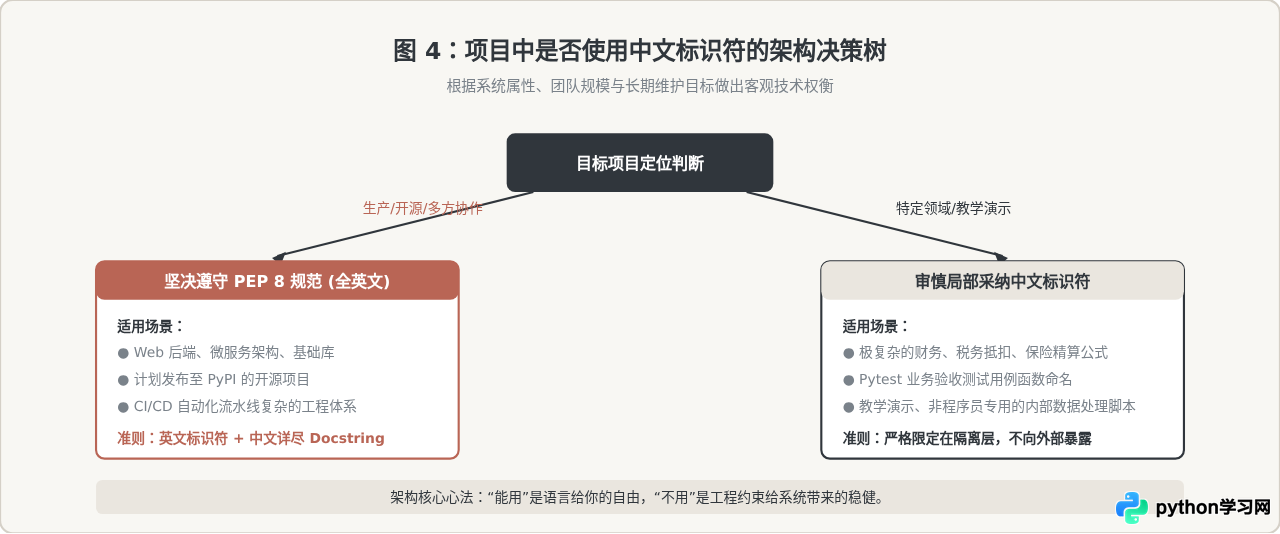
五、总结与最佳实践建议
回答“Python变量名可以用中文吗”,结论应当分为两个层面清晰审视:
- 语法层面:完全支持且合规。 Python 3 凭借 PEP 3131 和内置的 Unicode NFKC 处理能力,为非英文字符提供了与原生标识符平起平坐的法律地位。
- 工程层面:极力规避,保持克制。 全角输入法污染、等宽字形对齐破坏、周边工具链差异以及官方 PEP 8 规范的指引,构成了中文变量名难以进入生产代码的核心原因。
对于绝大多数项目而言,“严守英文标识符命名 + 使用详尽中文类型标注与文档注释(Docstrings)” 始终是最高效、最稳健、最符合工程直觉的黄金实践。如果确实在公式验证或测试用例中需要使用中文命名,请务必保证编辑器处于 UTF-8 编码,并严格核查全半角标点,确保代码安全平稳运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















