


Python自学遇到报错怎么办?高效利用社区与文档的技巧
针对Python自学者在遇到程序报错时的应对指南,详解Traceback堆栈定位、官方文档与本地内省工具查阅技巧、技术社区精准检索语法以及构建最小可复现代码的提问规范。
Python 自学过程中遇到程序中断和控制台红字报错是极其正常的现象。高效排错的核心并不在于盲目复制整屏信息去搜索引擎碰运气,而在于建立一条明确的解决路径:先通过 Python 的异常堆栈(Traceback)锁定触发源头与异常类型,再利用语言自带的内省机制与官方文档核对用法,若需寻求外部解答则借助结构化搜索语法精准筛选社区与仓库,并在必要时提炼出可以直接运行的最小可复现示例发起求助。
一、解读 Traceback 异常堆栈:第一现场的信息提取
当 Python 程序运行抛出未捕获的异常时,解释器会在终端输出详细的 Traceback(回溯追踪信息)。许多初学者因为看到大段英文字符产生畏难情绪,往往直接关掉终端或整段复制。实际上,Traceback 严格遵循调用栈自顶向下的执行顺序,其最后一行才是最关键的核心事实。
标准的 Traceback 通常由调用链条与终端错误总结两大部分构成。最底部的一行清晰地列出了“异常类名”以及“具体描述文本”。顺着错误向上看,上一行则指明了引发该错误的源文件路径、代码行号以及所在函数。排查时应当遵循“先看底行确定异常种类,再看倒数第二行定位代码行数”的逆序原则。
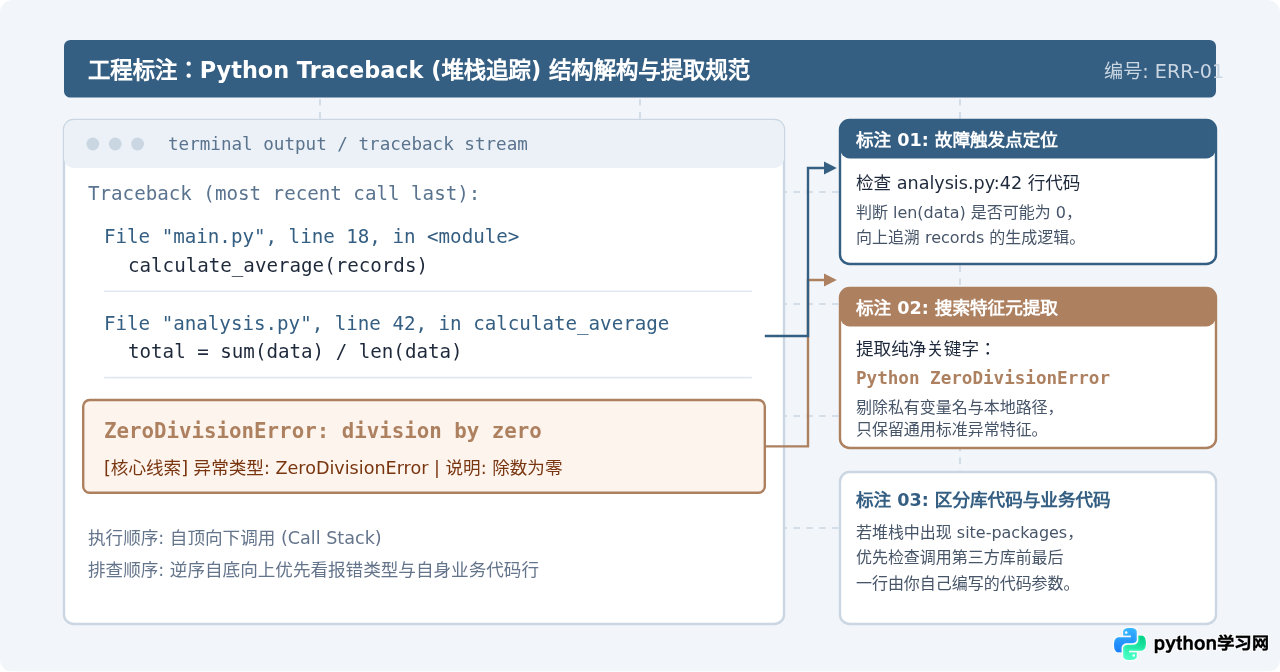
在提炼关键词时,务必过滤掉带有个人计算机环境特征的内容。例如 C:\Users\John\Desktop\my_script.py 或者 records 等自定义变量名不具备通用性。若将整段带本地私有路径的文本直接丢入搜索引擎,几乎无法匹配到有价值的结果。标准的关键词提取公式应为:Python版本 + [库名] + 异常类名 + 通用错误描述短语。
二、高效查阅官方与本地文档:验证事实与规避歧义
很多自学者在报错后习惯直接去第三方博客寻找现成代码,但第三方文章存在时效性过期或版本不兼容的问题。官方文档(Python Documentation)与库自带的 API Reference 才是最准确的技术事实来源。
查阅官方资源通常包含两个层次:一是无需联网的本地运行时自检,二是官方站点的标准手册查询。
1. 本地内省工具:快速确认对象类型与函数签名
在代码运行出错前或调试过程中,利用 Python 交互式命令行(REPL)自带的内省工具,可以瞬间弄清楚函数的预期入参以及对象的真实类型,避免因凭空猜测参数而引发 TypeError 或 AttributeError。
# 启动交互式环境验证未知对象的方法与文档
$ python3 -i
>>> import math
>>> dir(math)  # 查看模块内部导出的全部属性与函数名称
['__doc__', '__loader__', '__name__', 'acos', 'ceil', 'sqrt', ...]

>>> help(math.isclose)  # 查看具体函数的参数签名及说明文档
Help on built-in function isclose in module math:

isclose(a, b, *, rel_tol=1e-09, abs_tol=0.0)
    Determine whether two floating point numbers are close in value.
2. 官方文档结构化检索技巧
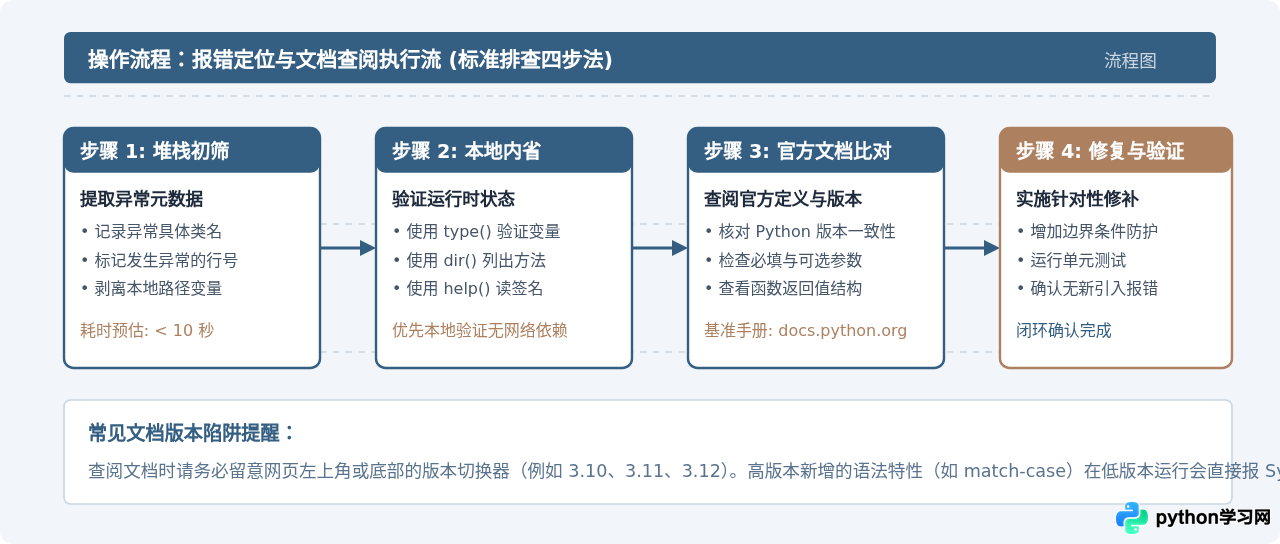
访问官方文档(例如 docs.python.org/zh-cn/3/)时,不要盲目浏览。针对常见问题,应善用以下固定入口:
- 库参考(Library Reference):查找标准库模块(如
json,os,datetime)的具体函数参数、默认值以及可能抛出的特定异常。 - 语言参考(Language Reference):当遇到缩进、作用域、运算符优先级等语法困惑时,查阅数据模型(Data Model)部分。
- 索引页(Global Module Index):若记不清模块全名,直接按字母索引快速检索。
三、精准利用技术社区:搜索语法与信息鉴别技巧
当确认代码语法与标准库用法无误,但因第三方库兼容性、系统平台差异或逻辑复杂性仍然报错时,转向技术社区是解决瓶颈的必然途径。然而,普通自然语言搜索往往返回大量重复、低质量甚至误导性的拷贝网页。熟练掌握专业社区的检索语法,能将查找效率提升数倍。
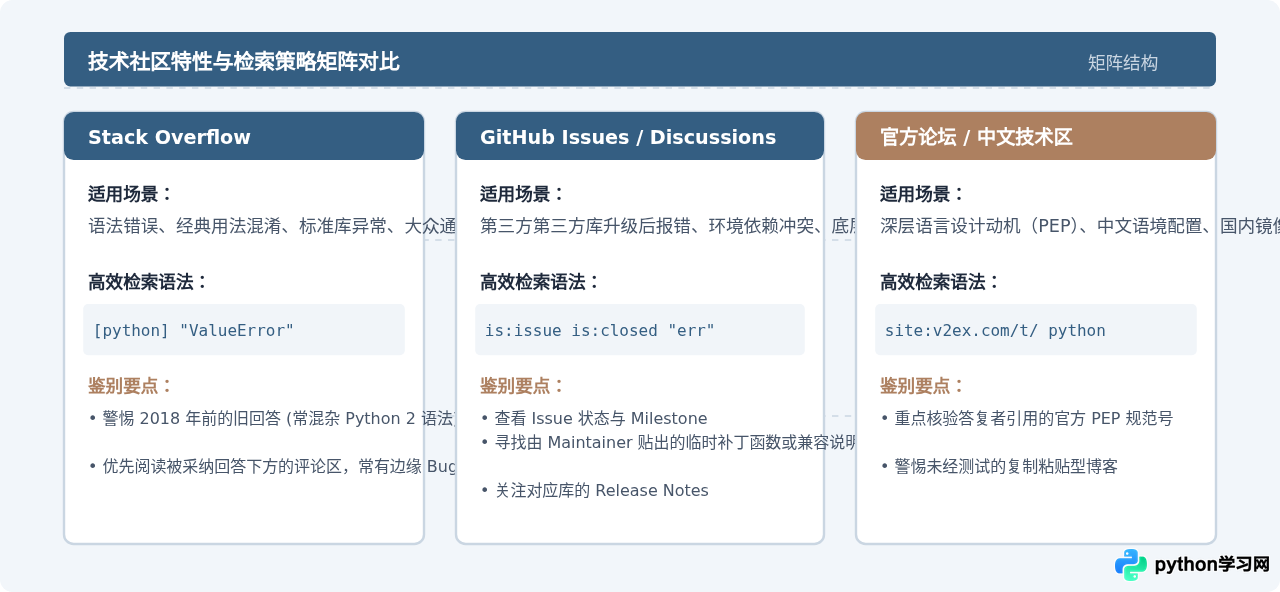
1. 针对核心社区的结构化搜索公式
在搜索引擎、Stack Overflow 或 GitHub 中检索时,建议配合布尔语法与限定标签:
- Stack Overflow 精确标签检索:在检索框中使用方括号限定技术栈。例如:
[python] [pandas] "KeyError: 'name'"。双引号强制精确匹配报错短语,方括号则把讨论范围锁定在指定库中。 - GitHub Issues 深度排查:对于活跃开源库(如 FastAPI、PyTorch、Requests),很多前沿报错往往是第三方库特定版本的新 Bug。在仓库的 Issues 栏目输入:
is:issue is:closed "exact error text"。检索已关闭(closed)的问题,可以直接找到官方团队打上的修复 commit 或维护者给出的临时规避建议(work-around)。 - 搜索引擎高级指令:利用
site:指令剔除垃圾内容农场。例如:site:stackoverflow.com python "json.decoder.JSONDecodeError"。
2. 社区答案的鉴别原则
搜到了看似匹配的答案,不要直接照抄并覆盖现有代码。执行前应完成三个自检:
- 时间有效性核验:Python 生态发展迅速,许多早年高赞回答基于 Python 2 或较早的库 API。例如旧版
pandas.DataFrame.append在现代版本中已被废弃并移除,如果照抄旧答案会引入新的AttributeError。 - 原理理解:先看答主的解说文字。回答是否解释了引发错误的根本机理?如果仅有一行粗暴的“把配置改成 True”或“加个 try-except pass 忽略掉”,往往只是掩盖了数据问题,而非真正修复。
- 代码干净程度:验证答复代码中是否含有多余的全局变量或不必要的额外依赖包。
四、构建“最小可复现示例”:终极求助技能
当现有资料无法解决你的问题,必须在论坛或社区发帖求助时,提问的质量直接决定了你能否获得专业开发者的解答。直接贴出手机拍摄的屏幕模糊照片、或者丢出几百行充满业务数据的混乱代码,通常会被社区直接忽略或关闭(Marked as Closed)。
获取高水准解答的关键是提供最小可复现示例(Minimal, Reproducible Example,简称 MRE)。MRE 必须满足四个严格标准:
- 最小化(Minimal):剔除所有与报错无关的辅助逻辑。删去复杂的数据库连接、外部网络请求、界面布局代码,仅保留能触发报错的核心骨架。
- 完整且独立(Complete):代码必须是自包含的。其他人在新机器上复制这段代码后,无需从你的电脑获取本地文件(如
D:\data.xlsx),可直接复制并运行。 - 能稳定复现(Reproducible):执行该示例代码时,必定能精确产生与你所见完全一致的异常堆栈。
- 环境交代明确:附带当前运行的 Python 准确版本(如 3.11.4)、操作系统类型以及相关依赖库的精确版本号。
# 【反面教材】:依赖本地文件、包含大量无关业务逻辑,他人无法运行复现
import pandas as pd
import requests

def parse_my_excel():
    df = pd.read_excel('C:/Users/test/my_secret_sales.xlsx')  # 依赖本地私有文件
    # 此处省略 200 行复杂的企业数据过滤与网络同步...
    res = df.groupby('store_id')['revenue'].mean()
    print(res['unknown_key'])  # 报错 KeyError

# -------------------------------------------------------------
# 【规范做法(MRE)】:自包含、无私有文件、他人一秒即可粘贴复现
import pandas as pd

# 使用内置字典构建最小测试数据框,直接重现 KeyError
data = pd.DataFrame({'store_id': [1, 1, 2], 'revenue': [100, 200, 300]})
grouped = data.groupby('store_id')['revenue'].mean()

# 目标:想要通过键名访问,但运行抛出 KeyError: 'unknown_key'
print(grouped['unknown_key'])

# 附运行环境信息:
# Python: 3.11.2 | pandas: 2.0.3 | OS: Ubuntu 22.04 LTS
很多时候,当你耐心地把大段业务代码逐步削减、提炼成仅有五六行的最小示例时,导致报错的真实原因往往就已经暴露出来了。这种剥离过程本身就是极其高效的调试手段。
五、全流程闭环总结与排错习惯养成
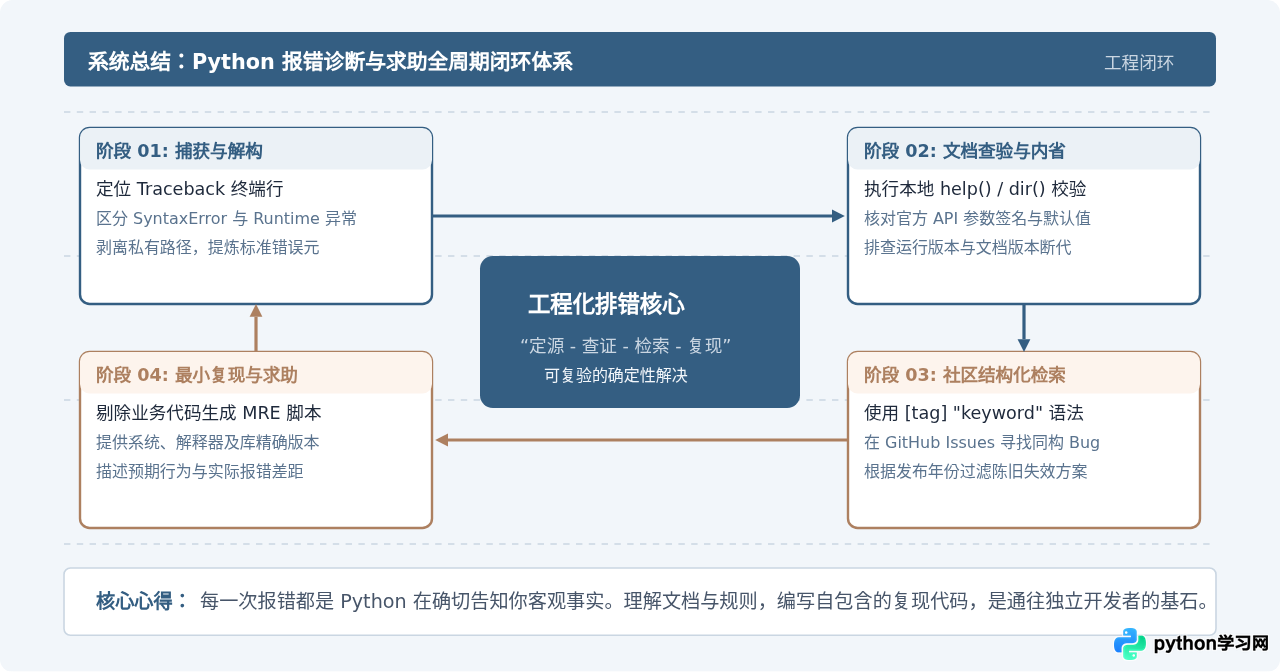
将零散的排查操作内化为条件反射,需要一套标准的工程化闭环思维。遇到报错时,不慌乱、不盲目猜解,按照科学的闭环流程依次推演,自学之路就会从被动应付转变为主动积累认知。
- 杜绝盲目重装:一遇到报错就卸载 Python 或 IDE 是最不可取的做法,环境重装通常无法解决逻辑与语法层面的错误。
- 慎用万能捕获:尽量不要使用裸
except: pass来吞掉异常。掩盖报错会让程序在后续环节发生更难以推断的数据污染。 - 养成调试记录习惯:将遇到的典型 Traceback 以及对应的文档链接、有效解决方案记录在个人笔记中,形成专属于自己的高频排错速查库。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















