


Python批量翻译英文:多线程与异步请求优化指南
系统介绍如何使用Python对海量英文文本进行批量翻译优化,对比ThreadPoolExecutor多线程与asyncio异步协程的执行机制,并提供请求批处理、并发信号量限流、指数退避重试及完整实现代码。
在面对大量英文文档、本地化条目或数据抓取内容的翻译任务时,单线程顺序调用翻译接口往往会导致长达数小时的低效等待。翻译任务的本质是典型的网络 I/O 密集型工作,程序的大部分时间都在空等远端 API 返回响应。通过合理运用多线程(ThreadPoolExecutor)或异步协程(asyncio + httpx),并结合文本打包批处理、并发信号量限制与动态退避重试,能够使网络吞吐效率提升十倍至数十倍,同时规避服务端的频控封禁。本文将从执行机制对比、具体代码实现及工程防护三个维度,详细讲解批量翻译场景下的优化方案。
一、为什么批量翻译极度依赖并发优化?
假设我们有 10,000 条英文句子需要调用翻译 API,每次网络往返平均耗时 200 毫秒:
- 单线程顺序执行:耗时 = 10,000 × 0.2 秒 = 2,000 秒(约 33.3 分钟)。在这半个多小时里,CPU 实际占用率不到 1%,99% 以上的时间都在等待网络套接字返回数据。
- 并发优化执行(以 30 并发为例):耗时可压缩至 1 分钟左右。如果再将多条短句打包成单次批量请求,整体开销还能进一步降低 60% 以上。
然而,盲目创建成百上千个线程或不加节制地发射请求,会立刻引发服务端 429 Too Many Requests(频控超限)、本地内存暴涨或连接超时崩溃。因此,高质量的批量翻译方案必须在并发吞吐量与服务配额限制之间取得平衡。
二、多线程与异步协程的机制对比与选型
Python 提供了两种主要的高并发网络 I/O 处理方案:标准库中的多线程池(concurrent.futures.ThreadPoolExecutor)以及基于事件循环的异步编程(asyncio)。两者的工作原理与适用场景存在明确差异:
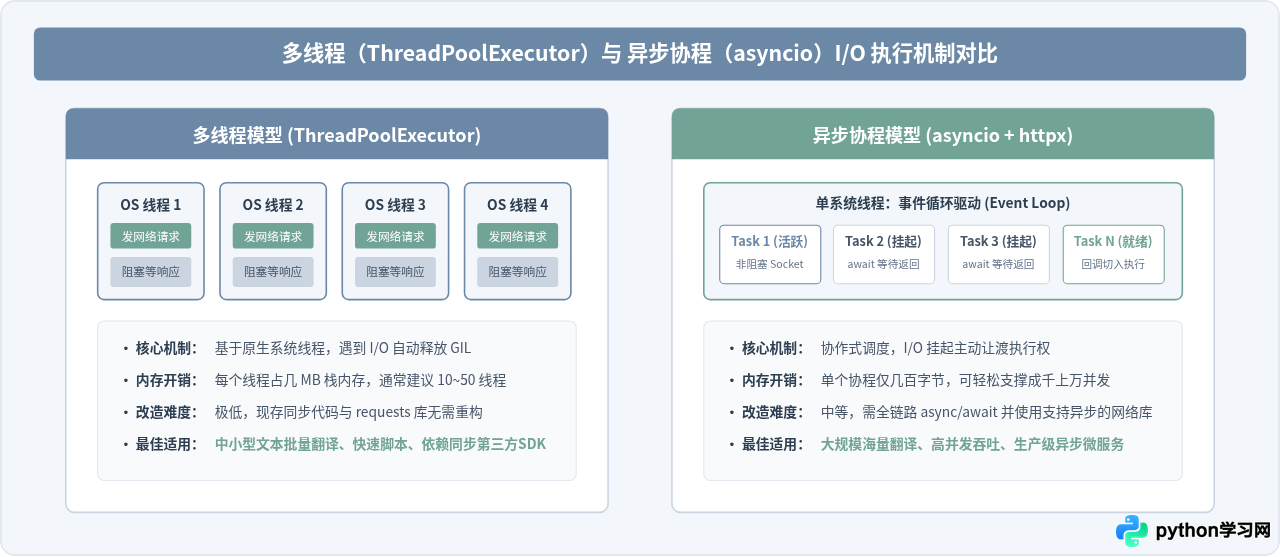
| 对比维度 | 多线程 (ThreadPoolExecutor) | 异步协程 (asyncio + httpx) |
|---|---|---|
| 并发量级 | 推荐 10 ~ 50(受操作系统线程与栈内存制约) | 可达 100 ~ 1,000+(仅受网络带宽与远端限流制约) |
| 代码复杂度 | 代码简单,直接将单条翻译函数提交至线程池 | 需编写 async/await 语法,并注意协程间上下文隔离 |
| 底层网络库 | 配合 requests.Session 复用 TCP 连接 |
使用 httpx.AsyncClient 或 aiohttp.ClientSession |
| 保序难度 | executor.map 自带保序;as_completed 需手动带索引 |
asyncio.gather 自带严格按输入列表保序 |
三、方案一:使用 ThreadPoolExecutor 进行多线程批量翻译
多线程非常适合不想重写原有同步业务逻辑的场景。为了让多线程发挥最大威力,有两点至关重要:
- 必须复用 HTTP 连接:切忌在线程内部每次都新建一个
requests.post,这会导致高频 TCP 握手甚至端口耗尽。应为所有线程共享一个配置了连接池大小的requests.Session()。 - 保持结果严格有序:翻译文本通常对应原始文件行号,必须保证译文与原文序号一一对应。
import time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry
from concurrent.futures import ThreadPoolExecutor, as_completed

def create_shared_session(max_workers: int) -> requests.Session:
    """创建带重试和连接池复用的共享 Session"""
    session = requests.Session()
    # 连接池大小必须大于等于工作线程数,避免线程排队等待空闲连接
    adapter = HTTPAdapter(
        pool_connections=max_workers,
        pool_maxsize=max_workers * 2,
        max_retries=Retry(
            total=3,
            backoff_factor=0.5,
            status_forcelist=[429, 500, 502, 503, 504],
            raise_on_status=False
        )
    )
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    return session

def translate_single_text(index: int, text: str, session: requests.Session) -> tuple[int, str]:
    """单条翻译工作单元:返回元组 (原始序号, 翻译结果) 保障保序"""
    api_url = "https://api.example-translate.com/v1/translate"
    payload = {
        "text": text,
        "source_lang": "EN",
        "target_lang": "ZH"
    }
    headers = {"Authorization": "Bearer YOUR_API_KEY"}

    try:
        response = session.post(api_url, json=payload, headers=headers, timeout=10)
        if response.status_code == 200:
            translated = response.json().get("result", "")
            return (index, translated)
        else:
            # 记录失败状态,避免整个批次崩溃
            return (index, f"[ERROR_{response.status_code}]")
    except Exception as exc:
        return (index, f"[EXCEPTION: {str(exc)}]")

def batch_translate_threads(texts: list[str], max_workers: int = 16) -> list[str]:
    """多线程批量翻译入口函数"""
    session = create_shared_session(max_workers)
    results = [None] * len(texts)

    start_time = time.time()
    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 提交所有任务,记录 future 到原始 index 的映射
        future_map = {
            executor.submit(translate_single_text, idx, text, session): idx
            for idx, text in enumerate(texts)
        }

        for future in as_completed(future_map):
            idx, translated_text = future.result()
            results[idx] = translated_text

    duration = time.time() - start_time
    print(f"多线程处理完毕: 共 {len(texts)} 条,耗时 {duration:.2f} 秒")
    return results

# 运行示例(供测试):
if __name__ == "__main__":
    sample_texts = [
        "Concurrent execution speeds up translation.",
        "Network latency is the main bottleneck.",
        "Always handle rate limiting carefully."
    ]
    # output = batch_translate_threads(sample_texts, max_workers=4)
四、方案二:基于 asyncio + httpx 的异步高并发翻译
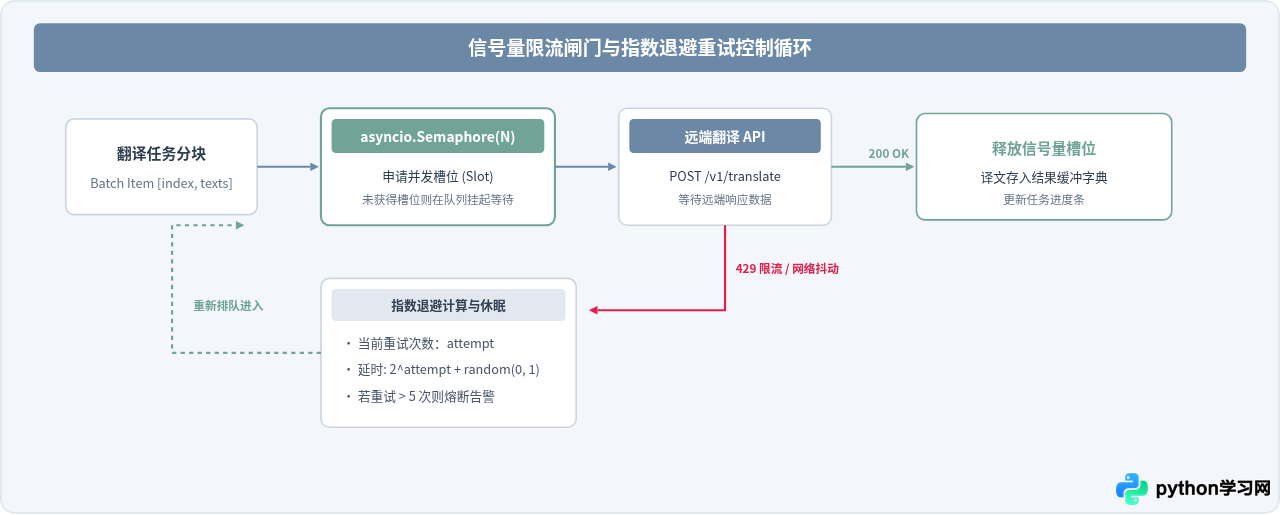
当待翻译量级达到数万条甚至数十万条时,异步协程是吞吐上限最高的选择。协程开销微乎其微,但如果不加节制,asyncio.gather 会在瞬间产生数千个请求,立即把远端 API 压瘫或招致 IP 封禁。
因此,异步翻译必须使用 asyncio.Semaphore(信号量)作为并发门禁,将同时处于活跃状态的请求数严格锁定在设定的安全阈值内。
import asyncio
import httpx
import time
from typing import List

async def translate_item(
    index: int,
    text: str,
    client: httpx.AsyncClient,
    semaphore: asyncio.Semaphore,
    max_retries: int = 3
) -> tuple[int, str]:
    """单条异步翻译协程:通过信号量受控执行与退避重试"""
    api_url = "https://api.example-translate.com/v1/translate"
    payload = {"text": text, "source_lang": "EN", "target_lang": "ZH"}
    headers = {"Authorization": "Bearer YOUR_API_KEY"}

    # 在进入信号量保护区前排队,确保最多只有 N 个请求同时在网络上飞行
    async with semaphore:
        for attempt in range(max_retries):
            try:
                response = await client.post(api_url, json=payload, headers=headers, timeout=12.0)

                # 触发 429 限流时进行指数退避
                if response.status_code == 429:
                    retry_after = float(response.headers.get("Retry-After", 2 ** attempt))
                    await asyncio.sleep(retry_after)
                    continue

                response.raise_for_status()
                data = response.json()
                return (index, data.get("result", ""))

            except (httpx.RequestError, httpx.HTTPStatusError) as e:
                if attempt == max_retries - 1:
                    return (index, f"[FAILED: {str(e)}]")
                await asyncio.sleep(1.5 ** attempt)

    return (index, "[UNKNOWN_ERROR]")

async def batch_translate_async(texts: List[str], max_concurrency: int = 30) -> List[str]:
    """异步批量翻译入口"""
    # 限制并发连接数与信号量窗口
    semaphore = asyncio.Semaphore(max_concurrency)
    limits = httpx.Limits(max_keepalive_connections=max_concurrency, max_connections=max_concurrency * 2)

    async with httpx.AsyncClient(limits=limits) as client:
        # 创建所有翻译任务
        tasks = [
            translate_item(idx, text, client, semaphore)
            for idx, text in enumerate(texts)
        ]
        # asyncio.gather 严格按传入 tasks 的顺序收集返回列表
        raw_results = await asyncio.gather(*tasks)

    # 按原始索引排序确保无缝保序
    raw_results.sort(key=lambda item: item[0])
    return [item[1] for item in raw_results]

# 运行示例(供测试):
# if __name__ == "__main__":
#     texts = ["Asyncio provides lightweight concurrency."] * 50
#     results = asyncio.run(batch_translate_async(texts, max_concurrency=20))
五、全流程工程优化:从文本切分到容错持久化
仅仅把单句放入多线程或异步中,并不等同于工程落地的最优解。一个健壮的工业级批量翻译系统,还需要完成以下关键环节的配合:
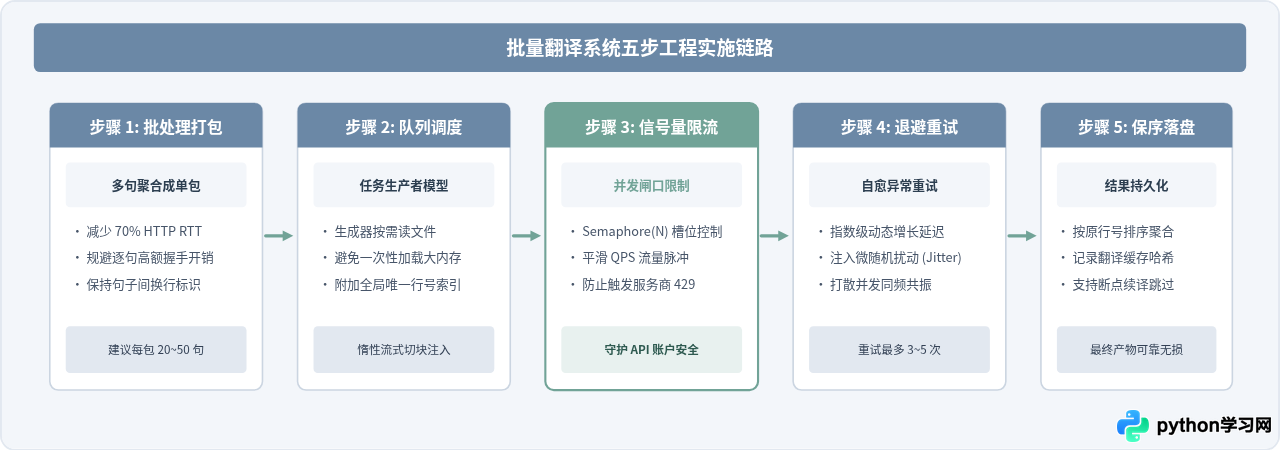
1. 请求打包(Batching):成倍降低 RTT 往返损耗
绝大多数商业翻译接口(如 Google Translate API、DeepL API 或火山翻译)均支持向单个 HTTP 请求中传入一个字符串数组 text: ["line 1", "line 2", ...]。如果把 30 句话打包为一次 POST 请求,网络建立与往返损耗(RTT)将直接缩减为原先的 1/30。建议根据单个请求字符数限制(例如每次请求不超过 4,000 字符或 50 句)进行切块分包。
2. 并发限流与动态退避重试(Jittered Backoff)
当 API 返回 HTTP 429 Too Many Requests 时,说明瞬时请求速率已击穿服务端的配额防线。如果此时所有失败的并发协程立即同频发起重试,将形成“惊群效应”(Thundering Herd),进一步加剧服务瘫痪。
标准的解决方案是指数退避结合随机抖动:每次重试的等待时间按 \(2^{\text{attempt}}\) 指数递增,并在其中混入 0 到 1 秒的随机浮动时间(Jitter),将重试时间点均匀打散。
六、高阶生产实践中的避坑法则
避免内存溢出:切勿一次性 read() 整个海量语料文件
面对几百兆或数个 GB 的待翻译大文件,如果一次性使用 readlines() 读入内存形成巨大的 Python 列表,不仅会使内存瞬间占用数个 G,而且一旦中途网络中断或程序崩溃,已翻译的数据将全部丢失。应使用生成器按批次流式读取,并使用 SQLite 或追加文件(.jsonl)实现实时持久化与断点续译。
1. 断点续译与本地缓存设计
网络请求必然存在偶尔的失败可能。在工程实现中,推荐在发送请求前计算英文文本的 MD5 或 SHA-256 哈希值作为缓存 Key:
- 在执行翻译前,首先查询本地轻量数据库(如 SQLite)或缓存文件。
- 若已存在对应的翻译记录,则直接填充译文,跳过远程 API 调用。
- 这一机制能在遭遇网络中断重新运行脚本时,直接跳过已经处理过的成千上万条记录,省去重复扣费与等待时间。
2. 多账号 / 多 API Key 的轮询池(Key Rotation)
部分翻译服务提供商对单个 API Key 实行严格的单 IP 或单 Key QPS 限制(例如 5 QPS)。在合规范围内,如果你拥有分配的不同业务子 Key,可以在异步调度器中维护一个 itertools.cycle 轮询池或基于各 Key 配额权重的调度器,将并发请求均匀分摊到不同 Key 上,从而成倍突破单 Key 的速率天花板。
七、批量翻译优化策略全景总结
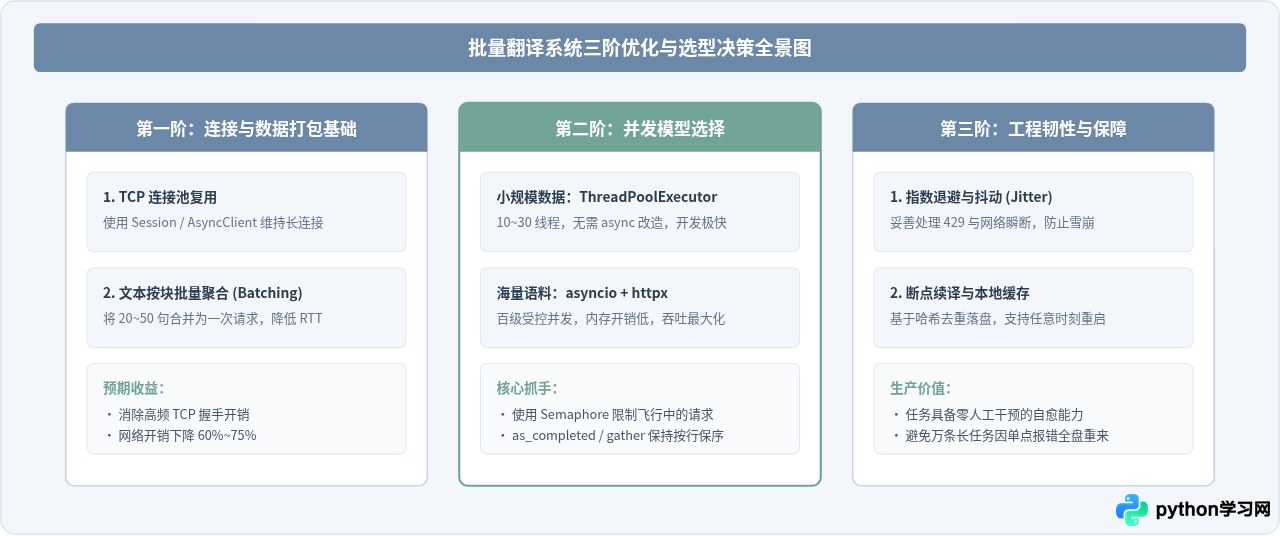
综上所述,在 Python 批量翻译英文的场景中,选择哪种方案取决于业务规模:
- 对于数千条级别的小型任务或快速开发的离线脚本,采用
ThreadPoolExecutor+ 共享requests.Session能以最小的心智负担获取数倍的性能飞跃。 - 对于数万至百万级以上的语料本地化、生产级数据管道,采用
asyncio+httpx+Semaphore限流 + 指数退避重试 则是构建稳定、高吞吐、低资源消耗翻译服务的工业级标准范式。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















