


Python解析C++头文件时怎么处理宏定义与模板实例化
深入解析在Python中利用libclang解析C++头文件时处理宏定义与模板实例化的工程方案,涵盖预处理记录捕获、Token分词求值与合成存根具现化技术。
cppheaderparser)必然会在这两个环节失真甚至解析崩溃。核心解决路径是基于生产级编译器前端 libclang(Python 的 clang.cindex 绑定):针对宏定义,必须在构建编译单元时开启详细预处理记录(Detailed Preprocessing Record)并通过分词器获取语义;针对模板实例化,则需要通过合成实例化存根(Synthetic Instantiation Stub)向编译前端注入特化声明,驱动 Clang 计算出确定的内存对齐、结构尺寸与具现化函数符号。
一、为什么常规解析器在处理宏与模板时必然失效?
C++ 的语法解析之所以极其复杂,根本原因在于其源码在编译前需要经过严苛的预处理器展开,而在编译语义分析期又依赖图灵完备的模板元编程系统。
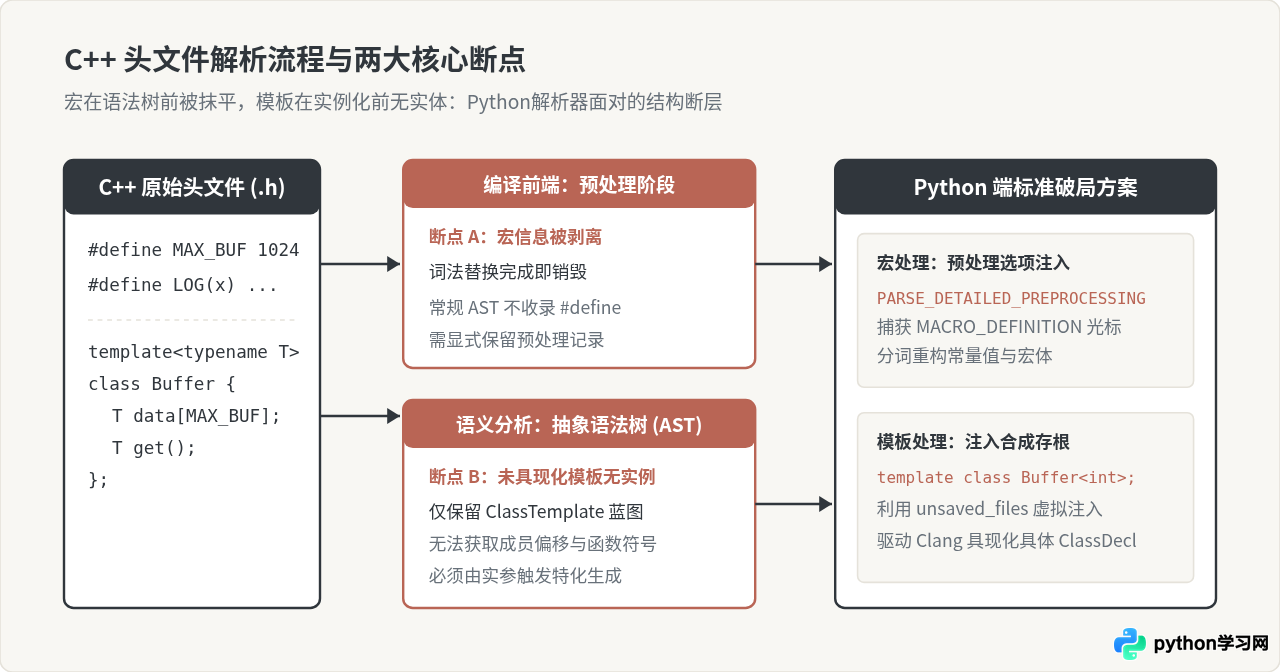
一方面,宏并非 C++ 语法树的合法节点,它属于纯文本替换工具。编译器在进入词法分析和语法分析(AST 构建)之前,预处理器就已经将条件编译分支(如 #ifdef)裁减完毕,并把对象式宏与函数式宏全部替换到了源码中。常规的 AST 解析器如果按默认配置运行,其输出的语法树中根本不会为 #define 留存光标节点。
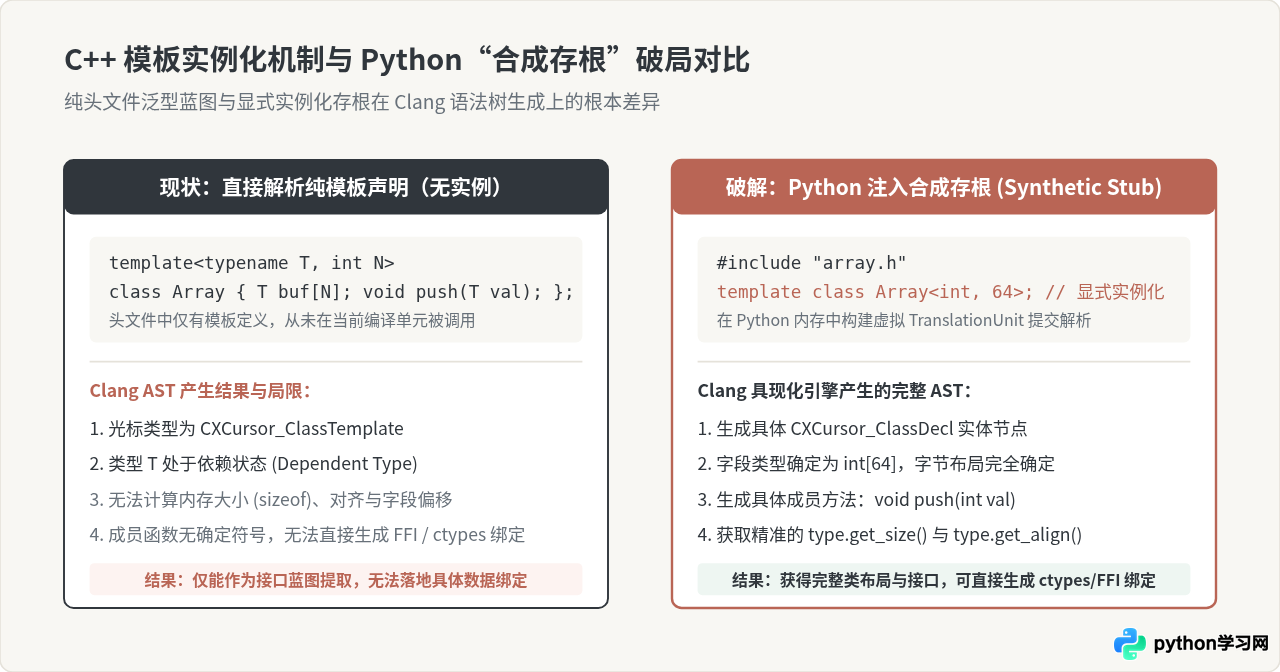
另一方面,C++ 模板本质上是“生成代码的代码”。一个未被实例化的类模板(例如 template<typename T> class Vector)在 AST 中仅仅以 CXCursor_ClassTemplate 蓝图的形式存在。因为缺乏具体的类型实参,类型 T 处于未决状态(Dependent Type)。编译器此时无法确定成员变量的偏移量、无法计算类的总字节大小,更不会为成员函数生成具体的符号。
二、宏定义(Macros)的识别、提取与分类求值
在处理宏定义时,需要将宏分为两类对待:常量对象宏(如 #define MAX_CONNECTIONS 100)和函数式/语法结构宏(如 #define EXPORT_API __declspec(dllexport))。针对不同类型,处理手段存在本质区别。
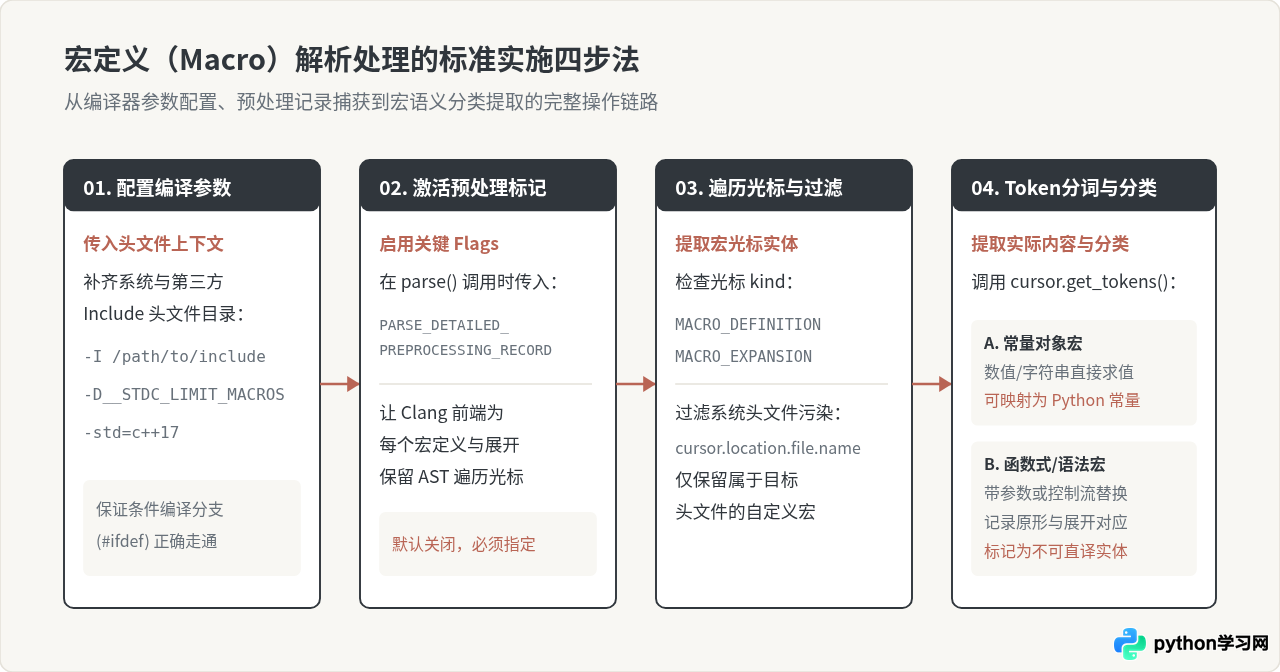
1. 开启编译前端的详细预处理记录
在调用 clang.cindex.TranslationUnit.from_source 或 parse 时,必须显式传递标记 TranslationUnit.PARSE_DETAILED_PREPROCESSING_RECORD。只有开启此标记,Clang 的语法树遍历光标(Cursor)才会包含宏定义与宏展开信息。
2. 实战代码:提取宏光标与分词重构
在获取到 CursorKind.MACRO_DEFINITION 后,由于宏不具有标准类型系统,其值不能直接通过 cursor.type 读取,必须通过 cursor.get_tokens() 提取源码 Token 进行拼装。
import clang.cindex
from clang.cindex import CursorKind, TranslationUnit

def extract_macros_from_header(header_path: str, include_dirs: list[str] = None):
    index = clang.cindex.Index.create()

    # 构造编译器编译选项
    compile_args = ['-std=c++17', '-x', 'c++-header']
    if include_dirs:
        for inc in include_dirs:
            compile_args.append(f'-I{inc}')

    # 核心:必须注入 PARSE_DETAILED_PREPROCESSING_RECORD 标记
    options = TranslationUnit.PARSE_DETAILED_PREPROCESSING_RECORD
    tu = index.parse(header_path, args=compile_args, options=options)

    macros = {}
    for cursor in tu.cursor.get_children():
        # 严格过滤:只解析当前头文件自身定义的宏,跳过引入的系统头文件宏
        if cursor.location.file and cursor.location.file.name == header_path:
            if cursor.kind == CursorKind.MACRO_DEFINITION:
                macro_name = cursor.spelling
                tokens = [t.spelling for t in cursor.get_tokens()]

                # tokens[0] 必然是宏名字本身,后续 tokens 为宏的内容定义
                if len(tokens) > 1:
                    raw_body = " ".join(tokens[1:])
                    macros[macro_name] = {
                        "type": "FUNCTION_OR_COMPLEX" if "(" in tokens[1] else "OBJECT",
                        "raw": raw_body,
                        "line": cursor.location.line
                    }
                else:
                    macros[macro_name] = {"type": "FLAG", "raw": None, "line": cursor.location.line}

    return macros
在 Windows 动态库导出宏(如 MY_API)或属性宏(如 __attribute__((aligned(8))))存在时,如果不传定义,Clang 会直接报错将后续类或函数标记为无效语法。此时必须在 compile_args 中显式传入 -DMY_API=(替换为空字符串),确保编译器前端能够正常推演主要类型的语法结构。
三、模板实例化(Template Instantiation)的破局之道
与宏不同,模板是类型系统的一部分,但它处于“延迟生成”状态。要解决 Python 无法获取模板内具体字段、成员函数以及布局信息的问题,有两种截然不同的工程方案。
1. 仅提取模板泛型骨架(静态声明提取)
如果目标只是提取头文件 API 并生成文档,或者只需要知道该模板接收几个类型参数(例如 template<typename T, typename Alloc>),可以直接遍历 CXCursor_ClassTemplate 或 CXCursor_FunctionTemplate 的子节点。
此时可以通过遍历 CXCursor_TemplateTypeParameter 和 CXCursor_NonTypeTemplateParameter 拿到模板形参的名字与默认值。但需明确,这种方式无法得知具体类型下的 sizeof 大小、字段偏移以及特化方法的确定签名。
2. 注入合成实例化存根(Synthetic Instantiation Stub)
如果解析目的是自动化生成 ctypes、CFFI 绑定,或者进行二进制交互,必须知道具体的内存排布。此时最严谨的做法是:在 Python 内存中构建一段显式特化代码,驱动 Clang 完成具现化(Instantiation)。
3. 合成存根驱动具现化代码实现
我们无需在磁盘上创建临时文件。借助 Clang 提供的 unsaved_files 内存文件特性,可以安全、无污染地在 Python 内存中完成虚拟源文件的解析。
import clang.cindex
from clang.cindex import CursorKind

def instantiate_and_inspect_template(header_abs_path: str, template_name: str, concrete_types: list[str]):
    """
    构造虚拟的合成存根,驱动 Clang 具现化特定的类模板
    """
    index = clang.cindex.Index.create()

    # 构建内存虚拟代码:包含目标头文件,并添加显式实例化语句
    synthetic_code = f'#include "{header_abs_path}"\n'
    for t in concrete_types:
        synthetic_code += f'template class {template_name}<{t}>;\n'

    virtual_filename = "virtual_instantiator.cpp"
    unsaved_files = [(virtual_filename, synthetic_code)]

    compile_args = ['-std=c++17', '-x', 'c++']
    tu = index.parse(virtual_filename, args=compile_args, unsaved_files=unsaved_files)

    instantiated_classes = []
    for cursor in tu.cursor.get_children():
        # 寻找具现化后的具体类声明
        if cursor.kind == CursorKind.CLASS_DECL and cursor.spelling == template_name:
            t = cursor.type
            # 具现化后即可成功获得内存大小与布局信息
            size_in_bytes = t.get_size()
            align_in_bytes = t.get_align()

            methods = []
            for member in cursor.get_children():
                if member.kind == CursorKind.CXX_METHOD:
                    methods.append({
                        "name": member.spelling,
                        "return_type": member.result_type.spelling,
                        "is_const": member.is_const_method()
                    })

            instantiated_classes.append({
                "template": template_name,
                "type_arg": t.spelling,
                "size": size_in_bytes,
                "align": align_in_bytes,
                "methods": methods
            })

    return instantiated_classes
四、方案对比与工程落地决策
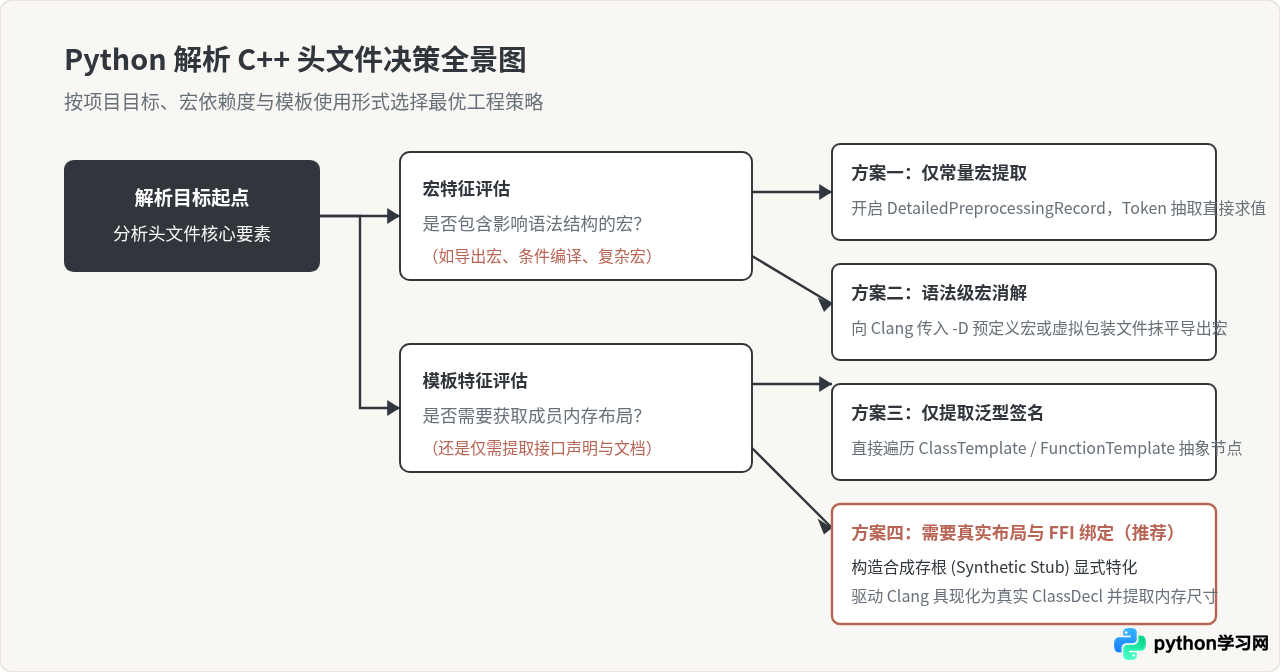
在实际项目落地中,选择哪种策略取决于解析结果的最终用途。如果仅做元信息展示,不需要深入实例化;但若是绑定与自动化测试,必须将预处理标志与存根具现化组合使用。
| 处理目标 | 典型场景 | 推荐技术手段 | 主要优势与限制 |
|---|---|---|---|
| 对象式宏常量 | 头文件中的枚举值替代品、版本号、缓冲区常数 | DetailedPreprocessingRecord + Token 分词 |
直接提取为 Python 字典;受宏嵌套影响需做简单二分代换 |
| 语法与导出宏 | DLL_EXPORT、调用约定标记、平台条件判断 |
通过编译参数 -D 预置或抹空 |
避免 AST 语法解析因未知语法修饰符崩溃,成本极低 |
| 泛型签名声明 | 接口文档生成、泛型类型树分析 | 遍历 ClassTemplate 蓝图光标 |
轻量快捷;无法获得结构大小与内存字段偏移 |
| 模板布局与绑定 | ctypes/CFFI 封装、二进制协议反序列化 |
unsaved_files 内存合成存根显式实例化 |
精准获取底层 ABI 布局与具现化方法符号;需枚举目标类型 |
五、工程实施最佳实践与避坑要点
-
系统头文件隔离:调用
cursor.get_children()时,务必通过cursor.location.file.name比对当前处理文件路径。Clang 会将所有#include展开,不加路径过滤会导致 Python 处理成千上万个来自标准库的宏与内置类型。 -
编译选项环境对齐:解析 C++ 头文件时,必须向
args中补充目标平台的核心宏定义(如-D__x86_64__、-D_WIN32等)以及标准库路径(-isystem)。缺少关键宏可能导致代码在条件编译预处理时直接“消失”。 -
无文件写入安全隔离:对于模板实例化存根,始终优先采用
unsaved_files内存流提交给 Clang,避免在磁盘工作区遗留多余的临时.cpp文件,既能保证解析的高性能并发,又杜绝了文件系统残留问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















