


Python异步编程中await怎么实现高并发而不创建新线程
await 表达式遇到尚未完成的 I/O 操作时,该协程会主动把 CPU 执行权挂起并交回事件循环;事件循环立即切换去执行其他已就绪的协程;与此同时,底层网络连接被注册到操作系统的事件监听器中,一旦数据传输就绪,操作系统唤醒事件循环,再由事件循环将暂停的协程恢复执行。整个过程自始至终由主线程串联调度,消除了多线程模型所带来的巨额内存开销与锁竞争。
一、并发的两种范式:多线程阻塞 vs 单线程事件循环
要透彻理解 await 的机制,首先需要厘清“并行(Parallelism)”与“并发(Concurrency)”在 Python 中的实现差异。许多初学者容易把高并发等同于“同时运行多个线程”。然而在标准的 CPython 解释器中,由于全局解释器锁(GIL)的存在,同一时刻只能有一个系统线程在执行 Python 字节码。
在传统的多线程模型下,应对高网络并发通常采用“一个连接对应一个线程”的方式。当线程执行网络请求(如读取 Socket 数据)时,如果远端服务器没有立刻返回数据,该线程就会陷入阻塞(Blocking)。操作系统内核会将这个线程挂起,并触发上下文切换(Context Switch)去运行其他线程。
这种模式存在两个核心瓶颈:
- 内存开销巨大:在 Linux 系统中,每个线程默认分配数兆字节(通常为 8MB)的独立调用栈空间。即便通过参数调小,维持 10,000 个并发连接依然需要占用数吉字节(GB)的物理内存。
- 调度损耗高昂:大量的操作系统线程频繁陷入睡眠与唤醒,CPU 需要频繁在内核态与用户态之间切换,保存与恢复 CPU 寄存器和栈指针,导致大量计算资源浪费在调度本身。
与多线程不同,以 asyncio 为代表的单线程异步模型采用的是完全不同的思路:网络通信中 99% 的耗时都在等待网卡收发数据,CPU 本身处于极度空闲状态。异步模型只维持一个线程,该线程内运行一个中央调度器——事件循环(Event Loop)。
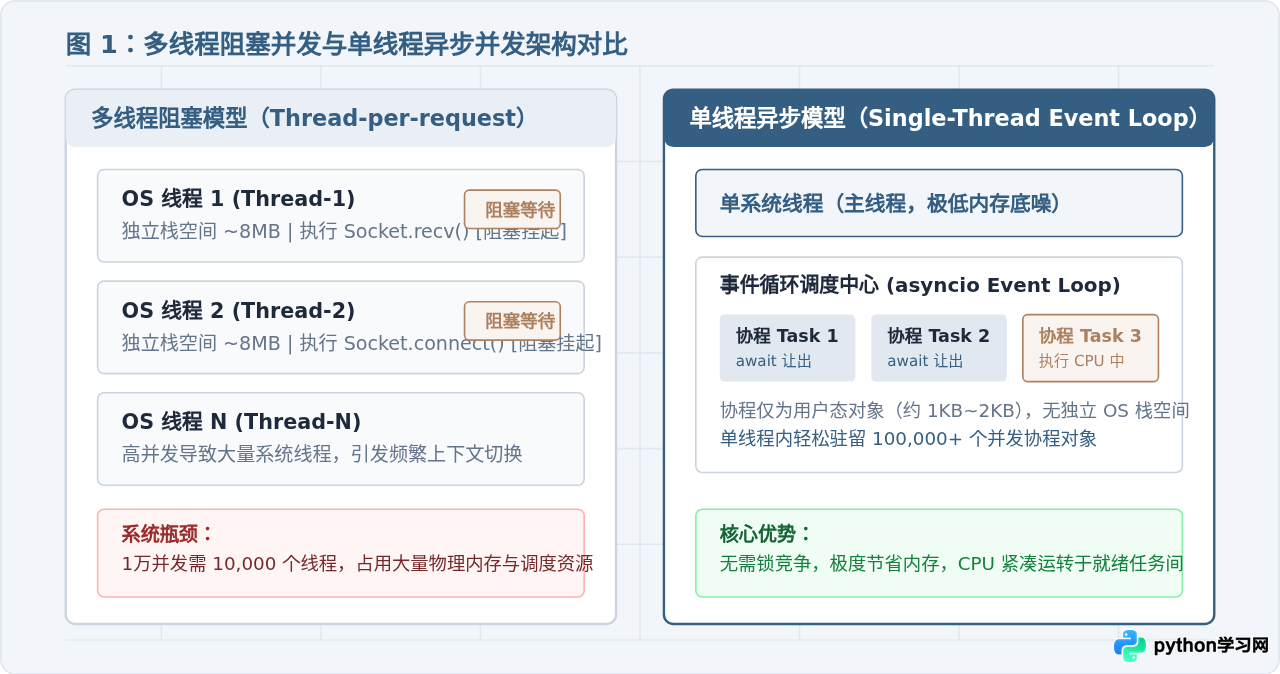
从图 1 可以看出,异步编程并没有创建任何新的操作系统线程。每一个所谓的“并发任务”,在 Python 内部实际上只是一个普通的 Python 对象(asyncio.Task)。其内存占用通常只有 1KB 到 2KB 左右。由于所有协程运行在同一个线程中,代码执行完全不需要互斥锁(Mutex)保护共享变量,从而根除了死锁隐患。
二、await 的底层机制:协程是如何暂停与交出控制权的
既然只有一个线程,当一个任务在等待网络传输时,为什么整个程序没有被冻结?关键就在于关键字 await 的行为。
在语法层面上,由 async def 定义的函数被称为原生协程函数(Coroutine Function)。调用该函数时,函数体内的代码不会立即运行,而是返回一个协程对象。
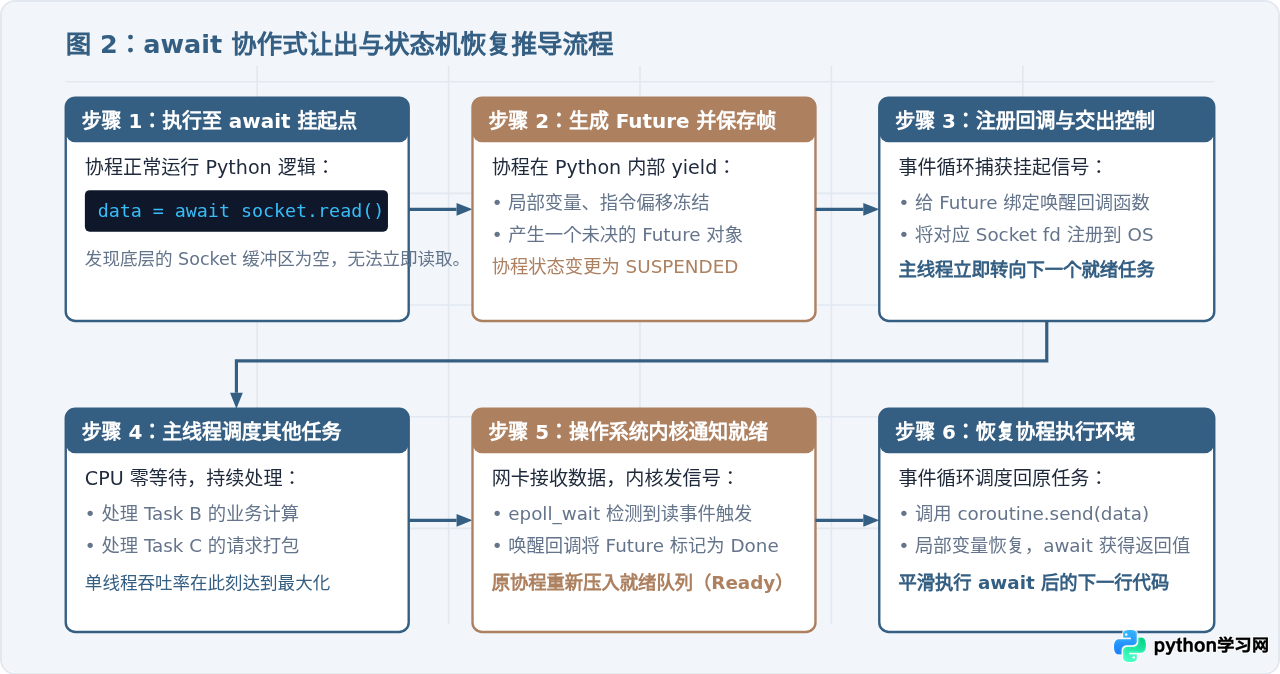
Python 内部的协程实质上是生成器(Generator)的高级演进形式。回顾传统生成器:通过 yield 语句,函数可以将局部状态(局部变量、当前程序计数器指针、异常处理栈)保存在帧对象(Frame Object)中,并将执行权退回到调用方;稍后,调用方可以通过 send() 方法,让该生成器从上一次 yield 的位置无缝继续向下执行。
await future_or_task 时:
- 它检查目标对象是否已经完成。如果已经完成,直接解包结果,继续执行下一行,不发生任何调度切换。
- 如果尚未完成,它会向事件循环返回一个信号,主动将当前协程挂起(Suspend)。
- 当前协程的执行栈帧保留在堆内存中,CPU 控制权被归还给事件循环。
这一过程属于协作式调度(Cooperative Multitasking)。与操作系统多线程的“抢占式调度(Preemptive Scheduling)”不同,Python 运行时绝不会强行剥夺一个正在运行的代码块。只有当编写者显式写下 await 表达式时,协程才自愿交出主线程的控制权。
三、幕后驱动力:事件循环与操作系统 I/O 多路复用
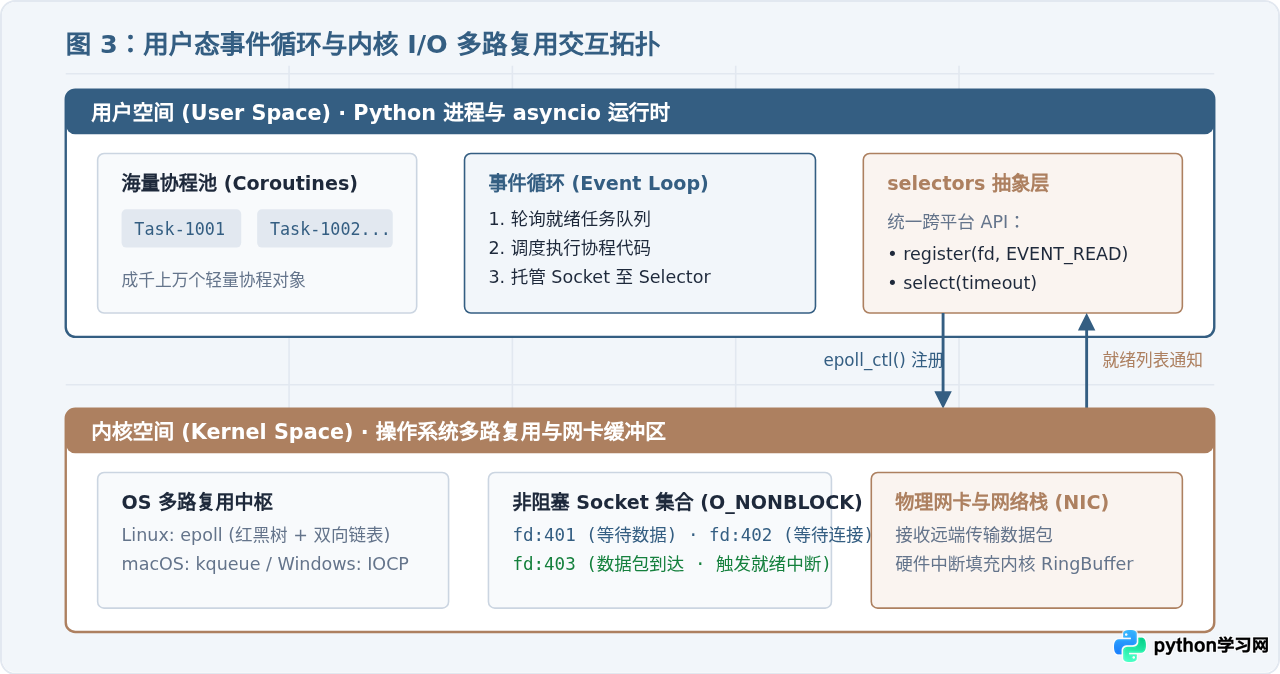
当几千个协程都执行了 await 并交出执行权后,主线程不可能无休止地轮询每一个协程,否则单单是检查“谁已经收到数据”就会将单核 CPU 占满到 100%。
解决这个问题的真正技术支柱,是操作系统内核提供的I/O 多路复用(I/O Multiplexing)技术,例如 Linux 下的 epoll、macOS/BSD 下的 kqueue 以及 Windows 下的 IOCP。
在 Python 底层,标准库 selectors 模块会自动封装当前操作系统最高效的多路复用 API:
-
非阻塞 Socket(Non-blocking Socket):当使用异步框架建立网络连接时,底层的套接字(Socket)都被显式配置为
O_NONBLOCK模式。这意味着对该 Socket 执行读写操作时,若没有数据可用,内核不会让线程睡眠,而是立刻返回一个EWOULDBLOCK或EAGAIN错误。 -
文件描述符托管给内核:当协程挂起时,
asyncio不会自己去轮询 Socket,而是通过系统调用(如epoll_ctl)把对应的文件描述符(fd)注册给 Linux 内核的epoll监听实例,并声明:“当这个连接有数据到达(EPOLLIN)时请通知我”。 -
高效的睡眠与批量就绪:当事件循环发现内存中的就绪任务队列为空时,它会执行
epoll_wait()系统调用。此时主线程才会在操作系统内核中安详入睡,CPU 占用率彻底降为 0%。一旦网卡芯片接收到网络数据包并通过中断通知内核,内核会一次性把所有“数据已就绪”的文件描述符打包返回给epoll_wait。 -
精准回调触发:事件循环拿到这批就绪的 fd 列表,按图索骥找到挂在每个 fd 上的回调函数,直接将对应的
Future对象状态改写为已完成,并把挂起的协程重新加入事件循环的执行队列。
实战对比:从代码看高并发的调度全貌
为了直观感受 await 的执行模式,请看下面使用 aiohttp 同时发起 1000 个 HTTP 请求的完整示例:
import asyncio
import aiohttp

# 每一个请求对应一个独立的协程任务
async def fetch_status(session, url, task_id):
    # 遇到 await,当前协程主动挂起,底层将 socket 注册到 epoll
    # 主线程不阻塞,直接跳转执行其他任务
    async with session.get(url) as response:
        content = await response.read()
        return task_id, response.status, len(content)

async def main():
    target_url = "https://httpbin.org/delay/1"  # 模拟 1 秒网络延迟

    # 限制并发连接池,避免耗尽本地端口或被远端熔断
    connector = aiohttp.TCPConnector(limit=1000)
    async with aiohttp.ClientSession(connector=connector) as session:
        # 创建 1000 个任务对象,瞬间全部驻留在事件循环中
        tasks = [
            fetch_status(session, target_url, i)
            for i in range(1000)
        ]

        # 等待全部任务并发完成
        results = await asyncio.gather(*tasks)
        print(f"已顺利完成并发请求总数: {len(results)}")

if __name__ == "__main__":
    # 启动单个主线程中的事件循环
    asyncio.run(main())
运行过程剖析:
- 当循环执行
main()时,1000 个fetch_status协程几乎在一瞬间全部启动并运行到await session.get()。 - 在这短短几毫秒内,主线程向网络发送了 1000 个 SYN 握手包,底层的 1000 个 Socket 全部处于“等待响应”状态,这 1000 个协程也全部挂起。
- 在接下来的 1 秒延迟期间,没有任何操作系统线程处于自旋或无意义睡眠状态,主线程由
epoll_wait托管,CPU 负载微乎其微。 - 当远端服务器的数据陆续抵达网卡时,内核唤醒事件循环,事件循环以纳秒级的时间依次将 1000 个协程恢复,解包数据并返回。完成这 1000 次请求的总耗时仅略大于 1 秒,而自始至终只有一个操作系统线程参与运算。
四、异步编程的适用边界与常见避坑指南
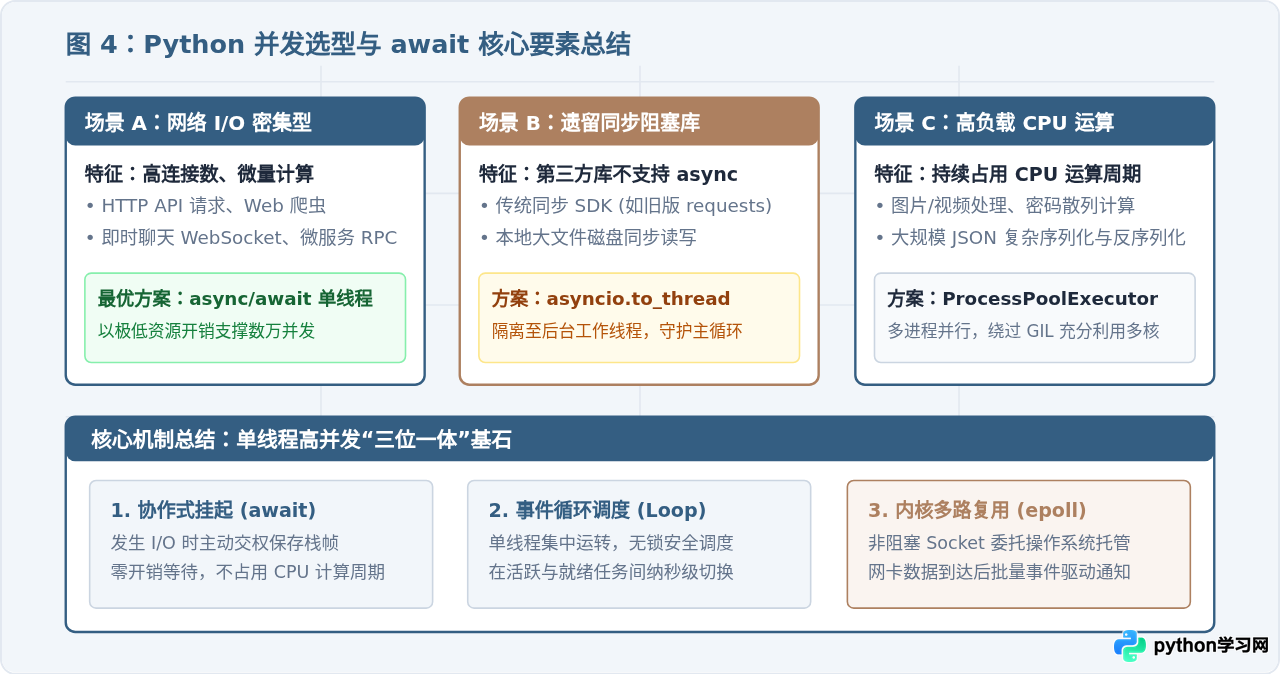
理解了“单线程”这个底色,就能清晰推导出异步高并发的致命弱点:事件循环最怕被单线程本身阻塞。
1. 绝不能在协程中调用同步阻塞库
如果在 async def 函数中调用了传统的阻塞式调用(例如 time.sleep(5)、标准库的 requests.get() 或者是没有提供异步驱动的数据库客户端),这个调用不会交出控制权,而是直接让唯一的系统主线程陷入硬阻塞。在此期间,整个事件循环将彻底停转,所有其他成百上千个本已就绪的协程全部被卡死,高并发优势荡然无存。
应对方案:所有 I/O 操作必须替换为支持异步的标准库或第三方库(例如用 asyncio.sleep() 替换 time.sleep(),用 httpx/aiohttp 替换 requests,用 asyncpg 替换 psycopg2)。如果必须调用老旧的同步阻塞模块,必须使用 asyncio.to_thread(func, *args) 将该函数丢给单独的备用线程池执行,从而保护主事件循环不被阻塞。
2. 异步无法加速 CPU 密集型任务
await 的本质是“在等待 I/O 时干别的事情”。如果任务本身是高密度的 CPU 计算(例如视频转码、复杂图像滤镜、大文件加密运算、机器学习矩阵点积),代码不会发生 I/O 等待,也就无法通过 await 挂起。单线程下运行 CPU 密集计算只会一直霸占核心。
应对方案:CPU 密集型任务应使用 concurrent.futures.ProcessPoolExecutor(多进程模型),通过跨进程派发绕过 Python 的 GIL 限制,利用多核 CPU 真正实现物理层面的并行计算。
五、多维度对比总结表
为了方便在实际开发中进行技术评估,下表总结了 Python 中多线程与异步编程的关键特性对比:
| 对比维度 | 多线程模型 (threading) | 异步事件循环 (async/await) |
|---|---|---|
| 并发载体 | 操作系统内核线程 (OS Thread) | 用户态协程任务 (asyncio.Task) |
| 调度机制 | 抢占式调度 (由 OS 内核强制时间片切换) | 协作式调度 (由代码中的 await 主动让出) |
| 单个并发内存开销 | 较大 (每个线程约几 MB 栈空间) | 极微小 (每个协程仅约 1KB~2KB 堆内存) |
| 并发连接上限 | 通常受限于几千个 (受物理内存与内核句柄限制) | 轻松支持数万至数十万个 (受限于网络端口与带宽) |
| 数据同步与锁 | 需要复杂的锁机制 (Lock, RLock) 防止竞争 | 单线程运行,原生无锁安全,代码逻辑线性可预测 |
| I/O 阻塞处理 | 线程陷入阻塞,由内核挂起 | Socket 非阻塞,由 epoll/kqueue 异步事件唤醒 |
| 编码与心智负担 | 符合传统同步直觉,但调试死锁/竞态极难 | 传染性强 (async 需层层传递),需杜绝任何同步阻塞 |
六、核心结论
回到标题的核心问题:Python 异步编程中 await 是怎么实现高并发而不创建新线程的?
答案归结为三句话:
await在语法层充当了微型任务的主动暂停开关,将等待网络响应的空闲时间交还给主线程;- 事件循环在单线程内持续运转,利用极低内存开销维护数以万计的协程任务,实现紧凑高效的用户态任务轮转;
- 操作系统内核的
epoll/kqueue承担了所有非阻塞网络连接的状态监听,在网络数据抵达的瞬间精准唤醒事件循环。
正是这三者的无缝协作,让 Python 开发者能够用接近同步顺序的清晰语法,写出吞吐量惊人、资源利用率极高的高并发网络程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















