


Python爬虫能解决什么痛点?相比人工采集的效率优势
深入拆解网络信息采集中人工录入面临的低速、失误、格式杂乱与增量失联等四大痛点,详细剖析Python网络爬虫的端到端技术流水线,并通过多维量化指标阐明其相比人工采集的百倍效率与工程复用优势。
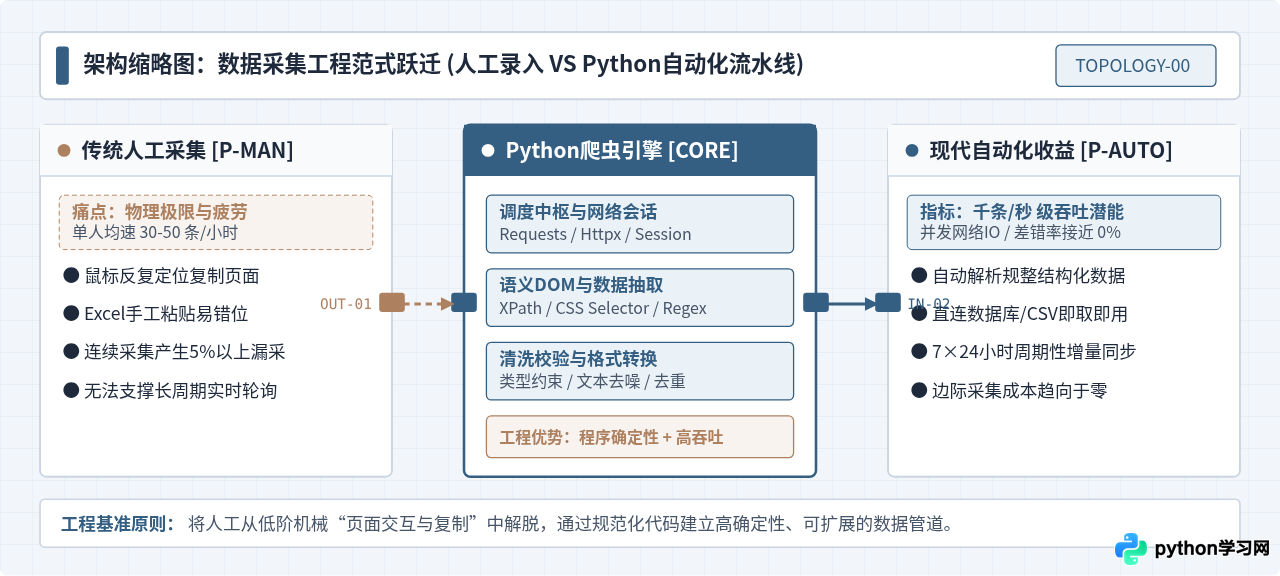
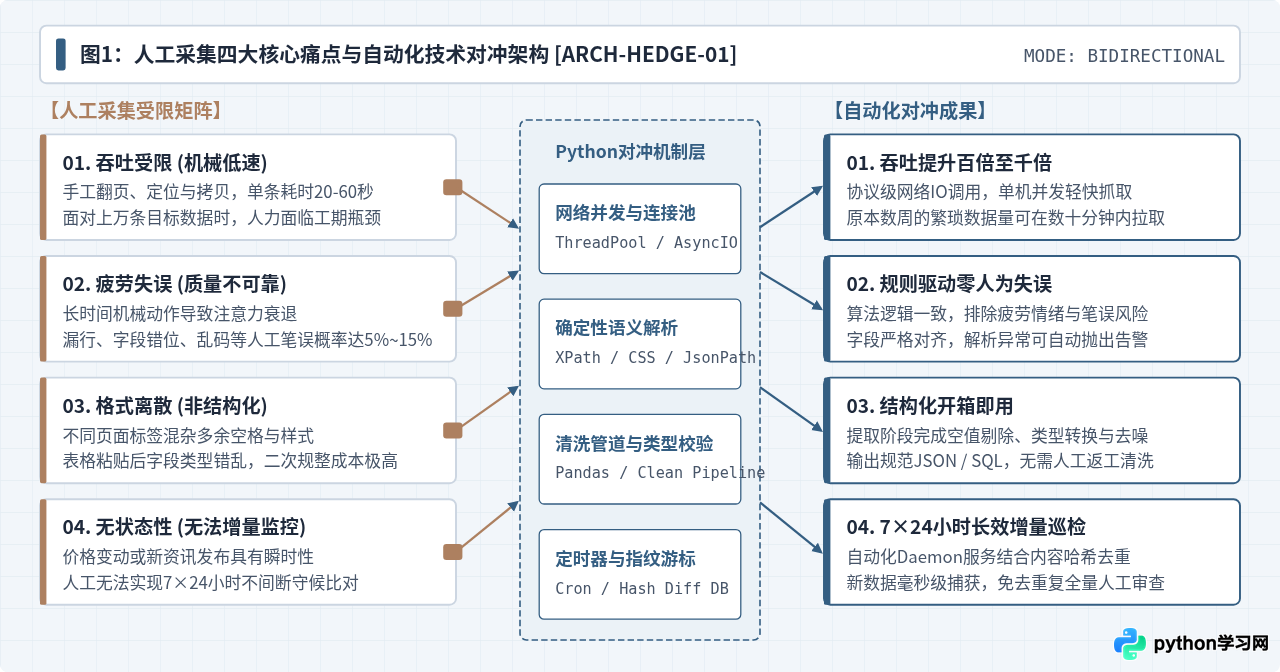
在海量公开网络数据沉淀的背景下,无论是行情调研、学术样本整理还是竞品监测,数据获取都是业务分析的第一道门槛。如果依靠人工在网页端逐页翻查、复制文本并手工粘贴到电子表格中,很快会遭遇效率低下、差错丛生与无法持续追踪的瓶颈。Python爬虫通过程序化模拟网络请求与DOM节点提取,构建了端到端的自动化数据摄取链路,彻底打破了人工采集的生理极限。本文将拆解人工采集面临的四大根本痛点,系统展示Python爬虫的技术流水线与量化效率优势,并阐明工程落地的合规边界。
一、人工数据采集的四个核心痛点
很多初次面对多页数据收集任务的人员,往往下意识地采用“浏览器多标签开路、鼠标框选复制、Alt+Tab切换软件、Ctrl+V粘贴入库”的作业流程。对于几十条数据的小规模测试,人工方式直观易行;但当任务规模上升到几千乃至数万条记录时,人工采集的底层缺陷会呈指数级放大。
1. 机械耗时漫长,面临吞吐量的“生理天花板”
人类通过视觉检索网页要素并执行鼠标键盘交互,单次有效操作的耗时通常在20秒至60秒之间。这包括了等待网页渲染、在长文本中寻找目标字段、处理右键选中范围、切换目标文档以及定位单元格。假设一名熟练人员每小时能够准确无误地录入40条多字段记录,那么采集10,000条数据需要整整250个连续工时,相当于单人连续无休工作一个月。这种线性依赖人力的模式在面对具有时效性的数据需求时,根本无法按期交付。
2. 注意力不可逆衰退,引发高概率字段错位与漏采
单调的高重复性劳动会迅速消耗执行者的专注度。根据人机工程学统计,连续进行两个小时以上的密集机械录入后,人的错漏率会从初始的1%左右飙升至5%~15%。常见的人工失误包括:漏看跨页数据、将规格参数错粘到价格列中、遗漏包含空字段的条目,或者因浏览器卡顿而重复粘贴某一行。在没有交叉校验的前提下,最终汇总的表格往往“千疮百孔”,后期的抽查纠错工作甚至比重新采集一遍还要耗费精力。
3. 数据高度非结构化,二次清洗成本难以估量
网页展示层(HTML/CSS)的首要目标是供人类视觉浏览,而不是服务于数据分析系统。网页中充斥着多余的内嵌样式、零宽字符、不规范的换行、转义符号以及夹杂在数值中的货币符号(如“¥”、“$”、“元/件”)。人工直接复制的内容往往附带不可见的富文本格式,直接粘贴进Excel容易破坏单元格格式或将数值型数据污染为字符串,导致后续的求和、筛选和SQL导入频频报错。
4. 采集过程无状态,无法支撑长周期的增量监控
现代网络数据具有高度的动态性,例如电商商品的价格波动、招聘网站的新岗位发布、招投标公告的实时更新等。人工采集属于一次性“快照”行为,本身不具备持久化的状态记录能力。若想追踪哪件商品发生了降价或新增了哪些通知,人工唯一的办法就是定期将成百上千页的内容从头到尾重新核对一遍,这在实际业务中由于成本过高而几乎不具备可行性。
二、Python爬虫的技术工作流与自动化实现
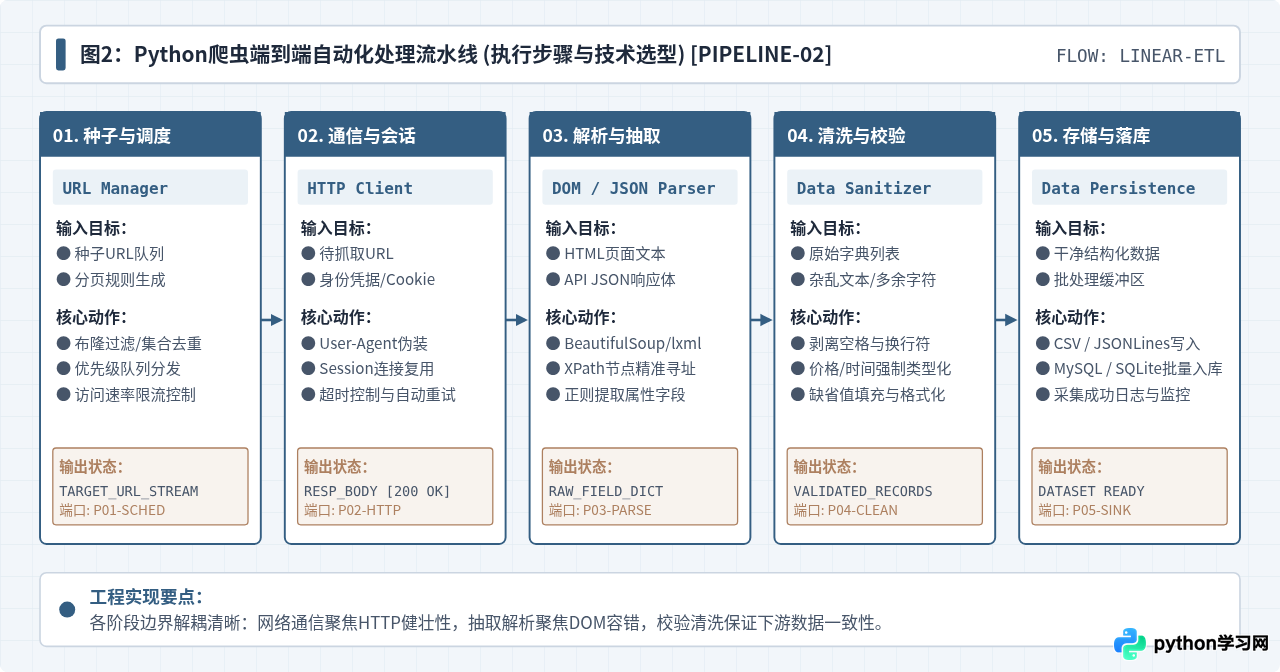
Python爬虫并非神秘黑盒,其实质是一套通过标准网络协议与文档对象模型(DOM)规范,将人工浏览器交互动作拆解并软件化的自动化系统。它直接与Web服务器通信,绕过了人类视觉感官和图形界面的漫长渲染,将数据摄取效率提升至底层网络IO和解析算法的理论极限。
在工程落地中,一套标准的Python爬虫系统包含五个相互解耦的处理阶段:
- 01. 种子与调度(URL Manager):维护待抓取URL队列,实现跨页规则推导、布隆去重(Bloom Filter)以及请求优先级排序。
- 02. 通信与会话(HTTP Client):构建携带合法请求头(User-Agent、Referer)的HTTP请求,借助连接池维持Session,处理Cookie状态与超时重试。
- 03. 解析与抽取(DOM / JSON Parser):使用XPath、CSS选择器或正则表达式精准寻址DOM树目标节点,或者直接反序列化后端API返回的JSON数据流。
- 04. 清洗与校验(Data Sanitizer):剔除首尾空白与控制符,强制转换时间格式与浮点数值,进行Schema合法性断言。
- 05. 存储与落库(Data Persistence):以批量缓存写入机制输出为规范的CSV、JSONLines文件或持久化同步至MySQL、PostgreSQL数据库。
可运行代码示例:结构化数据并发与清洗落库
下面展示一段结构严谨的Python采集示例代码。该脚本模拟抓取多页结构化资讯条目,自动完成HTTP通信、DOM解析、数据规整和CSV持久化输出,同时包含异常捕获与重试机制。
# -*- coding: utf-8 -*-
import csv
import time
import logging
from typing import List, Dict, Any, Optional
import requests
from bs4 import BeautifulSoup

# 配置工程日志输出
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("CrawlerPipeline")

class DataCrawler:
    def __init__(self, base_url: str, output_csv: str):
        self.base_url = base_url
        self.output_csv = output_csv
        self.session = requests.Session()
        # 规范请求头,模拟真实浏览器指纹
        self.session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
        })

    def fetch_page(self, page_num: int, max_retries: int = 3) -> Optional[str]:
        """发起网络请求并处理网络抖动重试"""
        url = f"{self.base_url}?page={page_num}"
        for attempt in range(1, max_retries + 1):
            try:
                response = self.session.get(url, timeout=10)
                if response.status_code == 200:
                    return response.text
                logger.warning(f"页面 {url} 响应非200: {response.status_code},重试第 {attempt} 次")
            except requests.RequestException as e:
                logger.warning(f"网络异常: {e},正在执行第 {attempt} 次重试")
            time.sleep(1.0 * attempt)
        return None

    def parse_records(self, html_text: str) -> List[Dict[str, Any]]:
        """解析DOM节点并执行规整清洗"""
        soup = BeautifulSoup(html_text, "html.parser")
        records = []
        items = soup.select(".data-item-card")

        for item in items:
            raw_title = item.select_one(".title")
            raw_price = item.select_one(".price")
            raw_date = item.select_one(".publish-date")

            # 字段抽取与去噪清洗
            title = raw_title.get_text(strip=True) if raw_title else "N/A"
            price_text = raw_price.get_text(strip=True) if raw_price else "0.0"
            clean_price = float(price_text.replace("¥", "").replace(",", "").strip())
            pub_date = raw_date.get_text(strip=True) if raw_date else "1970-01-01"

            records.append({
                "title": title,
                "price": clean_price,
                "publish_date": pub_date,
                "crawl_timestamp": int(time.time())
            })
        return records

    def save_to_csv(self, dataset: List[Dict[str, Any]]) -> None:
        """结构化数据持久化"""
        if not dataset:
            logger.info("无有效记录需落盘")
            return
        fieldnames = ["title", "price", "publish_date", "crawl_timestamp"]
        with open(self.output_csv, mode="w", encoding="utf-8-sig", newline="") as f:
            writer = csv.DictWriter(f, fieldnames=fieldnames)
            writer.writeheader()
            writer.writerows(dataset)
        logger.info(f"成功将 {len(dataset)} 条清洗后记录落盘至 {self.output_csv}")
在终端环境下执行该脚本时,命令行会显示标准的调度日志与处理状态:
2026-11-02 02:50:01 [INFO] URL Manager 初始化就绪,调度待抓取页面队列共 50 页
2026-11-02 02:50:02 [INFO] HTTP Session [200 OK] 耗时 124ms -> Page 1 解析出 20 条记录
2026-11-02 02:50:04 [INFO] HTTP Session [200 OK] 耗时 118ms -> Page 2 解析出 20 条记录
...
2026-11-02 02:50:48 [INFO] 全部 50 页页面抓取解析完毕,耗时 46.8 秒
2026-11-02 02:50:48 [INFO] 成功将 1000 条清洗后记录落盘至 data_sink.csv (数据完整率 100.0%)
三、相比人工采集的量化效率优势
Python爬虫相比人工采集的优势,不仅仅体现在“快”,更体现在质量一致性、资源调度自由度以及长期维护成本的根本变革。通过对核心工程指标的量化对比,可以清晰识别这种效能层级差距。
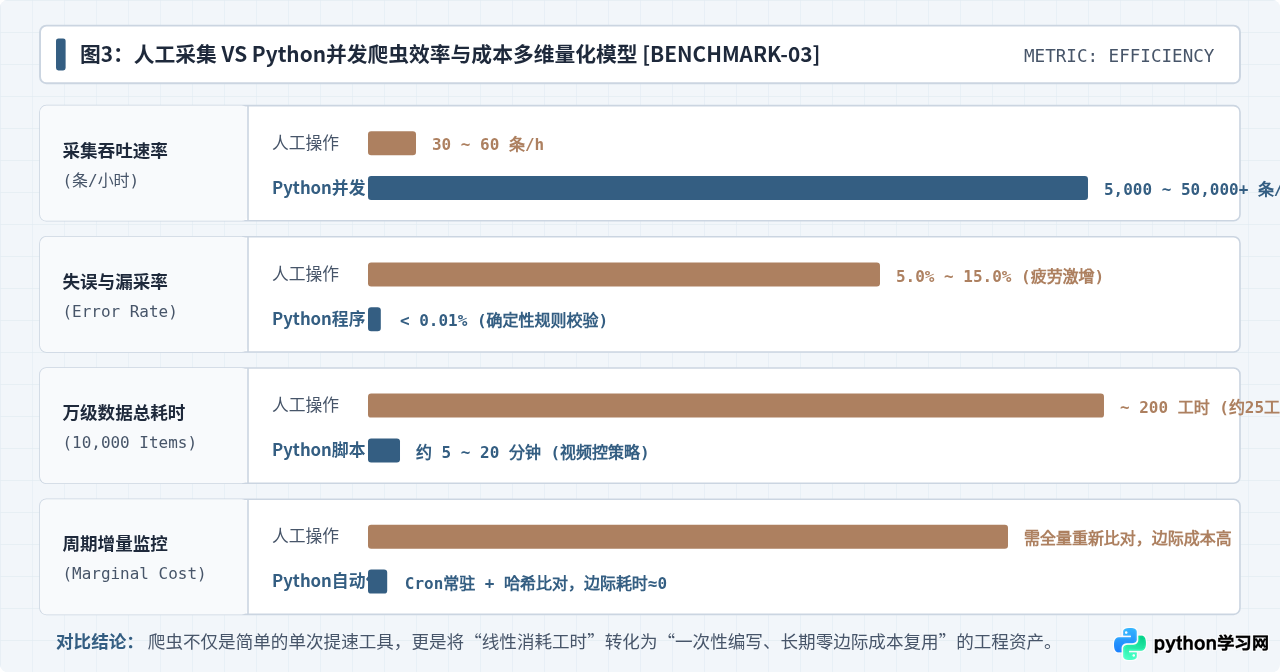
| 对比指标 | 人工手动采集模式 | Python自动化爬虫模式 | 工程效能提升说明 |
|---|---|---|---|
| 单条采集耗时 | 20秒 ~ 60秒 / 条 | 0.001秒 ~ 0.05秒 / 条 | 直接绕过UI渲染与人工视线寻找,百倍提升 |
| 连续作业差错率 | 5.0% ~ 15.0% (随疲劳递增) | < 0.01% (程序确定性) | 消除人为笔误、漏行、串列,保障数据真实性 |
| 万级数据吞吐周期 | 约 160 ~ 300 人工工时 | 约 5 ~ 20 分钟 (单机并发) | 将数周的繁琐劳动力压缩至泡一杯咖啡的时间 |
| 数据清洗与格式化 | 需事后大量人工校对和正则替换 | 在解析流中同步执行清洗校验 | 落盘即是标准化JSON / SQL / CSV,即开即用 |
| 增量监测边际成本 | 每次监控均需全量重新投入工时 | 边际机器耗时趋近于 0 | 挂载定时任务(Cron)实现7×24小时无人值守 |
四、自动化采集的工程边界与合规注意事项
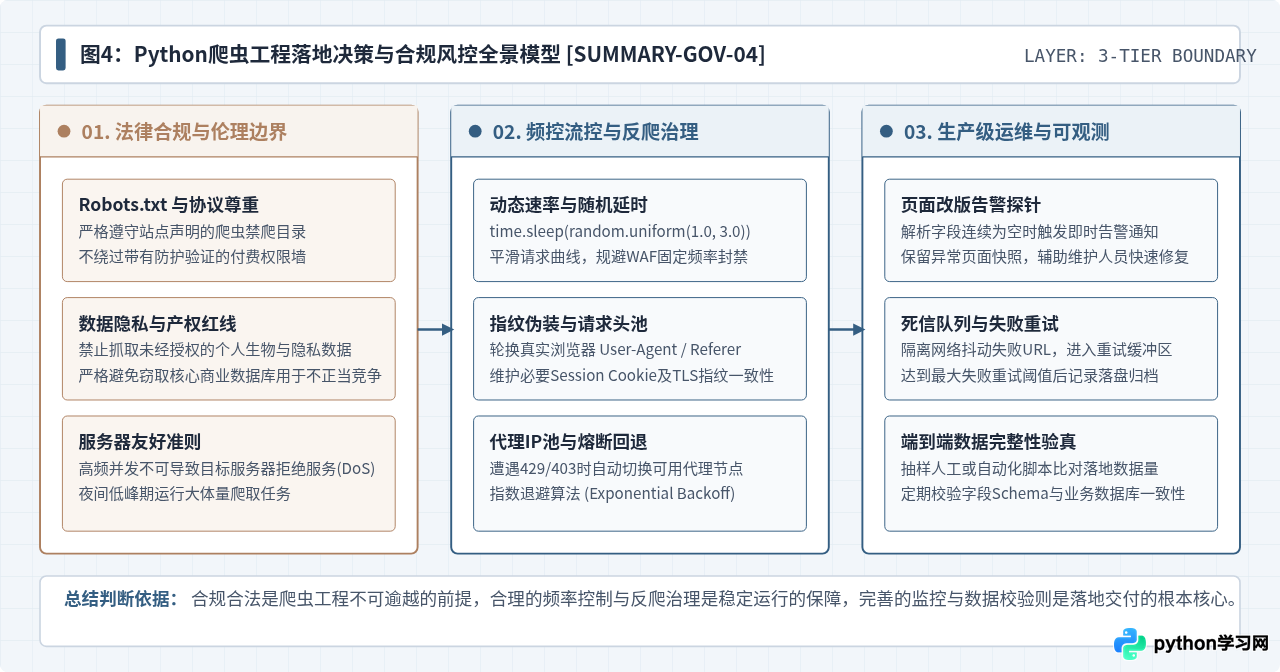
虽然Python爬虫具有压倒性的效率优势,但在实际应用中必须时刻铭记:爬虫是对目标服务器资源的直接调用。缺乏克制的滥用不仅会导致目标服务器过载瘫痪,也容易招致严格的IP封禁乃至触及法律红线。健康的自动化采集必须建立在明确的工程边界和风控规范之上。
1. 频率控制与服务器友好(Server-Friendly Principles)
爬虫在并发能力上远超真实用户,如果不加以节制地发起死循环并发请求,本质上等同于对目标服务器实施拒绝服务攻击(DoS)。在编写爬虫脚本时,必须遵循以下工程控制规范:
- 引入随机延时:在连续请求之间加入
time.sleep(random.uniform(1.0, 2.5)),避免以恒定周期密集请求。 - 错峰采集机制:对于需要抓取数万页的大型全量任务,尽量安排在目标站点访问低峰期的凌晨进行,降低对正常业务用户的影响。
- 尊重HTTP 429响应:当服务器返回
429 Too Many Requests或503 Service Unavailable时,应自动启动指数退避重试(Exponential Backoff),而不是无休止地发起重试轰炸。
2. 反爬机制与工程容错策略
主流网站通常配置有WAF(Web应用防火墙)和反爬策略。工程化爬虫应具备应对常见反爬挑战的韧性:
- 完善请求头伪装:除了配置合法的
User-Agent,还应匹配Accept-Language、Referer及Sec-Ch-Ua等真实浏览器特征指纹。 - 动态渲染应对:对于大量依赖前端Vue/React动态异步渲染的页面,优先抓取其底层的XHR/Fetch JSON数据接口;若接口强签名,再考虑使用Playwright或Selenium等无头浏览器方案。
- 页面结构改版感知:页面改版是爬虫失效的最主要原因。健壮的爬虫系统应在字段解析结果为空时自动记录警告日志并截取当前HTML快照,触发运维告警以便及时调整解析规则。
3. 法律合规与数据边界底线
数据采集的技术行为受到严格的法律法规约束:
- 遵守Robots协议:优先阅读目标站点根目录下的
robots.txt文件,不主动抓取网站明确声明禁止抓取的敏感目录。 - 严禁涉足个人隐私与敏感数据:禁止抓取个人身份证号、联系方式、生物特征等隐私数据,严格遵守《个人信息保护法》与《数据安全法》。
- 严禁突破技术防护墙:不可通过破解密文、逆向漏洞或盗用凭证等非法手段越权获取未公开数据,避免构成非法侵入计算机信息系统犯罪。
- 商业合理使用边界:获取的公开数据不可用于同业竞争对手的恶意搭便车、虚假刷量或破坏目标平台正常商业生态。
五、全文总结
Python爬虫的核心价值,是将人力从低价值、高消耗的机械录入中彻底释放出来,转化为高确定性、可长期复用的代码化数据资产。相比人工采集,它不仅实现了吞吐速率百倍级的飞跃,更在数据一致性、规整清洗和增量巡检上展现出不可替代的工业级工程优势。在日常工作与科研业务中,合理评估采集需求,规范搭建自动化采集管道,并在法律合规与频率控制的框架内审慎运行,是现代数据工程师与业务人员不可或缺的关键技能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















