


Python做数据分析的核心优势:生态库丰富与通用性强
深入解析Python在数据分析领域的两大核心优势:极其完备且高度协同的第三方生态库,以及作为全功能通用编程语言所带来的工程落地与系统集成能力。
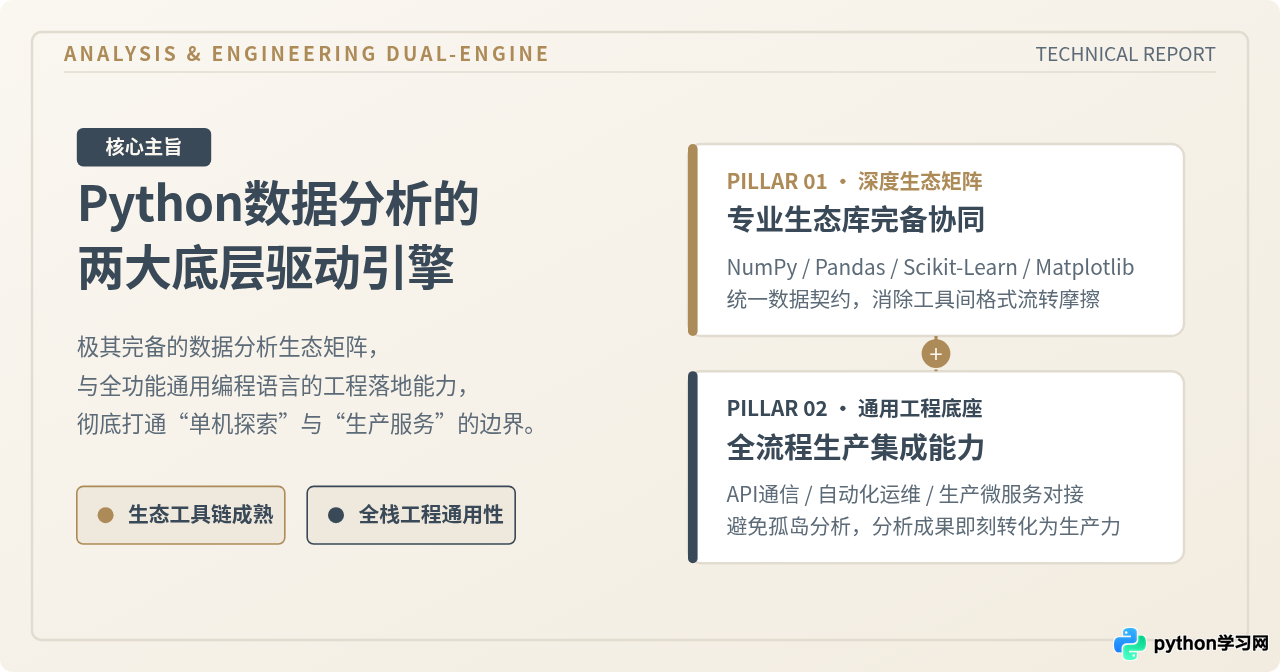
在现代数据分析领域,Python 之所以能够取代传统闭源软件与单一工具链成为行业通用事实标准,核心并不在于其语法本身多么独特,而在于两大无法替代的底层优势:极其完备且高度协同的第三方生态库,以及作为全功能通用编程语言所具备的系统工程集成能力。前者提供了从数据摄取、清洗重塑、统计建模到可视化呈现开箱即用的专业轮子;后者则彻底打破了“数据分析只停留在本地报表”的孤岛局限,使分析逻辑能无缝嵌入自动化系统与生产业务链条中。
一、核心定位:支撑 Python 数据分析的两大底层支柱
讨论 Python 做数据分析,必须先厘清一个常见误区:很多人认为 Python 的流行是因为它“简单好学”。然而在工业界,易学性只能降低入门门槛,真正决定技术选型并建立深厚技术壁垒的,是该技术是否具备解决复杂多变业务问题的综合性价比。
面对现代数据环境,分析人员通常面临两个维度的考验:其一是计算与算法的专业性,要求工具能够处理成百上千万行的高维异构数据、执行复杂的线性代数运算与统计建模;其二是工作流的工程通用性,要求工具不能被限制在特定封闭格式内,而要能直接调用 Web API、读取企业内部数据库、对接消息队列并输出生产级服务。
Python 正好落在这两大维度的交叉点上。它既有经过几十年演进、经受千万级生产环境检验的数学与统计库矩阵,同时又是一门能够编写网络爬虫、搭建后端微服务、操控操作系统底层以及管理云计算资源的通用编程语言。正是这种“双核驱动”,赋予了 Python 极高的综合效能。
二、优势一:高度协同且成熟的专业生态库体系
Python 本身作为一门解释型高级语言,其原生列表和字典在处理大规模数值计算时并不占优势。然而,以 NumPy 为代表的底层生态库通过将底层核心计算交由高效的 C/Fortran 原生指针与连续内存块执行,从根本上解决了运算性能瓶颈。更重要的是,Python 社区围绕统一的数据结构协议,演化出了环环相扣、分工明确的专业库集群。
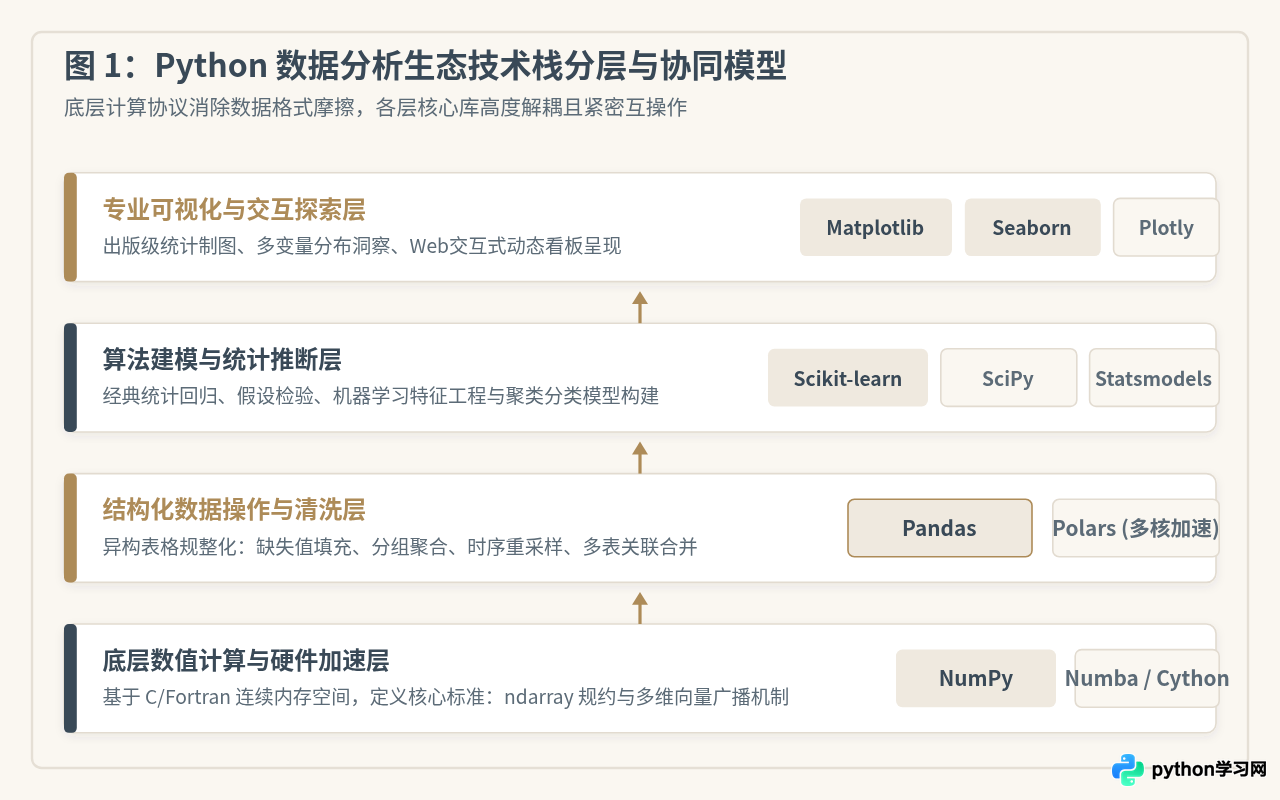
ndarray 到 Pandas 的 DataFrame,上层可视化和机器学习库无需对数据进行序列化中转,即可直接基于内存指针高速调用,极大减少了不同工具间格式转换的性能损耗与出错概率。
这种生态库的丰富性体现在三个关键维度:
- 功能链条的零盲区覆盖: 从底层矩阵运算(NumPy)、二维异构数据治理(Pandas)、统计检验(SciPy/Statsmodels)、经典机器学习(Scikit-learn)到多维制图(Matplotlib/Seaborn),整个数据生命周期无须跳出 Python 环境。
- 统一的内存抽象协议: 在许多其他编程语言中,不同开发者开源的库往往定义了不同的数据容器,导致跨库协同困难。而在 Python 中,NumPy 的向量内存布局与 Pandas DataFrame 已经成为行业公认标准。Scikit-learn 的模型可以直接喂入 Pandas DataFrame,Matplotlib 也原生支持提取其列标签,形成了极其丝滑的调用体验。
- 海量社区沉淀与故障排查经验: 由于这些核心库已被全球数以百万计的工程师持续打磨十余年,在处理时间序列对齐、时区转换、高维稀疏矩阵、非标准日期解析等边缘边界问题时,库内部已封装了完备的防御逻辑,避免开发者重复踩坑。
三、优势二:全功能通用编程语言带来的工程化与集成能力
如果说丰富的生态库解决了“如何算”的问题,那么 Python 作为通用编程语言的强通用性,则彻底解决了“算完之后怎么用”的工程落地难题。这是专用工具(如 Excel、纯 SQL 引擎、专用统计软件等)最显著的短板。
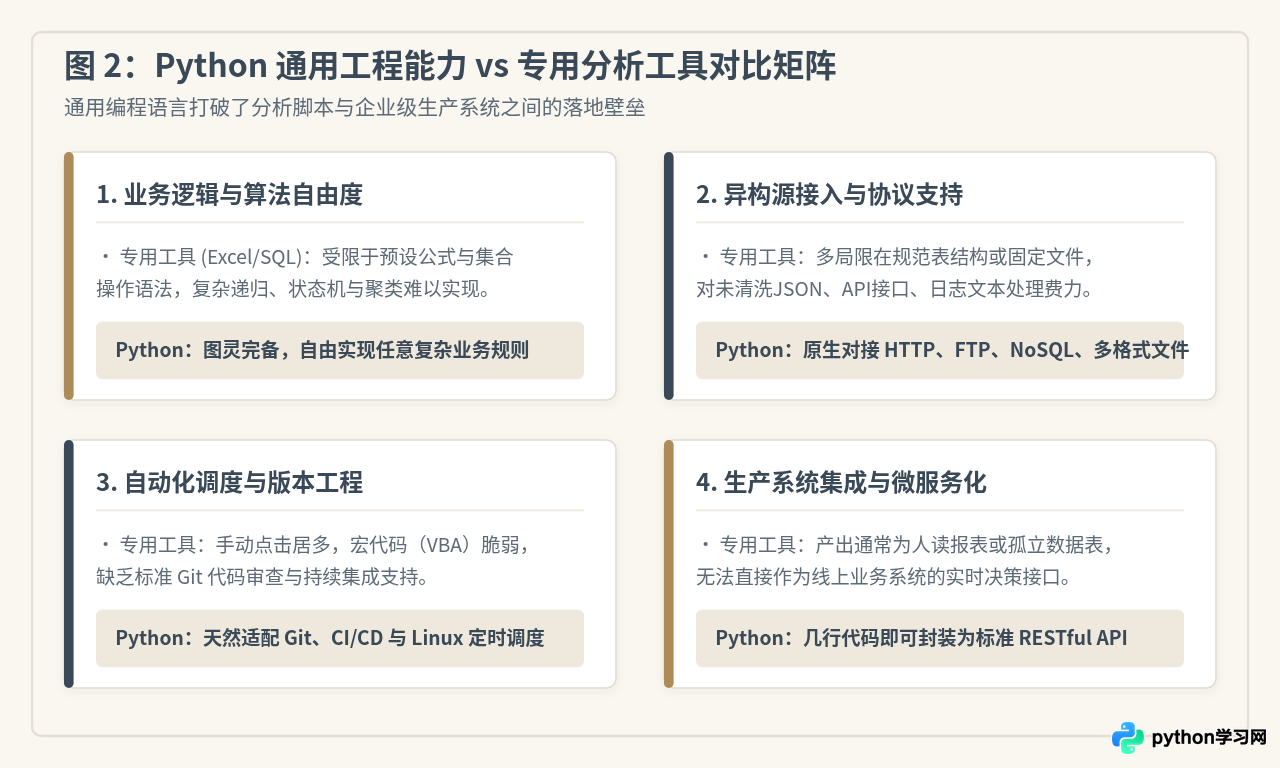
通用编程语言赋予数据分析的具体工程价值主要体现在以下三个方面:
-
无缝拼接“全生命周期”数据链路:
真实业务场景中的数据往往不是整齐划一的数据库表。分析师可能需要先通过网络请求拉取三方公开汇率数据,再解析一批存放在对象存储中的压缩 JSON 日志,最后连同内部关系型数据库的订单表做联合分析。Python 可以轻松在一个脚本中同时使用
requests、json、sqlalchemy等模块搞定全套输入,无需中间文件导来导去。 - 端到端的自动化与持续重跑能力: 使用界面交互式工具完成一次分析后,当下月数据产生变动时,往往需要重新手动点击处理。而 Python 脚本天生具备高度的可重复性(Reproducibility),配合标准参数解析器,可直接部署在 Linux 服务器配合 Cron、Airflow 或 Prefect 实现全自动无人值守调度。
-
分析结果微服务化与系统嵌入:
在完成用户价值分群或销量预测模型后,分析师可以通过
FastAPI或Flask在同一技术栈内直接封装出对外暴露的 HTTP 接口,让前端界面或后端业务系统实时获取预测结果,完成数据价值的“最后一公里”闭环。
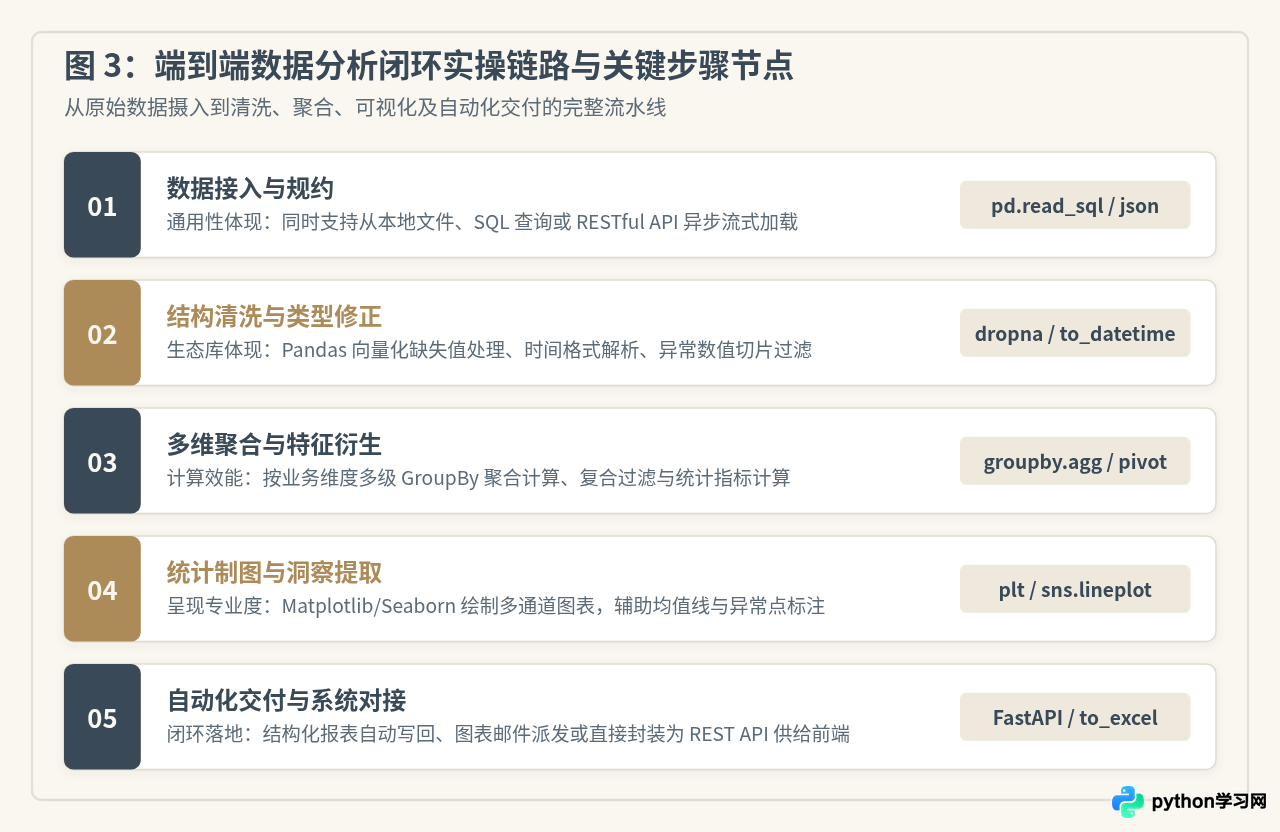
四、实操演练:端到端数据分析的完整闭环操作链路
为了具体展现生态库丰富性与通用性的结合优势,我们通过一个常见的真实业务场景进行演练:分析某业务线全周期的订单流转与客单价特征,并导出汇总数据及出版级趋势图表。
1. 依赖环境准备
在标准 Python 虚拟环境中,完成本链路通常仅需安装三个基础生态库:
pip install pandas matplotlib numpy2. 核心分析逻辑与完整代码
以下脚本完整演示了从构造模拟业务流水数据、数据清洗规范、基于 Pandas 的分组多重聚合,到输出分析图表与指标结构化存储的全流程:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# -------------------------------------------------------------------
# 步骤 1:多源数据模拟生成与载入(通用性:可替换为数据库/接口读取)
# -------------------------------------------------------------------
raw_data = {
    "order_id": ["ORD-101", "ORD-102", "ORD-103", "ORD-104", "ORD-105", "ORD-106", "ORD-107", "ORD-108"],
    "order_date": ["2026-03-01", "2026-03-01", "2026-03-02", "2026-03-02", "2026-03-03", "2026-03-03", "2026-03-03", None],
    "channel": ["线上直销", "线上直销", "分销渠道", "线上直销", "分销渠道", "企业定制", "线上直销", "线上直销"],
    "amount": [420.0, 180.5, 950.0, None, 1200.0, 3400.0, 310.0, 89.0],
    "user_rating": [5, 4, 3, 5, 4, 5, 2, 4]
}

df_raw = pd.DataFrame(raw_data)

# -------------------------------------------------------------------
# 步骤 2:结构清洗与类型约束(生态库:Pandas 链式操作)
# -------------------------------------------------------------------
df_clean = (
    df_raw
    .dropna(subset=["order_date", "amount"]) # 剔除日期或金额缺失的无效订单
    .copy()
)

# 时间列标准化转换,并衍生出日期维度字段
df_clean["order_date"] = pd.to_datetime(df_clean["order_date"])
df_clean["day"] = df_clean["order_date"].dt.strftime("%Y-%m-%d")

# -------------------------------------------------------------------
# 步骤 3:多维指标聚合统计(生态库:Groupby + 向量化聚合)
# -------------------------------------------------------------------
channel_metrics = (
    df_clean
    .groupby("channel")
    .agg(
        order_count=("order_id", "count"),
        total_revenue=("amount", "sum"),
        avg_order_value=("amount", "mean"),
        avg_rating=("user_rating", "mean")
    )
    .reset_index()
    .sort_values(by="total_revenue", ascending=False)
)

# -------------------------------------------------------------------
# 步骤 4:自动化报表导出与打印(通用性:直接对接下游业务流)
# -------------------------------------------------------------------
print("=== 渠道经营分析汇总报告 ===")
print(channel_metrics.to_string(index=False))

# 导出为业务常用的结构化文件
channel_metrics.to_csv("channel_summary_report.csv", index=False, encoding="utf-8-sig")
print("\n[INFO] 已成功将汇总指标持久化为 channel_summary_report.csv")
for row in df.iterrows() 遍历行,这种方式会破坏 NumPy 底层的连续内存加速,使得性能下降数十至数百倍。充分利用生态库设计好的向量函数,是发挥 Python 计算效能的前提。
五、客观审视:Python 数据分析的现实限制与现代应对方案
为了全面理解 Python 的应用边界,避免盲目选型,技术人员必须清晰认识到它的客观限制。Python 的优势建立在其抽象层次与生态黏合度上,但在极端性能场景中,存在两个固有的工程瓶颈:
- 单机全内存载入模式(In-Memory Processing): 标准 Pandas 的设计假设是将所有分析数据一次性完整载入物理内存。当单表数据规模达到几十 GB 甚至上百 GB 时,由于 Pandas 内部索引与对象封箱机制带来的额外开销,往往需要 3~5 倍于原始文件大小的内存容量,极易触发 OOM(Out Of Memory)崩溃。
- 全局解释器锁(GIL)对纯 Python 多线程的限制: 由于 CPython 的 GIL 机制,纯 Python 编写的代码无法直接通过原生多线程实现真正的多核 CPU 算力打满。虽然大部分 C 扩展库(如 NumPy、OpenBLAS)在内部运算时会释放 GIL,但在进行复杂自定义函数清洗时,并行度仍会受到制约。
值得强调的是,Python 活跃且持续进化的生态正在迅速解决这些痛点:
-
单机大规模加速(Polars 与 DuckDB):
近年来兴起的
Polars基于 Rust 语言开发,采用 Apache Arrow 内存格式并自带多线程并行执行引擎;DuckDB则以极轻量的嵌入式方式将全功能列式 OLAP 引擎引入 Python 中。分析人员仍可在熟悉的 Python 语法下操作数十 GB 乃至上亿行数据,享受亚秒级的查询性能。 -
分布式弹性计算(PySpark 与 Ray):
当数据量上升至数 TB 级数仓规模时,Python 代码可以通过
PySpark或Ray调度到分布式计算集群中执行,底层的集群通信与容错由分布式架构承担,而对上层开发者依然暴露友好的 Python DataFrame API。
六、选型指南与总结:何时单用 SQL/Excel,何时必须采用 Python?
在实际工作中,Python 并不排斥其他工具,而是与现有体系优势互补。选择工具的标准应始终取决于“数据规模”、“业务复杂度”以及“后续自动化与系统集成需求”。
| 业务场景类型 | 典型任务特征 | 推荐最佳工具 | 选择理由与判断依据 |
|---|---|---|---|
| 单次小型表格整理 | 数据行数 < 5万,单次会议临时汇报,简单求和透视 | Excel / 电子表格 | 所见即所得,拖拽排版效率最高,无需编写代码与配置运行环境。 |
| 固定报表与基准统计 | 数仓规范建模,日常指标提取、简单过滤与汇总展示 | SQL + BI看板 (Tableau等) | 直接在数据库引擎内做集合筛选,网络开销小,仪表盘交互展示直观。 |
| 多源复杂关联与清洗 | 涉及未规范文本、API调用、跨多数据库混合计算 | Python | 通用编程能力强大,拥有最全面的数据读取驱动与异常容错逻辑。 |
| 进阶算法与机器学习 | 时序预测、客户画像聚类、自然语言分析、因果推断 | Python (主选) | Scikit-learn、Statsmodels 等算法库现成可用,且能平滑接入深度学习框架。 |
| 自动化运维与微服务 | 定时抓取分析、报表告警推送、分析结果对外提供 API | Python (唯一兼备者) | 全栈通用语言属性,分析成果能够直接打包上线,与企业 IT 体系浑然一体。 |
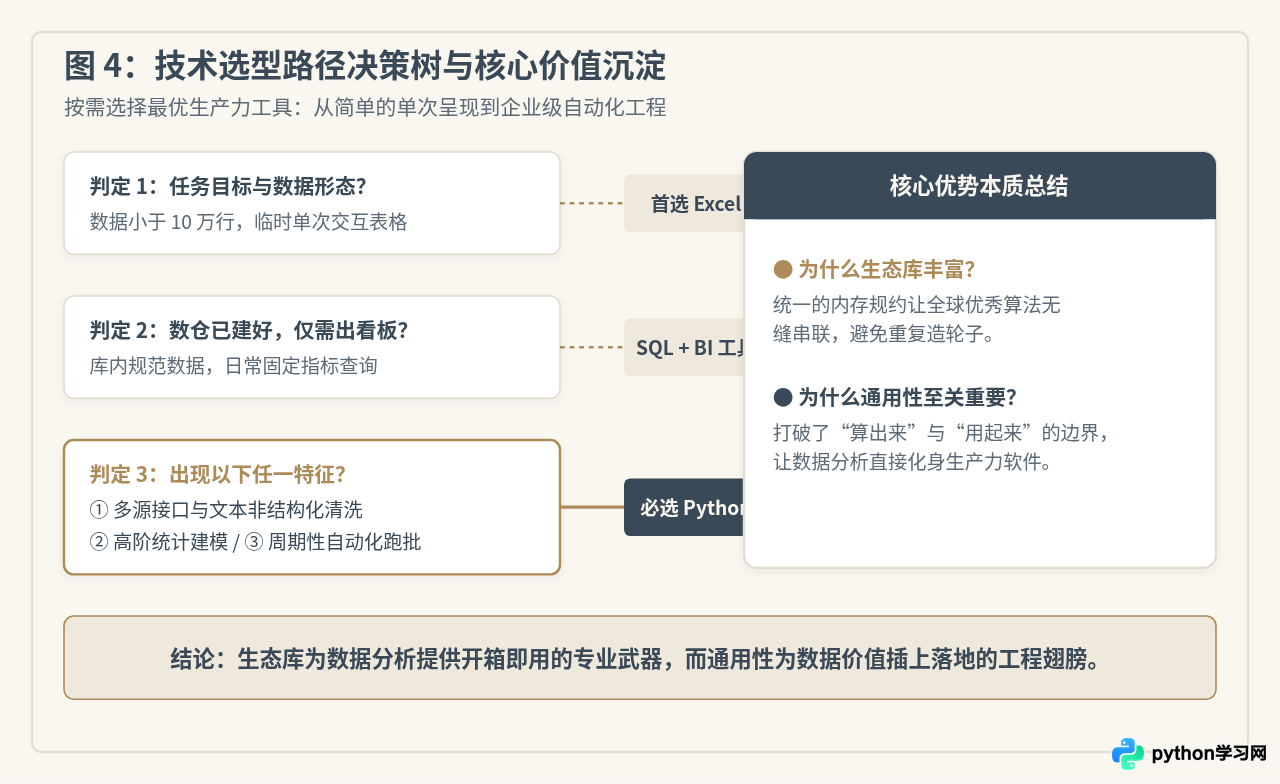
归纳而言,Python 在数据分析领域的统治级地位,并非由某一个语法特性单独促成,而是其庞大深厚的专业生态库与全功能通用编程语言的工程能力深度结合的必然结果。无论是应对复杂的业务场景探查,还是构建现代化的企业自动化数据资产,掌握并善用 Python 的这双核心引擎,都是释放数据生产力的关键路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















