


怎么用Python内置函数简化代码?替代循环的实用技巧
系统讲解如何运用 Python 常用内置函数替代冗长命令式循环,涵盖 sum、any、all、zip、enumerate、map 等核心原语,深入对比字节码与底层 C 循环执行机制,提供重构步骤与最佳实践准则。
for 循环不仅会让代码充斥着累加器、标志变量与多层缩进,还会因为逐行解释执行而损失运行效率。本文系统梳理 sum、any/all、enumerate、zip 等核心内置函数的替换技巧,并通过执行机制剖析与标准化重构步骤,帮助你将机械的显式循环改写为直观、高效的声明式表达。
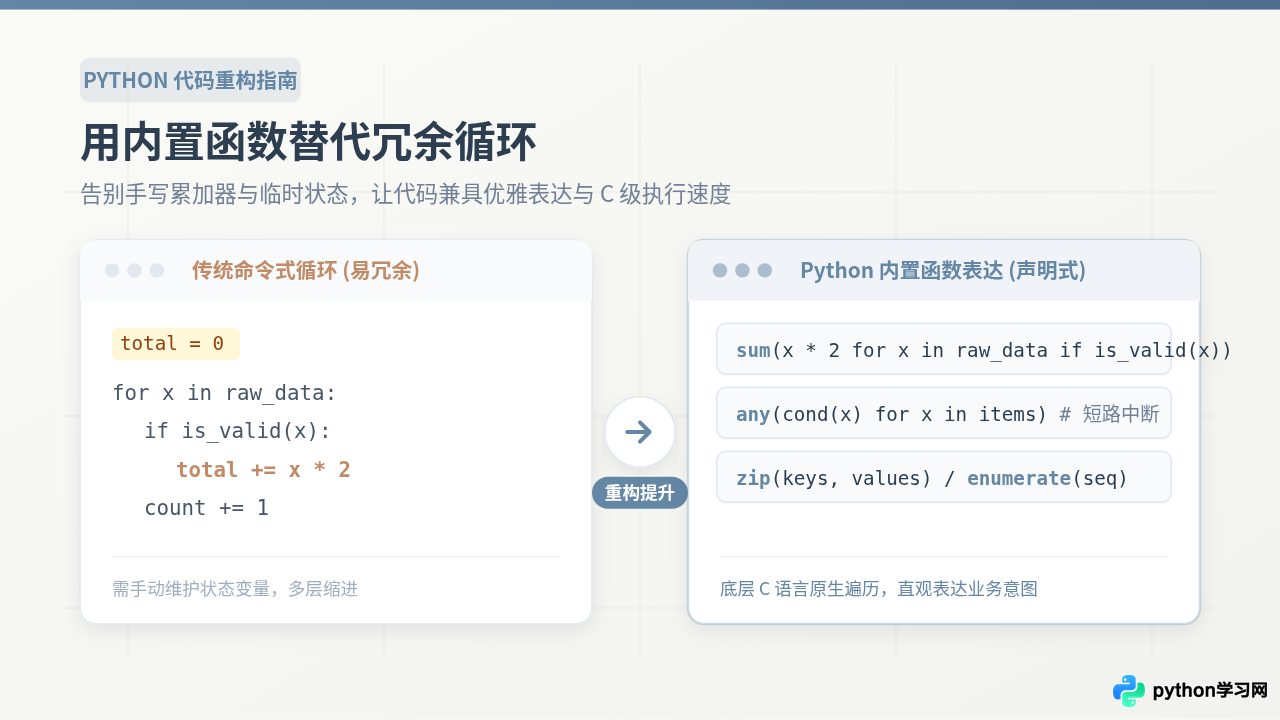
一、为什么要用内置函数替代显式循环?
初学 Python 时,绝大多数人习惯用 for 循环解决一切迭代任务:初始化一个临时空列表或整型变量 total = 0,进入循环逐个读取元素,执行判定或累加,最后返回结果。这种命令式风格虽然直观,但随着业务逻辑增加,容易带来三类显著问题:
- 样板变量污染作用域:循环前往往需要声明用于承载中间状态的哨兵变量(如
found = False、index = 0),这些变量在循环结束后依然滞留在当前命名空间中,容易造成误用。 - 代码意图被算法细节遮蔽:阅读一段嵌套了多层
if与+=的循环体时,阅读者必须在大脑中模拟变量累加与跳转过程,才能理解代码最终只是为了“判断列表中是否存在负数”或“求满足条件的项目总和”。 - 解释器运行开销累积:Python 的普通
for循环依赖解释器逐条分发字节码指令(如FOR_ITER、STORE_FAST、LOAD_FAST)。而在数据量较大时,这种每次循环迭代产生的方法调用与对象解包开销非常可观。
而 Python 提供的各类内置函数,其本质是高度优化的抽象原语。它们在语义上直接回答“要做什么(What)”而不是“一步步怎么做(How)”,并且多数内置函数的内部迭代过程完全在 CPython 的 C 语言原生层运行,既能精简代码篇幅,又能带来立竿见影的性能提升。
二、五大高频场景与内置函数替代技巧
1. 累加与聚合计数:用 sum() 替代手动累加器
统计数值总和或计算满足条件的元素个数,是日常业务中最容易写出冗长循环的场景。
# 需要额外维护 total 状态
orders = [{'amount': 120}, {'amount': 85}, {'amount': 210}]
total = 0
for item in orders:
total += item['amount']# 生成器表达式配合 sum,直奔主题
orders = [{'amount': 120}, {'amount': 85}, {'amount': 210}]
total = sum(item['amount'] for item in orders)
在统计“符合特定条件的项目个数”时,同样无需手写计数器。由于在 Python 中布尔值 True 在数值计算中等价于 1,可以直接将判定条件作为生成项传递给 sum():
# 统计金额超过 100 的订单数量
high_value_count = sum(1 for item in orders if item['amount'] > 100)
2. 存在性与全局一致性检测:用 any() 与 all() 替代查找跳出循环
检查一组数据中“是否存在至少一个满足条件”或“是否所有项均满足条件”时,手写循环往往需要配合 flag 变量和 break 语句,逻辑分散在循环上下文中。
has_invalid = False
for user in users:
    if not user.is_active:
        has_invalid = True
break# 单行表达,且自带短路机制
has_invalid = any(not user.is_active for user in users)
all_active = all(user.is_active for user in users)any() 一旦遇到首个为 True 的元素会立即终止迭代并返回 True;同样,all() 遇到首个为 False 的元素就会立刻返回 False。传入生成器表达式时,后续未访问的元素绝不会被计算,与手写 break 具备完全相同的截断效率。
3. 索引跟踪与双序列关联:用 enumerate() 与 zip() 消除下标计数
如果遍历过程中需要同时使用元素序号,或者需要并行遍历两个长度相关的列表,很多开发者会沿用 C 风格的 range(len(seq)) 或者在循环体内写 index += 1。这既不美观,又极易在边界处引发索引越界异常。
# 场景 A:需要索引序号时使用 enumerate(iterable, start=0)
tasks = ["数据校验", "格式清洗", "入库导出"]
for idx, task_name in enumerate(tasks, start=1):
    print(f"步骤 {idx}: {task_name}")

# 场景 B:同步遍历成对序列时使用 zip()
headers = ["name", "score", "level"]
values = ["Alice", 94, "A"]
user_dict = dict(zip(headers, values))  # 直接将双序列转换为字典
4. 极值定位与条件比对:用 max() 和 min() 的 key 参数替代手动比较
从结构化字典或对象列表中挑选“某个指标最大”的项时,手动比对循环不仅代码繁杂,还需要小心处理空集合初值的问题。
best_player = None
highest_score = -1
for p in players:
    if p['score'] > highest_score:
        highest_score = p['score']
best_player = p# 传入 key 回调与 default 容错值
best_player = max(
players,
key=lambda x: x['score'],
default=None
)
通过指定 key 参数,max() 和 min() 可以在底层一次性完成所有权重计算与比较,同时支持利用 default=None 避免序列为空时抛出 ValueError。
5. 批量类型转换与数据提取:合理运用 map() 与 filter()
当存在现成的函数或类构造器需要直接映射到序列元素时(例如将一组字符串数字批量转为整型),map() 比显式推导式更加精炼:
raw_strings = ["10", "25", "30", "45"]

# 传统循环
parsed = []
for s in raw_strings:
    parsed.append(int(s))

# 内置函数 map:直接传递函数引用与可迭代对象,返回惰性迭代器
parsed = list(map(int, raw_strings))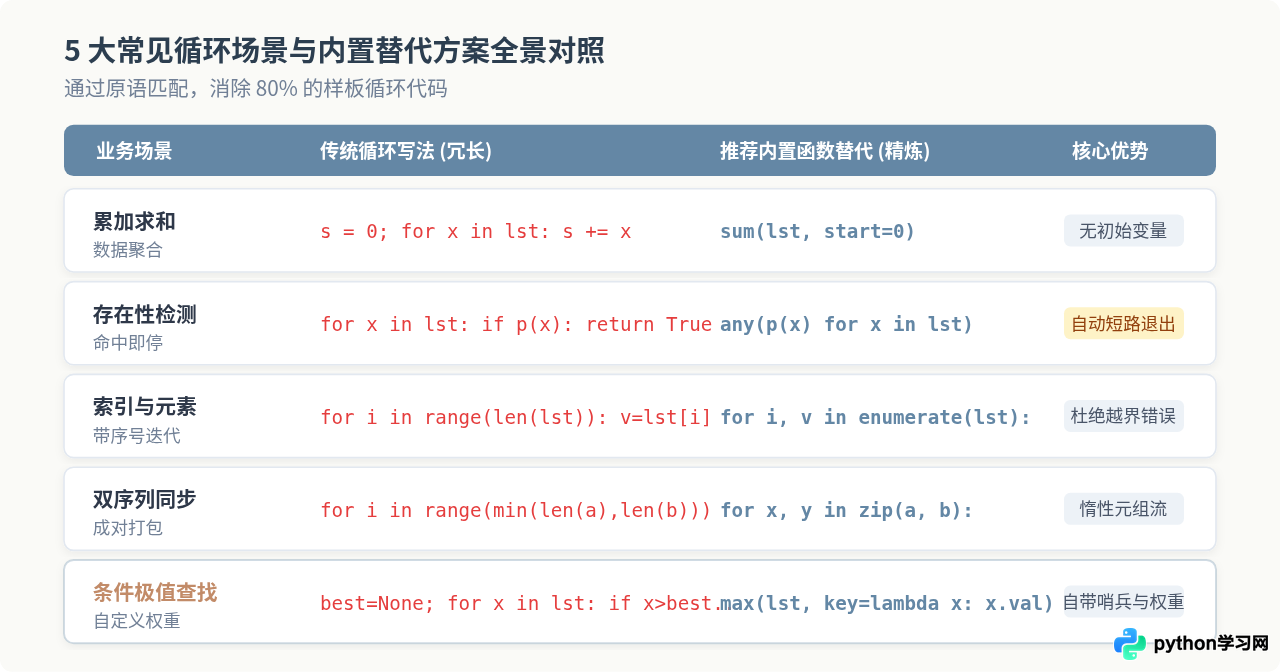
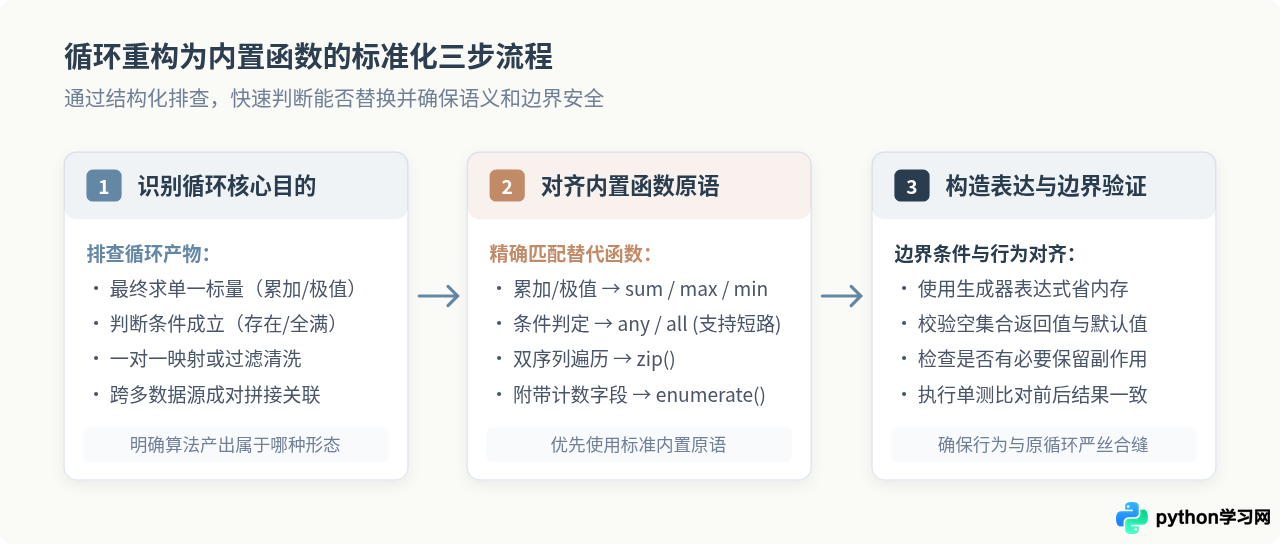
三、从冗长循环到内置函数的标准化重构步骤
面对既有工程中复杂的循环代码,重构不应是盲目的单行压缩,而应遵循明确的步骤来保障代码质量与行为一致性。
-
步骤一:辨别循环的本质归宿
观察当前循环的目标是生成单一计算标量(总数、均值、布尔状态、极值对象),还是生成新的集合。如果只是为了产生单个标量,90% 以上的情况都可以直接对应到sum()、any()、all()、max()、min()。 -
步骤二:匹配对应的内置原语并提取变换函数
将循环体内的取值与过滤规则解耦。如果逻辑纯粹是属性提取或简单数学运算,直接编写生成器表达式(func(x) for x in data if cond(x))喂给对应的内置函数;如果是调用已有标准库函数(如str.strip),则直接结合map()。 -
步骤三:对齐边界语义与单测验证
重点检查两个边界:- 空集合处理:原始循环中如果输入列表为空,输出初始值是多少?替换为
max()/min()时必须显式补齐default=...参数,避免空集合抛出异常。 - 生成器单次消费特性:如果内置函数接收的是生成器,注意该生成器只能被完整遍历一次,若后续仍需复用结果,应显式转为
tuple或list。
- 空集合处理:原始循环中如果输入列表为空,输出初始值是多少?替换为
四、深入剖析:为什么内置函数比普通循环更快?
很多开发者直觉上认为:内置函数底层依然需要遍历数据,因此性能应该和 for 循环相差无几。然而在实际基准测试中,内置函数往往比手写循环快 30% 到 200% 以上。这种性能优势源自 CPython 的底层架构设计。
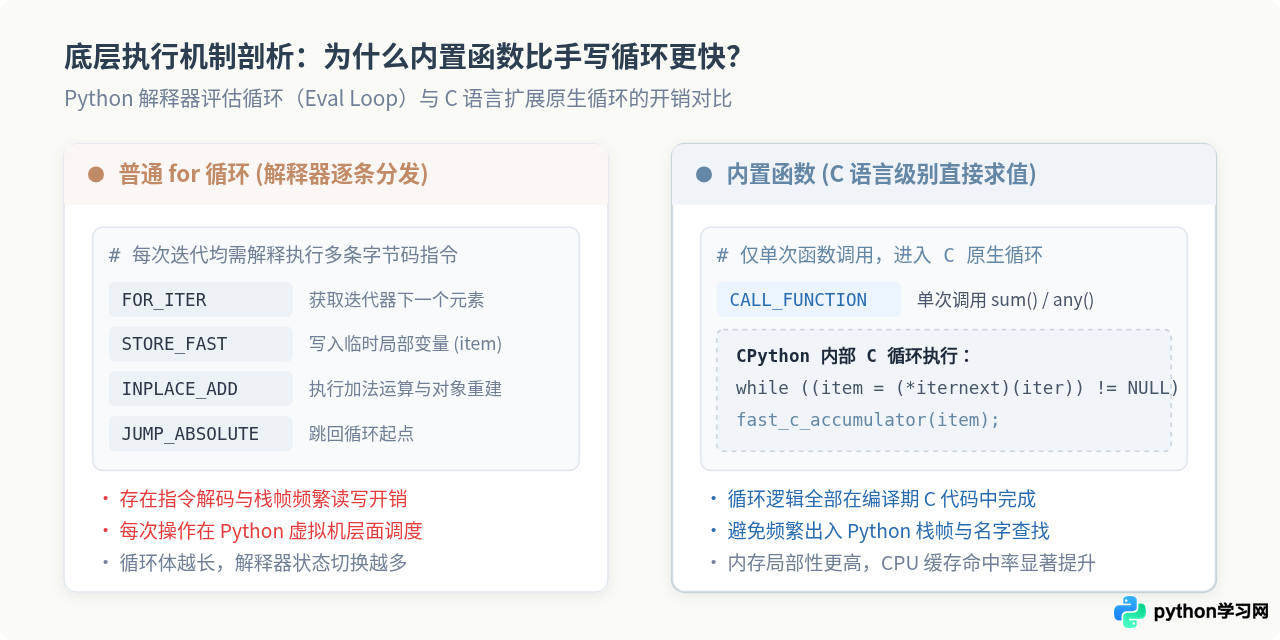
如上图所示,当我们在 Python 中执行一个标准的 for x in data: total += x 时,Python 虚拟机的解释器主求值循环(_PyEval_EvalFrameDefault)必须针对每个元素执行以下动作:
- 通过
FOR_ITER指令调用迭代器的__next__方法; - 将解包出来的对象引用通过
STORE_FAST写入 Python 局部命名表; - 通过
LOAD_FAST重新将操作数压入计算栈,执行INPLACE_ADD; - 执行跳转指令
JUMP_ABSOLUTE回到循环头部。
整个过程全部在解释器的字节码分发机制中反复打转。而当我们调用 sum(data) 时,Python 只需执行单次 CALL_FUNCTION,便直接进入 C 语言编译好的 builtin_sum 函数内部。C 语言的 while 循环直接在连续内存地址上调用指针迭代,彻底省去了中间的指令解码、操作数入栈出栈以及作用域变量查找开销。
五、适用边界:什么时候不应该替代循环?
尽管内置函数具备诸多优势,但这并不意味着所有的循环都应该被消除。若为了追求所谓的“一行流(One-liner)”而强行压缩复杂代码,反而会严重损害项目的可读性与可维护性。
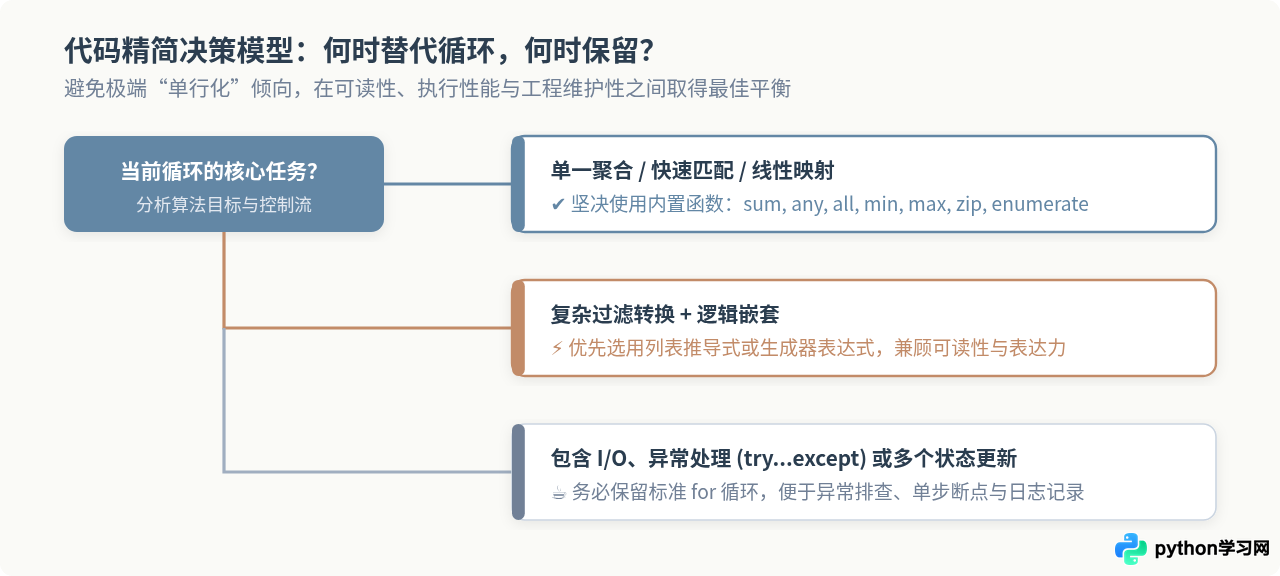
遇到以下情况时,建议坚决保留清晰的常规 for 循环:
- 循环体内包含明显的外部副作用:例如在循环中写文件、发送 HTTP 请求或更新数据库记录。函数式原语的设计初衷是纯计算,在内置函数表达式中塞入副作用会让代码行为难以预测。
- 需要精细的异常捕获与局部重试:如果在单次迭代中需要针对特定记录执行
try...except处理或打印局部告警日志,传统的for循环能提供更清晰的执行轨迹与单步调试体验。 - 业务逻辑分支多且深度嵌套:如果一次遍历中需要根据 3 个以上的条件分支更新 4 个不同的业务状态,强行拆解为多个内置函数会导致数据被重复遍历多次;此时使用单一
for循环统一更新状态是最佳方案。
六、总结
使用 Python 内置函数替代繁琐的命令式循环,关键在于建立从“操作过程”到“数据契约”的思维转变。在日常编码中,建议优先采用以下自查清单:
- 需要累加或统计个数?优先选择
sum(); - 需要寻找是否存在或是否全部符合?果断使用具备短路特性的
any()和all(); - 需要同步双列表或序列计数?使用
zip()和enumerate()摒弃下表操作; - 涉及复杂状态更新或 I/O 副作用?坦然保留清晰、直观的常规
for循环。
合理运用这些内置原语,不仅能消除 80% 以上的样板循环代码,还能让你的 Python 程序在保持优雅表达的同时,充分释放底层 C 语言级别的高效性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















