


Python打印调试技巧:怎么清晰输出复杂数据结构
针对Python中复杂嵌套字典、列表、自定义类及海量数据集难以清晰打印的问题,本文系统讲解原生print的局限、内置pprint与json.dumps核心参数控制、自定义对象解构以及Rich与IceCream进阶调试工具的选型与使用方法。
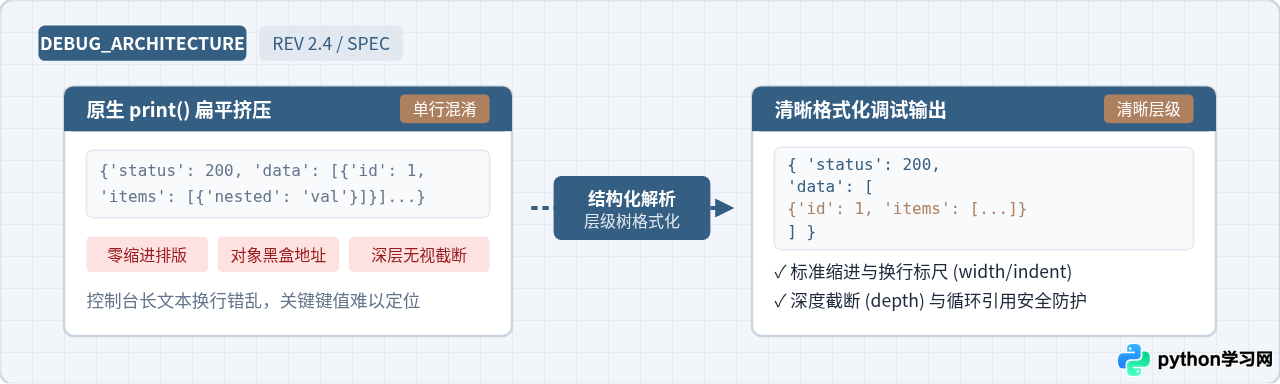
在 Python 日常开发与调试过程中,直接调用 print() 输出多层嵌套字典、列表或自定义对象时,控制台通常会将其压缩为一行极其冗长且无缩进的文本,关键字段难以辨认。清晰输出复杂数据结构的核心解法是:在无第三方依赖的环境下,优先使用内置 pprint 模块控制深度与行宽,或使用 json.dumps() 格式化纯数据结构;在允许安装辅助工具的本地开发环境中,使用 rich.print() 获取彩色语法高亮,或使用 icecream 自动打印变量名与代码行号。本文将逐一讲解这些工具的具体用法、参数调节方法以及应对复杂对象的解构技巧。
一、原生 print() 的排版局限与调试痛点
Python 原生的 print() 函数在设计上追求通用与轻量,其底层通过调用对象的 __str__() 方法获取字符串表示并写入标准输出。对于整数、浮点数或简短字符串,原生输出足够直接;但当面对嵌套字典、包含列表的元组或包含复杂属性的自定义类时,原生输出存在以下明显局限:
- 单行挤压缺乏缩进:无论数据结构包含多少层嵌套,
print()默认不会主动插入换行和层级缩进,导致在控制台或日志中横向拉伸数百字符,难以肉眼区分父子从属关系。 - 自定义对象呈现黑盒:对于未实现详细
__repr__()的普通类实例,print()仅输出类似<User object at 0x7fa2b041a280>的内存地址,无法直接观察其实际属性值。 - 海量集合容易刷屏:面对上万个元素的列表或字典,原生
print()会全量向终端倾泻文本,造成控制台假死、日志文件急剧膨胀,且缺乏深度的截断机制。
以下示例展示了原生输出面临的直观对比:
# 示例代码:使用原生 print 输出多层嵌套数据
user_data = {
    "user_id": 10428,
    "profile": {"name": "林工", "dept": "平台工程部", "active": True},
    "tags": ["python", "backend", "devops"],
    "permissions": {"read": True, "write": False, "admin": False},
    "history": [{"action": "login", "ip": "192.168.1.10"}, {"action": "query", "target": "orders"}]
}

print("【原生 print 示例输出】:")
print(user_data)
# 示例输出(所有层级强行拼接为单行):
【原生 print 示例输出】:
{'user_id': 10428, 'profile': {'name': '林工', 'dept': '平台工程部', 'active': True}, 'tags': ['python', 'backend', 'devops'], 'permissions': {'read': True, 'write': False, 'admin': False}, 'history': [{'action': 'login', 'ip': '192.168.1.10'}, {'action': 'query', 'target': 'orders'}]}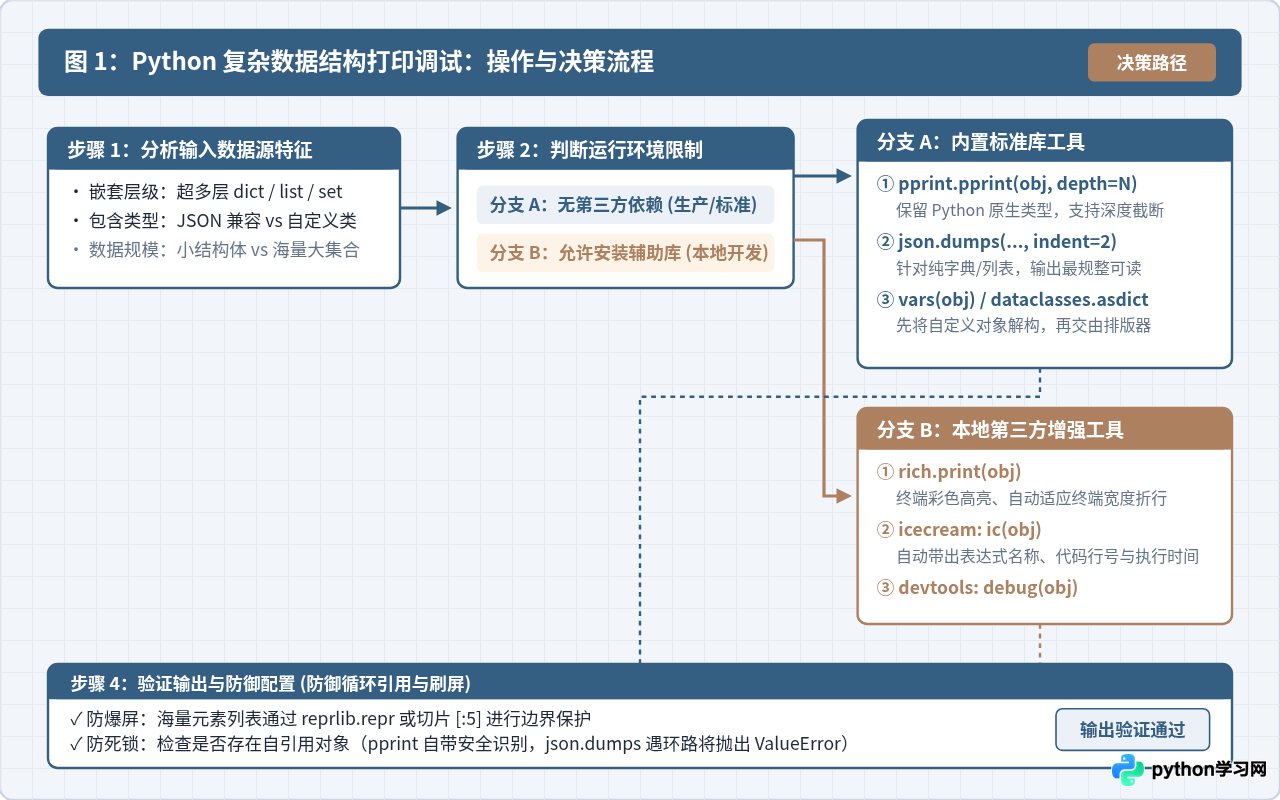
二、标准库首选:掌握 pprint 模块的参数控制
在绝大多数生产服务器或严格限制外部依赖的环境中,Python 标准库自带的 pprint(PrettyPrinter)模块是首选解决方案。它能够保留 Python 原生数据类型(如集合 set、元组 tuple),并根据设定的宽度和深度自动完成格式化排版。
1. 基础调用:pprint() 与 pformat()
pprint 模块提供两个核心入口:pprint.pprint() 直接向控制台或指定流输出格式化文本;pprint.pformat() 则将排版完成的内容作为字符串返回,适合用于写入日志系统(如 logging.info())。
import pprint

# 直接打印到控制台
pprint.pprint(user_data)

# 格式化为字符串后传递给日志器
formatted_str = pprint.pformat(user_data)
# logging.debug(f"用户上下文详情:\n{formatted_str}")
2. 精准控制排版:核心参数解析
pprint 的强大之处在于可以通过灵活的参数微调输出形态:
indent(缩进量):默认为 1。建议显式设为2或4,使各层级在视觉上具备清晰的阶梯感。width(行宽上限):默认阈值为 80 个字符。排版引擎会尽可能在不超过width的前提下保留行内结构;一旦超出,将自动拆解换行。若在笔记本窄屏或拆分窗口调试,可调小至50;在宽屏终端调试可设为120。depth(最大嵌套深度):控制递归展开层级。若结构极深或只需观察顶层概况,可设为depth=2。超出深度的子节点会被自动替换为...。compact(紧凑模式):默认为False。当设为True时,多项简单元素会尽量横向填满单行后再换行。sort_dicts(字典排序):Python 3.8+ 新增参数,默认为True。开启时会对字典键按字母排序,便于两次输出之间进行 diff 比对;若需要严格观察业务插入顺序,可设为sort_dicts=False。
# 示例代码:使用参数精细控制 pprint 输出
deep_structure = {
    "service": "order-api",
    "cluster": {"node_a": {"status": "ok", "metrics": {"cpu": 12, "mem": 45}},
                "node_b": {"status": "degraded", "metrics": {"cpu": 88, "mem": 92}}},
    "endpoints": ["/api/v1/orders", "/api/v1/pay", "/api/v1/refund"]
}

print("【pprint 深度控制示例 (depth=2)】:")
pprint.pprint(deep_structure, indent=2, width=60, depth=2)
# 示例输出:
【pprint 深度控制示例 (depth=2)】:
{ 'cluster': {'node_a': {...}, 'node_b': {...}},
'endpoints': ['/api/v1/orders',
'/api/v1/pay',
'/api/v1/refund'],
'service': 'order-api'}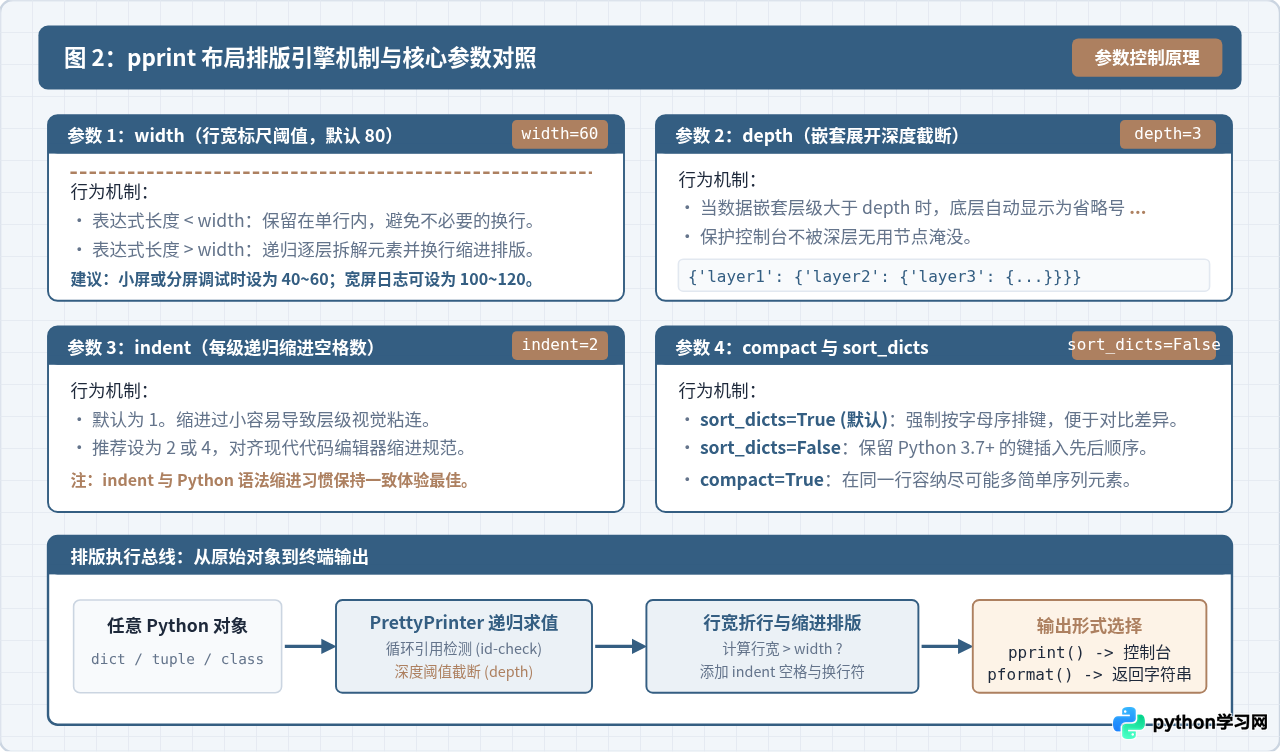
三、结构化序列化:用 json.dumps 格式化数据字典
如果打印的目标数据主要是字典、列表、数字和字符串(例如从 Web 接口获取的响应报文或配置文件),使用标准库 json.dumps() 能够输出业界最为通用的缩进格式。
1. 常用参数搭配
使用 json.dumps() 打印调试时,务必注意配置以下三个参数:
indent=2或indent=4:开启多行阶梯缩进。ensure_ascii=False:默认情况下中文会被转义为\uXXXX形式的 Unicode 编码,设置此项可直接输出可读中文字符。sort_keys=True:按键名排序输出,便于肉眼检索长字典。
import json

payload = {
    "ret_code": 0,
    "message": "查询成功",
    "records": [
        {"id": 101, "item": "显示器", "count": 2},
        {"id": 102, "item": "机械键盘", "count": 1}
    ]
}

print("【json.dumps 格式化示例】:")
print(json.dumps(payload, indent=2, ensure_ascii=False, sort_keys=True))
# 示例输出:
【json.dumps 格式化示例】:
{
"message": "查询成功",
"records": [
{
"count": 2,
"id": 101,
"item": "显示器"
},
{
"count": 1,
"id": 102,
"item": "机械键盘"
}
],
"ret_code": 0
}json.dumps 无法直接序列化 set、datetime 或自定义类实例,强行传入会抛出 TypeError: Object of type ... is not JSON serializable。针对此类对象,可传入 default=str 将非标对象降级为字符串,或者先通过解构函数转化为基础类型。
四、自定义类与复杂对象的解构输出
在面向对象设计中,直接打印自定义类的实例往往只能得到内存地址。为了在调试时看清内部状态,可以采取以下三种递进手段。
1. 重写类的 __repr__ 魔法方法
__str__() 主要面向最终用户,而 __repr__() 面向开发者调试。在自定义类中显式实现 __repr__(),不仅能在单变量打印时见其属性,而且当该对象被放入 list 或 dict 中被 pprint 打印时,也能递归展现其内部结构:
class Device:
    def __init__(self, device_id: str, ip: str, port: int):
        self.device_id = device_id
        self.ip = ip
        self.port = port

    def __repr__(self):
        return f"Device(id={self.device_id!r}, ip={self.ip!r}, port={self.port})"

devices = [Device("dev-01", "10.0.0.1", 8080), Device("dev-02", "10.0.0.2", 9000)]
pprint.pprint(devices, width=40)
2. 使用 dataclass 自动生成与转换为字典
对于数据载体类,推荐使用标准库 dataclasses。@dataclass 会自动合规生成包含所有字段的 __repr__();同时,使用 dataclasses.asdict() 可无缝转换为原生字典,直接交由 pprint 或 json.dumps 打印:
from dataclasses import dataclass, asdict

@dataclass
class ServerNode:
    name: str
    ip: str
    cores: int
    is_master: bool

node = ServerNode(name="worker-1", ip="192.168.0.5", cores=16, is_master=False)

# 1. 直接输出 dataclass 实例(自动具备良好 repr)
print("【dataclass 直接输出】:", node)

# 2. 转换为 dict 进行深度层级打印
pprint.pprint(asdict(node), indent=2)
3. 通用反射与 reprlib 截断防护
对于未实现 __repr__ 且无法修改源码的三方库对象,可以使用内置函数 vars(obj) 或访问 obj.__dict__ 临时提取其实例属性字典。
当对象内部包含数千项的长序列时,若直接全量输出会导致刷屏。标准库 reprlib 提供了带限制的缩略功能:
import reprlib

huge_dataset = {"id": "task-99", "samples": list(range(10000))}

# 使用 reprlib 自动将中间长列表折叠
print("【reprlib 智能截断示例】:")
print(reprlib.repr(huge_dataset))
# 示例输出:
【reprlib 智能截断示例】:
{'id': 'task-99', 'samples': [0, 1, 2, 3, 4, 5, ...]}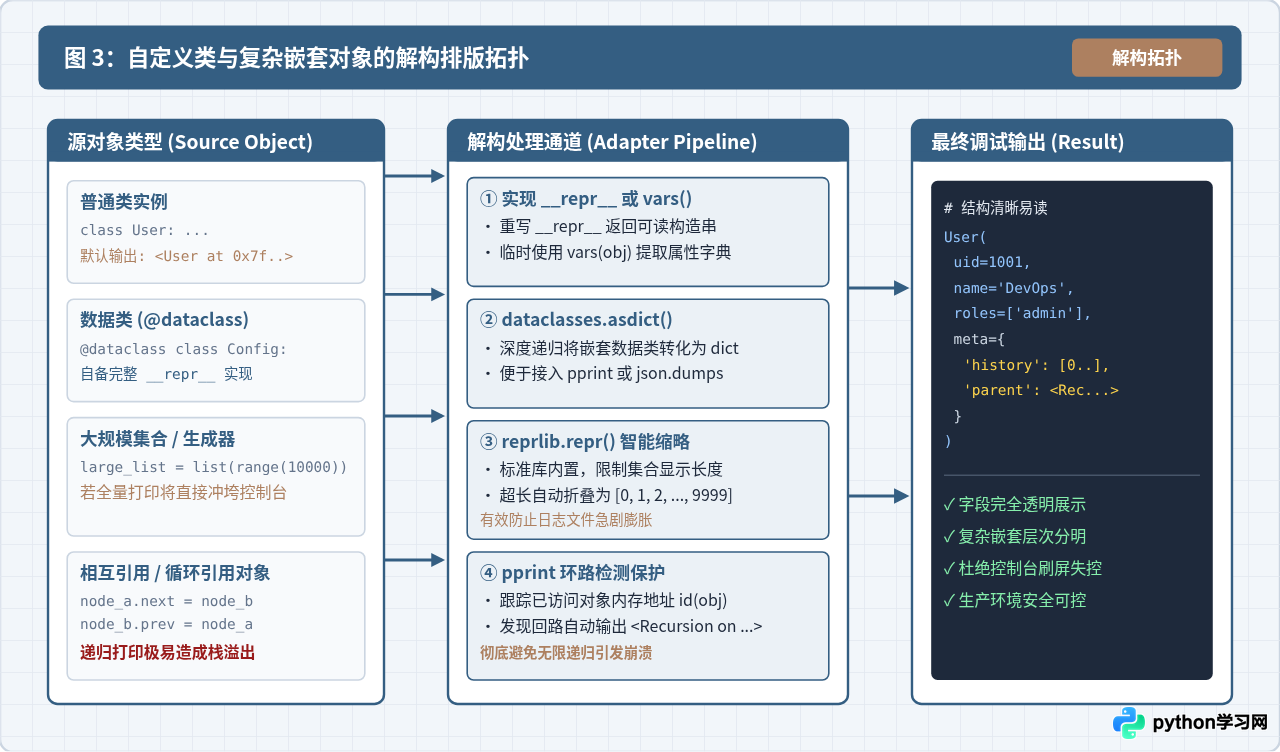
五、本地调试增强:Rich 与 IceCream 进阶工具
在本地日常编码、单元测试排查或交互式终端环境中,引入专注开发者体验的第三方库能够显著提升排查效率。
1. rich.print:彩色终端与自适应折行
rich 是现代 Python 最受欢迎的终端美化库。通过 from rich import print 覆盖原生打印,或直接使用 rich.print(),可以获得开箱即用的语法高亮,不同类型(字符串、数字、布尔值、None)会以不同色彩标记。此外,它还能够根据当前终端窗口的实际像素与列宽自适应重排版:
# 安装命令:pip install rich
from rich import print as rprint

complex_tree = {
    "application": "payment-service",
    "version": "2.1.0",
    "online": True,
    "metrics": {"qps": 4250.8, "errors": None},
    "tags": ["prod", "critical", "fintech"]
}

# 控制台将按彩色高亮且规整排版输出
rprint(complex_tree)
2. icecream (ic):告别盲打变量名与行号
在日常使用 print() 调试代码逻辑时,开发者往往需要写出 print(f"resp: {resp}") 或 print(">>> step 2 <<<")。第三方库 icecream 提供的 ic() 函数通过抽象语法树(AST)自动解析表达式自身:
- 自动打印被调用的变量名或表达式文本本身及其当前值;
- 可配置输出所在源文件名、函数名及具体行号;
- 在函数中包裹返回值时,
ic(expr)会原样返回expr,允许无缝插入到链式调用或赋值语句中。
# 安装命令:pip install icecream
from icecream import ic

def compute_tax(price, rate=0.08):
    tax = price * rate
    # 直接在表达式中审查,不破坏原有计算逻辑
    return ic(price + tax)

result = compute_tax(100)
# 示例输出:
ic| price + tax: 108.0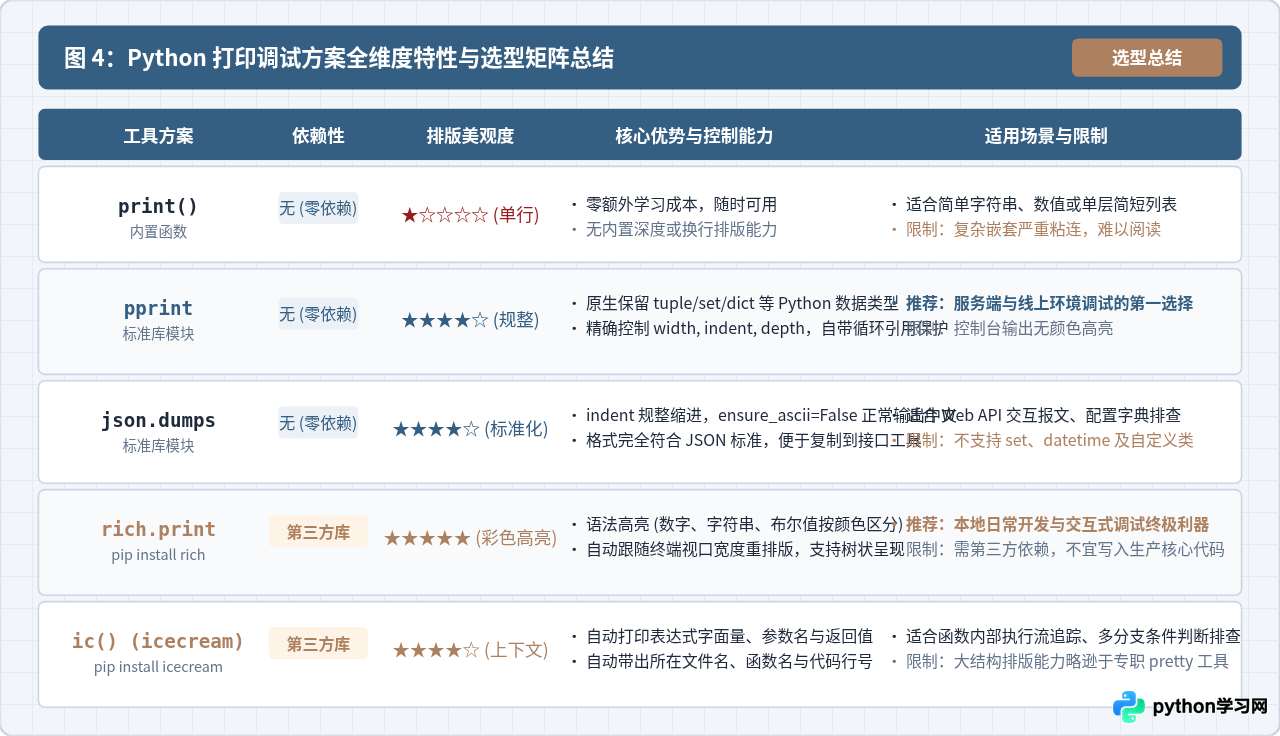
六、排查陷阱与避坑指南
在打印复杂数据结构时,有两处极易引发程序异常或生产隐患的边界情况需要特别留意:
- 循环引用引发的崩溃:当对象 A 引用了对象 B,而对象 B 反向引用了对象 A(如双向链表、复杂图结构或父子组件树),递归遍历可能导致
RecursionError: maximum recursion depth exceeded。- 标准库
pprint内置了访问地址检测,能安全识别环路并将其标记为<Recursion on ...>,不会导致程序中断; - 若误用
json.dumps()序列化循环引用结构,将直接抛出ValueError: Circular reference detected,在网络报文打印前需先行剥离环路。
- 标准库
- 调试打印遗留在生产代码中的 I/O 损耗:格式化超大型嵌套对象(如包含数十万条记录的数据帧或字典)属于 CPU 密集与 I/O 阻塞操作。在生产环境中应统一接入
logging模块并设置日志级别(如DEBUG),避免在未判断日志开关前直接执行昂贵的pprint.pformat()计算。
七、总结与选型建议
| 调试场景 | 推荐方案 | 典型用法 | 选用理由 |
|---|---|---|---|
| 生产/容器环境(零依赖) | pprint.pprint() |
pprint(obj, indent=2, width=80, depth=3) |
标准库内置,类型保留完整,支持截断与循环引用保护 |
| Web API 交互与配置排查 | json.dumps() |
json.dumps(obj, indent=2, ensure_ascii=False) |
标准 JSON 格式,可直接复制到 API 测试工具中复用 |
| 本地交互终端开发 | rich.print() |
from rich import print; print(obj) |
彩色语法高亮,自动匹配控制台列宽,视觉体验最佳 |
| 函数逻辑与执行流跟踪 | icecream (ic) |
ic(variable_or_expr) |
自动带出代码行号与表达式字面量,省去手动拼接标签 |
| 海量数据集防爆屏 | reprlib.repr() |
reprlib.repr(huge_list) |
内置智能折叠算法,防止控制台假死与磁盘写满 |
理解上述各工具的特性与适用边界后,可以在日常开发中根据环境约束与调试目的灵活组合:线上排查与日志记录以 pprint 为基石,纯数据校验结合 json.dumps,本地终端开发借助 Rich 与 IceCream 提效,从而彻底摆脱混乱单行打印带来的排查困扰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















