


Python连接MySQL数据库存储中文乱码的解决方法
针对Python连接MySQL存储中文出现乱码或报错的问题,详细解析字符编码流转链路、排查定位步骤、库表与驱动的utf8mb4配置方案及常见认知误区。
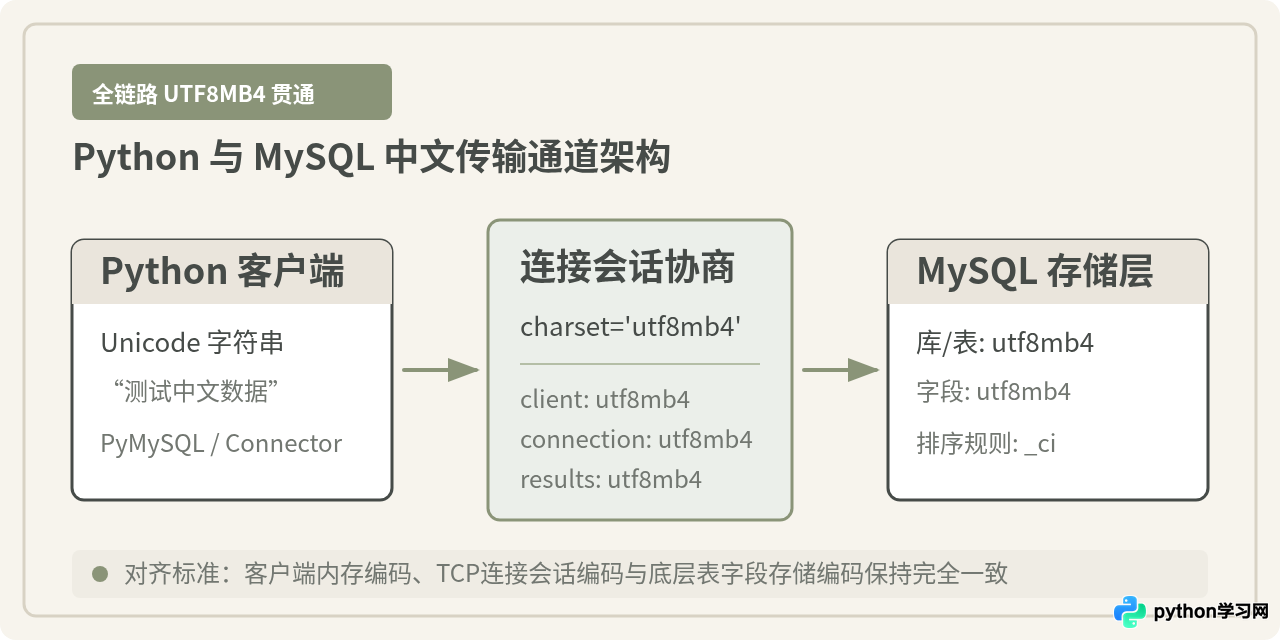
1366 Incorrect string value,本质原因是“Python 驱动连接编码”、“MySQL 连接会话编码(client / connection / results)”以及“数据表与列的存储字符集”三者之间存在失配,或者误用了仅支持 3 字节的 utf8(utf8mb3)。彻底解决该问题的方法只有一个:将 MySQL 数据库、数据表及文本字段统一设置为 utf8mb4,并在 Python 连接驱动(如 PyMySQL、mysql-connector 或 SQLAlchemy)中显式指定 charset='utf8mb4',完成全链路对齐。
一、乱码的具体表现与底层传输机制
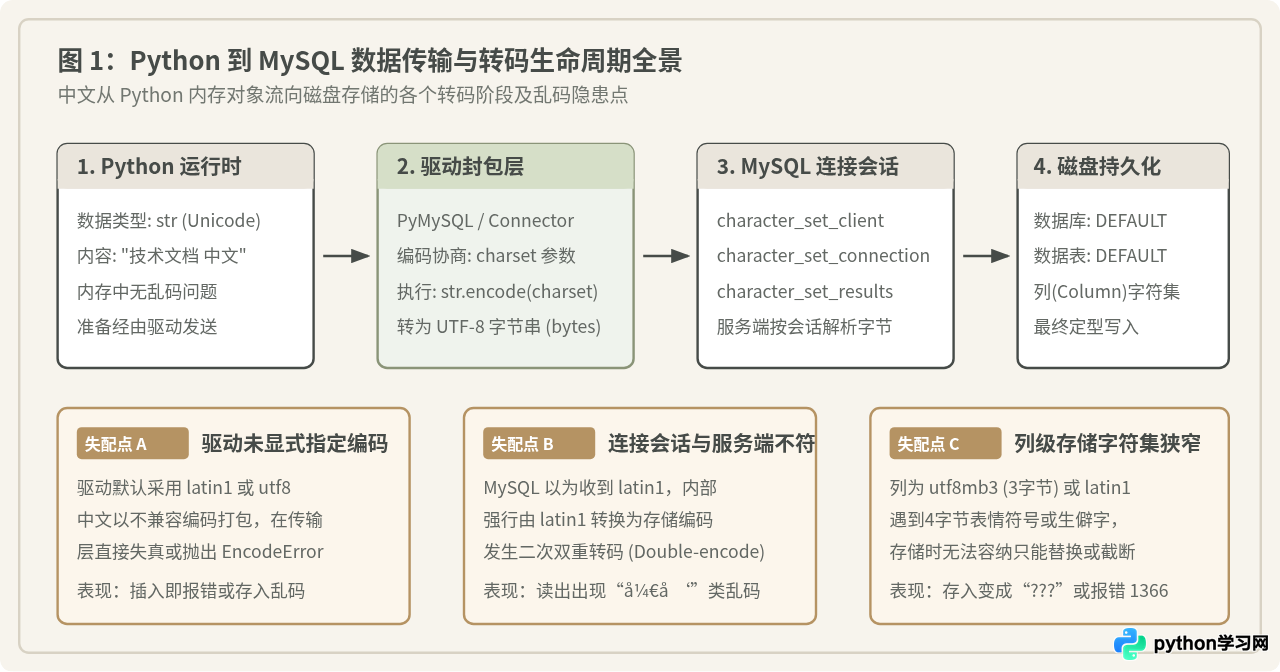
在 Python 程序与 MySQL 交互时,中文乱码通常以三种典型形态出现:
- 形态一:写入时抛出异常。程序报错
OperationalError: (1366, "Incorrect string value: '\xE4\xBD\xA0' for column ..."),常见于数据表列定义为latin1或包含 Emoji 表情(4 字节)时存储到 3 字节的utf8列中。 - 形态二:存储为一连串问号(如“???”)。数据能够正常插入,但在 MySQL 命令行或管理工具中查看时,中文字符全部变成英文半角问号。这是因为字符在通过连接层或落盘时,目标编码集无法识别该字节,被强行替换为占位替代符(0x3F)。
- 形态三:变成西欧拼音重音杂乱字符(如“å¼€å ‘è€…”)。这种现象通常是“双重编码”(Double-encoding)导致的:Python 以 UTF-8 字节流发出数据,但连接通道将其当作单字节的
latin1重新打包存储,导致读取时按西欧字符还原。
要理清这些现象的起因,必须还原数据从 Python 内存到磁盘的流转过程。Python 3 运行时的字符串(str)在内存中全部采用统一的 Unicode 存储,此时是不存在乱码概念的。当调用 cursor.execute() 发送 SQL 时,驱动程序需要将 Unicode 字符编码为具体的网络字节序列,经过 TCP 套接字发送给 MySQL 服务端,服务端会话层再根据内部字符集变量解析,最后按照目标表和字段的定义写入磁盘文件。
二、排查与定位:确认失配的具体环节
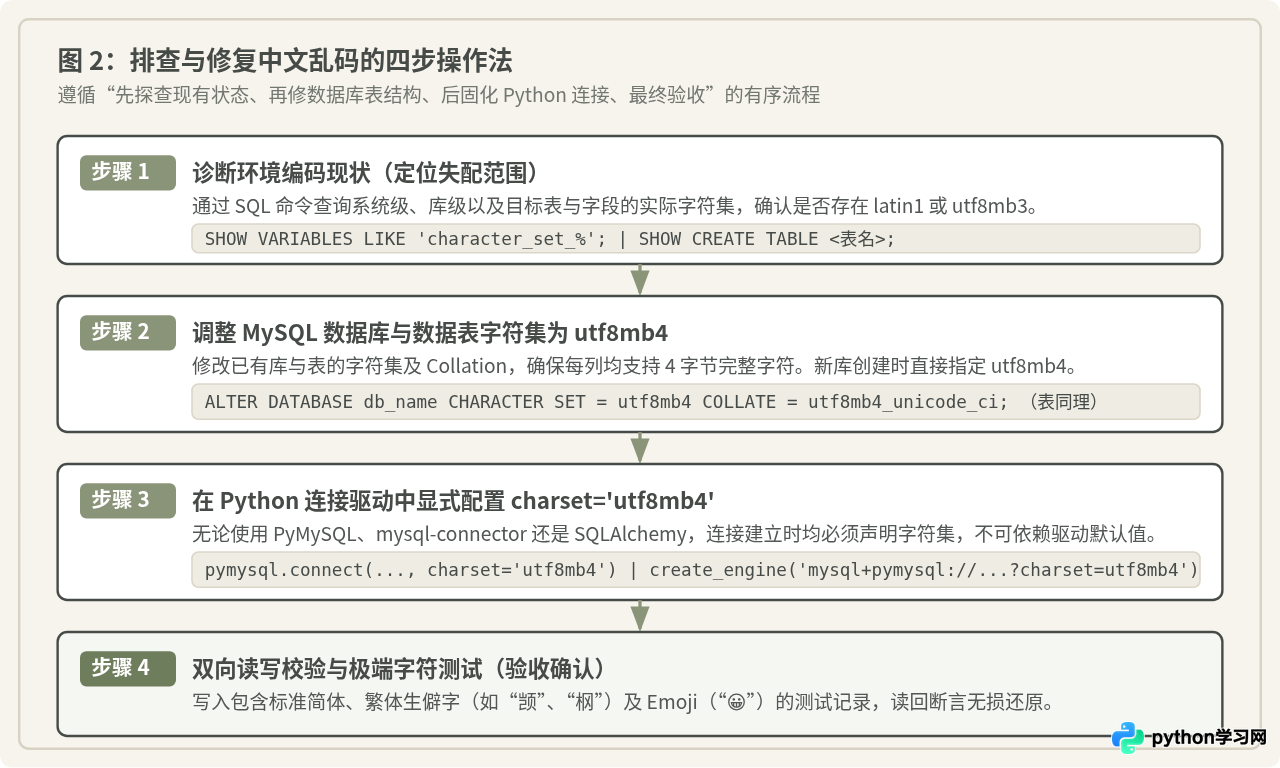
当乱码发生时,切勿盲目尝试各种转码函数,应先登录 MySQL 执行诊断命令,确定问题究竟出在“数据库表结构”还是“客户端连接会话”。
1. 检查 MySQL 实例当前的字符集变量
SHOW VARIABLES LIKE 'character_set_%';
SHOW VARIABLES LIKE 'collation_%';| Variable_name | Value |
+--------------------------+----------------------------+
| character_set_client | latin1 | <-- 隐患:客户端编码识别为单字节
| character_set_connection | latin1 | <-- 隐患:传输通道被转码为 latin1
| character_set_database | latin1 | <-- 隐患:数据库默认字符集未配置
| character_set_results | latin1 | <-- 隐患:返回结果被强转为 latin1
| character_set_server | latin1 | <-- 实例全局默认配置为旧版标准
| character_set_system | utf8mb3 |
+--------------------------+----------------------------+
如果 character_set_client 或 character_set_connection 显示为 latin1,说明 Python 驱动与 MySQL 握手时没有正确协商字符集;如果 character_set_database 为 latin1,则新建表会默认继承该非中文字符集。
2. 检查目标数据表与字段的具体字符集
数据库的默认字符集修改后,并不会自动改变之前已经建好的历史表。需要具体检查目标表的 DDL 语句:
SHOW CREATE TABLE users;`id` int NOT NULL AUTO_INCREMENT,
`nickname` varchar(50) CHARACTER SET latin1 DEFAULT NULL, <-- 字段单列字符集异常
PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=latin1; <-- 表级字符集异常
即便数据库整体为 utf8mb4,如果某个字段单独声明了 CHARACTER SET latin1,写入该字段仍然会触发 1366 报错或乱码。
三、具体修复步骤与完整配置代码
排查确认后,请严格按照“调整存储层字符集”与“固化 Python 连接驱动参数”两部分完成修改。
步骤一:将 MySQL 数据库、数据表与列转换为 utf8mb4
首先在 MySQL 中调整数据库与表结构的定义。对于已经存在数据的表,必须使用 CONVERT TO CHARACTER SET 语法,该语法会自动将表中已有列的物理存储格式一并转换:
-- 1. 修改数据库默认字符集与校验规则
ALTER DATABASE my_database CHARACTER SET = utf8mb4 COLLATE = utf8mb4_unicode_ci;

-- 2. 将已有数据表及其内部所有文本列完整转换为 utf8mb4
ALTER TABLE users CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;

-- 3. (可选)如果只需修改特定单个字段
ALTER TABLE users MODIFY nickname VARCHAR(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;如果拥有 MySQL 服务器的管理权限,建议在配置文件中修改全局默认项,避免日后新建库时再次回退:
[mysqld]
character-set-server = utf8mb4
collation-server = utf8mb4_unicode_ci

[client]
default-character-set = utf8mb4
步骤二:在 Python 连接驱动中显式指定 utf8mb4
不同 Python 数据库驱动库的参数写法略有不同,但核心都是在建立连接实例时明确指定 charset='utf8mb4'。
1. 使用 PyMySQL 库
PyMySQL 是纯 Python 实现的 MySQL 驱动。建立连接时必须传入 charset='utf8mb4':
import pymysql

# 建立连接时显式传入 charset='utf8mb4'
connection = pymysql.connect(
    host='127.0.0.1',
    port=3306,
    user='app_user',
    password='your_strong_password',
    database='my_database',
    charset='utf8mb4',            # 关键参数:强制握手阶段使用 4 字节 UTF-8
    cursorclass=pymysql.cursors.DictCursor
)

try:
    with connection.cursor() as cursor:
        sql = "INSERT INTO users (nickname) VALUES (%s)"
        # 写入包含中文汉字与 4 字节 Emoji 表情的混合文本
        cursor.execute(sql, ("张三工程师_🚀",))
    connection.commit()
finally:
    connection.close()
2. 使用 mysql-connector-python(Oracle 官方驱动)
import mysql.connector

conn = mysql.connector.connect(
    host='127.0.0.1',
    user='app_user',
    password='your_strong_password',
    database='my_database',
    charset='utf8mb4',
    collation='utf8mb4_unicode_ci'  # 可选但建议指定对应排序规则
)
cursor = conn.cursor()
cursor.execute("INSERT INTO users (nickname) VALUES (%s)", ("李四架构师",))
conn.commit()
cursor.close()
conn.close()
3. 使用 SQLAlchemy ORM
在 SQLAlchemy 的连接字符串(Database URL)末尾拼接 ?charset=utf8mb4 参数:
from sqlalchemy import create_engine

# 在 URL 中显式携带 charset=utf8mb4
DATABASE_URL = "mysql+pymysql://app_user:your_strong_password@127.0.0.1:3306/my_database?charset=utf8mb4"

engine = create_engine(
    DATABASE_URL,
    pool_recycle=3600,
    echo=False
)
步骤三:验证与测试脚本
配置完成后,编写一个独立的验证脚本,测试“普通简体中文”、“繁体/生僻字”和“4 字节 Emoji 表情”的双向读写:
import pymysql

def verify_chinese_storage():
    conn = pymysql.connect(
        host='127.0.0.1',
        user='app_user',
        password='your_strong_password',
        database='my_database',
        charset='utf8mb4',
        cursorclass=pymysql.cursors.DictCursor
    )

    test_cases = [
        "标准简体中文测试",
        "繁體生僻字:𪚥 𫖮 㭎",
        "混合表情符:数据科学 ✨ 🚀 🐍"
    ]

    try:
        with conn.cursor() as cur:
            # 准备临时测试表
            cur.execute("""
                CREATE TEMPORARY TABLE test_charset (
                    id INT AUTO_INCREMENT PRIMARY KEY,
                    content VARCHAR(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci
                ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
            """)

            # 批量写入
            for text in test_cases:
                cur.execute("INSERT INTO test_charset (content) VALUES (%s)", (text,))
            conn.commit()

            # 读取并验证
            cur.execute("SELECT content FROM test_charset ORDER BY id ASC")
            rows = cur.fetchall()

            print("[测试结果]")
            for idx, row in enumerate(rows):
                stored = row['content']
                expected = test_cases[idx]
                is_match = (stored == expected)
                print(f"用例 {idx+1}:写入=[{expected}] 读取=[{stored}] 校验通过={is_match}")
                assert is_match, "数据不一致!写入与读出不匹配"

            print("所有测试用例校验通过,全链路无乱码!")
    finally:
        conn.close()

if __name__ == "__main__":
verify_chinese_storage()用例 1:写入=[标准简体中文测试] 读取=[标准简体中文测试] 校验通过=True
用例 2:写入=[繁體生僻字:𪚥 𫖮 㭎] 读取=[繁體生僻字:𪚥 𫖮 㭎] 校验通过=True
用例 3:写入=[混合表情符:数据科学 ✨ 🚀 🐍] 读取=[混合表情符:数据科学 ✨ 🚀 🐍] 校验通过=True
所有测试用例校验通过,全链路无乱码!
四、常见误区与深度辨析
在处理 MySQL 中文乱码的过程中,有几个看似合理但在特定条件下会失效的说法,需要读者准确理解其成立边界与局限性。
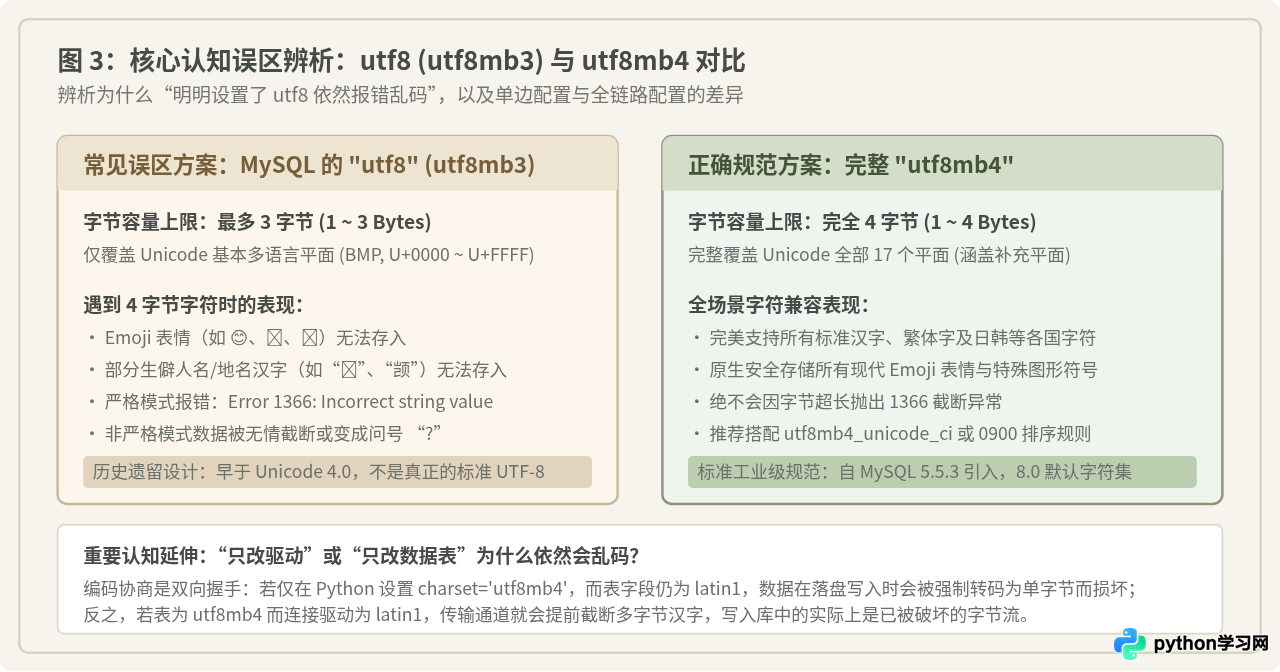
误区一:“在 MySQL 里指定 charset='utf8' 就能支持全部中文”
为什么看似合理:在国际标准中,UTF-8 是能够表示所有字符的通用编码。大部分常用汉字(如常用三千字)在 UTF-8 下占用 3 个字节,因此如果只插入常用汉字,设置 charset='utf8' 往往可以正常运行,给人一种“已经解决”的错觉。
哪里需要修正:MySQL 中的 utf8 实际上是历史遗留的 utf8mb3(mb3 即 max bytes 3),它人为限制了一个字符最多只分配 3 个字节。然而,Unicode 规范早在 4.0 版本就扩展了辅助平面(Supplementary Planes),现代标准的 UTF-8 最多可达 4 字节。当用户在文本中输入手机键盘常用的 Emoji 表情(如 😊),或者历史典籍中的生僻字、特定繁体字(如“𪚥”占用 4 字节)时,MySQL 的 utf8mb3 会立刻因超长抛出 Error 1366: Incorrect string value,若在非严格模式下则直接将后面的内容整段截断或替换为 ?。因此,必须使用 utf8mb4,而不是 utf8。
误区二:“只要把 Python 连接代码里的 charset 改成 utf8mb4,数据库就能正常存中文”
为什么看似合理:修改 Python 代码最简单,不需要改动线上数据库结构,很多开发者改完后发现程序不报错了。
哪里需要修正:这忽略了 MySQL 会话层到存储层的二次转码。Python 指定 charset='utf8mb4' 仅仅保证了 Python 到 MySQL 会话通道(character_set_client)能正确识别中文。如果目标数据表或列依然是 latin1,MySQL 服务端在将数据写入磁盘列时,会尝试将 UTF-8 字节强行转码为单字节的 Latin1。由于绝大多数汉字在 Latin1 中不存在,MySQL 会把不可转换的字符直接变成问号 ?。这种破坏是物理写入层面的不可逆损坏,读出时永远无法恢复。因此必须“驱动”和“表字段”双向对齐。
误区三:“数据库中已经变成问号的历史乱码,通过 ALTER TABLE 能自动变回中文”
哪里需要修正:乱码分为“可逆的误读”和“不可逆的破坏”:
- 如果当初写入时,数据是以 UTF-8 字节原封不动地存入
latin1字段(即纯 Latin1 容器存放了未校验的 raw bytes),那么只要字段内容未被替换,通过先转为BLOB再转为utf8mb4往往可以找回原文字节。 - 但如果当初写入时,MySQL 已经将其转码为
0x3F(即真正的问号字符?),那么原始的汉字信息已经在落盘前被丢弃,任何 SQL 转换语句都无法凭空把?还原成汉字,历史数据只能通过源数据重放或数据备份来恢复。
五、全链路防乱码规范总结
为确保整个软件生命周期中不再复发中文乱码问题,建议将以下配置要点纳入团队的工程规范清单。
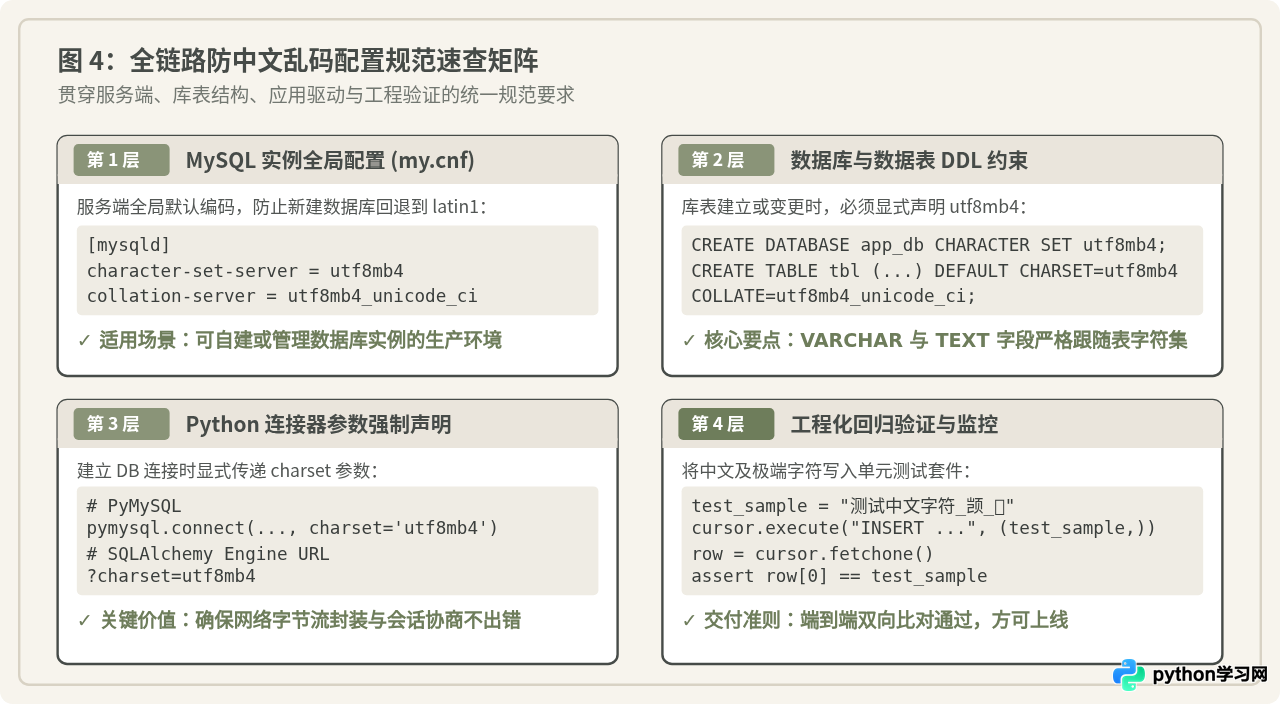
| 所属层级 | 检查项目 | 标准配置 / 建议值 | 作用与目的 |
|---|---|---|---|
| MySQL 服务端 | my.cnf 默认编码 |
character-set-server = utf8mb4 |
统一新创建数据库与内部临时表的全局默认字符集 |
| 数据库定义 | CREATE DATABASE |
CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci |
确保新建数据表未单独声明时默认采用 4 字节 UTF-8 |
| 数据表与列 | CREATE TABLE |
文本列继承 DEFAULT CHARSET=utf8mb4 |
保证所有 VARCHAR 与 TEXT 字段能够无损容纳 4 字节数据 |
| Python 驱动 | 连接参数 (DB-API) | 显式传入 charset='utf8mb4' |
确保驱动在封包时将 Unicode 编码为正确的 UTF-8 网络流 |
| 工程与测试 | 持续集成测试套件 | 写入包含中文字符与 Emoji 的断言测试用例 | 在开发与发版阶段及时捕获驱动升级或连接池默认值变动带来的隐患 |
通过贯通上述四个层级的 utf8mb4 标准,Python 连接 MySQL 存储中文乱码的问题将得到彻底根除,同时也能全面兼容未来现代应用中频繁出现的 Emoji、符号以及多语言国际化数据。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















