


Python安装指定版本的sklearn以兼容旧项目
针对旧机器学习工程与历史模型文件,系统化介绍如何正确安装指定版本的 scikit-learn。涵盖包名规范、Python解释器兼容矩阵、Conda与venv环境隔离、旧模型加载验证及高频编译报错排查。
在维护或复现几年前的 Python 机器学习旧项目时,直接运行 pip install sklearn 往往无法让代码正常跑起来。解决这个问题的核心路径非常明确:必须将安装包名称明确为 scikit-learn 并指定版本号,同时为该版本匹配能够提供官方预编译 Wheel 的旧版 Python 解释器(如 Python 3.7 或 3.8),并在独立的虚拟环境中进行隔离安装与验证。
一、核心认知:区分包名 scikit-learn 与导入名 sklearn
许多初学者或从老代码接手项目的工程师,最容易陷入的第一个陷阱就是混淆了“包分发名”与“代码导入名”。
在 Python 代码中,我们调用算法库时书写的语法是 import sklearn,但这并不意味着它的安装包全名就叫 sklearn。在 Python 官方包索引 PyPI 上,该项目的正式分发名称始终是 scikit-learn。
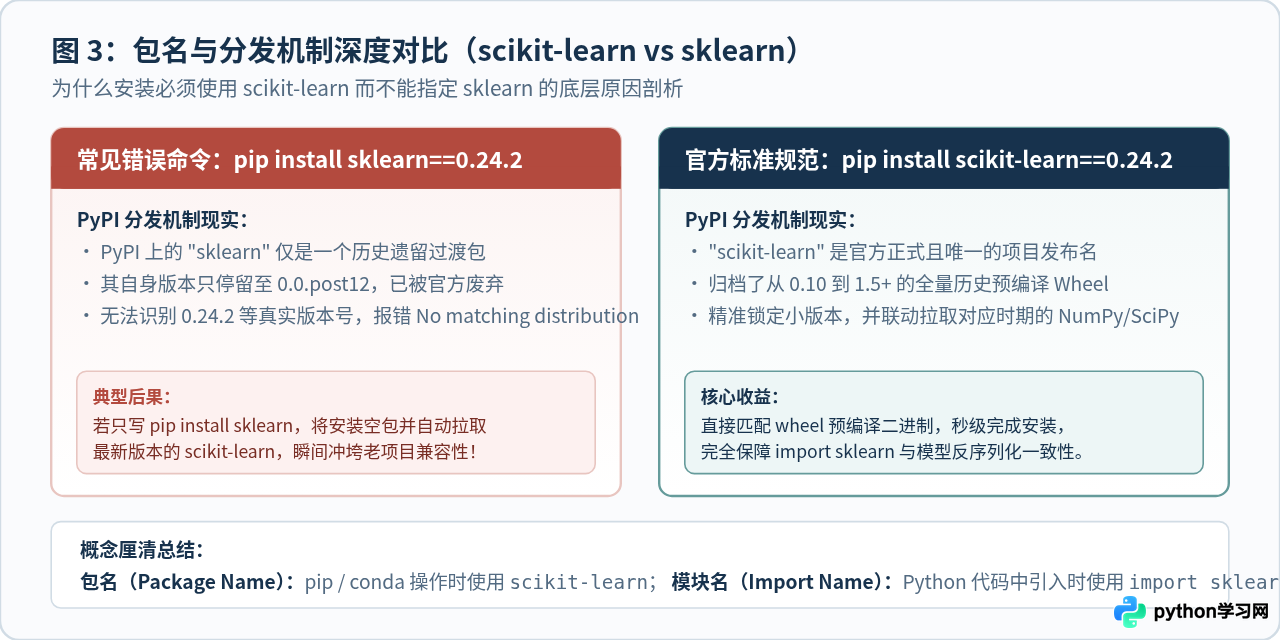
早年 PyPI 上曾存在过一个名为 sklearn 的占位过渡包。这个包的作用仅仅是引导用户去下载真正的 scikit-learn,它自身的版本号仅迭代到 0.0.post12 便已被官方正式废弃。如果你在命令行中执行:
pip install sklearn==0.24.2包管理器会直接返回找不到对应版本的错误提示:
ERROR: No matching distribution found for sklearn==0.24.2
更危险的操作是不带版本号直接输入 pip install sklearn。这会导致 pip 下载该过渡空包,并顺势拉取 PyPI 上最新的稳定版 scikit-learn(例如 1.5+)。一旦最新版本进入当前环境,老项目原有的接口调用、历史模型反序列化(pickle)都会由于 API 变动或类结构变更而彻底崩溃。
requirements.txt、终端命令还是自动化构建脚本中,声明依赖项时必须一律使用 scikit-learn==目标版本号。
二、版本兼容基石:scikit-learn 与 Python / 依赖的严格绑定
确定了正确的包名后,接下来的关键问题是:为什么旧版本的 scikit-learn 不能直接安装在现有的现代 Python 环境(如 Python 3.11 或 3.12)中?
scikit-learn 包含了大量的 Cython 和 C/C++ 扩展底层,用于加速矩阵运算与树模型分裂。为了让用户能够无需本地编译、开箱即用,官方团队会为每个发布的版本打包对应的二进制 Wheel 轮子。但每一个 Wheel 文件都是与特定的 Python C-API 及操作系统 ABI 深度绑定的。
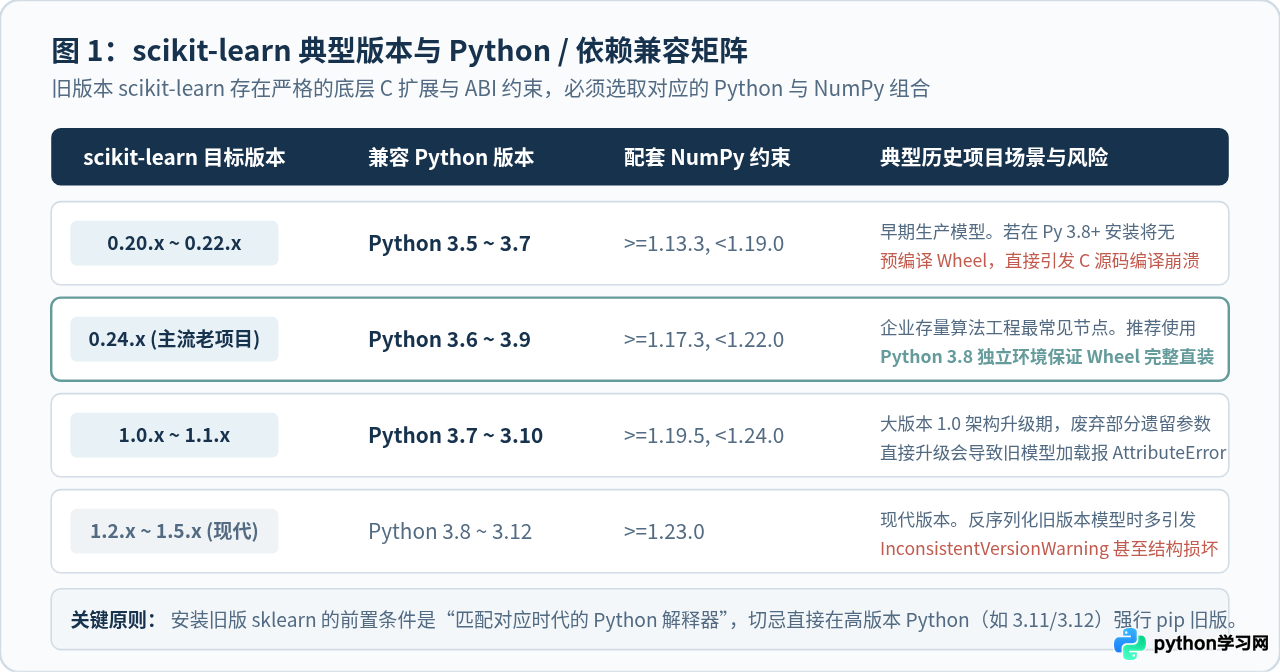
以经典的 scikit-learn 0.24.2 为例,该版本发布于 2021 年,官方构建并归档的 Wheel 轮子最高仅支持到 Python 3.9。如果当前开发者使用的是 Python 3.11,pip 在 PyPI 上无法检索到对应的 .whl 文件,就会自动回退去下载 .tar.gz 源码包并在本地尝试构建。这通常会引发庞大的 C++ 编译报错:
error: subprocess-exited-with-error
Running setup.py install for scikit-learn ... error
error: command 'gcc' failed with exit status 1
因此,要保证旧版本成功安装并正常加载老项目模型,首要任务是在兼容矩阵中找到目标版本所支持的 Python 运行时环境,切忌在过高版本的 Python 下强行构建。
三、分步实操:为旧项目配置独立环境并安装指定版本
为了避免修改旧环境导致现代项目受损,也为了确保依赖不会发生版本漂移,推荐使用虚拟环境进行隔离操作。以下按照标准五步闭环法进行演示。
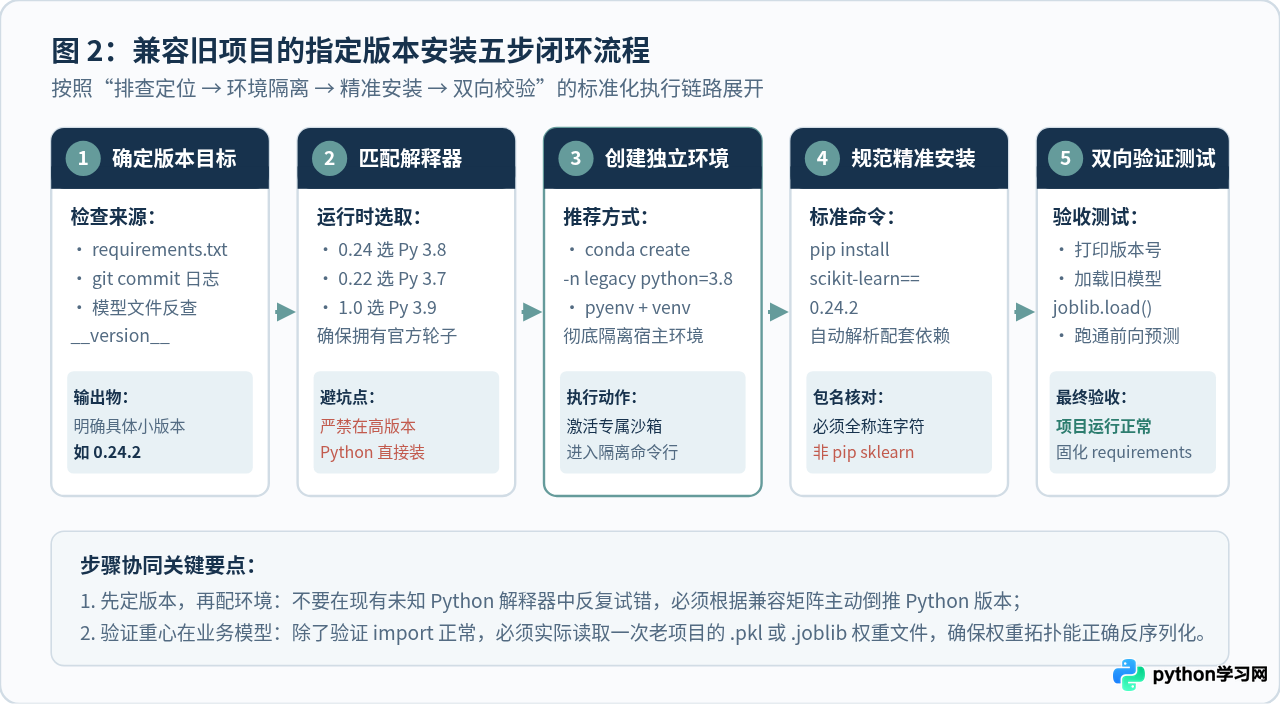
步骤一:准确定位老项目所需的历史版本号
在着手安装前,先从老项目的代码资产中寻找版本线索。常见的确认途径有三个:
- 检查依赖清单:查看项目根目录下的
requirements.txt、environment.yml或Pipfile.lock。 - 核对 Git 提交时间:若无依赖文件,可查看该项目最后活跃的年份。例如 2019 年前后的项目多基于
0.20 ~ 0.22,2021 年项目多基于0.24。 - 探测持久化模型元数据:如果存留有
.pkl或.joblib训练模型,可通过轻量脚本尝试探测其反序列化版本(见后文验证环节)。
步骤二:选择并安装对应的 Python 运行时
假设我们锁定的目标版本是 scikit-learn 0.24.2,根据兼容矩阵,最稳健的运行时是 Python 3.8。
管理多版本 Python 解释器最便捷的方式是使用 Miniconda/Anaconda,或者在 Linux/macOS 下使用 pyenv。这里以最通用的 Conda 为例:
# 创建专为旧项目准备的隔离环境,锁定 Python 3.8
conda create -n legacy_sklearn_env python=3.8 -y

# 激活该虚拟环境
conda activate legacy_sklearn_env
如果使用原生 Python 工具链,可先在宿主机安装好 Python 3.8 解释器,然后使用原生 venv 模块:
# 使用指定的 python3.8 解释器创建虚拟环境
python3.8 -m venv ./venv_legacy

# 激活虚拟环境 (macOS/Linux)
source ./venv_legacy/bin/activate

# 激活虚拟环境 (Windows PowerShell)
# ./venv_legacy/Scripts/Activate.ps1
步骤三:更新基础安装工具并安装指定版本
老旧 Python 环境中自带的 pip 工具可能无法正确协商较新的 TLS 协议或解析较新格式的 Wheel 元数据。因此进入虚拟环境后的第一件事是升级 pip:
python -m pip install --upgrade pip setuptools wheel接着,使用正规包名执行指定版本的安装命令:
pip install scikit-learn==0.24.2终端中将看到 pip 直接命中预编译轮子,几秒钟内完成解包与安装:
Downloading scikit_learn-0.24.2-cp38-cp38-manylinux2010_x86_64.whl (24.9 MB)
Collecting numpy>=1.13.3
Downloading numpy-1.24.4-cp38-cp38-manylinux_2_17_x86_64.whl (17.3 MB)
Collecting scipy>=0.19.1
Downloading scipy-1.10.1-cp38-cp38-manylinux_2_17_x86_64.whl (34.5 MB)
Collecting joblib>=0.11
Downloading joblib-1.3.2-py3-none-any.whl (301 kB)
Collecting threadpoolctl>=2.0.0
Downloading threadpoolctl-3.2.0-py3-none-any.whl (17 kB)
Successfully installed joblib-1.3.2 numpy-1.24.4 scikit-learn-0.24.2 scipy-1.10.1 threadpoolctl-3.2.0
四、结果验证:环境核验与旧模型反序列化加载测试
安装完成后,不能仅停留在“命令没有报错”的层面,必须进行两阶段的具体验证。
1. 基础导入与版本号校验
在命令行执行单行检测代码,验证模块是否能无警告导入并输出指定版本:
python -c "import sklearn; print('sklearn 版本:', sklearn.__version__)"2. 旧项目模型(.pkl / .joblib)反序列化测试
旧项目兼容中最常遇到的深层问题,是使用 pickle 或 joblib 保存的旧模型权重文件无法在新环境下复现。编写如下验证脚本 verify_model.py:
# verify_model.py
import joblib
import sklearn

print(f"当前运行环境 scikit-learn 版本: {sklearn.__version__}")

model_path = "legacy_model.joblib"  # 替换为老项目的实际模型文件路径

try:
    # 尝试加载旧模型对象
    model = joblib.load(model_path)
    print("✓ 模型权重文件反序列化成功!")

    # 检查模型关键属性
    if hasattr(model, "n_features_in_"):
        print(f"✓ 模型训练输入特征维度: {model.n_features_in_}")
    elif hasattr(model, "n_features_"):
        print(f"✓ 模型旧版特征维度属性: {model.n_features_}")

    print("✓ 旧项目模型兼容测试通过。")
except Exception as e:
    print(f"✗ 模型加载失败,异常详情: {type(e).__name__}: {e}")
如果输出顺利显示 模型反序列化成功,说明当前的解释器、scikit-learn 以及底层的 NumPy 结构体完全兼容。
五、常见安装失败原因与排查方案
在实际搭建过程中,因操作系统架构、历史依赖冲突等原因,常常会触发特定报错。针对图 4 总结的排查树,以下是具体的应对方案:
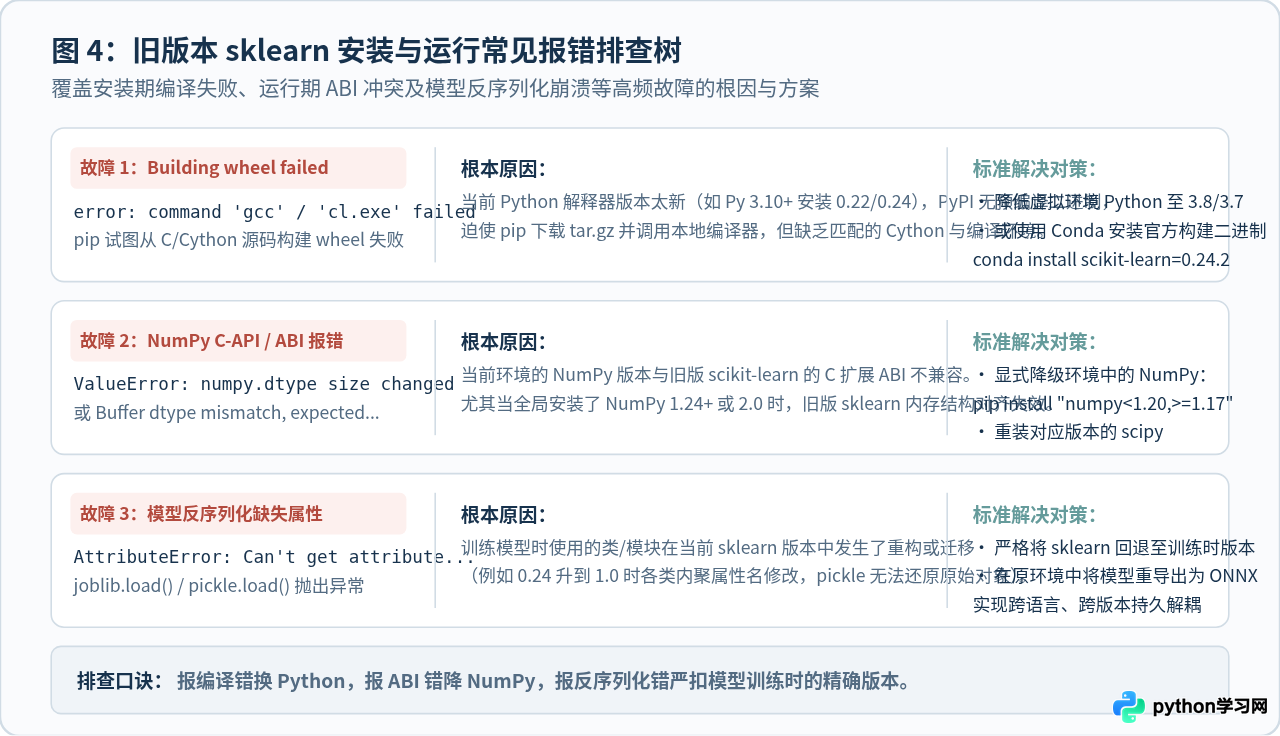
1. 报源码构建错误:Building wheel failed / gcc error
原因剖析:该现象 95% 以上是因为解释器版本与 scikit-learn 版本错位。例如在 Python 3.10 上尝试安装 scikit-learn==0.22.2,因官方没有为 Python 3.10 构建该版本的轮子,pip 被迫调用 gcc 进行源码编译,但老源码与现代 C 编译器标准不兼容导致终止。
解决途径:主动降级 Python 解释器。若受限于某些客观原因无法更换系统 Python,可借助 Conda 的 conda-forge 镜像源,由 Conda 负责解决二进制依赖:
conda install -c conda-forge scikit-learn=0.24.22. 报 C-API / ABI 内存冲突:ValueError: numpy.dtype size changed
原因剖析:scikit-learn 的 C 扩展在编译时绑定了特定版本的 NumPy C-API。如果环境中后来安装了过新的 NumPy(如 1.24 或 2.0),由于二进制结构体内存对齐改变,旧版 sklearn 在运行时就会报出 numpy.dtype size changed, may indicate binary incompatibility。
解决途径:对 NumPy 进行版本封顶锁定。针对 0.24 以前的 sklearn,建议显式约束 NumPy:
pip install "numpy<1.22.0,>=1.17.3" --force-reinstall3. 报模块或类缺失:AttributeError: Can't get attribute '...' on module 'sklearn'
原因剖析:scikit-learn 在 0.22 和 1.0 版本经历过两次核心代码重构(例如 sklearn.utils.testing 被移除,部分私有属性更名)。旧项目模型序列化时保存了对具体类路径的引用,反序列化时如果当前库的类路径已变,就会直接抛出属性缺失异常。
解决途径:严格校准环境至当初训练模型时的小版本号。可以通过 Python 原生 pickletools 工具分析 .pkl 文件的包头签名,获取其原始保存版本。
六、总结与环境固化清单
为了让旧项目在此次成功部署后不再重现“环境崩坏”的问题,最后一步务必将整个隔离环境中的实际依赖固化下来。
在当前激活的虚拟环境中,执行:
pip freeze > legacy_requirements.txt导出的 legacy_requirements.txt 应当类似于:
joblib==1.3.2
numpy==1.21.6
scikit-learn==0.24.2
scipy==1.7.3
threadpoolctl==3.1.0
同时在项目的根目录 README.md 中明确记录环境说明:“本项目依赖 Python 3.8 运行时,核心依赖请通过 pip install -r legacy_requirements.txt 进行安装,切勿在 Python 3.10+ 环境下直接更新依赖。” 这样就彻底完成了旧项目环境的兼容与长效维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















