


为什么sys.getsizeof计算的Python列表大小比预期大
深入解析为什么sys.getsizeof计算的Python列表内存大小比预期大,拆解PyListObject底层结构体开销、动态扩容预分配机制及实际排查优化方法。
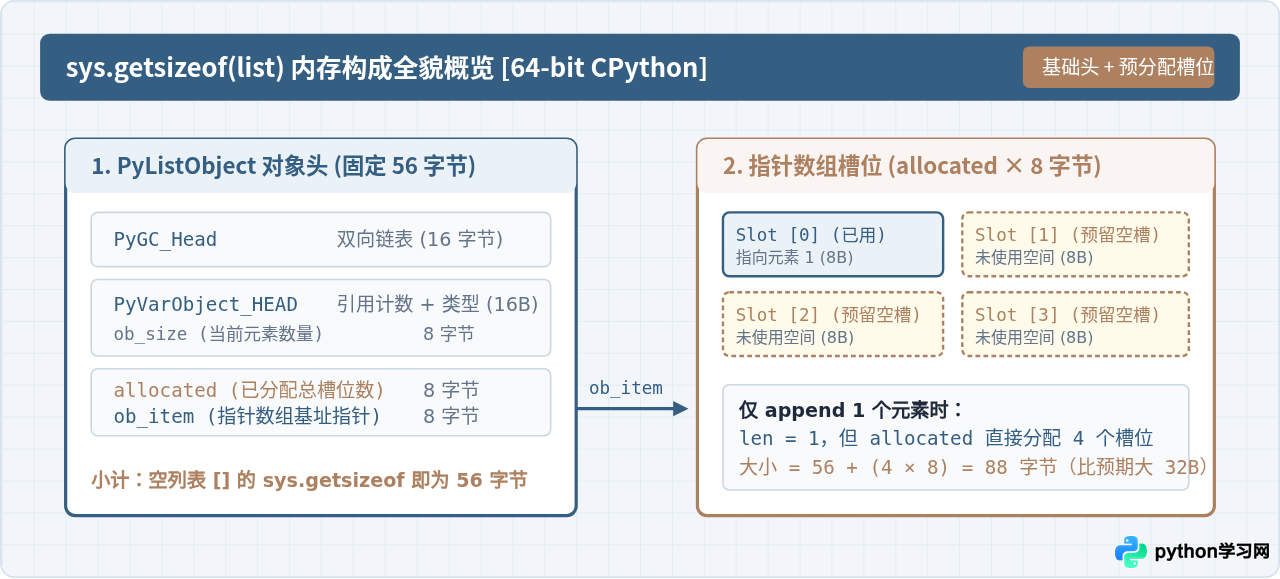
许多初次使用 sys.getsizeof() 测量 Python 列表大小的开发者,常常会看到超出直觉的数字:一个没有任何元素的空列表占用了 56 字节;仅仅添加一个整数,占用瞬间跳升到 88 字节;随着元素递增,内存增长并不是平缓递进,而是呈台阶状跳跃。这一现象的核心原因有两个:首先,Python 的 list 是一个由 CPython 结构体 PyListObject 构成的独立堆对象,自带不可削减的垃圾回收头与对象元数据基础开销(64 位系统下为 56 字节);其次,为了保证 append() 操作拥有均摊 $O(1)$ 的高效性能,列表底层采用了“超量预分配”(Over-allocation)机制,即内部指针数组预留的容量远大于当前实际存储的元素个数。本文将拆解其底层数据结构、扩容算法与测量边界,帮助你准确理解并合理评估列表的内存占用。
一、现象直观复现:预期大小与实际输出的差距
在编写程序时,很多人的第一直觉是:空的容器应该只占用几个字节或者不占内存;如果要放 1 个 64 位整数,加上容器本身至多也就十几到二十几字节。然而在标准 CPython(64 位系统)中执行以下诊断脚本,得到的结果往往与直觉大相径庭:
import sys

# 测试 1:空列表大小
empty_list = []
print("空列表大小:", sys.getsizeof(empty_list), "字节")

# 测试 2:单元素列表与连续追加
lst = []
print(f"初始大小: {sys.getsizeof(lst)} 字节")
for i in range(1, 10):
    lst.append(i)
    slots = (sys.getsizeof(lst) - 56) // 8
    print(f"追加第 {i:2d} 个元素 | sys.getsizeof: {sys.getsizeof(lst):3d} 字节 | 底层分配槽位: {slots:2d}")
初始大小: 56 字节
追加第 1 个元素 | sys.getsizeof: 88 字节 | 底层分配槽位: 4
追加第 2 个元素 | sys.getsizeof: 88 字节 | 底层分配槽位: 4
追加第 3 个元素 | sys.getsizeof: 88 字节 | 底层分配槽位: 4
追加第 4 个元素 | sys.getsizeof: 88 字节 | 底层分配槽位: 4
追加第 5 个元素 | sys.getsizeof: 120 字节 | 底层分配槽位: 8
追加第 6 个元素 | sys.getsizeof: 120 字节 | 底层分配槽位: 8
追加第 7 个元素 | sys.getsizeof: 120 字节 | 底层分配槽位: 8
追加第 8 个元素 | sys.getsizeof: 120 字节 | 底层分配槽位: 8
追加第 9 个元素 | sys.getsizeof: 184 字节 | 底层分配槽位: 16
从输出中可以清晰观察到两个现象:
- 起点高:空列表
[]自身就已经占用 56 字节; - 跳跃大:追加第 1 个元素时,内存不是增加 8 字节,而是直接暴增 32 字节(从 56 字节跳到 88 字节);并且在追加第 2、3、4 个元素时,内存大小纹丝不动,直到第 5 个元素又突然跳升 32 字节(达到 120 字节)。
二、基础开销拆解:空列表为什么占用 56 字节
在 CPython 实现中,列表不仅仅是一个“裸数组”,而是一个由 C 语言结构体定义的复杂对象(定义在 Include/cpython/listobject.h 中的 PyListObject)。只要在内存中创建了一个列表实例,操作系统就必须为这个结构体分配完整的头部字段。在 64 位操作系统环境下,指针和整数均为 8 字节对齐,具体结构如下:
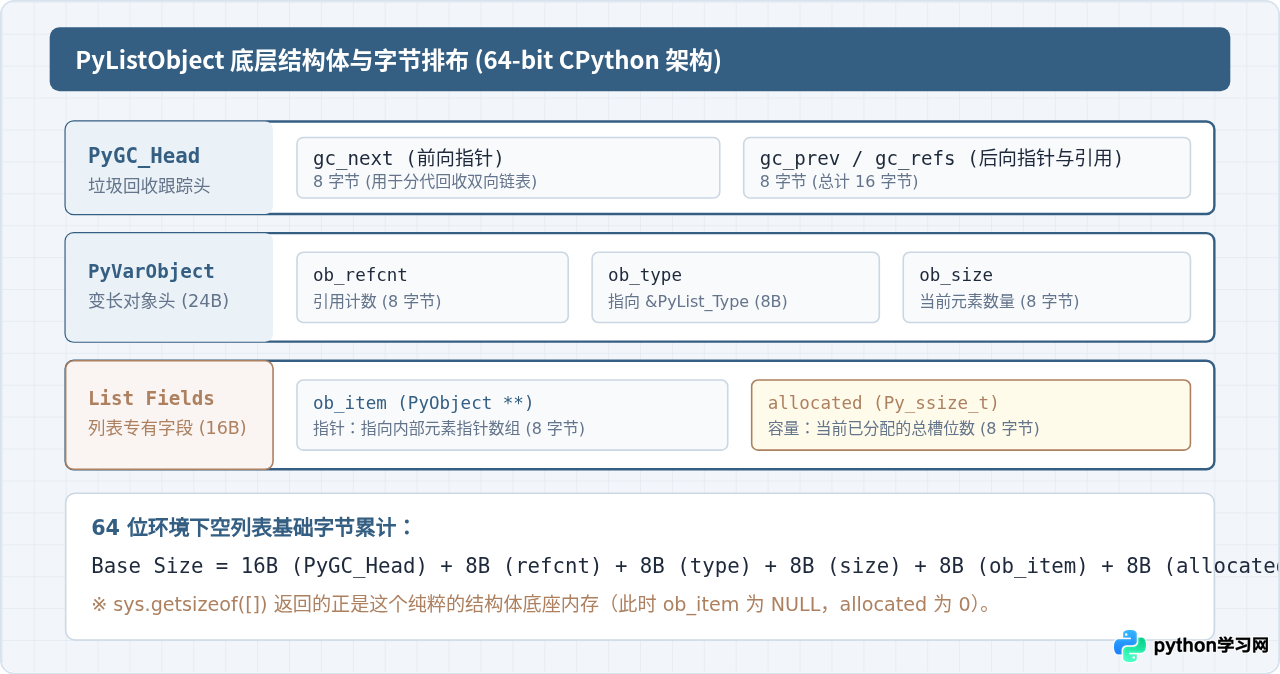
通过上述拆解可以清晰得出结论:在 64 位系统下,哪怕列表里一个元素都没有,为了支撑 Python 的动态类型检查、内存引用计数管理以及垃圾回收标记,56 字节的底座是刚性存在的。这解释了为什么“空列表不是 0 字节”。
三、动态预分配机制:为什么追加元素时内存跳跃增加
当列表开始存储数据时,sys.getsizeof() 计算的则是:基础大小(56字节) + 已分配槽位(allocated) × 指针大小(8字节)。但为什么追加 1 个元素时,分配的不是 1 个槽位,而是 4 个槽位?
1. 均摊时间复杂度的工程权衡
如果 Python 列表每追加一个元素就精确分配一个槽位,那么每一次 append() 都将引发底层内存重新分配(realloc)。在连续内存中,重分配往往需要将原有数据整体拷贝到新内存地址,这意味着向列表追加 $N$ 个元素的总时间复杂度会退化为 $O(N^2)$,性能极度低下。
为了使 append() 的平均时间复杂度保持在 $O(1)$,CPython 采取了过量预分配(Over-allocation)策略:在发现空间不足时,不仅分配当前所需的空间,还会额外预留出若干空闲槽位供后续追加直接使用。
2. CPython 扩容公式与推导步骤
在 CPython 源码(Objects/listobject.c 中的 list_resize 函数)中,扩容计算的核心逻辑如下:
/* 计算新容量的经验公式 */
size_t new_allocated = ((size_t)newsize + (newsize >> 3) + (newsize < 9 ? 3 : 6));
根据该公式,当新需求元素数量为 newsize 时,系统的执行步骤与推导流转如下:
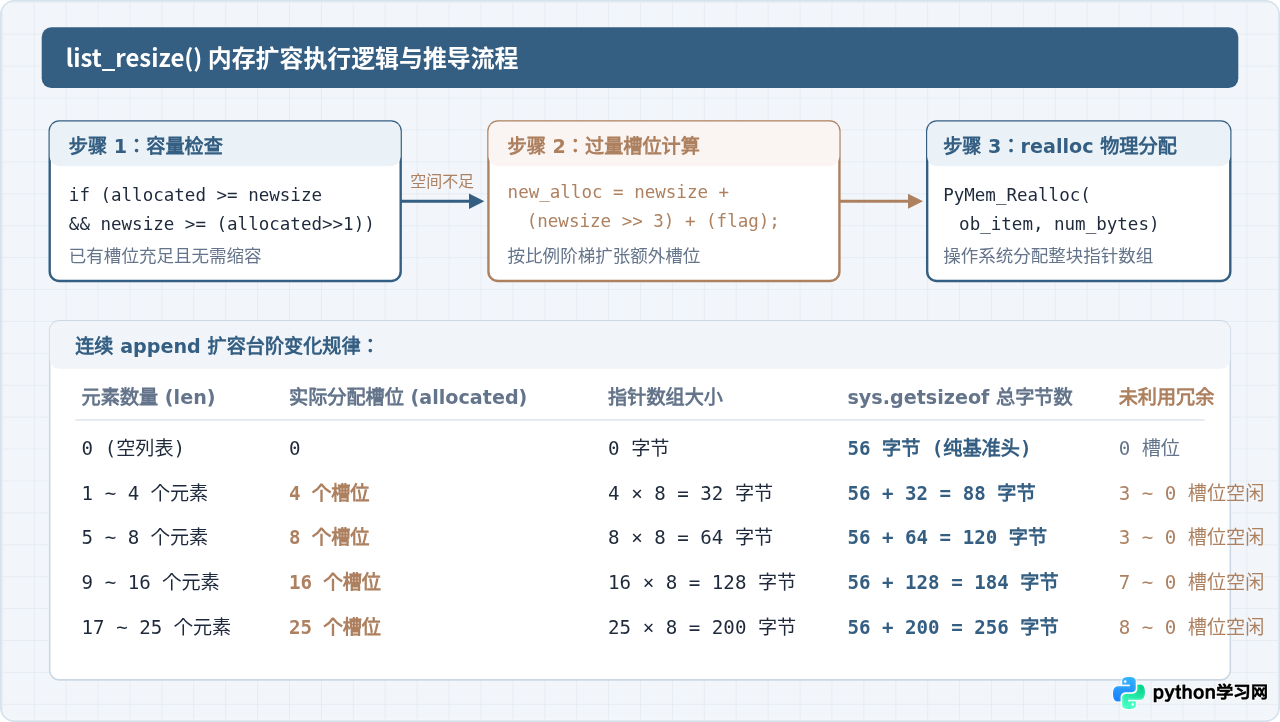
这个表揭示了为什么连续调用 append 时,列表大小呈现阶梯状停顿和突增:当你只存放了 9 个元素时,底层其实已经预分配了足以容纳 16 个指针的内存。空闲的 7 个槽位(56 字节)全部计入了 sys.getsizeof() 的结果中,因此在读者看来,列表比预期大了很多。
四、容易混淆的关键对比:构建方式与浅大小陷阱
在理解了底层结构与预分配后,还需要分清两个极易混淆的认知盲区:
1. 字面量构建 vs 动态追加构建
使用列表字面量(如 [1, 2, 3, 4, 5])或已知长度的可迭代对象初始化列表(如 list(range(5)))时,CPython 在构建伊始便知晓具体元素数量,因此会直接分配刚好契合的槽位(allocated == ob_size),不会触发 append 机制的过量预分配。
import sys

# 方式 A:字面量直接创建(5个元素)
list_literal = [1, 2, 3, 4, 5]
print("字面量创建大小:", sys.getsizeof(list_literal), "字节")
# 计算: 56 + (5 × 8) = 96 字节

# 方式 B:由空列表动态 append 到 5 个元素
list_appended = []
for x in range(1, 6):
    list_appended.append(x)
print("动态追加大小:", sys.getsizeof(list_appended), "字节")
# 计算: 56 + (8 × 8) = 120 字节
动态追加大小: 120 字节
同一个逻辑结果,因为构建路径不同,动态追加创建的列表足足多了 24 字节(多预留了 3 个指针槽位)。
2. 浅大小(Shallow Size)vs 实际深层占用(Deep Size)
另一个常让人产生“列表占用大”或“测量不准”困惑的,是 sys.getsizeof() 的本质:它只测量容器对象自身的浅层大小(Shallow Size),不包含指针所引用的外部 Python 对象本身。
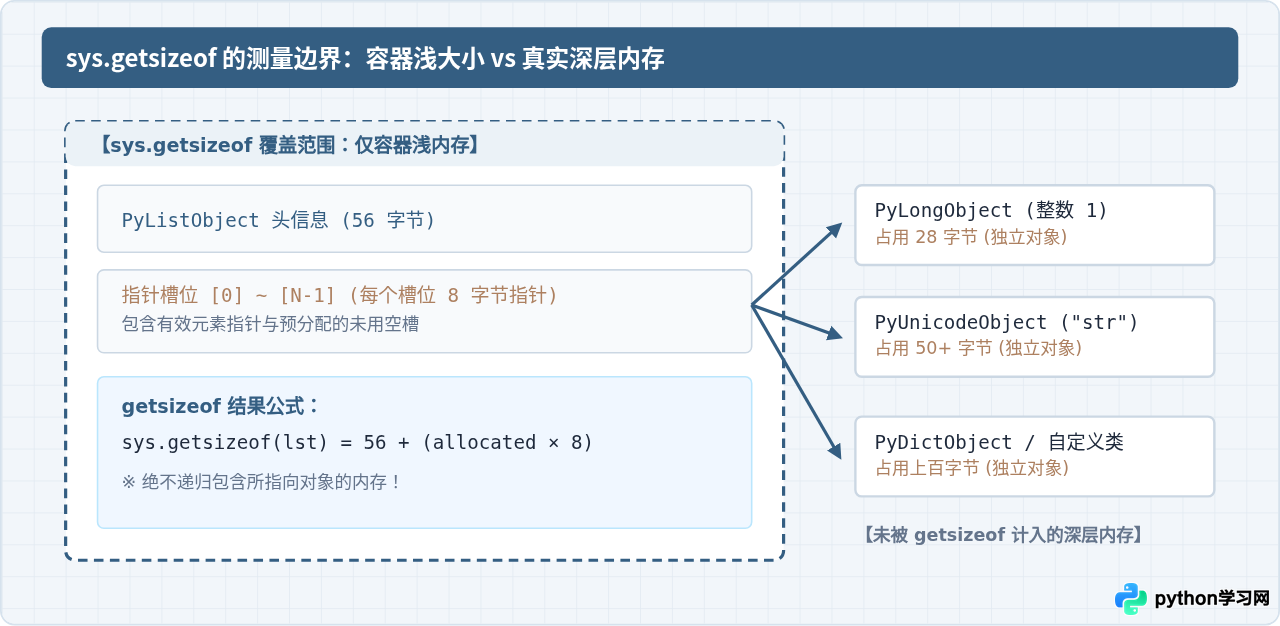
这意味着两层含义:
- 如果你的列表存放的是海量小对象(如百万个独立整数),每个整数又有自己的 28 字节头部,此时内存不仅在列表的指针数组上体现膨胀,更在分散的小对象上成倍放大;
- 反之,若列表中存放的是大型数据结构,
sys.getsizeof(lst)给出的数字可能看起来只有几十字节,但这只是因为指针本身很小,不能代表真实应用内存。
五、实用排查方法与内存优化决策
了解了为什么列表会偏大后,在面对大量列表或长生命周期列表时,应当如何排查与针对性优化?
1. 如何准确计算预分配闲置空间
在工程诊断中,可以编写一个轻量工具函数,准确测算列表当前的闲置指针槽位和空间浪费:
import sys

def inspect_list_memory(lst):
    shallow_size = sys.getsizeof(lst)
    current_len = len(lst)
    # 64 位系统下基础头 56 字节,每个指针槽位 8 字节
    allocated_slots = (shallow_size - 56) // 8 if shallow_size >= 56 else 0
    unused_slots = allocated_slots - current_len
    waste_bytes = unused_slots * 8

    return {
        "len": current_len,
        "allocated_slots": allocated_slots,
        "unused_slots": unused_slots,
        "shallow_size_bytes": shallow_size,
        "wasted_pointer_bytes": waste_bytes,
        "utilization_pct": round((current_len / allocated_slots * 100), 1) if allocated_slots > 0 else 100.0
    }

# 诊断一个经过多次 append 的列表
sample = []
for i in range(100):
    sample.append(i)

info = inspect_list_memory(sample)
print(f"当前长度: {info['len']}, 实际开辟槽位: {info['allocated_slots']}, 槽位利用率: {info['utilization_pct']}%")
print(f"总浅内存: {info['shallow_size_bytes']} 字节, 预分配闲置浪费: {info['wasted_pointer_bytes']} 字节")
总浅内存: 968 字节, 预分配闲置浪费: 112 字节
2. 优化决策路径与缩减技巧
当确认列表的预分配或对象指针成为内存瓶颈时,可参考以下决策路径进行处理:
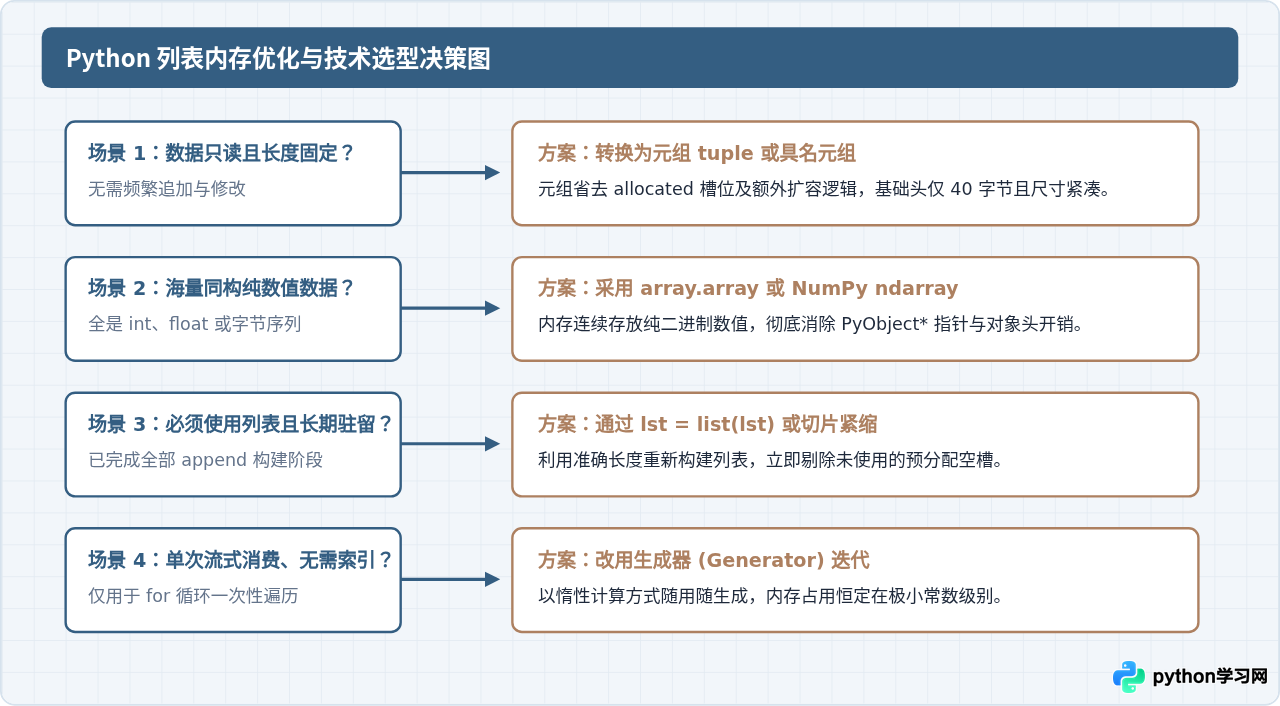
3. 列表构建后的物理容量收缩实操
如果业务逻辑必须依赖列表,且在批量 append 完成后该列表需要常驻内存,可以通过浅拷贝或 list() 强转去除预分配冗余:
import sys

# 动态追加 9 个元素(预分配 16 个槽位)
data = []
for i in range(9):
    data.append(i)

print(f"追加后大小: {sys.getsizeof(data)} 字节 (allocated: {(sys.getsizeof(data)-56)//8})")

# 执行紧缩重建
compact_data = list(data)
print(f"紧缩后大小: {sys.getsizeof(compact_data)} 字节 (allocated: {(sys.getsizeof(compact_data)-56)//8})")
紧缩后大小: 128 字节 (allocated: 9)
重构后,列表仅保留 9 个槽位($56 + 9 imes 8 = 128$ 字节),原本闲置的 7 个指针空间(56 字节)被彻底收回。
六、常见疑问与排查边界说明
1. pop() 删除元素时,列表大小会立刻缩小吗?
不会立刻缩容。CPython 源码同样在 list_resize 中对缩容做了防抖(Hysteresis)保护:只有当实际元素数量 newsize 跌破当前分配容量的一半(即 allocated / 2)以下时,系统才会触发重分配缩减内存。这种设计能够有效防止在临界点交替调用 append() 和 pop() 时发生高频的内存反复申请与拷贝震荡。
2. 32 位系统与 64 位系统的数值差异
本文中的 56 字节基准和 8 字节指针是以主流的 64 位 CPython 环境为基准的。如果运行在 32 位系统环境中,所有指针及 Py_ssize_t 的长度减半为 4 字节:
PyGC_Head:8 字节(2 个指针);PyVarObject_HEAD:12 字节(3 个 4 字节整型/指针);ob_item与allocated:8 字节;- 空列表基础大小变为:$8 + 12 + 8 = 28$ 字节;每个指针槽位变为 4 字节。
总结
sys.getsizeof 计算出的 Python 列表大小之所以比直觉预期大,本质是 CPython 运行时代价与运行效率权衡的物理体现:
- 56 字节的“起步价”:承载了垃圾回收分代链表、引用计数、类型安全与数组元数据的必要开销;
- 按台阶暴增的“槽位冗余”:是动态数组牺牲少量闲置空间换取 $O(1)$ 均摊追加速度的经典设计。
在日常开发中,无须对少量列表的预分配过分担忧;而在处理千万级高并发或密集型数据管道时,准确识别这层内存边界,合理切换到元组、同构数组或生成器,便能从底层彻底消除不必要的高内存占用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















