


Python自动化运维项目:脚本编写与系统监控实例
本文围绕Python自动化运维中的核心指标采集与告警分发,从psutil库应用、阈值防抖判断、Webhook告警通知到systemd守护进程部署,完整实现一套开箱即用的轻量级系统监控脚本。
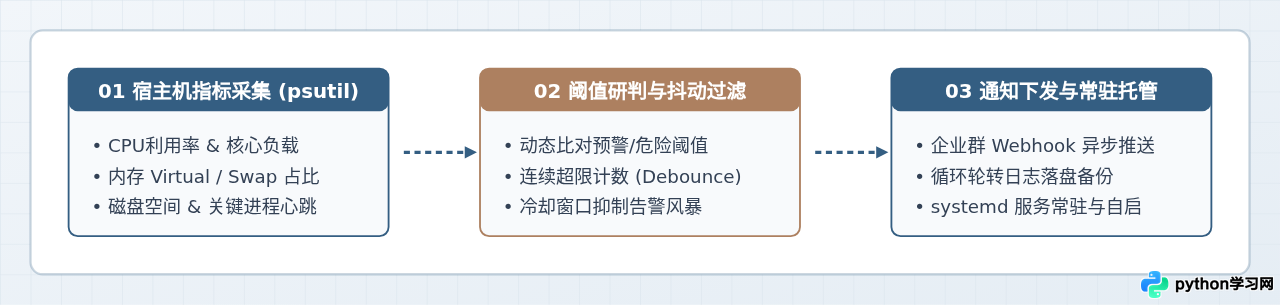
搭建一套高可靠的系统监控脚本,核心目标是用最小的资源开销获取主机运行状态,并在性能越限或进程挂起时准确通知运维人员。本文通过一个完整的Python工程实例,拆解从底层硬件指标采集(CPU、内存、磁盘、进程)、状态研判与告警防抖过滤,到Webhook通道分发以及systemd常驻守护的全流程,提供直接可在生产环境使用的脚本代码与配置规范。
一、系统监控项目的整体架构与数据流向
在轻量化运维场景中,部署复杂的集中式监控集群往往成本较高。单机或集群边缘节点更适合运行精简无依赖的Python自动化探针。整个监控闭环由四个阶段组成:底层采集、规则研判、告警聚合与持久化托管。
数据由探针从操作系统的虚拟文件系统及系统API读取,经过结构化解析后输入状态机。状态机维持当前的指标滑窗,若指标达到警告或危险阈值且满足防抖判定,立即触发报警下发模块;若状态恢复,则自动发送恢复通知。
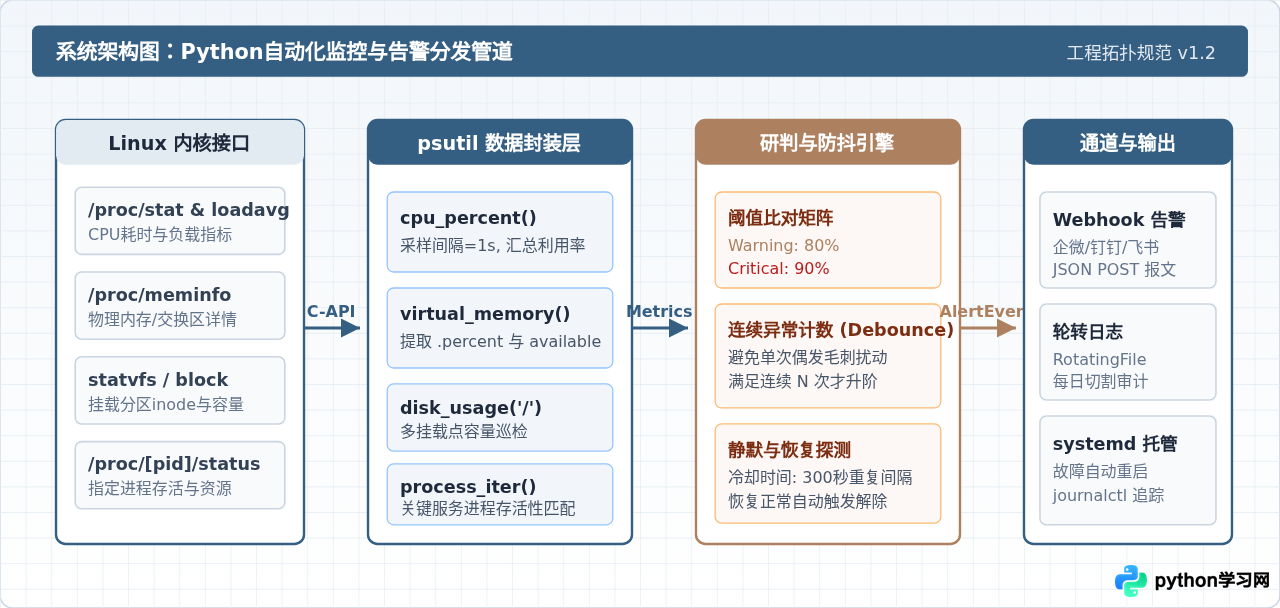
二、技术选型与采集核心:psutil 核心接口剖析
编写系统监控脚本时,传统做法常用 os.popen 或 subprocess 调用 Linux 命令(如 top、free -m、df -h)。这种方式不仅开销巨大(每次衍生子进程),且输出受命令版本和语言环境变量(如 LANG=zh_CN)影响,极易发生解析崩溃。
成熟项目优先选用 psutil(process and system utilities)。该库采用底层 C 扩展直接读取内核数据结构,性能优异且数据结构标准统一。
| 监控维度 | 核心 API 调用 | 关键返回属性 | 监控与排查注意点 |
|---|---|---|---|
| CPU利用率 | psutil.cpu_percent(interval=1.0) |
浮点数(百分比) | 必须传入 interval(建议1秒),若传入0则为非阻塞历史值,易失真。 |
| 系统平均负载 | psutil.getloadavg() |
三元元组 (1m, 5m, 15m) | 负载需与逻辑 CPU 核心数(psutil.cpu_count())结合分析。 |
| 物理内存 | psutil.virtual_memory() |
total, available, percent |
判断可用内存务必以 available 为准,Linux 的 buffers/cache 会被自动回收。 |
| 磁盘空间 | psutil.disk_usage(path) |
total, used, free, percent |
根分区 / 及独立挂载点(如 /data)需分别巡检。 |
| 关键进程存活 | psutil.process_iter(['name', 'pid']) |
进程信息生成器字典 | 遍历时必须捕获 NoSuchProcess 与 AccessDenied 异常。 |
三、项目实施全过程:从环境配置到完整脚本编写
为了保证项目具备工程化规范,脚本采用配置与代码分离的设计模式。将所有监控项的阈值、探测频率、Webhook 地址提取到 config.json,核心逻辑封装在 monitor.py 中。
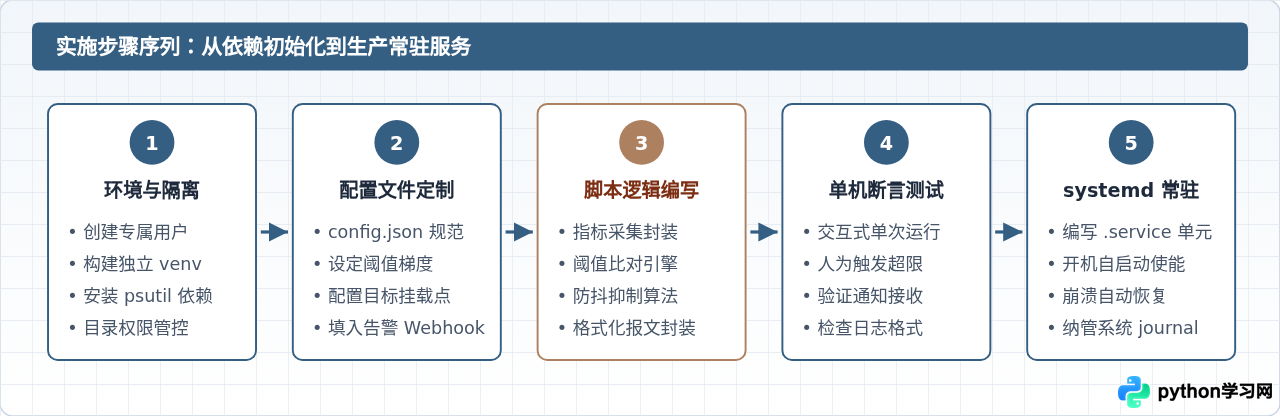
步骤一:项目工程目录与虚拟环境构建
为避免污染全局 Python 环境,推荐在 /opt/sysops-monitor 目录下构建隔离的运行环境。以 root 或具备 sudo 权限的运维账号在终端执行:
# 创建项目目录并进入
sudo mkdir -p /opt/sysops-monitor
cd /opt/sysops-monitor

# 创建独立虚拟环境并激活
python3 -m venv venv
source venv/bin/activate

# 安装运维核心库(只使用必要依赖)
pip install psutil==5.9.8 requests==2.31.0
步骤二:编写配置文件(config.json)
配置文件定义采集周期、各组件告警阈值、关注的进程列表与 Webhook 地址。保持配置解耦,后续调整指标阈值无需重启或修改核心代码。
{
  "server_name": "Prod-App-Node-01",
  "check_interval_seconds": 30,
  "debounce_count": 3,
  "alert_cooldown_seconds": 300,
  "thresholds": {
    "cpu_percent": 85.0,
    "memory_percent": 88.0,
    "disk_percent": 90.0,
    "load_15m_per_core": 1.2
  },
  "monitored_disks": ["/", "/var/log"],
  "monitored_processes": ["nginx", "mysqld", "redis-server"],
  "webhook_url": "https://oapi.dingtalk.com/robot/send?access_token=YOUR_TOKEN_HERE"
}
步骤三:编写核心监控脚本(monitor.py)
以下是监控主脚本的完整实现。包含日志自动轮转(单个日志最大 5MB,保留 3 个副本)、异常兜底、连续越限防抖判定、冷却期维护以及标准 JSON Webhook 投递。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
# 轻量化系统自动化监控脚本:实现 CPU、内存、磁盘、平均负载与关键进程存活性探测
import os
import sys
import time
import json
import socket
import logging
from logging.handlers import RotatingFileHandler
import urllib.request
import urllib.error
import psutil

# 初始化日志输出器
LOG_DIR = "/var/log/sysops-monitor"
os.makedirs(LOG_DIR, exist_ok=True)
log_file = os.path.join(LOG_DIR, "monitor.log")

logger = logging.getLogger("SystemMonitor")
logger.setLevel(logging.INFO)
formatter = logging.Formatter(
    '[%(asctime)s] [%(levelname)s] [%(filename)s:%(lineno)d]: %(message)s'
)
# 文件轮转处理器
file_handler = RotatingFileHandler(log_file, maxBytes=5 * 1024 * 1024, backupCount=3)
file_handler.setFormatter(formatter)
# 标准控制台输出
stream_handler = logging.StreamHandler(sys.stdout)
stream_handler.setFormatter(formatter)

logger.addHandler(file_handler)
logger.addHandler(stream_handler)


def load_config(config_path="/opt/sysops-monitor/config.json"):
    """安全读取JSON配置文件"""
    if not os.path.exists(config_path):
        logger.error(f"配置文件不存在: {config_path}")
        sys.exit(1)
    with open(config_path, "r", encoding="utf-8") as f:
        return json.load(f)


def get_local_ip():
    """获取当前主机首选出网IPv4地址"""
    s = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
    try:
        # 连接公网不可达路由测试地址,无需真实握手
        s.connect(('10.255.255.255', 1))
        ip = s.getsockname()[0]
    except Exception:
        ip = "127.0.0.1"
    finally:
        s.close()
    return ip


class MonitorEngine:
    def __init__(self, config):
        self.config = config
        self.local_ip = get_local_ip()
        self.server_name = config.get("server_name", self.local_ip)
        self.thresholds = config["thresholds"]
        self.debounce_limit = config.get("debounce_count", 3)
        self.cooldown_period = config.get("alert_cooldown_seconds", 300)

        # 状态追踪字典:记录各维度的连续异常次数与上次报警时间戳
        self.anomaly_counters = {}
        self.last_alert_time = {}
        self.is_in_alarm_state = {}

    def collect_metrics(self):
        """精准采集主机各项核心指标"""
        # 1. CPU 利用率(阻断采集 1 秒获取真实平均值)
        cpu_usage = psutil.cpu_percent(interval=1.0)

        # 2. 物理内存与可用率
        mem = psutil.virtual_memory()
        mem_usage = mem.percent
        mem_avail_mb = round(mem.available / (1024 * 1024), 1)

        # 3. 系统平均负载(1分、5分、15分)
        load1, load5, load15 = psutil.getloadavg()
        cpu_cores = psutil.cpu_count(logical=True) or 1
        load_15m_norm = round(load15 / cpu_cores, 2)

        # 4. 指定挂载点磁盘使用率
        disk_status = {}
        for mount_point in self.config.get("monitored_disks", ["/"]):
            if os.path.exists(mount_point):
                usage = psutil.disk_usage(mount_point)
                disk_status[mount_point] = usage.percent
            else:
                logger.warning(f"配置的磁盘挂载路径不存在: {mount_point}")

        # 5. 关键服务进程存活性扫描
        monitored_procs = self.config.get("monitored_processes", [])
        running_proc_names = set()
        for p in psutil.process_iter(['name']):
            try:
                running_proc_names.add(p.info['name'])
            except (psutil.NoSuchProcess, psutil.AccessDenied):
                continue

        proc_status = {name: (name in running_proc_names) for name in monitored_procs}

        return {
            "cpu_percent": cpu_usage,
            "memory_percent": mem_usage,
            "mem_available_mb": mem_avail_mb,
            "load_15m_norm": load_15m_norm,
            "load15": load15,
            "cpu_cores": cpu_cores,
            "disks": disk_status,
            "processes": proc_status
        }

    def evaluate_item(self, item_key, is_abnormal, current_desc):
        """
        状态防抖与告警下发决策器
        :param item_key: 监控项唯一标识符
        :param is_abnormal: 本次周期是否超出阈值
        :param current_desc: 当前状况可读描述
        """
        now = time.time()
        count = self.anomaly_counters.get(item_key, 0)
        was_alarmed = self.is_in_alarm_state.get(item_key, False)

        if is_abnormal:
            count += 1
            self.anomaly_counters[item_key] = count
            logger.warning(f"[{item_key}] 触发越限! 连续次数: {count}/{self.debounce_limit}. 详情: {current_desc}")

            # 满足防抖次数要求
            if count >= self.debounce_limit:
                last_time = self.last_alert_time.get(item_key, 0)
                # 检查冷却周期
                if (now - last_time) >= self.cooldown_period:
                    self.send_webhook_alert("WARNING", item_key, current_desc)
                    self.last_alert_time[item_key] = now
                    self.is_in_alarm_state[item_key] = True
        else:
            # 状态恢复检测
            if count > 0:
                self.anomaly_counters[item_key] = 0
            if was_alarmed:
                # 此前处于告警状态,现在恢复正常
                self.send_webhook_alert("RECOVERY", item_key, f"指标已恢复正常区间: {current_desc}")
                self.is_in_alarm_state[item_key] = False

    def send_webhook_alert(self, level, item_key, message):
        """封装标准 JSON 报文并通过 HTTP POST 投递"""
        webhook_url = self.config.get("webhook_url", "")
        if not webhook_url:
            logger.info(f"[告警模拟] [{level}] {item_key}: {message}")
            return

        title_tag = "【故障告警】" if level == "WARNING" else "【故障恢复】"
        payload = {
            "msgtype": "markdown",
            "markdown": {
                "title": f"{title_tag} {self.server_name}",
                "text": (
                    f"### {title_tag} 服务器状态通知\n"
                    f"- **节点名称**: {self.server_name} ({self.local_ip})\n"
                    f"- **告警级别**: `{level}`\n"
                    f"- **监控项目**: `{item_key}`\n"
                    f"- **事件详情**: {message}\n"
                    f"- **上报时间**: {time.strftime('%Y-%m-%d %H:%M:%S', time.localtime())}\n"
                )
            }
        }

        try:
            req_data = json.dumps(payload).encode('utf-8')
            req = urllib.request.Request(
                webhook_url,
                data=req_data,
                headers={'Content-Type': 'application/json'},
                method='POST'
            )
            with urllib.request.urlopen(req, timeout=5) as response:
                if response.status == 200:
                    logger.info(f"告警下发成功: [{level}] {item_key}")
                else:
                    logger.error(f"告警下发异常: HTTP状态码 {response.status}")
        except Exception as e:
            logger.error(f"发送 Webhook 告警失败: {str(e)}")

    def run_cycle(self):
        """执行单轮次检测评估"""
        metrics = self.collect_metrics()

        # 评估 CPU
        cpu_val = metrics["cpu_percent"]
        cpu_limit = self.thresholds.get("cpu_percent", 85.0)
        self.evaluate_item(
            "CPU_Usage",
            cpu_val >= cpu_limit,
            f"当前使用率: {cpu_val}%, 设定阈值: {cpu_limit}%"
        )

        # 评估 内存
        mem_val = metrics["memory_percent"]
        mem_limit = self.thresholds.get("memory_percent", 88.0)
        self.evaluate_item(
            "Memory_Usage",
            mem_val >= mem_limit,
            f"当前使用率: {mem_val}% (剩余 {metrics['mem_available_mb']}MB), 设定阈值: {mem_limit}%"
        )

        # 评估 15分钟归一化负载
        load_norm = metrics["load_15m_norm"]
        load_limit = self.thresholds.get("load_15m_per_core", 1.2)
        self.evaluate_item(
            "System_Load",
            load_norm >= load_limit,
            f"15m归一化单核负载: {load_norm} (物理核心: {metrics['cpu_cores']}), 设定阈值: {load_limit}"
        )

        # 评估 磁盘空间
        disk_limit = self.thresholds.get("disk_percent", 90.0)
        for mnt, usage in metrics["disks"].items():
            self.evaluate_item(
                f"Disk_{mnt}",
                usage >= disk_limit,
                f"挂载点 [{mnt}] 使用率: {usage}%, 设定阈值: {disk_limit}%"
            )

        # 评估 关键进程存活性
        for proc_name, is_running in metrics["processes"].items():
            self.evaluate_item(
                f"Proc_{proc_name}",
                not is_running,
                f"核心服务进程 [{proc_name}] 离线未运行!"
            )


def main():
    config = load_config()
    engine = MonitorEngine(config)
    interval = config.get("check_interval_seconds", 30)

    logger.info("==========================================")
    logger.info(f"系统监控守护进程启动! 宿主机: {engine.server_name}")
    logger.info(f"监控周期: 每 {interval} 秒探测一次")
    logger.info("==========================================")

    while True:
        try:
            engine.run_cycle()
        except Exception as e:
            logger.exception(f"周期执行异常捕捉: {str(e)}")
        time.sleep(interval)


if __name__ == "__main__":
    main()
四、核心机制:告警防抖与冷却状态机实现
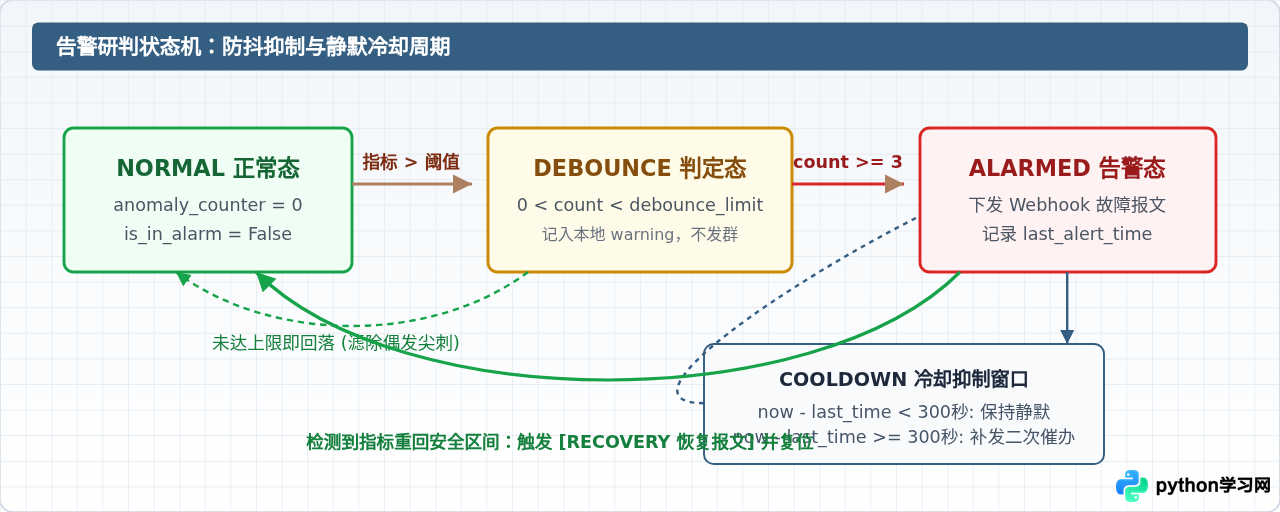
在生产环境中,最忌讳“告警风暴”与“毛刺误报”。例如某次批量任务可能导致 CPU 利用率瞬间飙升至 95%,但持续时间仅有 2 秒;或者磁盘满载后,监控每 30 秒向群聊狂轰一条告警,导致真正严重的故障被淹没。
针对此问题,脚本内置了双重保障机制:
- 连续异常计数(Debounce 阈值防抖):设定
debounce_count=3,指标第一次触碰红线时仅记入日志警告,只有连续 3 次探测(跨越约 90 秒)均超标时,才确认故障成立并初次触发告警。 - 冷却时间窗口(Cooldown 抑制机制):告警触发后,记录时间戳。在接下来的
alert_cooldown_seconds(例如 300 秒)内即使指标依旧超限,也保持静默;直到冷却窗口超时且异常仍未消除,才二次补发提醒。 - 状态自动解除通知(Recovery 闭环):指标回落至安全线以下后,状态机将计数归零,并自动发送一条绿色恢复报文,告知故障已解除。
五、生产部署与服务托管:systemd 自动化常驻
为了避免终端关闭或服务器重启导致监控中断,必须将脚本委托给 Linux 系统的 systemd 初始化系统进行统一纳管。
1. 编写 Unit 服务单元文件
在 /etc/systemd/system/ 目录下创建 sysops-monitor.service 文件:
[Unit]
Description=Python System Automation Monitor Agent
After=network.target network-online.target
Wants=network-online.target

[Service]
Type=simple
User=root
WorkingDirectory=/opt/sysops-monitor
ExecStart=/opt/sysops-monitor/venv/bin/python3 /opt/sysops-monitor/monitor.py
Restart=always
RestartSec=10s
StandardOutput=journal
StandardError=journal
LimitNOFILE=65535

[Install]
WantedBy=multi-user.target
2. 加载配置与启动服务
# 重新加载 systemd 守护进程
sudo systemctl daemon-reload

# 启用开机自启并立刻启动监控
sudo systemctl enable --now sysops-monitor.service

# 查看服务运行状态
sudo systemctl status sysops-monitor.service
启动成功后,可在控制台查看到如下示例输出:
Loaded: loaded (/etc/systemd/system/sysops-monitor.service; enabled; vendor preset: enabled)
Active: active (running) since Sun 2026-11-01 08:30:15 CST; 1min 20s ago
Main PID: 18452 (python3)
Tasks: 1 (limit: 4915)
Memory: 18.2M
CGroup: /system.slice/sysops-monitor.service
└─18452 /opt/sysops-monitor/venv/bin/python3 /opt/sysops-monitor/monitor.py
Nov 01 08:30:15 Prod-App-Node-01 python3[18452]: [2026-11-01 08:30:15,102] [INFO] [monitor.py:195]: ==========================================
Nov 01 08:30:15 Prod-App-Node-01 python3[18452]: [2026-11-01 08:30:15,103] [INFO] [monitor.py:196]: 系统监控守护进程启动! 宿主机: Prod-App-Node-01
Nov 01 08:30:15 Prod-App-Node-01 python3[18452]: [2026-11-01 08:30:15,103] [INFO] [monitor.py:197]: 监控周期: 每 30 秒探测一次
Nov 01 08:30:15 Prod-App-Node-01 python3[18452]: [2026-11-01 08:30:15,104] [INFO] [monitor.py:198]: ==========================================
六、运维实战验证与排错指南
部署完成后,必须进行人为故障注入以验证告警闭环的有效性。
1. 故障注入测试
- 内存满载模拟:可使用
stress --vm 1 --vm-bytes 90% --vm-hang 60或 Python 分配大列表。 - 服务离线模拟:临时停止某个关注的服务(例如
sudo systemctl stop nginx),观察日志输出与 Webhook 收到【故障告警】核心服务进程 [nginx] 离线未运行!。 - 恢复测试:重新拉起服务(
sudo systemctl start nginx),等待下一个周期,应收到【故障恢复】指标已恢复正常区间的通知。
1. 日志权限与磁盘打满:脚本默认输出在
/var/log/sysops-monitor,请确保通过 RotatingFileHandler 严格限制单个文件尺寸与保留副本数,杜绝监控日志自身将 /var 填满。2. Webhook 超时设置:
urllib.request.urlopen 必须显式设置 timeout=5。内网断网或代理阻塞时,若无超时,将导致监控主线程长期挂起在网络 I/O 上。3. CPU 核心感知:平均负载
loadavg 必须除以 logical=True 的逻辑核心数。若在一台 32 核服务器上 15 分钟负载为 16,其实利用率仅为 50%,不应当作故障报警。
七、工程总结与指标运维对照表
在实际生产中,各类型服务的阈值配置具有差异性。下表整理了常见生产业务节点的典型阈值与排查策略:
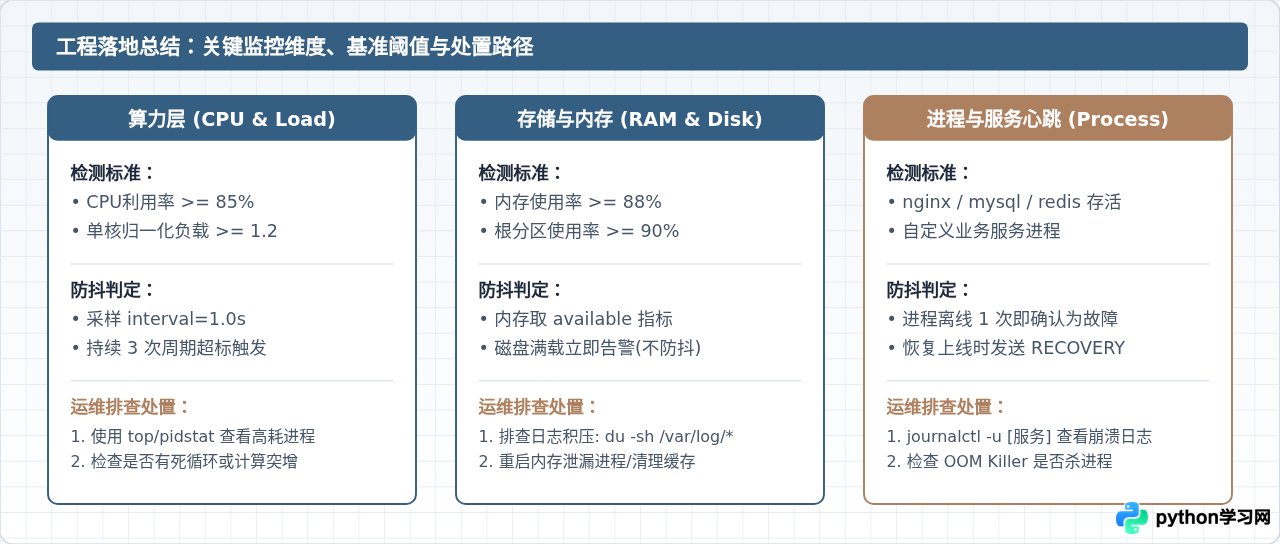
通过上述模块的设计与实现,本套监控体系以不到 250 行核心代码构建了完整的自动化巡检与告警通道。它的运行开销极小(CPU 占用低于 0.1%,内存常驻仅 18MB 左右),在保证对业务系统零侵扰的前提下,实现了对主机硬件健康与关键进程存活的实时洞察与全自动通知。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















