


Python无法打开损坏的Word文档怎么办
发布时间:2026-11-05 |
9人浏览过
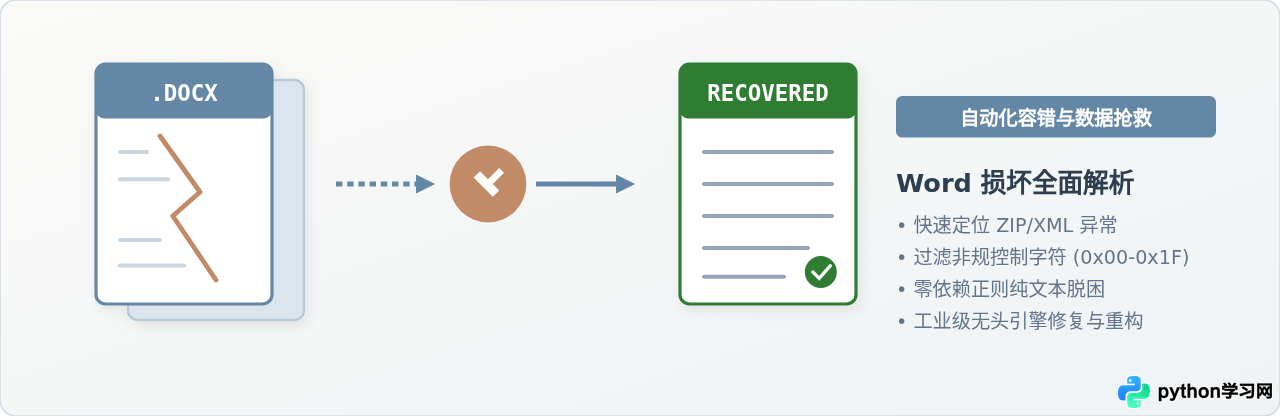
针对 Python 使用 python-docx 读取 Word 文档时出现的 PackageNotFoundError、BadZipFile 或 XMLSyntaxError 等报错,深入剖析其底层 ZIP 与 XML 损坏机理,并提供从文件头诊断、XML 非法字符清洗、底层流正则提取到无头办公软件中转修复的完整解决方案。
标签:Python自动化 / 故障排查 / 文档处理
实用技术指南
阅读时长:约 8 分钟
在 Python 自动化办公与文档批量处理场景中,使用
python-docx 读取 Word 文档(.docx)时,常常会因文件损坏而触发 PackageNotFoundError、BadZipFile 或 XMLSyntaxError 等异常,导致程序意外中断。解决该问题的核心路径在于明确现代 Word 文档是“遵循 Open Packaging Conventions(OPC)规范的 ZIP 归档包”:先通过文件头魔数与 ZIP 结构诊断损坏处于容器层、目录关系层还是 XML 语法层;再根据损坏深度,依次采用内存级 XML 非法控制字符清洗、底层流正则纯文本提取或调用无头办公引擎底层修复,在最大化保全数据的前提下完成自动恢复。
一、故障根源:为什么 Python 会拒绝打开损坏的 Word 文档
很多开发者在遇到 Python 无法打开 .docx 文件时,第一反应往往是升级 python-docx 库或检查文件路径是否存在。然而深入底层会发现,.docx 并不是扁平的单一二进制文件,而是一个包含了多层目录与数十个 XML 配置文件的标准 ZIP 压缩包。
当执行 docx.Document('sample.docx') 时,底层经历了两道极其严苛的校验关卡:
- ZIP 容器完整性校验:Python 标准库的
zipfile模块首先介入,核验文件头是否为0x504B0304(即 ASCII 的PK),随后扫描末尾的中央目录记录(End of Central Directory Record)。如果文件在网络下载过程中被截断,或者其实际上是老旧的二进制.doc格式被简单粗暴地重命名为.docx,此时就会直接抛出zipfile.BadZipFile: File is not a zip file。 - OPC 部件与 XML 语法树校验:在容器正常解压后,
python-docx会读取根目录下的[Content_Types].xml和_rels/.rels,根据关系树定位到主文档体word/document.xml。随后底层通过lxml严格解析该 XML。只要 XML 内部混入了非法 ASCII 控制字符(例如数据采集系统直接拼装字符串导致的
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















