


Python字符串大小写转换:upper、lower与capitalize用法
详细解析Python中字符串大小写转换的三个核心内置方法upper、lower与capitalize的用法、执行机制、代码示例、边界细节与选型对比。
一、核心基石:Python字符串的不可变性
在深入每个转换函数的具体语法之前,必须先明确一个最根本的概念:在Python中,字符串属于不可变类型(Immutable)。无论调用 upper()、lower() 还是 capitalize(),这些方法都绝对不会修改原始字符串内部的内容,而是根据转换规则在内存中申请一块新区域,生成并返回一个全新的字符串对象。
初学者最常见的失误就是直接执行转换方法却忘记接收返回值,导致变量值没有任何变化。我们通过以下代码来验证这一点:
# 典型失误:误以为 upper() 会就地修改原变量
raw_str = "python"
raw_str.upper()
print("直接调用后原变量:", raw_str)

# 正确做法:将返回的新字符串赋予新变量或重新赋值给原变量
upper_str = raw_str.upper()
print("新变量接收结果:", upper_str)

# 重新赋值原变量
raw_str = raw_str.upper()
print("重新赋值后原变量:", raw_str)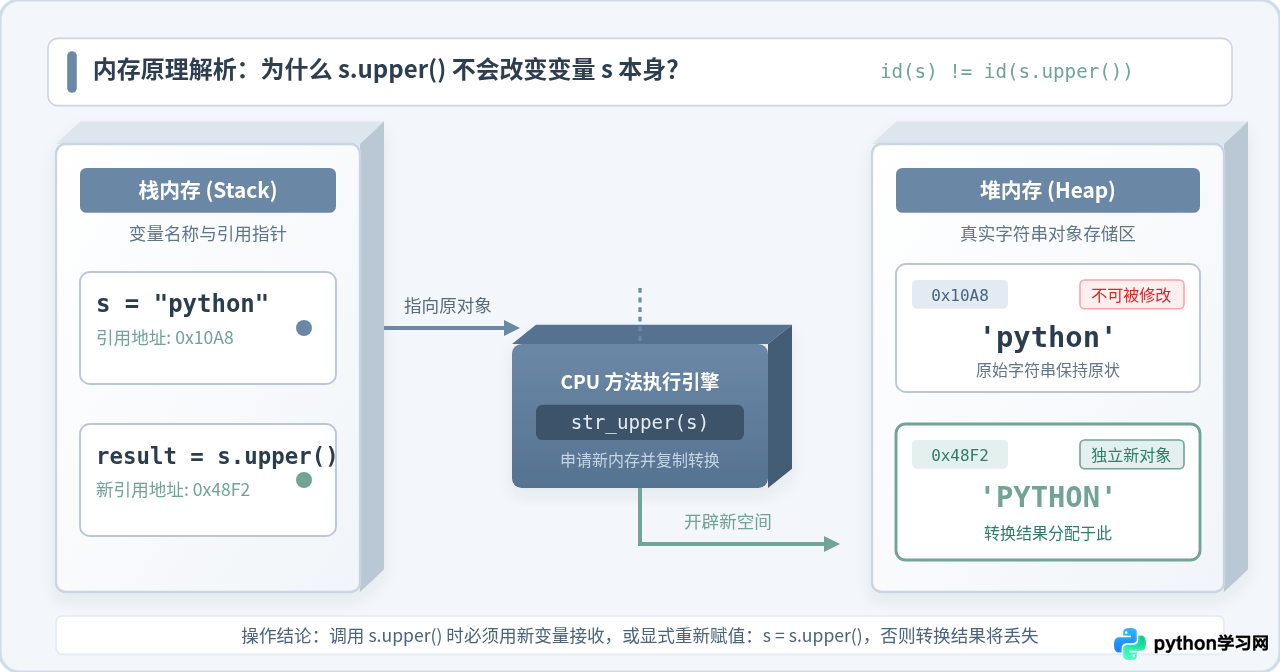
如图1所示,当执行 s.upper() 时,底层解释器读取 0x10A8 处的内容,完成ASCII码计算后,在堆内存中生成地址为 0x48F2 的新对象。如果代码写为 s.upper() 而没有等号赋值,新生成的对象由于没有任何变量引用,后续会被垃圾回收机制清理,原始变量 s 依然指向未变动的内容。
二、upper() 用法:将全部英文字母转为大写
str.upper() 的作用是将字符串中的所有小写英文字母转换成对应的大写英文字母。该方法不接收任何参数,如果传入参数会触发 TypeError。
1. 基本语法与调用
str.upper() -> str
它的转换规则非常纯粹:仅将 ASCII 字符中 'a' 至 'z'(ASCII 码 97~122)减去 32 映射为 'A' 至 'Z'(ASCII 码 65~90)。
2. 混合字符处理表现
字符串中往往包含数字、空格、标点符号以及中文等非英文字符。upper() 会自动识别这些字符并原样保留,不会发生截断或异常:
msg = "order_id: #9527-abc_测试"
result = msg.upper()
print("原始字符串:", msg)
print("转换后结果:", result)3. 实际高频应用场景
- 用户确认指令规整:在命令行交互或控制台脚本中,用户可能输入
y、Y、yes、YES。使用user_input.strip().upper() == "YES"可以简洁地完成判定。 - 常量配置生成:在动态解析配置文件或环境变量键名时,统一将配置项转换为全大写标准格式(如
DATABASE_URL)。
三、lower() 用法:将全部英文字母转为小写
与 upper() 互为镜像,str.lower() 的作用是将字符串中所有大写英文字母转换成对应的小写英文字母,同样不接收任何参数。
1. 基本语法与代码示例
account_email = "John.Doe@EXAMPLE.Com"
normalized_email = account_email.lower()
print("邮箱规范化存储:", normalized_email)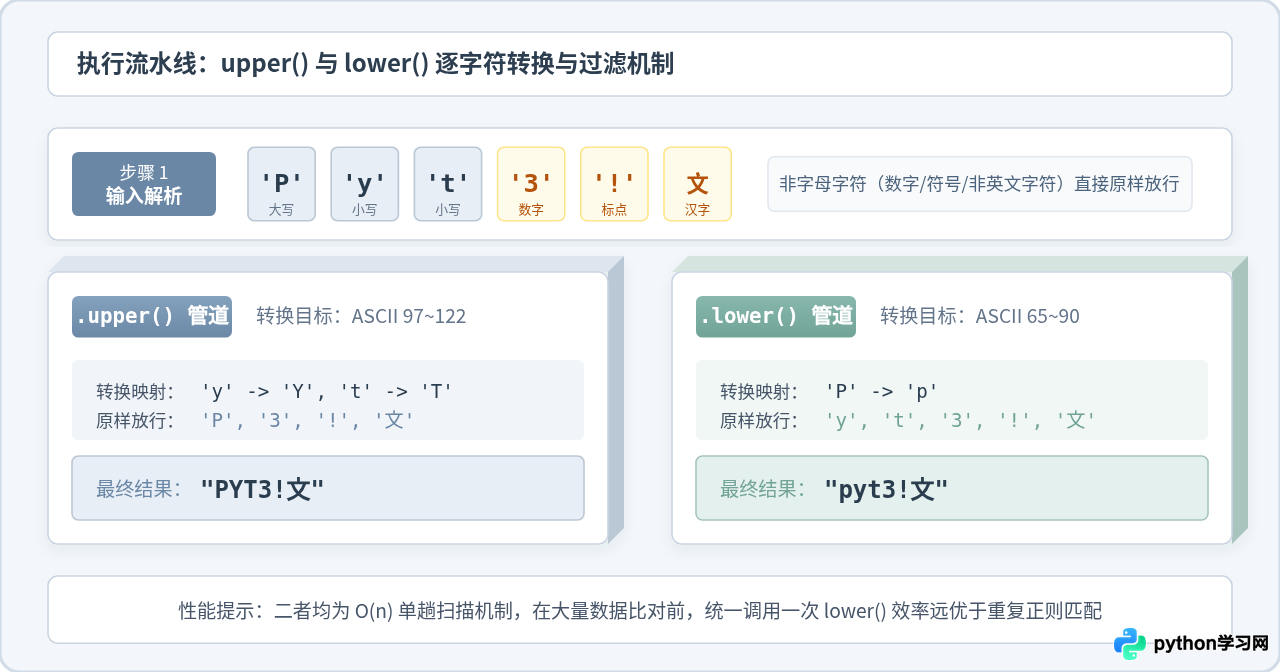
2. 实际业务场景:不区分大小写的文本比对
在登录系统或搜索关键词匹配中,通常不应该对大小写敏感。例如用户注册时输入了 Admin,如果登录时输入 admin,两者必须视为同一身份:
registered_user = "SuperAdmin"
login_input = "superadmin"

# 直接比对会返回 False
print("直接比对:", registered_user == login_input)

# 通过 lower() 统一降为小写后再比对
print("规范化后比对:", registered_user.lower() == login_input.lower())
如果你的程序面向国际化多语言场景,Python 还提供了 str.casefold()。对于标准英文 ASCII 字符,lower() 与 casefold() 表现完全一致;但对于某些德语、希腊语等特殊字符(例如德语字母 'ß'),lower() 保持 'ß',而 casefold() 会彻底转换为 'ss'。在常规开发及纯英文字符处理中,lower() 更加通用且直观。
四、capitalize() 用法:首字符大写与后续字符强制小写
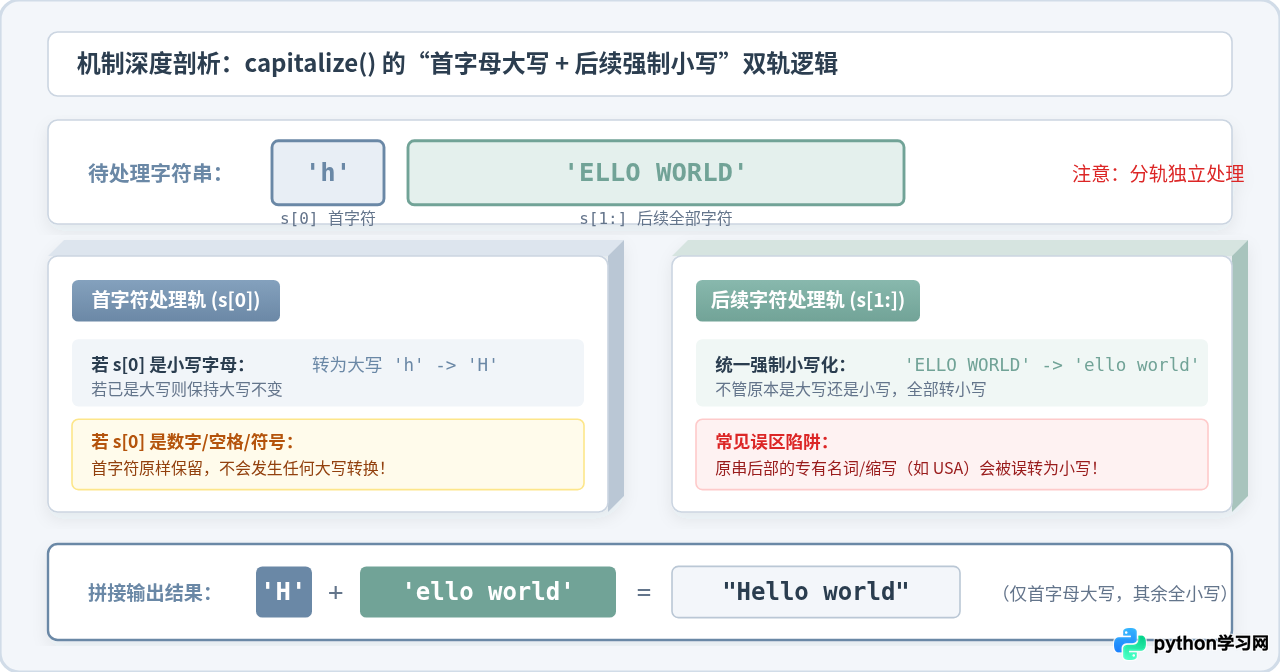
str.capitalize() 的直观语义常被理解为“首字母大写”,但它的底层执行逻辑包含两项不可分割的规则,这也是日常开发中最容易产生意外 bug 的地方。
1. capitalize() 的双重处理规则
- 处理第一个字符(Index 0):如果字符串首字符是小写英文字母,将其转换为大写;如果首字符本身已经是大写字母,或属于数字、空格、标点符号,则首字符保持原样。
- 处理其余所有字符(Index 1 至末尾):字符串中除了第一个字符以外的所有后续英文字母,无论原本是大写还是小写,都会被无条件强制转为小写。
2. 边界情况与典型示例分析
我们通过三组具代表性的字符串输入,观察 capitalize() 的具体行为:
# 案例 A:常规小写句子
s1 = "python is awesome"
print("案例 A 结果:", repr(s1.capitalize()))

# 案例 B:原串后半部分包含专有名词或缩写
s2 = "welcome to USA"
print("案例 B 结果:", repr(s2.capitalize()))

# 案例 C:首字符不是英文字母(空格或数字开头)
s3 = " 100 python tricks"
print("案例 C 结果:", repr(s3.capitalize()))
观察案例 B,原本大写的 USA 在执行后被强制转为了 usa;观察案例 C,由于首字符是空格,首字符并未大写,而原串后面的大写字母(若有)同样会被强转为小写。因此,如果需要对每个单词的首字母进行大写排版,应使用 str.title(),而不是 capitalize()。
五、三大方法全方位对比与选型决策
为了方便在编写代码时迅速决断,下表汇总了 upper()、lower() 与 capitalize() 的核心差异与技术指标:
| 方法名 | 首字符处理 | 后续字符处理 | 非字母字符反应 | 最典型使用场景 |
|---|---|---|---|---|
str.upper() |
小写转大写,大写保持 | 小写转大写,大写保持 | 原样保留 | 命令行指令比对、SQL语句格式化、环境变量键定义 |
str.lower() |
大写转小写,小写保持 | 大写转小写,小写保持 | 原样保留 | 用户输入归一化比对、邮箱存储、搜索词匹配 |
str.capitalize() |
小写转大写,其他原样保留 | 无条件强制全部转小写 | 原样保留 | 纯英文自然语言句首字符大写美化、表单单句修正 |
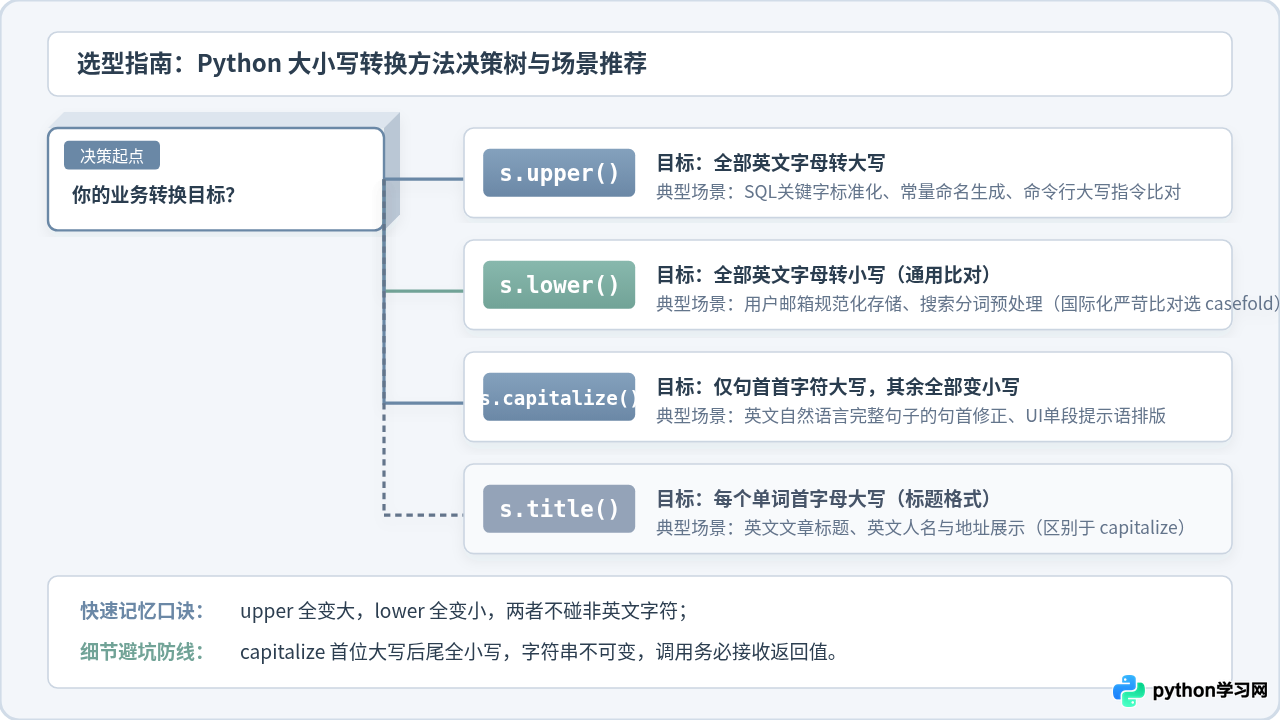
总结与避坑检查清单
- 检查是否接收了返回值:牢记字符串的不可变性,不要写出孤立的
text.upper(),务必使用text = text.upper()或赋予新变量。 - 输入对比务必双向归一化:不要仅对用户输入调用
lower()而去匹配硬编码的大写常量,双方统一调用.lower()或.upper()是最稳妥的防守性编程习惯。 - 警惕 capitalize 的破坏性降级:如果句子中存在类似
HTML、API、CPU等缩略词,capitalize()会将其强制转为小写,破坏文本原本的专业可读性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















