


Python网络请求一定要用requests吗?urllib标准库用法解析
解答Python网络请求是否必须使用requests的问题。详细梳理urllib标准库的模块构成、GET/POST请求发送、参数编码、Header伪装、Cookie与代理配置、异常处理及与requests的选型对比。
requests。Python 自带的 urllib 标准库无需安装任何依赖即可直接使用,在受限的服务器环境、轻量级自动化运维脚本、跨平台打包分发工具以及对外部供应链安全性要求严苛的场景下,urllib 是官方原生且最可靠的解决方案。本文将系统拆解 urllib 的模块架构、实用用法、异常控制与两者真正的选型边界。
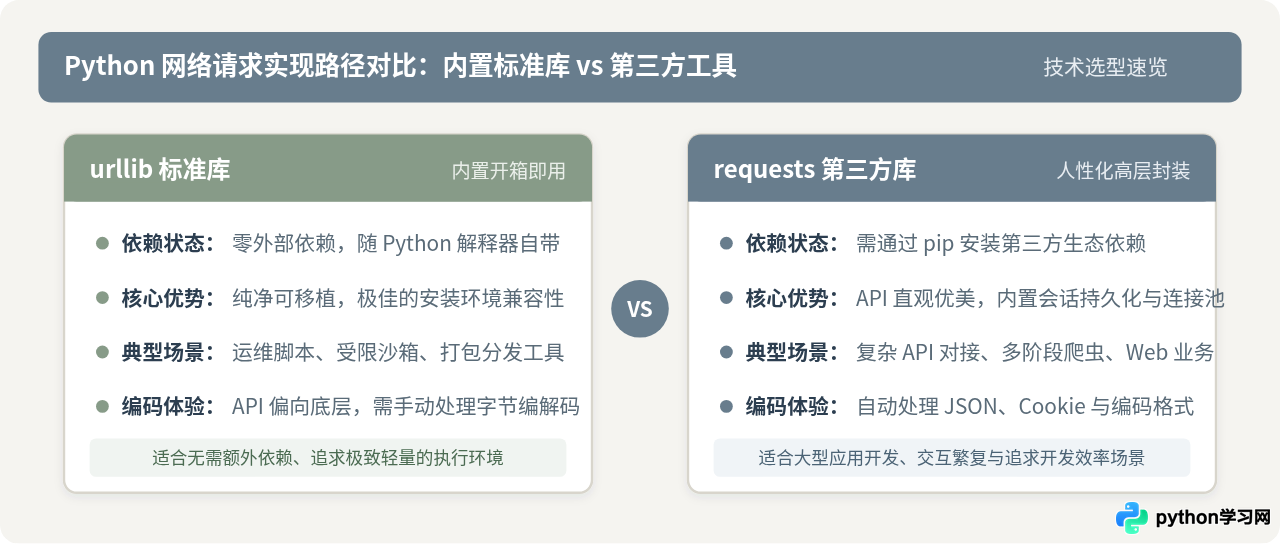
一、为什么会有“请求必用 requests”的普遍认知?
在大多数 Python 初学教程和网络资源中,只要涉及 HTTP 请求,示例代码往往第一行就是 import requests。这种现象的产生,源于 requests 极其优秀的高层抽象——它将连接池管理、JSON 自动序列化、Cookie 状态保持以及编码检测全部打包在几个直观的方法背后。
但这并不意味着标准库不可用。Python 自带的 urllib 诞生时间早,其底层设计更加贴近 HTTP 协议规范和操作系统 Socket 原型。虽然在复杂业务中编写的代码量相对较多,但在很多特定工况下,urllib 反而是更加合适甚至唯一的选择:
- 生产沙箱与受限环境:在金融、政企内网或隔离的 CI/CD 容器中,服务器无法访问外部 PyPI 仓库,无法执行
pip install。 - 独立脚本与分发工具:单文件脚本(如初始化部署脚本、
setup.py扩展安装脚本)要求拿来即用,不应给用户带来额外的依赖安装负担。 - 供应链安全要求:第三方开源包可能引入偶发漏洞或依赖升级破坏,标准库则完全由 Python 核心团队保障生命周期。
二、urllib 标准库的四大核心模块
在 Python 3 中,旧有的 urllib 和 urllib2 统一合并重构为 urllib 包,内部清晰划分为四个职责单一的子模块:
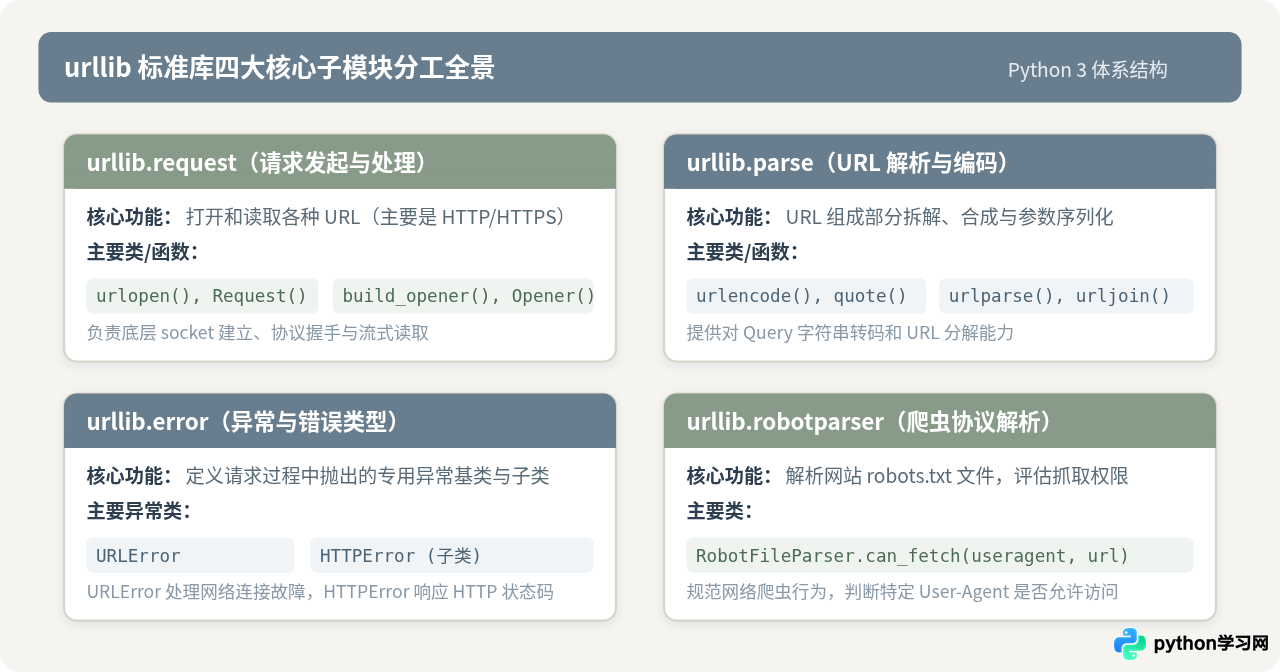
我们在实际编写网络请求时,绝大部分工作都集中在 urllib.request(负责发起连接并接收响应)、urllib.parse(负责编解码 URL 及查询参数)以及 urllib.error(处理各类网络异常)这三个模块中。
三、urllib 发起网络请求的完整步骤与基本操作
与 requests.get() 一行代码全包不同,urllib 的请求过程遵循清晰的底层网络调用生命周期。了解这一过程,有助于开发者准确把控 HTTP 报文各部分的构造。
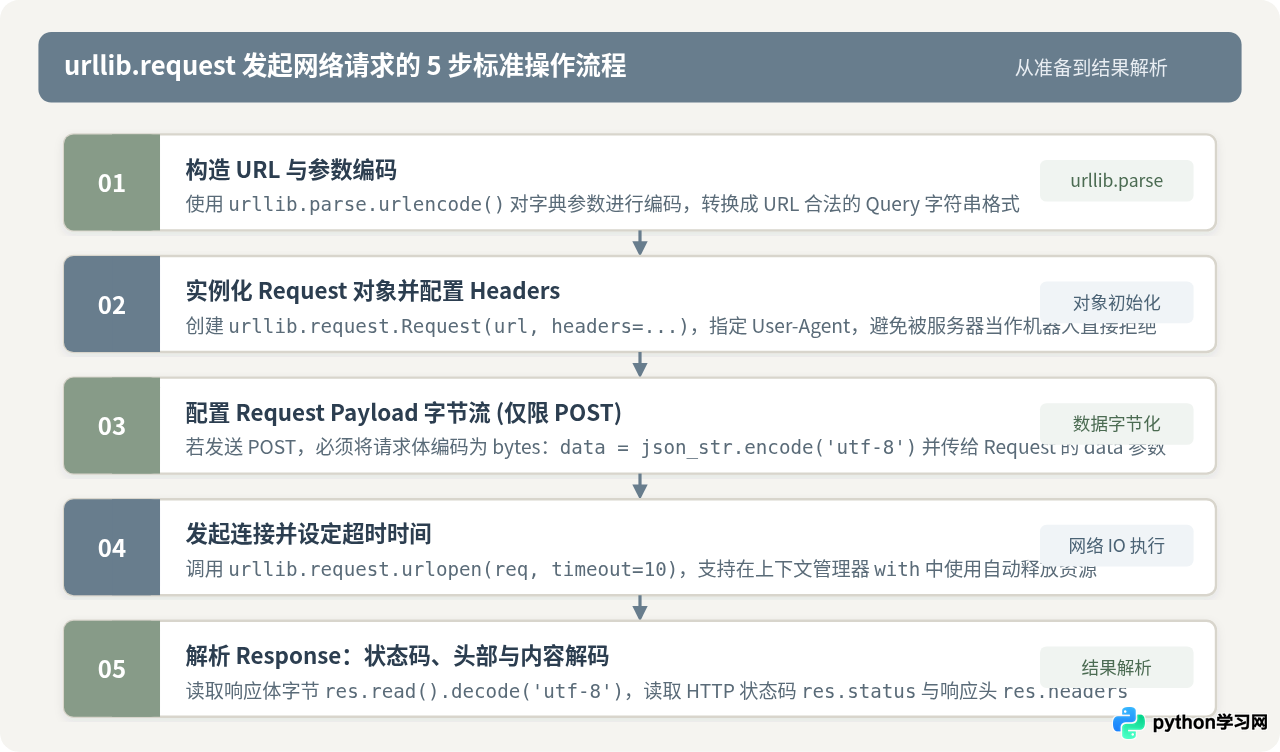
1. 发起最基础的 GET 请求
如果仅需要获取一个公开页面的内容,直接调用 urllib.request.urlopen 即可完成。返回值是一个类似文件对象的 HTTPResponse 实例:
import urllib.request

url = "https://httpbin.org/get"

# 使用 with 语句确保网络连接在读取后自动关闭
with urllib.request.urlopen(url, timeout=5) as response:
    status_code = response.status  # HTTP 状态码,如 200
    headers = response.headers      # HTTP 响应头对象
    raw_data = response.read()      # 读取到的原始字节流 (bytes)
    text = raw_data.decode("utf-8") # 将字节流解码为字符串

print(f"状态码: {status_code}")
print(f"响应内容前100字符: {text[:100]}")response.read() 返回的是未解码的 bytes 类型数据。与 requests 自动推断编码不同,urllib 要求我们显式通过 .decode("utf-8") 转换为字符串。这虽然多了一步,但避免了第三方库编码猜错导致的乱码隐患。
2. 处理 GET 查询参数(Query String)
当 URL 中包含中文字符或特殊符号时,不能直接拼接字符串,必须使用 urllib.parse.urlencode() 将字典安全编码为合法的查询串:
import urllib.request
import urllib.parse

base_url = "https://httpbin.org/get"
params = {
    "keyword": "Python标准库",
    "page": 1,
    "category": "编程"
}

# 将字典转为 'keyword=Python%E6%A0%87%E5%87%86%E5%BA%93&page=1&category=%E7%BC%96%E7%A8%8B'
query_string = urllib.parse.urlencode(params)
full_url = f"{base_url}?{query_string}"

with urllib.request.urlopen(full_url, timeout=5) as response:
    print(response.read().decode("utf-8")[:120])
3. 伪装请求头:使用 Request 对象
许多网站会检查 HTTP 报文中的 User-Agent。如果直接用 urlopen(url),urllib 默认发送的 User-Agent 会带有 Python-urllib/3.x 标识,极易被直接返回 403 Forbidden。
此时需要构造 urllib.request.Request 对象来装载自定义请求头:
import urllib.request

url = "https://httpbin.org/headers"

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "application/json",
    "Referer": "https://httpbin.org/"
}

# 构造包含特定 Headers 的 Request 对象
req = urllib.request.Request(url, headers=headers)

with urllib.request.urlopen(req, timeout=5) as response:
    print(response.read().decode("utf-8"))
4. 发送 POST 请求(表单数据与 JSON 数据)
urllib 判断请求是 GET 还是 POST 的依据非常简单:只要给 Request 传入了 data 参数,请求方法就会自动从 GET 切换为 POST。
需要特别注意,data 参数必须是已编码的 bytes 类型,不能直接传 Python 字典。
import urllib.request
import urllib.parse
import json

url = "https://httpbin.org/post"

# 场景 A: 发送普通表单数据 (Form Data)
form_data = {"username": "developer", "action": "login"}
encoded_form_data = urllib.parse.urlencode(form_data).encode("utf-8")

req_form = urllib.request.Request(url, data=encoded_form_data)
req_form.add_header("Content-Type", "application/x-www-form-urlencoded")

with urllib.request.urlopen(req_form, timeout=5) as res:
    print("Form POST 返回状态:", res.status)

# 场景 B: 发送 JSON 数据 (Application/JSON)
payload = {"task_id": 1024, "status": "completed", "scores": [98, 95]}
json_bytes = json.dumps(payload).encode("utf-8")

req_json = urllib.request.Request(
    url,
    data=json_bytes,
    headers={"Content-Type": "application/json; charset=utf-8"}
)

with urllib.request.urlopen(req_json, timeout=5) as res:
    result = json.loads(res.read().decode("utf-8"))
    print("服务器收到的 JSON:", result.get("json"))
四、进阶特性:Opener 与 Handler 机制
在 requests 中,如果我们想维持登录状态或走代理,通常会使用 requests.Session()。而在 urllib 中,这一设计模式是通过 Handler(处理器) 与 OpenerDirector(调度器) 实现的。
1. 配置 HTTP/HTTPS 代理服务器
import urllib.request

# 1. 定义 ProxyHandler,填入代理主机与端口
proxy_handler = urllib.request.ProxyHandler({
    "http": "http://127.0.0.1:7890",
    "https": "http://127.0.0.1:7890"
})

# 2. 使用 build_opener 组装含有代理处理器的 opener
opener = urllib.request.build_opener(proxy_handler)

# 3. 通过 opener.open 发送请求
# 也可以使用 urllib.request.install_opener(opener) 将其设为全局默认
try:
    with opener.open("https://httpbin.org/ip", timeout=5) as response:
        print("代理 IP 测试:", response.read().decode("utf-8"))
except Exception as e:
    print(f"代理请求失败: {e}")
2. 自动管理 Cookie 维持会话
标准库内置的 http.cookiejar 能够配合 HTTPCookieProcessor 自动提取服务端下发的 Set-Cookie 并在后续请求中自动带上,实现类似 Session 的效果:
import urllib.request
import http.cookiejar

# 1. 创建 CookieJar 容器用于在内存中存储 Cookie
cookie_jar = http.cookiejar.CookieJar()

# 2. 创建 Cookie 处理器
cookie_handler = urllib.request.HTTPCookieProcessor(cookie_jar)

# 3. 构造专用的 opener
session_opener = urllib.request.build_opener(cookie_handler)

# 4. 模拟初次访问,服务器下发 Cookie
session_opener.open("https://httpbin.org/cookies/set?token=xyz98765", timeout=5)

# 5. 第二次访问其他接口,此时客户端已自动附带该 Cookie
with session_opener.open("https://httpbin.org/cookies", timeout=5) as res:
    print("当前会话持有的 Cookie:", res.read().decode("utf-8"))
五、生产环境的异常处理与健壮性保障
网络请求受物理网络、DNS 状态及对端服务器影响,极易抛出各类网络异常。在 urllib 中,所有网络异常均继承自 urllib.error.URLError,而针对 HTTP 错误码(如 404、500、403)则特化为 urllib.error.HTTPError。
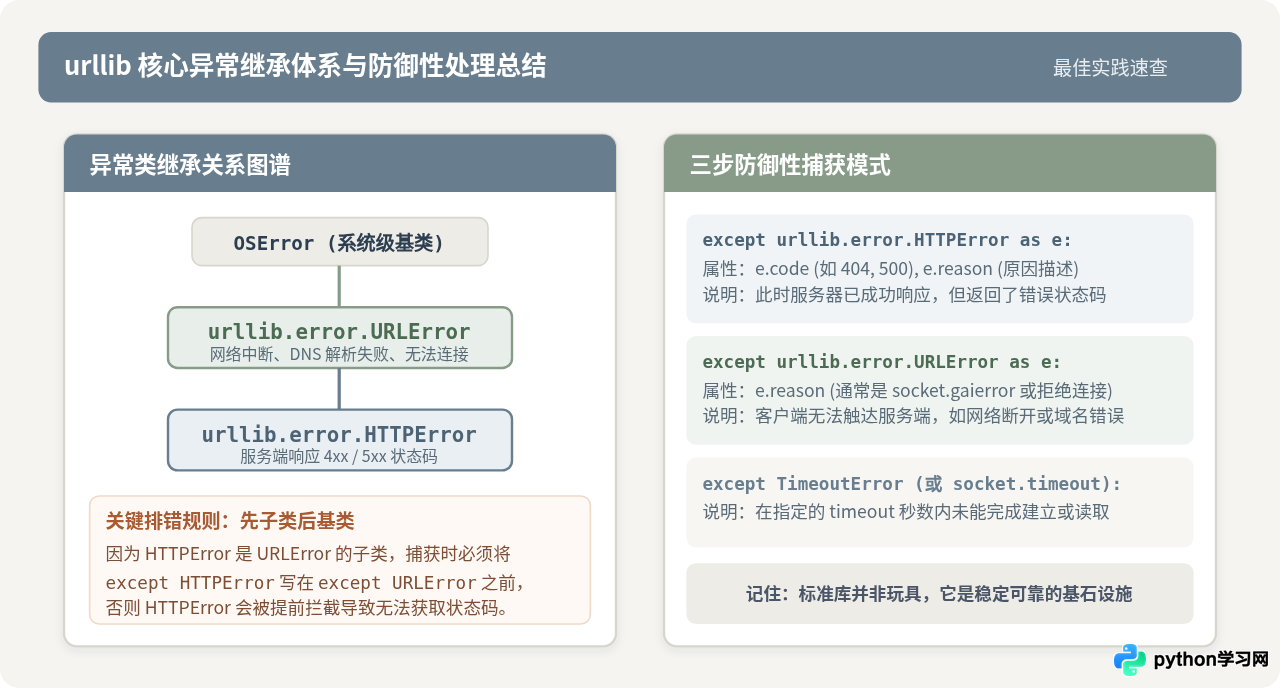
HTTPError 是 URLError 的直接子类。在写 try...except 结构时,必须严格将 except urllib.error.HTTPError 写在前面,except urllib.error.URLError 写在后面。如果颠倒顺序,HTTPError 将被提前拦截,导致无法读取 e.code 状态码。
以下是生产级推荐的稳健异常处理代码模板:
import urllib.request
import urllib.error
import socket

url = "https://httpbin.org/status/404"
req = urllib.request.Request(url, headers={"User-Agent": "Mozilla/5.0"})

try:
    with urllib.request.urlopen(req, timeout=5) as response:
        content = response.read().decode("utf-8")
        print("请求成功,内容长度:", len(content))

except urllib.error.HTTPError as e:
    # 状态码异常:说明服务器连通,但返回了 4xx/5xx
    print(f"[HTTP 错误] 状态码: {e.code},原因: {e.reason}")
    # HTTPError 自身也是一个 response 对象,可以读取服务端返回的具体错误说明
    error_body = e.read().decode("utf-8", errors="ignore")
    print(f"服务端错误响应体: {error_body[:100]}")

except urllib.error.URLError as e:
    # 网络故障:说明未能建立连接,如断网、DNS解析失败或端口拒绝
    if isinstance(e.reason, socket.timeout):
        print("[超时错误] 连接或读取超时,请检查网络延迟")
    else:
        print(f"[网络错误] 无法连接到目标服务器: {e.reason}")

except TimeoutError:
    # Python 3.3+ 顶层超时捕获
    print("[超时错误] 请求超时")

except Exception as e:
    print(f"[未知异常] {e}")
六、urllib 与 requests 深度技术选型决策
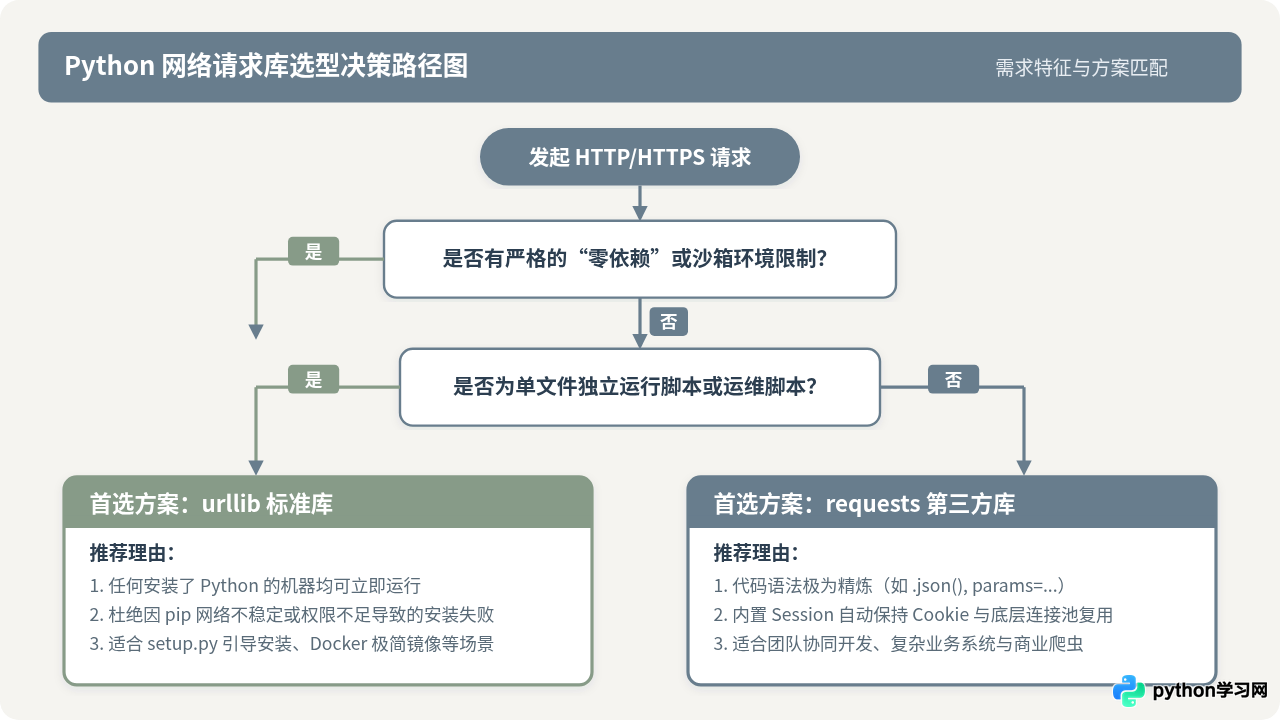
在理解了标准库的完整能力后,我们可以在工程实践中做出客观、理性的技术选型,而不是盲目跟随习惯。下表总结了两者的核心差异:
| 对比维度 | urllib (内置标准库) | requests (第三方生态) |
|---|---|---|
| 安装依赖 | 零依赖,随 Python 解释器默认分发 | 需要通过 pip 安装,伴随 urllib3、certifi 等依赖 |
| 语法简洁度 | 较为严谨冗长,需手动编码 URL 和 bytes | 极其精炼,内置 params, json, .json() |
| 连接复用 (Keep-Alive) | 默认不开启底层连接池,复用配置较繁琐 | requests.Session() 原生基于 urllib3 开启连接池 |
| 环境可移植性 | 极高,可在任何无网络权限的离线沙箱中执行 | 依赖外部包环境,离线分发需打包 wheel 或源码 |
| 典型适用定位 | 运维排障、打包脚本、受限测试环境、轻量单文件工具 | 企业级 Web 开发、复杂业务 API 客户端、多轮交互爬虫 |
七、全文总结
回答标题的问题:Python 进行网络请求绝非一定要用 requests。
- 当你在开发一个需要长期部署维护的独立工具、编写轻量级的自动化脚本、在容器最小化镜像中执行健康检查,或是受限于安全审计无法随意引入第三方包时,
urllib是完全胜任且极为可靠的利器。 - 掌握
urllib.request.Request组装报文、urllib.parse.urlencode编码参数、利用Opener扩展代理与 Cookie,以及分层处理HTTPError与URLError,是每位合格 Python 开发者应具备的底层基本功。 - 对于交互频繁、接口繁多、依赖 Session 保持的大型商业项目,
requests依然能大幅节省业务编码时间。明晰两者的能力边界,根据运行环境和交付形态选择最契合的工具,才是专业工程思维的体现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















