


Python赋值、浅拷贝与深拷贝三者有什么区别?

在 Python 编程中,赋值、浅拷贝与深拷贝的核心区别在于对内存对象引用的复制层级与解耦深度不同。赋值操作(=)完全不创建任何新对象,仅给已有对象增加一个新变量名(指针绑定);浅拷贝(如 copy.copy() 或切片 [:])会创建一个新的外层容器对象,但容器内部的子元素仍继续引用原对象的子元素;深拷贝(copy.deepcopy())则递归遍历所有层级,将外层容器与所有内部嵌套的可变对象均复制出完全独立的全新副本。
理解这三者的差异,关键在于建立对 Python 变量“名字与对象绑定”机制的认知,明确哪些操作会共享内存空间,哪些操作能够实现完全的数据隔离。
一、核心机制全景透视:内存引用模型对比
Python 中一切皆为对象,变量本身并不是存储数据的盒子,而是绑定在堆内存对象上的“标签”(引用)。当程序执行赋值、浅拷贝和深拷贝时,系统在内存中构建出的指针拓扑结构截然不同:
- 直接赋值:仅增加引用的别名,两个变量共享同一个外层容器和同一个内层元素。
- 浅拷贝:外层容器独立(具有独立的内存地址),但内层嵌套对象依然是指向同一内存地址的指针引用。
- 深拷贝:外层容器与内层嵌套对象全部在内存中开辟独立空间,实现全链路的物理隔离。
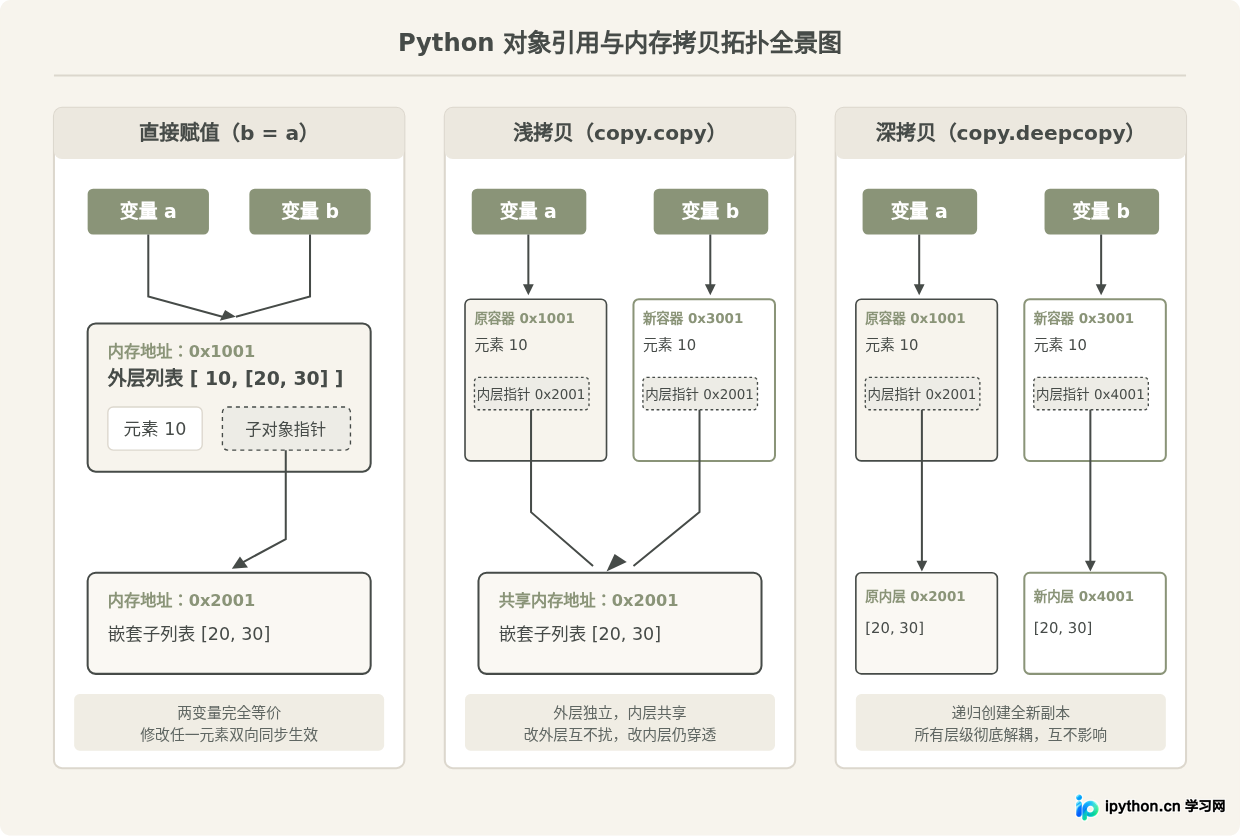
二、赋值操作:引用绑定的本质与代码行为
在 Python 中,执行 b = a 这一语句时,解释器并未在内存中开辟任何新的存储空间来存放数据,而是直接将变量名 b 绑定到变量 a 当前所指向的内存地址上。此时,a 与 b 实际上是同一个对象的两个别名。
通过内置函数 id() 可以获取对象在内存中的唯一身份标识,通过 is 关键字可以判断两个变量是否指向完全相同的内存对象:
# 1. 初始化包含嵌套列表的对象
original_list = [10, 20, [30, 40]]

# 2. 直接赋值给新变量
assigned_list = original_list

# 3. 内存地址与同一性核对
print("原始地址:", id(original_list))
print("赋值地址:", id(assigned_list))
print("是否为同一对象:", assigned_list is original_list)  # 输出: True

# 4. 修改外层或内层元素
assigned_list[0] = 99
assigned_list[2].append(50)

print("修改后 original_list:", original_list)  # 输出: [99, 20, [30, 40, 50]]
print("修改后 assigned_list:", assigned_list)  # 输出: [99, 20, [30, 40, 50]]
从代码执行结果可见,由于二者在底层指向同一块内存区域,针对 assigned_list 无论是执行外层索引赋值还是内层方法追加,都会直接反映在 original_list 上。赋值操作的时间复杂度为常数级 O(1),内存开销仅为一个变量名指针的存储成本。
三、浅拷贝:外层解耦与内层引用的穿透陷阱
浅拷贝(Shallow Copy)会在内存中构建一个新的外层容器对象,但对于容器内部容纳的各个子元素,浅拷贝仅复制它们的引用(即内存地址),而不会复制子元素本身。在 Python 中,有多种常见语法可以触发浅拷贝:
- 调用标准库模块方法:
copy.copy(x) - 内置序列类型的切片操作:
x[:] - 内置类型的工厂函数或构造方法:
list(x)、dict(d)、set(s) - 对象自带的复制方法:
list.copy()、dict.copy()
浅拷贝最容易产生隐蔽 Bug 的地方,在于开发者容易对“外层元素独立”产生误解,从而忽视了“内层嵌套可变对象依然共享”的事实:
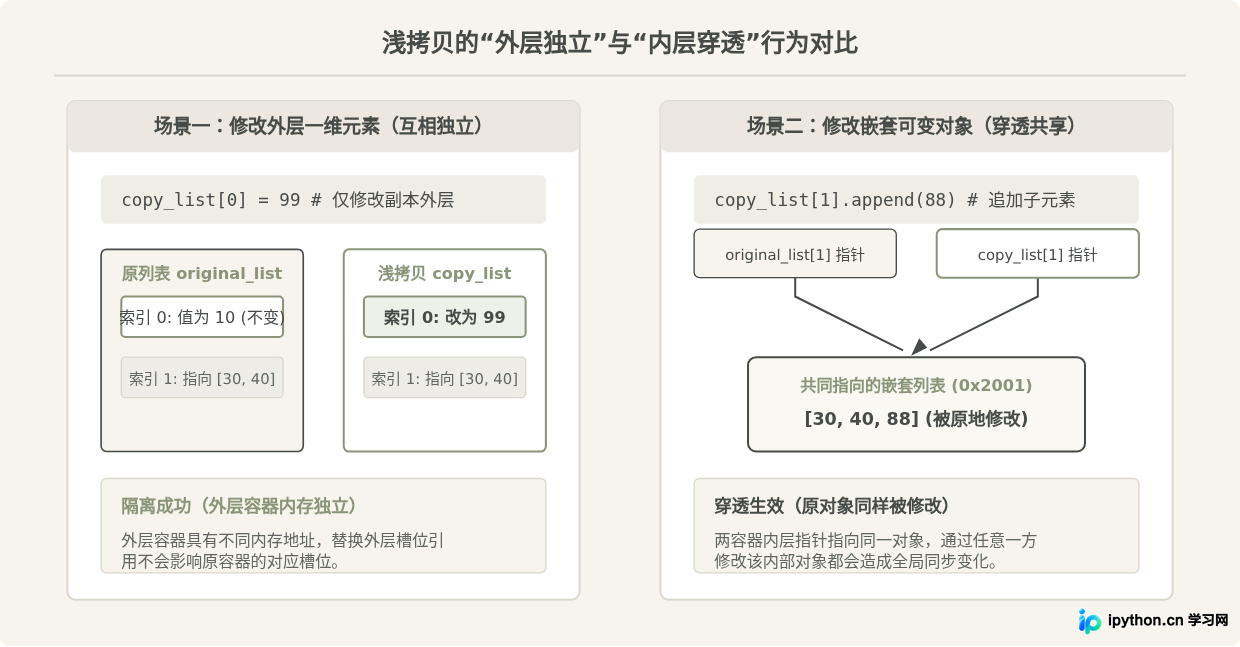
我们用一段具体的代码来验证上述机制:
import copy

# 定义包含不可变元素与可变嵌套对象的复合列表
original = [1, [2, 3]]

# 使用 copy.copy 进行浅拷贝
shallow = copy.copy(original)

# 验证外层容器与内层子对象的身份标识
print("外层容器是否相同:", shallow is original)          # False (已创建新外壳)
print("内层子列表是否相同:", shallow[1] is original[1])  # True  (共享内层引用)

# 操作 1:修改浅拷贝的外层元素
shallow[0] = 100
print("修改外层后 original:", original)  # [1, [2, 3]],原对象不受影响

# 操作 2:修改浅拷贝的内层嵌套列表
shallow[1].append(999)
print("修改内层后 original:", original)  # [1, [2, 3, 999]],原对象被意外穿透修改!
因此,对于只包含数字、字符串等不可变数据的一维扁平列表,浅拷贝足以实现完整的数据隔离;但在存在多层嵌套可变对象(如列表嵌套列表、字典嵌套字典)的场景下,浅拷贝绝不能提供深层次的安全隔离。
四、深拷贝:全层级递归克隆与内存完全隔离
深拷贝(Deep Copy)通过标准库函数 copy.deepcopy(x) 实现。它会递归地复制对象图中的所有可变容器与嵌套子对象,直到最底层均为完全独立的全新副本。深拷贝完成后,新对象与原对象之间在堆内存中不存在任何共享的可变数据结构。
import copy

original = [10, [20, 30]]
deep = copy.deepcopy(original)

# 验证容器及子对象的身份标识
print("外层容器是否相同:", deep is original)        # False
print("内层列表是否相同:", deep[1] is original[1])    # False (内层也开辟了新空间)

# 分别修改深拷贝对象的外层和内层
deep[0] = 999
deep[1].append(888)

print("原列表 original:", original)  # 输出: [10, [20, 30]] (完全不受干扰)
print("深拷贝列表 deep:", deep)        # 输出: [999, [20, 30, 888]]
深拷贝虽然保证了数据的绝对隔离,但它是通过自顶向下的递归遍历与内存分配实现的。对于庞大的嵌套字典、深层复杂树结构或含有数万个子节点的数据对象,深拷贝会消耗大量的 CPU 运算与堆内存空间,因此在高性能场景中需要审慎使用。
五、深拷贝的核心防线:循环引用与 Memo 字典机制
在现实业务模型中,对象之间常常会发生相互引用,甚至出现自身引用(即自环结构),例如链表、双向图或配置树:
a = []
a.append(a)  # 此时列表 a 内部包含了对自身的引用
如果是普通的递归算法,处理这种自环结构时必然会陷入无限递归,最终触发 Python 的 RecursionError: maximum recursion depth exceeded。然而,copy.deepcopy() 却能轻松且正确地处理这种结构。其内部奥秘就在于维护了一个备忘录字典(memo)。
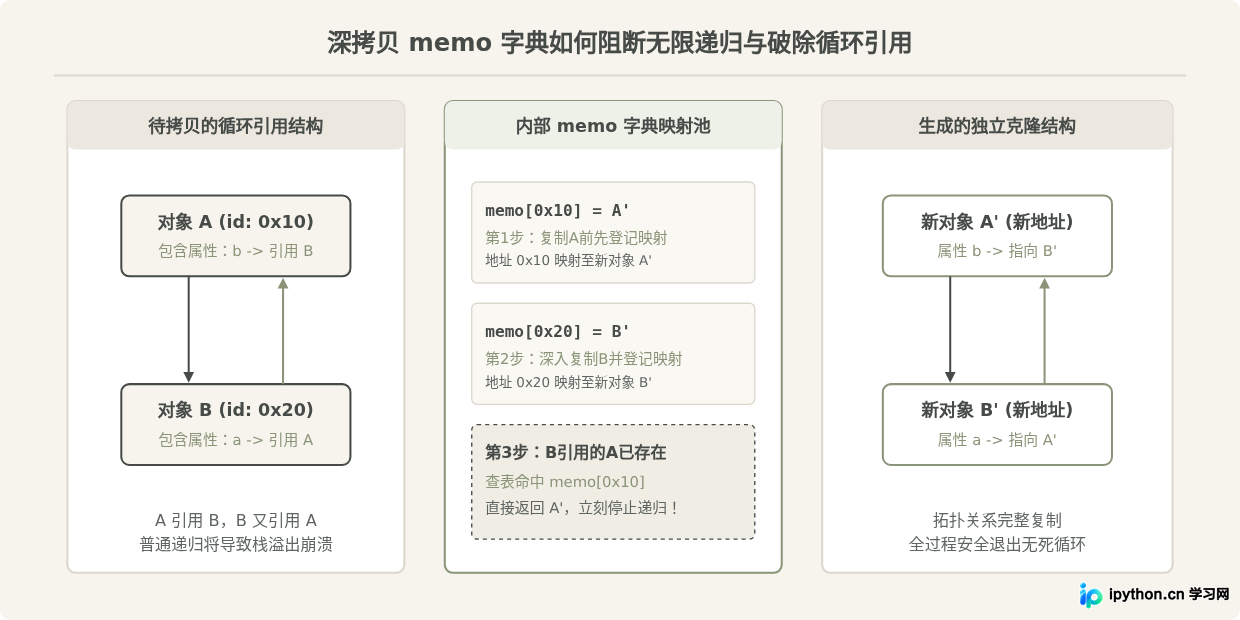
当执行 copy.deepcopy(obj) 时,其内部函数签名其实是 deepcopy(x, memo=None)。在整个复制过程中:
- 每当准备克隆一个对象前,深拷贝首先检查该对象的
id(obj)是否已存在于memo字典中。 - 如果已经存在,说明该对象在之前的层级已被复制过,直接返回字典中已缓存的新副本
memo[id(obj)]。 - 如果不存在,深拷贝先创建新对象的骨架,将其写入
memo[id(obj)] = new_obj,随后才递归填充子属性。
通过这套机制,Python 不仅优雅避免了循环引用导致的栈溢出崩溃,还确保了原始对象图中如果多个指针指向同一个子对象,在深拷贝后生成的新对象图中同样精确保持这一指针汇聚关系,而不会产生多份多余的冗余拷贝。
六、不可变对象的特殊机制与常见认识误区
在讨论拷贝概念时,许多开发者容易形成一个思维定势:“只要执行了 copy() 或 deepcopy(),就必定会产生新的内存对象”。这一结论在 Python 的不可变对象(Immutable Types)上是不成立的。
Python 对于整数(int)、浮点数(float)、字符串(str)以及纯不可变元素的元组(tuple)进行了专门的内存复用优化。因为不可变对象一旦创建就无法修改,在内存中共享这些对象是绝对线程安全且不会引起数据污染的,因此进行拷贝完全没有必要浪费内存去开辟新空间。
import copy

# 1. 字符串与整数的浅拷贝与深拷贝
text = "hello"
text_shallow = copy.copy(text)
text_deep = copy.deepcopy(text)

print(text_shallow is text)  # 输出: True (直接复用原对象)
print(text_deep is text)     # 输出: True (依然直接复用原对象)

# 2. 纯不可变元组的拷贝行为
t1 = (1, 2, 3)
t1_copy = copy.copy(t1)
t1_deep = copy.deepcopy(t1)

print(t1_copy is t1)         # 输出: True
print(t1_deep is t1)         # 输出: True

# 3. 包含可变子对象的特殊元组
t2 = (1, [2, 3])
t2_copy = copy.copy(t2)
t2_deep = copy.deepcopy(t2)

print(t2_copy is t2)         # 输出: True (浅拷贝认为元组本身不可变,直接返回原引用)
print(t2_deep is t2)         # 输出: False (深拷贝探测到内含可变列表,强制重新生成全新元组)
print(t2_deep[1] is t2[1]) # 输出: False (内层可变列表也生成全新独立副本)元组自身的不可变性仅仅约束其第一层容器保存的“内存指针”不可替换。如果元组内部某个指针指向的是一个可变列表,该列表的内容依然可以被原地改变(例如 t2[1].append(4))。在这种情况下,copy.deepcopy() 会识别出潜在的变更风险,从而打破常规优化,新建一个包含新列表引用的独立元组。
七、全维度特性对比与技术选型指南
为了在实际架构与业务开发中做出合理的性能与安全权衡,我们可以从各个关键维度综合归纳三者的差异:
| 对比维度 | 直接赋值(=) | 浅拷贝(copy / 切片) | 深拷贝(deepcopy) |
|---|---|---|---|
| 实现语法 | b = a |
copy.copy(a) / a[:] / list(a) |
copy.deepcopy(a) |
| 外层容器对象 | 完全共享(同一内存地址) | 开辟新独立容器(新地址) | 开辟新独立容器(新地址) |
| 内层嵌套可变对象 | 完全共享引用 | 完全共享引用(穿透影响) | 递归创建独立全新副本 |
| 不可变类型优化 | 仅绑定变量标签 | 直接返回原对象引用 | 纯不可变直接复用,含可变则新建 |
| 循环引用支持 | 无需处理(同对象) | 无需处理(仅复用一层) | 内置 memo 机制安全破除自环 |
| 时间与内存开销 | 极低,均为 O(1) |
较低,仅随外层容器长度线性增加 | 较高,与整个对象图的所有节点深度相关 |
| 典型适用场景 | 别名传递、函数传参、共享状态 | 一维扁平数据防修改、分段截取、排序展示 | 多层嵌套配置克隆、回滚快照、隔离测试数据 |
面对具体的开发任务,可以参考以下决策路径来选用合适的复制机制:
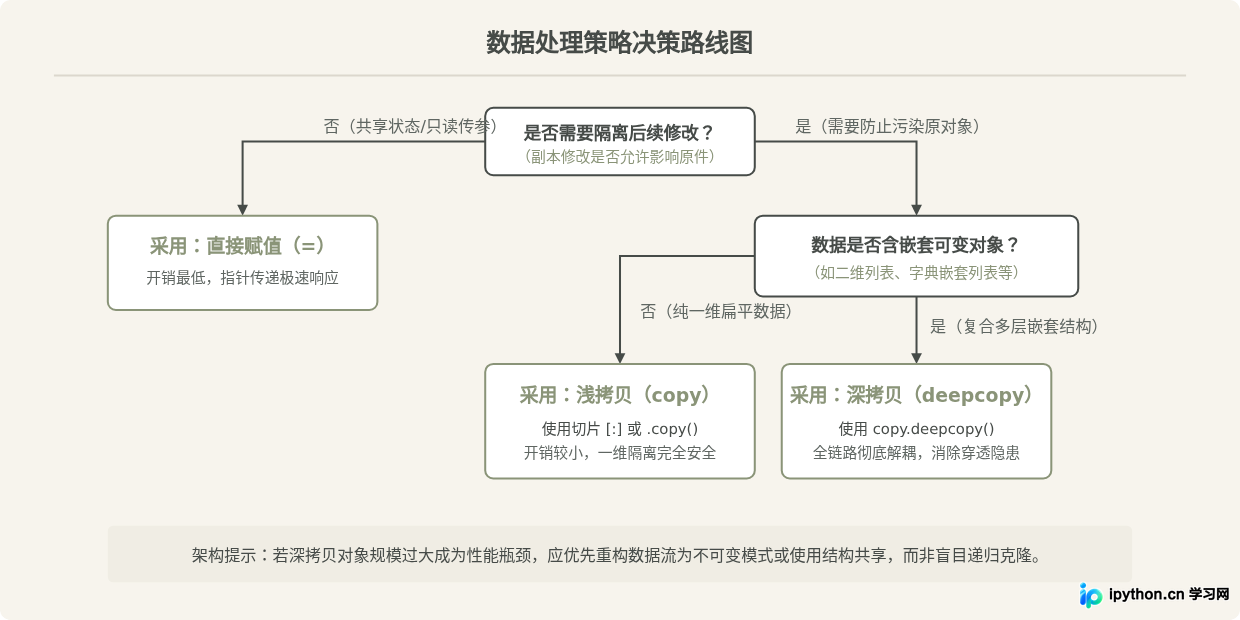
总结而言,赋值是建立对象引用的捷径;浅拷贝是针对扁平一维集合的高效解耦工具;而深拷贝则是面对复杂、多层嵌套可变结构时,确保数据彻底隔离、杜绝副作用修改的终极保障手段。在编写 Python 代码时,根据数据的实际维度与变动边界按需选择,方能在程序的执行性能与数据安全性之间取得最佳平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















