


Python批量处理文件时怎么获取文件名变量
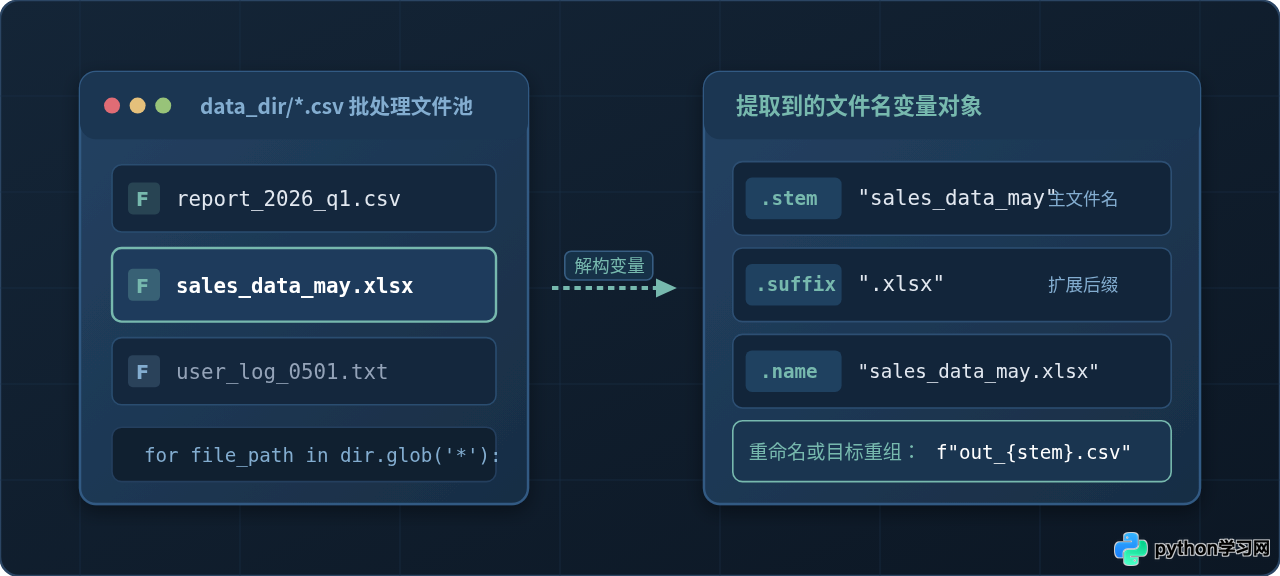
在Python批量处理文件时,获取文件名变量的核心在于将文件路径解构成主文件名(stem)、后缀(suffix)与完整名称(name)。本文通过pathlib与os.path详细讲解获取文件名变量的标准方法、批量遍历模式与实际案例。
pathlib.Path 对象:在遍历目录时,通过路径对象的 .stem 属性直接获取不带后缀的纯主文件名,通过 .suffix 获取文件扩展名,通过 .name 获取带扩展名的完整文件名。若需兼容 Python 较早版本或习惯使用 os 模块,则可以通过 os.path.basename() 提取出文件名字符串,再借助 os.path.splitext() 拆解为纯文件名与扩展名。本文将完整梳理路径各层级变量的解构逻辑、两种核心模块的实现代码以及批量重命名和动态输出等常见业务场景。
一、解构文件路径:文件名变量包含哪些组成部分?
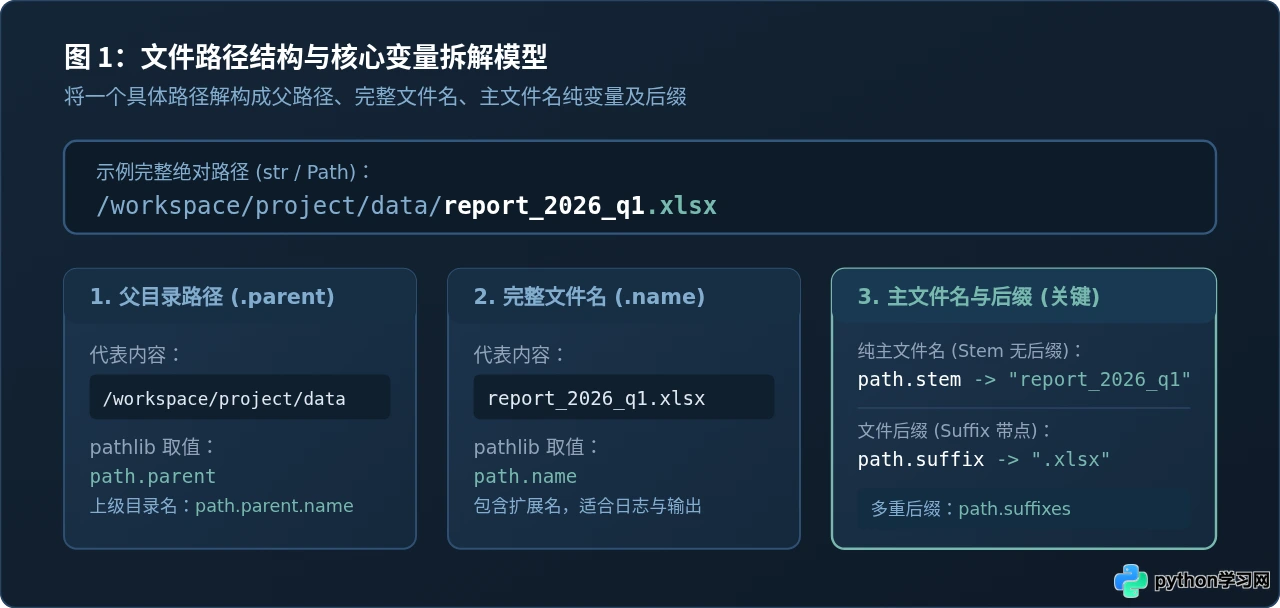
假设你正在处理存放在目录 data/sales/ 下的上百个报表文件,其中一个文件名为 report_2026_q1.xlsx。在批量操作过程中,“获取文件名”往往不是拿一个简单的整段字符串,而是需要根据业务诉求把路径拆解为不同粒度的变量:
- 完整文件名(Filename / Name):包含后缀的完整文件名,例如
report_2026_q1.xlsx。常用于日志记录或作为字典键。 - 主文件名(Stem / Base Name):剔除了扩展名的纯名称,例如
report_2026_q1。这是最常用的变量,用于作为新生成文件的基础名称、拼接日期或提取编号。 - 文件后缀(Suffix / Extension):带有点号的扩展名,例如
.xlsx。常用于格式判定或转换为新格式时替换。 - 父目录名称(Parent Name):当前文件所在的文件夹名称,例如
sales。多层级归档时常用于归类标记。
二、推荐方案:使用 pathlib 获取文件名变量
Python 3.4 引入的 pathlib 模块采用面向对象的方式封装了文件与目录操作,是目前 Python 官方最为推荐的标准做法。它不仅消除了不同操作系统间斜杠(/ 与 \)的差异,还提供了直接对应的属性来读取文件名变量,无需手动进行字符串截取。
1. 单个路径对象的核心属性
通过 Path(file_path) 构造的路径对象,提供了以下几个关键只读属性:
from pathlib import Path

# 构造一个示例路径对象
file_path = Path("raw_data/monthly_report_2026.csv")

# 提取关键变量
full_name = file_path.name        # 完整文件名: "monthly_report_2026.csv"
stem_name = file_path.stem        # 纯主文件名: "monthly_report_2026"
file_ext  = file_path.suffix      # 文件扩展名: ".csv"
parent_dir = file_path.parent.name # 所在目录名: "raw_data"

print(f"完整文件名: {full_name}")
print(f"纯主文件名: {stem_name}")
print(f"扩展名:     {file_ext}")
print(f"父级文件夹: {parent_dir}")纯主文件名: monthly_report_2026
扩展名: .csv
父级文件夹: raw_data
2. 批量扫描目录并提取变量
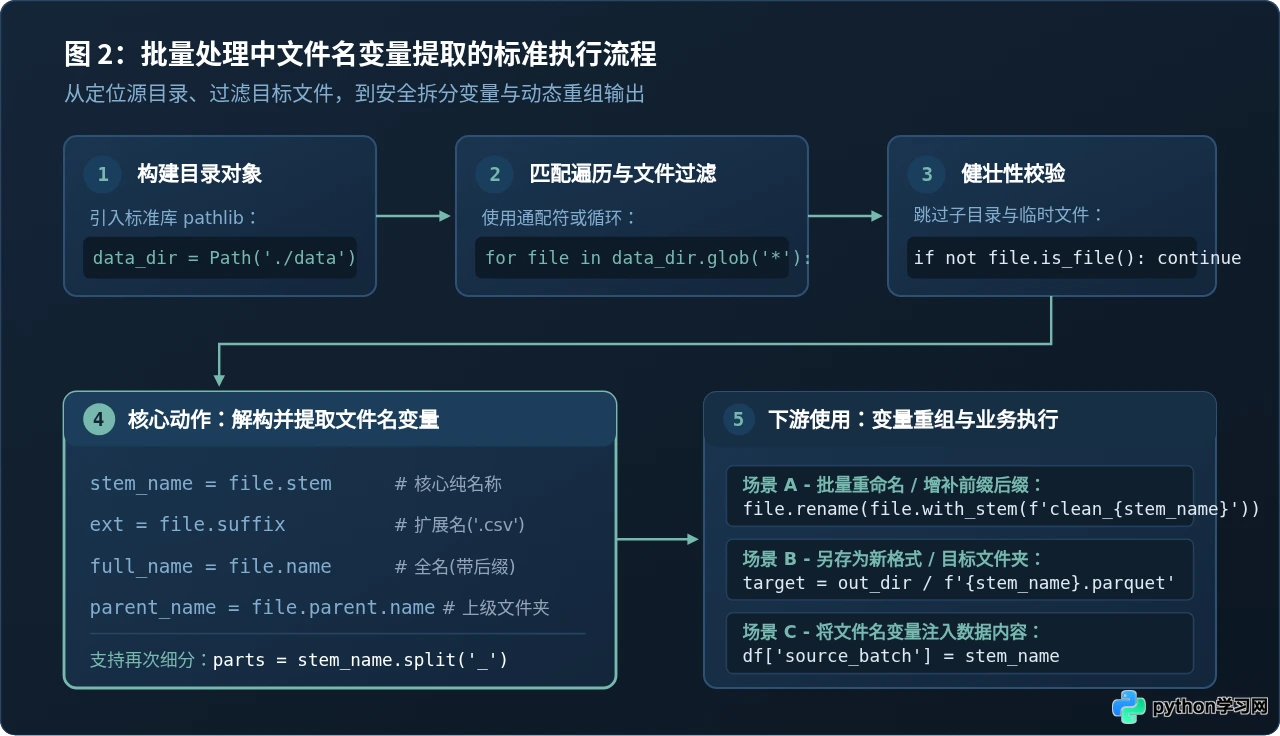
在批量处理时,通常结合 Path.glob() 或 Path.iterdir() 进行遍历。使用 glob('*.csv') 可以直接筛选指定类型的文件,避免将子文件夹或无关文件误当作目标文件。
from pathlib import Path

# 定义待处理的目录
source_dir = Path("./sales_records")

# 确保目录存在
if source_dir.exists() and source_dir.is_dir():
    # 批量匹配所有 .csv 文件
    for file_path in source_dir.glob("*.csv"):
        # 稳妥过滤:确认当前项确实是文件而非同名文件夹
        if not file_path.is_file():
            continue

        # 提取文件名变量
        stem = file_path.stem      # 如 "store_01_day"
        ext  = file_path.suffix    # 如 ".csv"

        # 使用变量进行业务操作(例如打印当前处理进度)
print(f"正在读取任务 [{stem}], 后缀为 {ext}")正在读取任务 [store_02_day], 后缀为 .csv
正在读取任务 [store_03_day], 后缀为 .csv
三、兼容方案:使用 os 与 os.path 拆分文件名变量
在维护早期代码库或与不支持 Path 对象的旧版第三方库交互时,可以使用 Python 传统的 os 和 os.path 模块。该方法以纯字符串的方式传递路径,通过多次调用分割函数来得到所需变量。
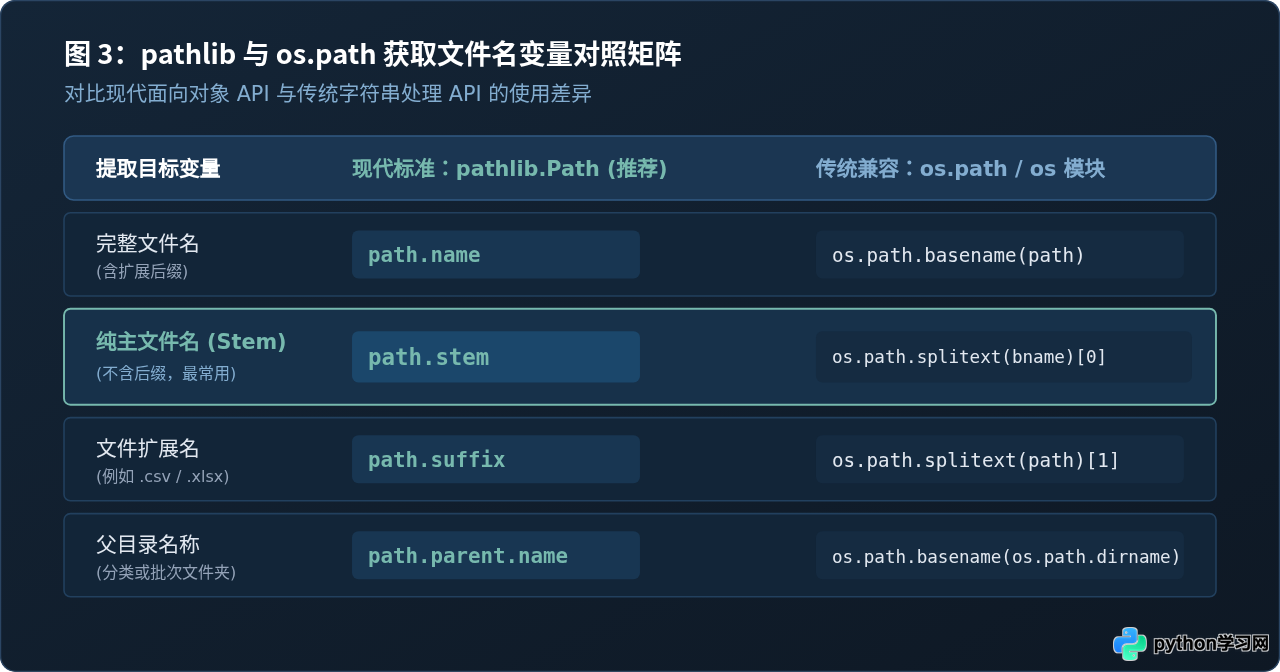
1. os.path.basename 与 os.path.splitext 的配合
在 os.path 中,获取纯主文件名需要两步:先使用 os.path.basename() 去掉路径前缀,再使用 os.path.splitext() 将扩展名剥离。
import os

# 假设我们在遍历目录
folder_path = "./sales_records"

for item in os.listdir(folder_path):
    # 拼接出完整相对路径
    full_path = os.path.join(folder_path, item)

    # 过滤掉子文件夹
    if os.path.isfile(full_path):
        # 1. 获取完整文件名
        full_name = os.path.basename(full_path)

        # 2. 拆分主文件名与后缀
        stem, ext = os.path.splitext(full_name)

print(f"文件名: {full_name} -> 主变量: {stem}, 后缀: {ext}")文件名: order_b.txt -> 主变量: order_b, 后缀: .txt
2. 多级子目录场景:os.walk 遍历
当文件分散在多个层级的子文件夹中时,os.walk() 会生成三元组 (root, dirs, files)。其中的 files 列表本身就已经是纯文件名字符串(包含扩展名),此时只需调用 os.path.splitext() 即可直接得到主文件名变量。
import os

root_dir = "./nested_data"

for current_dir, _, filenames in os.walk(root_dir):
    for filename in filenames:
        stem, ext = os.path.splitext(filename)
        # 结合当前目录名称作为分类标签
        category = os.path.basename(current_dir)
        print(f"分类: {category} | 文件变量: {stem}")
四、实战应用:文件名变量在批量处理中的三种常见用法
获取到文件名变量后,通常会在以下三类场景中作为核心参数驱动后续操作:
场景 1:进一步解析主文件名中的业务参数
如果文件名遵循结构化命名规则(例如 202605_beijing_electronics.csv),可以使用 str.split() 将 stem 进一步分解为具体的业务字段:
from pathlib import Path

for file_path in Path("./reports").glob("*.csv"):
    stem = file_path.stem
    parts = stem.split("_")

    if len(parts) == 3:
        date_str, city, category = parts
        print(f"日期: {date_str}, 城市: {city}, 品类: {category}")
场景 2:批量重命名与增补前后缀
在 Python 3.9 及以上版本中,pathlib.Path 提供了 with_stem() 方法,可以极其优雅地基于现有主文件名生成新的重命名目标,而无需手动拼接扩展名:
from pathlib import Path

dir_path = Path("./images")

for img in dir_path.glob("*.png"):
    if not img.name.startswith("backup_"):
        # 利用 with_stem 构造加前缀的新文件名对象
        new_file = img.with_stem(f"backup_{img.stem}")
        img.rename(new_file)
        print(f"重命名: {img.name} -> {new_file.name}")
场景 3:读取源文件并在输出目录保存同名衍生文件
在数据转换(例如将 CSV 批量转换为 Parquet)或处理图片(生成缩略图)时,通常需要保留原有的主文件名变量,仅更换存储目录与扩展名:
from pathlib import Path

input_dir = Path("./raw_csv")
output_dir = Path("./processed_parquet")
output_dir.mkdir(parents=True, exist_ok=True)

for csv_file in input_dir.glob("*.csv"):
    # 动态构建目标路径:保持主文件名相同,仅将后缀替换为 .parquet
    target_path = (output_dir / csv_file.stem).with_suffix(".parquet")

    # 模拟业务写入
    # df.to_parquet(target_path)
print(f"源文件: {csv_file.name} -> 目标文件: {target_path}")源文件: data_part2.csv -> 目标文件: processed_parquet/data_part2.parquet
五、注意事项与易错点
对于像
archive_2026.tar.gz 这样的双重后缀文件,path.stem 默认只会剥离最后一个点号后面的内容,返回的是 archive_2026.tar;而 path.suffix 返回的是 .gz。如果你的意图是取得最原始的主名称 archive_2026,可以使用 path.suffixes 检查所有后缀列表,或通过 path.name[:-len("".join(path.suffixes))] 进行彻底剥离。
在 macOS 上批量扫描时经常会遇到
.DS_Store,在 Windows 上开启 Excel 时会生成 ~$sample.xlsx 临时文件。在获取变量前,务必增加判断:if file_path.name.startswith((".", "~$")): continue,防止脏数据干扰批量逻辑。
尽量避免直接使用字符串切片或
split('/') 来提取文件名。Windows 系统的分隔符为反斜杠 \,手动切片极易在跨平台运行时引发 IndexError 或产生错误的变量值。始终优先使用 pathlib.Path 或 os.path 提供的标准接口。
六、方案选型与总结速查
在日常开发与数据批处理脚本中,可以根据目录层级与处理目标快速选择对应写法:
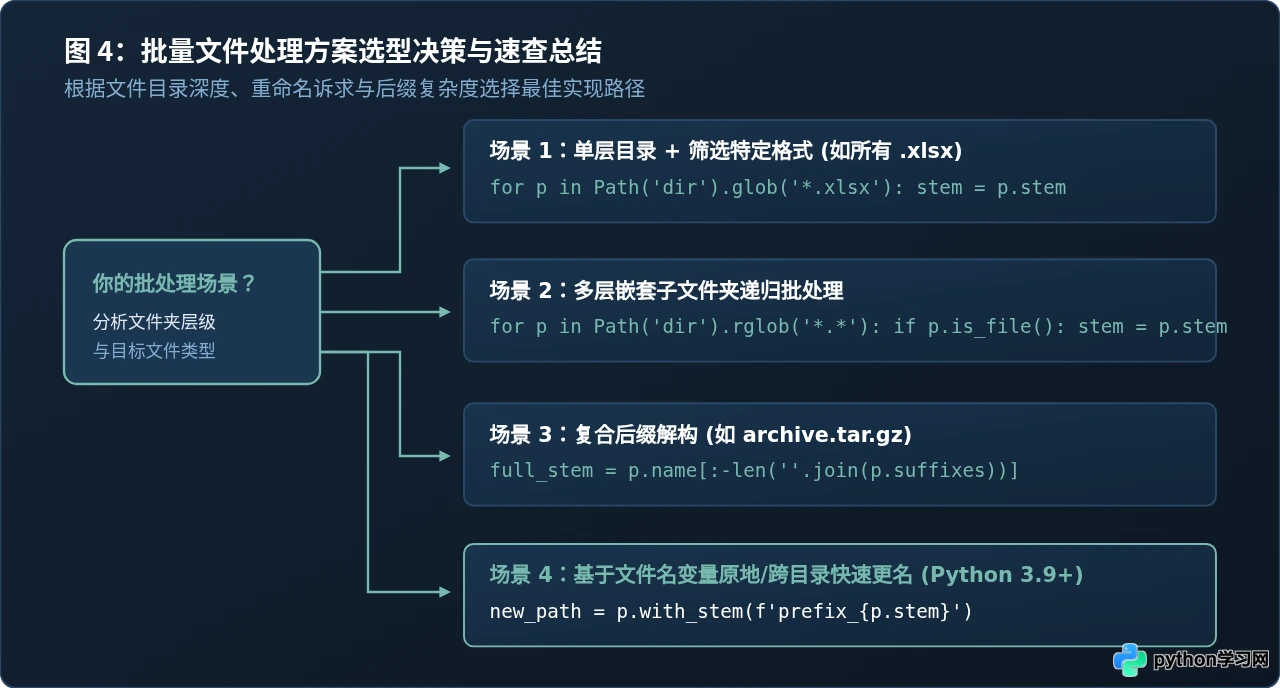
| 需求场景 | 推荐代码实现 | 核心提取变量 |
|---|---|---|
| 单层目录按后缀筛选 | for p in Path(d).glob("*.csv"): |
p.stem (纯名), p.suffix (后缀) |
| 多层子目录递归批处理 | for p in Path(d).rglob("*.txt"): |
p.stem, p.parent.name (分类) |
| 批量更名 / 增减前后缀 | p.rename(p.with_stem(f"new_{p.stem}")) |
p.with_stem(...) |
| 传统代码库兼容 | stem, ext = os.path.splitext(os.path.basename(f)) |
stem, ext |
掌握了 pathlib.Path 的 .stem、.suffix 与 .name 属性后,无论面对何种复杂度的批量文件处理任务,都能清晰、安全地捕获并重组文件名变量,写出更具可读性与健壮性的自动化脚本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















