


Python递归实现阶乘之和及最大递归深度处理
深入讲解使用Python递归计算阶乘之和的具体实现、时间复杂度从O(n²)到O(n)的单递归状态回溯优化,剖析CPython调用栈与RecursionError触发机理,并提供sys.setrecursionlimit深度调优与迭代工程改造方案。
RecursionError,掌握合理调整 sys.setrecursionlimit 的安全边界与改用迭代循环的工程落地策略。
一、阶乘之和的递归数学拆解与朴素实现
阶乘之和要求对前 \(n\) 个正整数的阶乘依次相加。若读者初次尝试用递归实现,最直觉的做法往往是将问题拆解为两个独立的递归动作:一个递归函数负责计算单个整数的阶乘 \(k!\),另一个递归函数负责将 \(n!\) 与前 \(n-1\) 项的和累加在一起。
我们先看一下这种朴素双重递归的代码实现:
def factorial(n: int) -> int:
    """计算单个正整数的阶乘 n!"""
    if n <= 1:
        return 1
    return n * factorial(n - 1)

def factorial_sum_naive(n: int) -> int:
    """计算 1! + 2! + ... + n! 的朴素递归实现"""
    if n < 1:
        raise ValueError("输入参数 n 必须为大于等于 1 的正整数")
    if n == 1:
        return factorial(1)
    # 递归调用自身计算前 n-1 项之和,再加上当前项 n!
    return factorial_sum_naive(n - 1) + factorial(n)

# 示例验证:计算 1! + 2! + 3! + 4! = 1 + 2 + 6 + 24 = 33
if __name__ == "__main__":
    result = factorial_sum_naive(4)
    print(f"factorial_sum_naive(4) 的计算结果为: {result}")
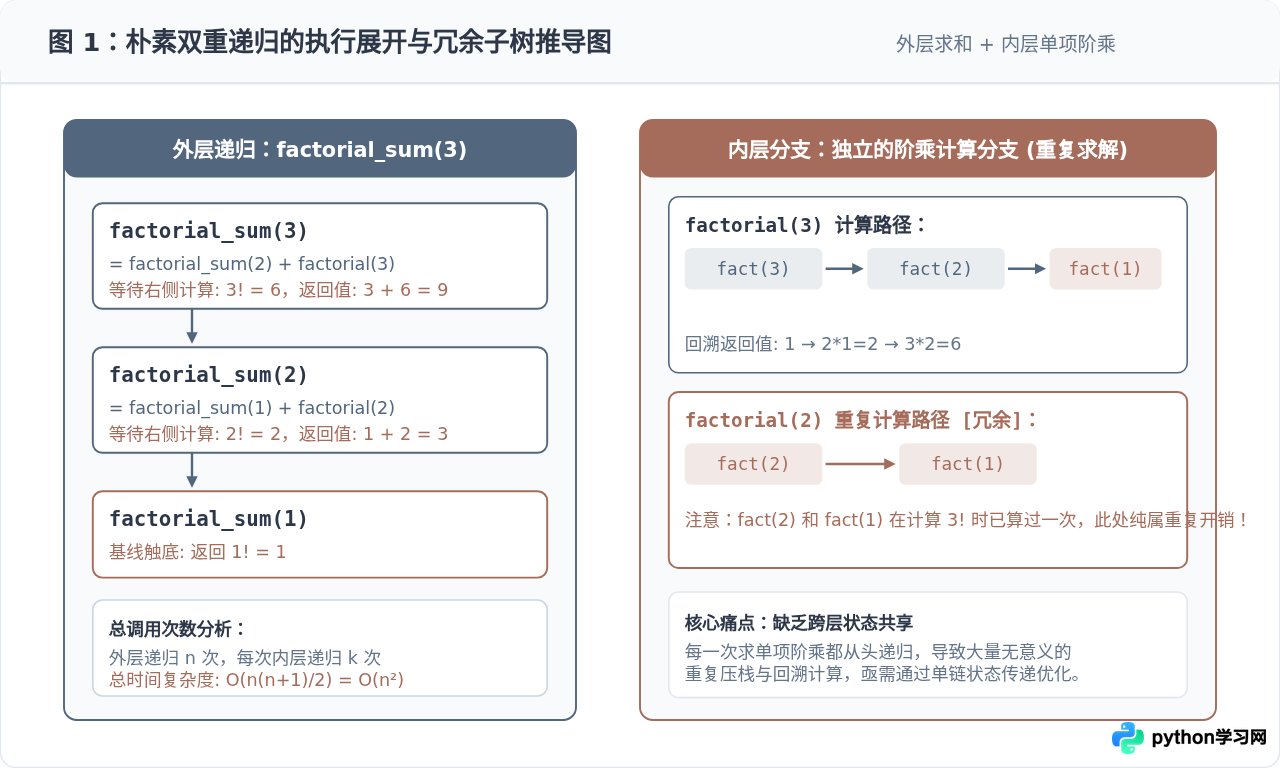
上面的代码逻辑虽然清晰,但在算法性能上存在严重缺陷。当 factorial_sum_naive(3) 执行时,它在计算自身时展开调用了 factorial(3);而在向下递归调用 factorial_sum_naive(2) 时,又会再次独立调用 factorial(2)。
由于 factorial(3) 在求值过程中已经完整计算过 2! 和 1!,外层函数并未将这些中间结果保存或向下传递,导致每次求单项阶乘都在从头重复递归。对于规模为 \(n\) 的计算,内层总调用次数为 \(n(n+1)/2\),时间复杂度达到 \(O(n^2)\)。
二、单递归状态合并优化:O(n) 时间与单链栈结构
观察数学递推关系可以发现:第 \(k\) 项的阶乘与第 \(k-1\) 项具有直接倍数关系,即 \(k! = k imes (k-1)!\);而累加和满足 \(S_k = S_{k-1} + k!\)。
这意味着只要在递归从最深层基线条件(\(n=1\))开始往上回溯时,同时向上层返回两个数值——当前项的阶乘值与当前已累积的总和,上一层就可以直接使用下层的阶乘乘以当前 \(n\) 得到当前阶乘,并将其加到下层的累计和中。通过返回一个包含双元素的元组 (curr_fact, curr_sum),即可在单次递归链中搞定两项计算。
from typing import Tuple

def _factorial_sum_recursive(n: int) -> Tuple[int, int]:
    """
    单递归核心:返回元组 (curr_fact, curr_sum)
    curr_fact: 当前项 n! 的值
    curr_sum:  1! + 2! + ... + n! 的累计和
    """
    if n <= 1:
        # 基线条件:1! = 1,累计和也是 1
        return 1, 1

    # 向下单链递推,直至触底
    sub_fact, sub_sum = _factorial_sum_recursive(n - 1)

    # 回溯阶段利用子结果进行常数级计算
    curr_fact = n * sub_fact
    curr_sum = sub_sum + curr_fact
    return curr_fact, curr_sum

def factorial_sum(n: int) -> int:
    """对外的阶乘之和入口函数,包含参数校验"""
    if not isinstance(n, int) or n < 1:
        raise ValueError("输入参数 n 必须是正整数 (n >= 1)")
    _, total_sum = _factorial_sum_recursive(n)
    return total_sum

# 示例验证:
if __name__ == "__main__":
    n = 5
    # 1! + 2! + 3! + 4! + 5! = 1 + 2 + 6 + 24 + 120 = 153
    print(f"factorial_sum({n}) = {factorial_sum(n)}")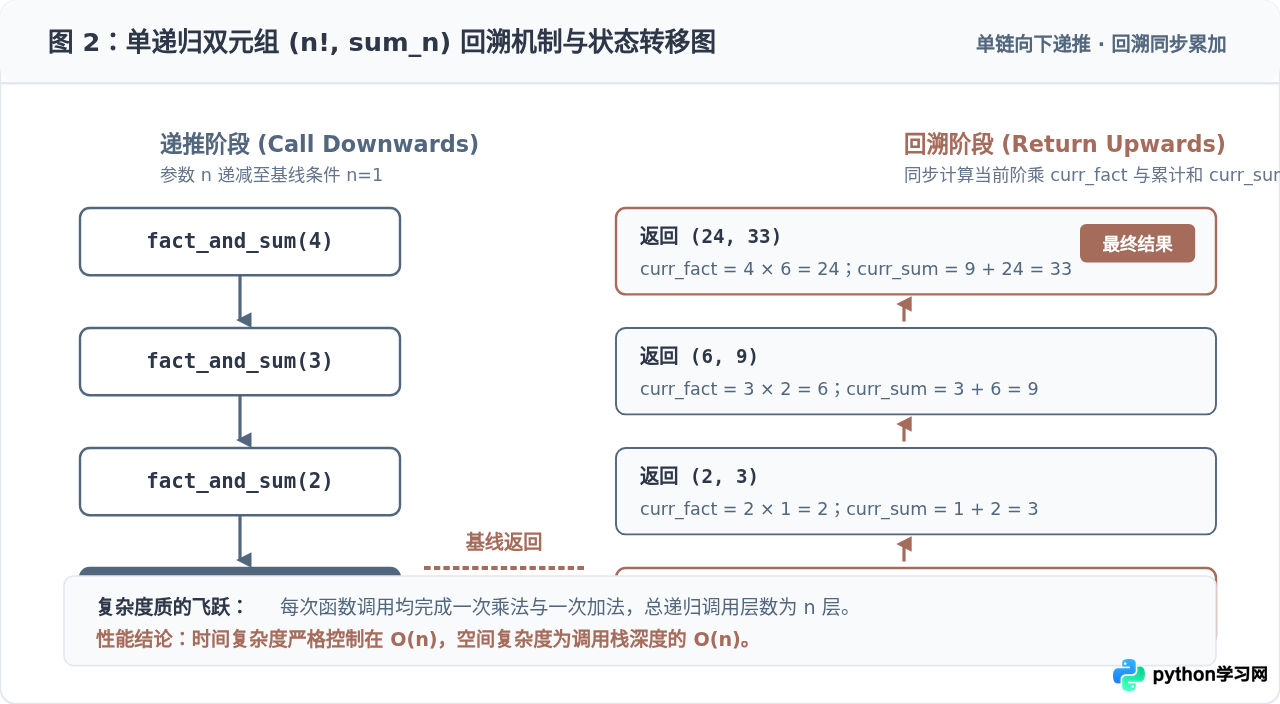
如上图所示,当调用 factorial_sum(4) 时,函数只产生一条深度为 4 的单向递归调用链,基线返回 (1, 1) 后自底向上逐层收拢计算。整个过程中函数只被调用了 \(n\) 次,乘法和加法各执行了 \(n-1\) 次,时间复杂度从 \(O(n^2)\) 骤降至严格的 \(O(n)\),并且代码优雅直观。
三、Python 最大递归深度限制与 RecursionError 剖析
当我们把 \(n\) 的规模逐步扩大测试时,会遇到 Python 语言层面的一个硬性门槛。在标准终端中执行以下代码:
# 尝试计算规模为 1500 的阶乘之和
try:
    print(factorial_sum(1500))
except RecursionError as e:
    print(f"捕获到运行时错误: {e}")
控制台会立即抛出异常:
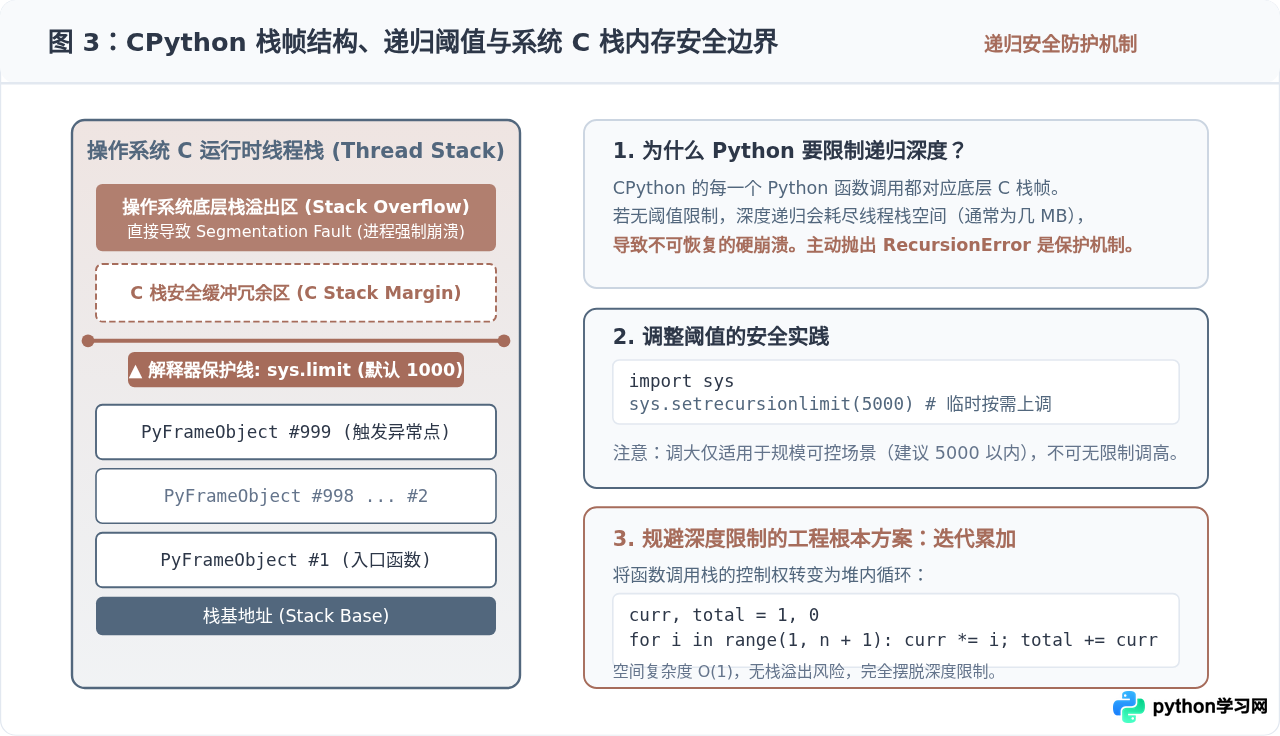
捕获到运行时错误: maximum recursion depth exceeded while calling a Python object为什么计算小数字非常顺畅的递归,在 \(n=1500\) 甚至更小的时候就会报错?这是 CPython 解释器的安全防御机制:
- 底层 C 栈机制:CPython 解释器本身是由 C 语言编写的。Python 代码中每一次执行函数调用,底层都会分配一个
PyFrameObject结构体,并且需要消耗操作系统分配给当前线程的 C 语言运行时调用栈空间(通常 Linux/macOS 默认线程栈大小约为 8MB)。 - 防止硬崩溃(Segmentation Fault):如果 Python 允许无限递归下去,操作系统的 C 栈内存会被彻底耗尽,进而触发系统级的段错误直接杀死 Python 进程。这会导致任何
try...except机制都无法执行,进程瞬间消失。 - 阈值守护:为了避免不可控的崩溃,CPython 在虚拟机中设置了一个递归深度计数器。可以通过
sys.getrecursionlimit()查询,其默认值通常为 1000。只要当前调用栈深度达到该限制,解释器便主动截断执行并抛出规范的RecursionError。
四、最大递归深度的处理策略与工程实现
针对递归深度的限制,在实际开发中有两种处理路线:一种是“临时提高阈值”,适用于必须保持递归结构且深度仍在可控区间内的场景;另一种是“算法迭代重构”,这也是生产环境处理大规模数据的标准解法。
策略 1:使用 sys.setrecursionlimit 按需安全扩容
Python 官方标准库 sys 提供了 setrecursionlimit(limit) 函数,允许开发者根据任务需求主动调高递归上限。
在调整该限制时,推荐采用“按需提升并在执行后恢复”的模式,避免将过高的递归限制泄露给后续全局代码:
import sys
from contextlib import contextmanager

@contextmanager
def temporary_recursion_limit(new_limit: int):
    """上下文管理器:临时提升递归深度限制,执行完毕后自动复原"""
    old_limit = sys.getrecursionlimit()
    sys.setrecursionlimit(max(old_limit, new_limit))
    try:
        yield
    finally:
        sys.setrecursionlimit(old_limit)

# 安全执行调用示例
n = 2000
with temporary_recursion_limit(3000):
    result = factorial_sum(n)
    print(f"成功在临时扩容至 3000 的环境下计算 factorial_sum({n})")
    print(f"结果的十进制位数长度为: {len(str(result))} 位")

print(f"退出上下文后,全局递归深度自动还原为: {sys.getrecursionlimit()}")sys.setrecursionlimit(1000000)),解释器在抛出 RecursionError 之前就会因为 C 栈溢出直接发生段错误退出。在常规操作系统上,建议的安全设置上限通常在 3000 ~ 10000 以内。
策略 2:改用迭代循环(工程终极解法)
递归的本质是利用系统调用栈来暂存每一步的状态。而在阶乘之和问题中,我们完全可以在堆内存中用简单的局部变量来暂存中间状态,将递归消除为平面的 for 循环。
def factorial_sum_iterative(n: int) -> int:
    """
    迭代实现阶乘之和
    时间复杂度: O(n)
    空间复杂度: O(1) 辅助空间 (无调用栈压力)
    """
    if not isinstance(n, int) or n < 1:
        raise ValueError("输入参数 n 必须是正整数 (n >= 1)")

    current_factorial = 1
    total_sum = 0

    for i in range(1, n + 1):
        current_factorial *= i
        total_sum += current_factorial

    return total_sum

# 即使计算 n = 10000,迭代法也只需零点几秒,完全不会触碰任何递归栈限制
if __name__ == "__main__":
    big_n = 5000
    res = factorial_sum_iterative(big_n)
    print(f"迭代计算 n={big_n} 顺利完成,结果总位数: {len(str(res))} 位")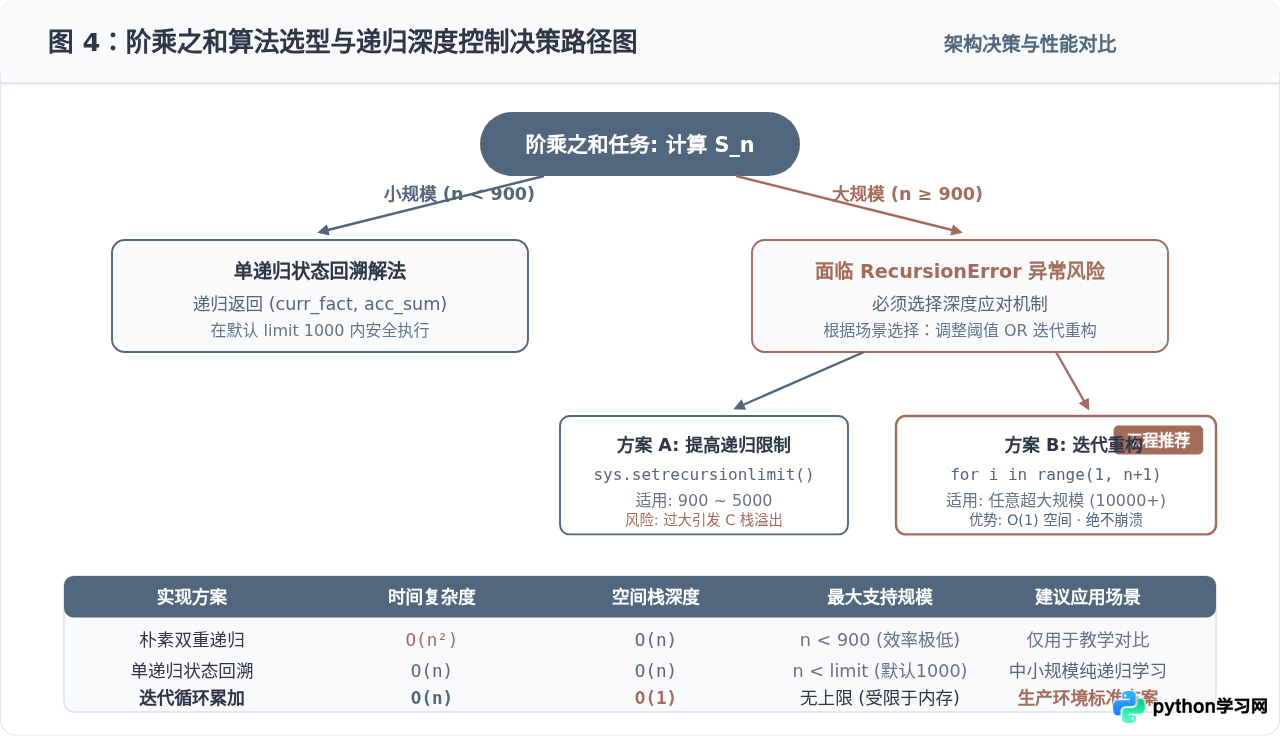
五、边界条件与大整数精度考量
在编写与测试阶乘之和程序时,有两个值得特别关注的具体细节:
- 零与负数的语义定义:在纯数学约定中,\(0! = 1\)。如果业务需求将求和区间定义为 \(k=0\) 到 \(n\),则结果比 \(1\) 到 \(n\) 多 1。在编写函数时,务必对 \(n \le 0\) 做明确的校验抛错或根据业务规范定义返回值,避免因负数输入导致无限递归直至栈崩溃。
- Python 的大整数自动高精度特性:与其他语言(如 C/C++ 或 Java 中
long在 \(21!\) 就会发生 64 位整型溢出)不同,Python 3 的int类型具有无限精度,仅受物理内存大小限制。例如 \(1000!\) 产生的数字有 2568 位十进制数,计算本身是精确无误的;但此时主要性能开销会从函数调用逐渐转移到超大整数乘法运算上,这是在大规模数值计算时需要留意的性能特征。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















