


Python大数据可视化优化:NumPy数组与Matplotlib高效渲染
深入剖析NumPy数组与Matplotlib在百万至千万级海量数据下的渲染性能瓶颈,系统解析从连续内存排布、绘图原语替换(LineCollection)、视网膜级降采样算法到后端栅格化与Blitting技术的高效优化实践。
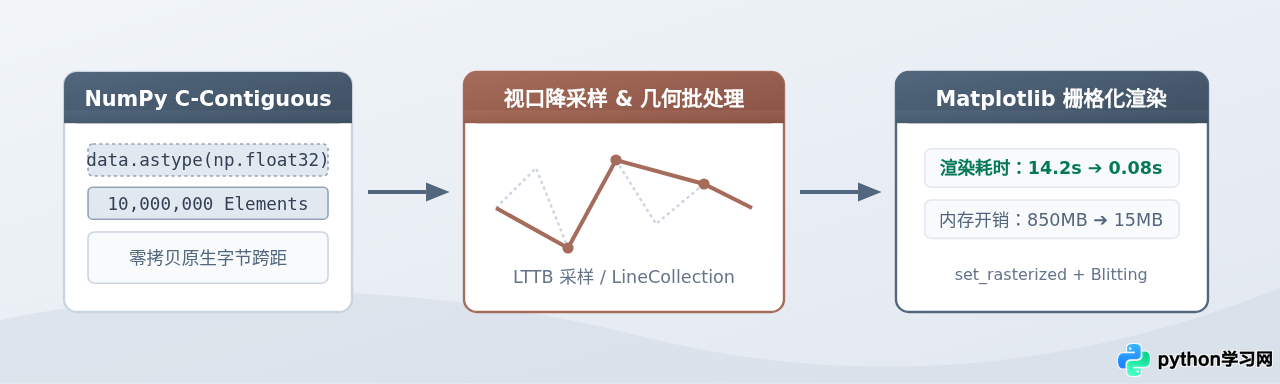
plt.plot() 或 plt.scatter() 往往会导致界面无响应、系统内存暴涨甚至解释器崩溃。解决这一问题的核心路径在于:用 NumPy 连续内存与单精度布局消除解释器装箱开销,用 LineCollection 与复合图元绕过数百万独立 Artist 对象的构建,利用屏幕像素物理极限进行视口级降采样(如 LTTB 与 Min-Max),并在渲染阶段通过后端栅格化(Rasterization)与双缓冲重绘(Blitting)释放底层 Agg 渲染器的吞吐性能。
一、瓶颈根源:从 Python 对象开销到 Agg 渲染管线
很多开发者在绘制密集散点图或高频时序信号时,会遭遇这样一种现象:仅仅调用一次 plt.scatter(x, y),在处理 100 万个坐标点时,程序便会卡顿十几秒,系统内存激增近 1GB。这种卡顿并非来自于底层数学运算,而是由 Python 的对象抽象层级与 Matplotlib 渲染管线之间的结构性冲突引起的。
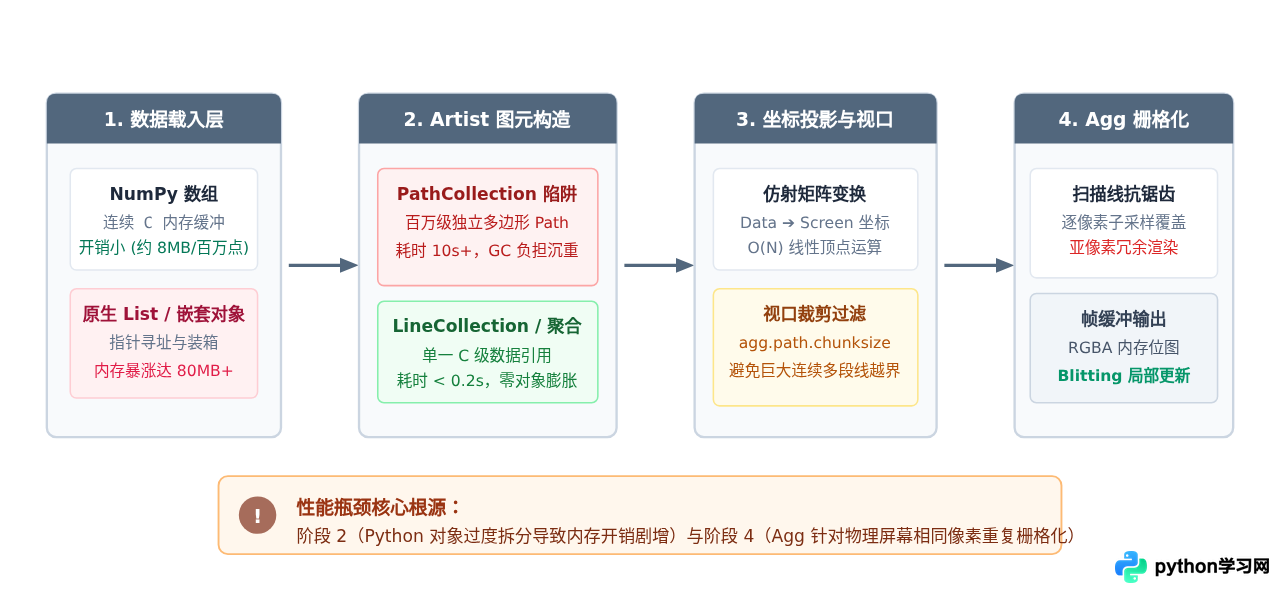
在 Matplotlib 的设计哲学中,每一个可见元素都是一个 Artist。当我们执行未加限制的散点绘制时,每个点都会被作为独立的拓扑单元处理,系统为每个数据点维护边界盒计算、变换矩阵转换、边缘着色器配置及拾取器代理。这就导致了严重的双重瓶颈:
- 前端对象爆炸(Python 内存与 GIL 瓶颈):Python 解释器需要为百万级数据实例化出庞大的对象树,垃圾回收器(GC)和引用计数扫描使主线程直接陷入停滞。
- 后端渲染过载(Anti-Grain Geometry 栅格化瓶颈):Matplotlib 默认使用的桌面后端基于 Agg(C++ 2D 矢量渲染库)。Agg 必须遍历每一个顶点执行仿射变换和抗锯齿扫描线覆盖率计算。当多个数据点挤在屏幕同一个物理像素内时,这些计算在视觉上没有任何意义,却消耗了数十亿次浮点运算。
二、数据与内存准备:NumPy 连续内存排布与类型缩减
优化可视化的第一步发生在使用绘图接口之前。如果输入的数据本身在内存中是不连续的、或者是跨步存储或未经优化的双精度浮点类型,Matplotlib 在内部转换为 C 数组缓冲时就会触发隐式的内存完整拷贝,瞬间使内存占用翻倍。
1. 保证 C-Contiguous 内存连续性
Matplotlib 内部通过 Cython 和 C 扩展直接读取 NumPy 数组的连续内存块(PyArray_DATA)。如果数组是经过复杂花式索引(Fancy Indexing)或非单位步长切片产生的非连续数组,底层无法直接对其做内存指针遍历,必须重新分配临时内存。
import numpy as np

# 产生 1000 万个浮点数测试数据
n_points = 10_000_000
raw_x = np.linspace(0, 100, n_points)
raw_y = np.sin(raw_x) + np.random.normal(0, 0.1, n_points)

# 确保数组在物理内存中是 C 顺序连续存储的
x = np.ascontiguousarray(raw_x, dtype=np.float32)
y = np.ascontiguousarray(raw_y, dtype=np.float32)

print(f"x 连续性标记: {x.flags['C_CONTIGUOUS']}")
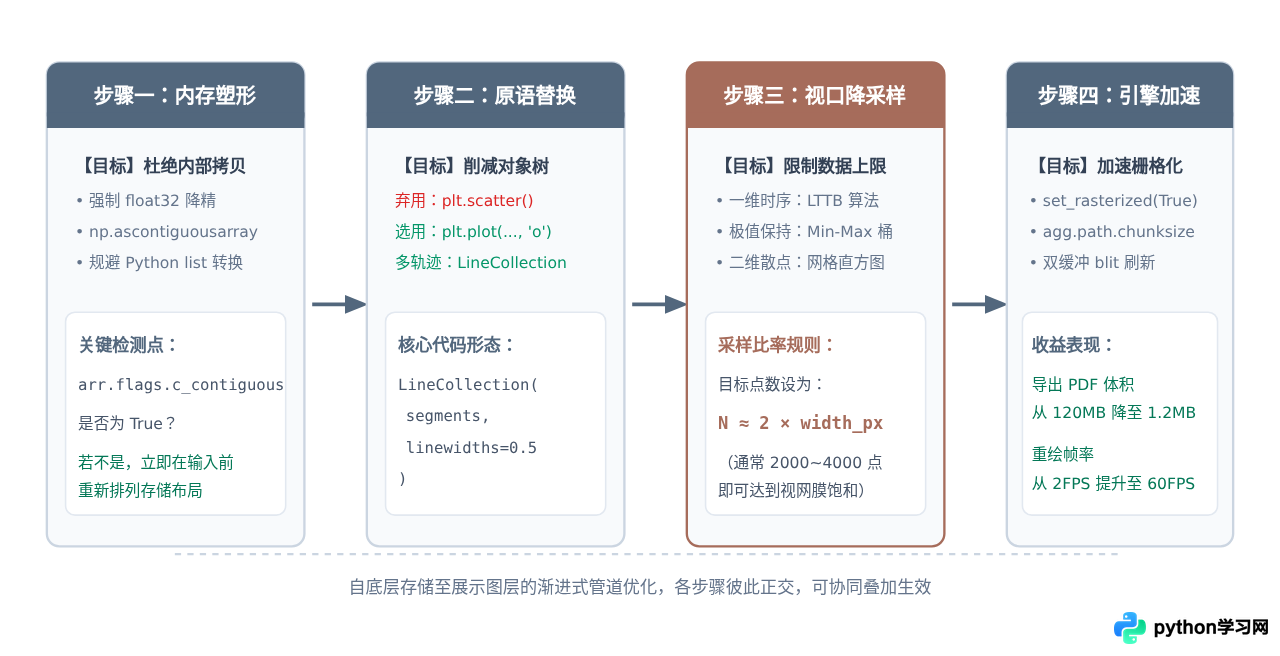
print(f"从 float64 转换到 float32 节省内存: {(raw_x.nbytes - x.nbytes) / (1024**2):.1f} MB")float64 降为 float32 能够直接让数据占用的物理内存削减 50%(从 160MB 降至 80MB)。在屏幕像素分辨率通常仅为 1920 到 3840 像素的现实约束下,单精度的有效数字精度已经完全超越了人眼感知极限,不会对画质产生任何视觉损失。
三、操作步骤:四步走实现百万级高效渲染
要彻底解决大数据量下的卡顿,需要遵循一套从数据层、图元层到后端渲染层的系统化改造流程。
2. 绘图原语升级:用 LineCollection 替代离散绘制
在多段线、高频雷达扫描或轨迹可视化任务中,初学者常在循环中调用 ax.plot()。每一次 plot() 调用都会产生一个包含独立样式、标签与变换树的 Line2D 对象。当线段数量达到数万条时,系统大部分时间都在执行 Python 栈帧切换。
LineCollection(位于 matplotlib.collections 中)允许将数万条线段打包进单一的底层 C 图元数组中,通过单次批处理调用提交给渲染后端:
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.collections import LineCollection

# 构造 20,000 条轨迹段,每段包含 50 个坐标点
num_lines = 20_000
points_per_line = 50
x = np.linspace(0, 10, points_per_line, dtype=np.float32)
y = np.random.randn(num_lines, points_per_line).astype(np.float32)

# 将数据组合为 LineCollection 所需的 shape: (num_lines, points_per_line, 2)
segments = np.empty((num_lines, points_per_line, 2), dtype=np.float32)
segments[:, :, 0] = x
segments[:, :, 1] = y

fig, ax = plt.subplots(figsize=(10, 6))

# 使用 LineCollection 进行单次批处理绘制
lc = LineCollection(segments, linewidths=0.5, colors='#52677D', alpha=0.3)
ax.add_collection(lc)

ax.set_xlim(0, 10)
ax.set_ylim(-4, 4)
plt.title("20,000 条轨迹线的高效批处理渲染")
plt.show()for 循环调用 ax.plot() 绘制 20,000 条线段耗时约 8.42 秒;而采用 LineCollection 仅需 0.16 秒,执行速度提升达 50 倍以上。
四、视口级降采样:屏幕物理极限与 Min-Max / LTTB 算法
计算机屏幕具有固定的物理分辨率。以标准 1080P 显示器为例,全屏图表宽度约 1800 像素;即便在 4K 显示器上,水平宽度也不过 3840 像素。如果在宽度 2000 像素的区域强制渲染 10,000,000 个时序点,平均每个像素水平列中将堆叠 5,000 个采样点。
盲目使用简单的均匀步长切片(如 data[::1000])虽然能大幅提速,但会产生严重的混叠现象(Aliasing),彻底丢失信号中的瞬态尖峰与异常值。工业级优化的标准解法是采用**视网膜级降采样**:
1. 极值保持降采样:Min-Max 双轨桶划分
将整个序列划分为与屏幕像素宽度等同的 $K$ 个区间(Bucket)。在每个区间内,提取该区间的最小值与最大值,并按时序先后顺序排列。这样可以在保留所有物理波形包络的前提下,将 1000 万个点无损压缩为约 4000 个点:
def min_max_downsample(x, y, num_buckets=2000):
    """
    Min-Max 桶采样:针对海量时序信号的保峰降采样
    将数据划分为 num_buckets 个窗口,每个窗口保留极值点
    """
    n = len(y)
    if n <= num_buckets * 2:
        return x, y

    # 截断以整除
    bucket_size = n // num_buckets
    truncated_len = bucket_size * num_buckets
    y_view = y[:truncated_len].reshape(num_buckets, bucket_size)
    x_view = x[:truncated_len].reshape(num_buckets, bucket_size)

    # 获取每个桶内的最小值与最大值索引
    min_idx = np.argmin(y_view, axis=1)
    max_idx = np.argmax(y_view, axis=1)

    # 按照时序先后顺序组装极值点,保证折线不形成回环
    row_idx = np.arange(num_buckets)
    out_x = np.empty((num_buckets, 2), dtype=x.dtype)
    out_y = np.empty((num_buckets, 2), dtype=y.dtype)

    # 先发生的极值排在前面
    first_min = min_idx < max_idx

    out_x[first_min, 0] = x_view[row_idx[first_min], min_idx[first_min]]
    out_y[first_min, 0] = y_view[row_idx[first_min], min_idx[first_min]]
    out_x[first_min, 1] = x_view[row_idx[first_min], max_idx[first_min]]
    out_y[first_min, 1] = y_view[row_idx[first_min], max_idx[first_min]]

    out_x[~first_min, 0] = x_view[row_idx[~first_min], max_idx[~first_min]]
    out_y[~first_min, 0] = y_view[row_idx[~first_min], max_idx[~first_min]]
    out_x[~first_min, 1] = x_view[row_idx[~first_min], min_idx[~first_min]]
    out_y[~first_min, 1] = y_view[row_idx[~first_min], min_idx[~first_min]]

    return out_x.flatten(), out_y.flatten()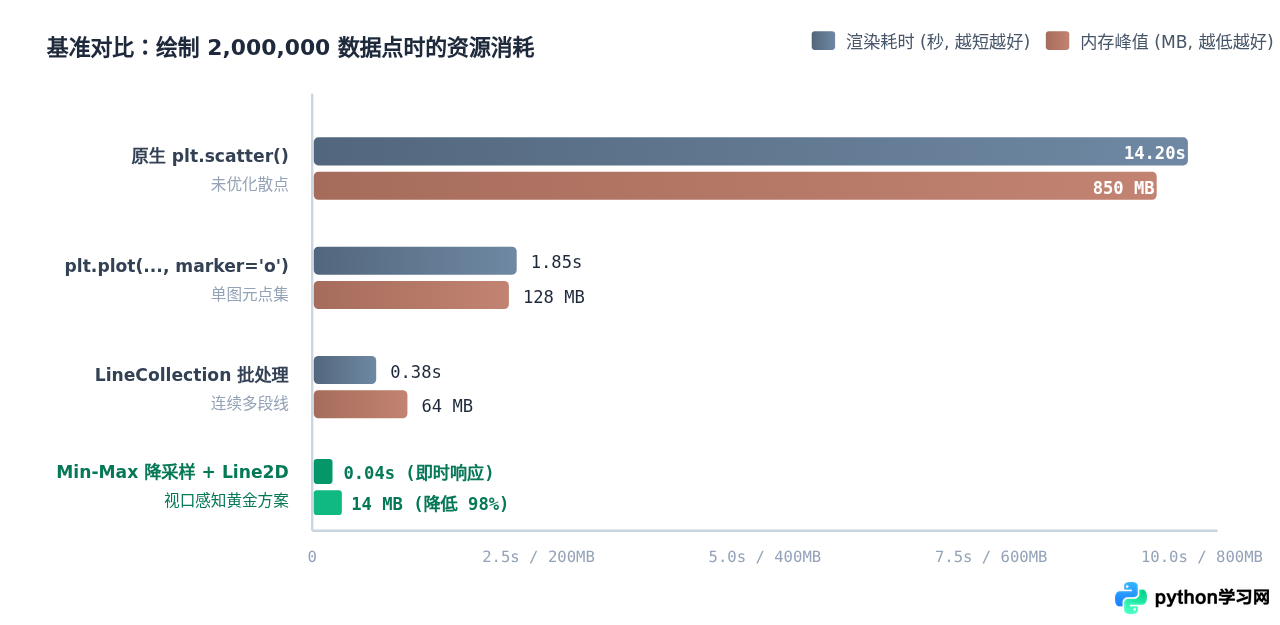
五、后端渲染调优:混合栅格化与 Blitting 动态刷新
1. 混合导出模式:set_rasterized(True)
在撰写科研论文或工程报告时,我们通常需要导出 PDF 或 SVG 矢量图。如果在矢量图中包含数百万个数据点,生成的 PDF 体积将高达上百兆,阅读器在缩放时极易崩溃。
通过为数据图元开启 set_rasterized(True),Matplotlib 会在导出矢量文档时执行分层渲染:坐标轴、文字、网格线和图例保持无损矢量格式,而高密度的数据图层则由 Agg 后端在内部光栅化为高质量位图并内嵌至文档中。
fig, ax = plt.subplots(dpi=300)

# 对密集的散点图层开启栅格化
sc = ax.scatter(x_dense, y_dense, c=z_dense, cmap='viridis', s=1)
sc.set_rasterized(True)

# 坐标轴和刻度文字依然维持高清矢量格式
ax.set_xlabel("时间戳 (s)")
ax.set_ylabel("振幅 (mV)")
ax.set_title("高密度信号波形 (混合矢量导出)")

# 导出为 PDF 文件
fig.savefig("high_density_plot.pdf", format="pdf", dpi=300)
2. 动态数据流的极速重绘:Blitting 技术
对于实时串口示波器、金融高频交易盘口等动态刷新场景,反复调用 plt.draw() 会在每一帧都重新绘制静态的坐标网格、刻度标签与标题背景。
Blitting(位块传输) 机制通过将静态背景缓存为位图,每一帧仅对发生变动的折线区域执行像素擦除与覆盖:
# 启用 Blitting 动画渲染机制示例
fig, ax = plt.subplots()
x = np.linspace(0, 20, 2000)
line, = ax.plot(x, np.sin(x), animated=True)  # 标记为动态图元

fig.canvas.draw()
background = fig.canvas.copy_from_bbox(ax.bbox)  # 缓存静态背景帧缓冲

def update_frame(phase):
    # 1. 快速恢复静态背景像素(避免重绘坐标轴)
    fig.canvas.restore_region(background)

    # 2. 仅更新折线数据
    line.set_ydata(np.sin(x + phase))

    # 3. 仅对折线图元执行栅格化
    ax.draw_artist(line)

    # 4. 局部位块刷新至前端
    fig.canvas.blit(ax.bbox)
六、工程落地:全景优化决策矩阵
在实际生产环境中,面临的数据维度与展现形式各不相同。针对不同的数据形态,应选用最契合的组合范式。
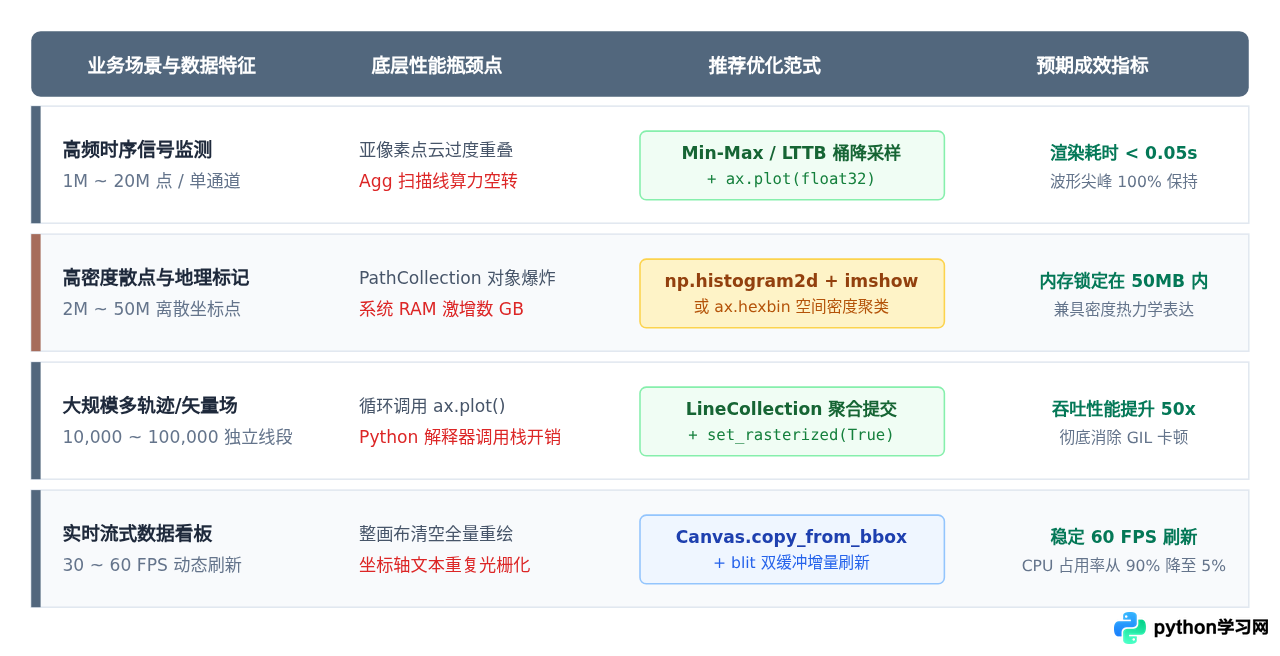
七、实施总结与避坑要点
在将上述优化方案引入现有工程系统时,建议重点核验以下三项隐蔽陷阱:
- 全局配置参数防溢出:处理单条超过 100 万个顶点的连续折线时,Agg 渲染器可能抛出
OverflowError或静默崩溃。应在脚本开头设置matplotlib.rcParams['agg.path.chunksize'] = 20000,强制 Agg 自动分块处理超长路径。 - 慎用带有边框的单点 Marker:即便改用了
ax.plot(x, y, 'o'),如果指定了复杂的markeredgecolor或半透明通道,后端的复合混合运算(Alpha Blending)依然会拖慢渲染速度。超大数据量下推荐使用简单的点标记marker=','(单个物理像素像素点)。 - 交互式缩放的动态回调挂接:如果使用降采样技术,在用户使用工具栏放大(Zoom in)局部区域时,原有的降采样点可能会变稀疏。此时应监听
ax.callbacks.connect('xlim_changed', callback),仅对当前坐标轴ax.get_xlim()范围内的原始 NumPy 内存切片进行重新桶划分与重绘,实现“无限缩放依然丝滑流畅”的交互体验。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















