


什么是Pythonic代码?新手常见冗长写法与简洁优化对比
深入解析什么是Pythonic代码,聚焦新手在循环、序列、字典操作和资源管理中常见的冗长写法,提供清晰直观的优雅优化方案与场景对比。
一、从命令式操作到表达意图:理解 Pythonic 的本质
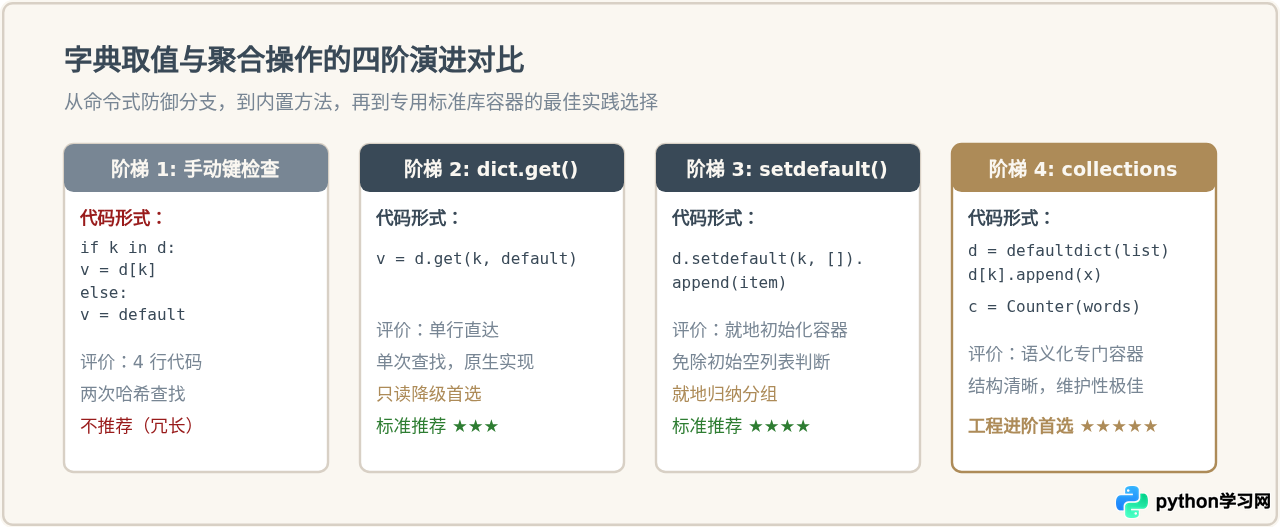
在许多传统编程语言中,开发者必须事无巨细地告诉计算机“如何一步步分配内存、维护下标、检查边界并执行赋值”。而在 Python 的设计哲学中,强调的是直接表达“你要什么”,即《Python 之禅》(The Zen of Python)所倡导的:优美胜于丑陋、明了胜于晦涩、简洁胜于复合。
一段代码是否具有 Pythonic 风格,并不取决于它是否用了晦涩难懂的奇巧淫技,而在于它是否用最符合 Python 习惯的原生原语解决问题。真正的 Pythonic 代码通常具备三个特征:首先是高可读性,读者无需在脑海中模拟循环计数器的增减;其次是充分复用内置容器与迭代器协议;最后是具备稳健的防御性机制,避免遗漏边界与资源泄漏。
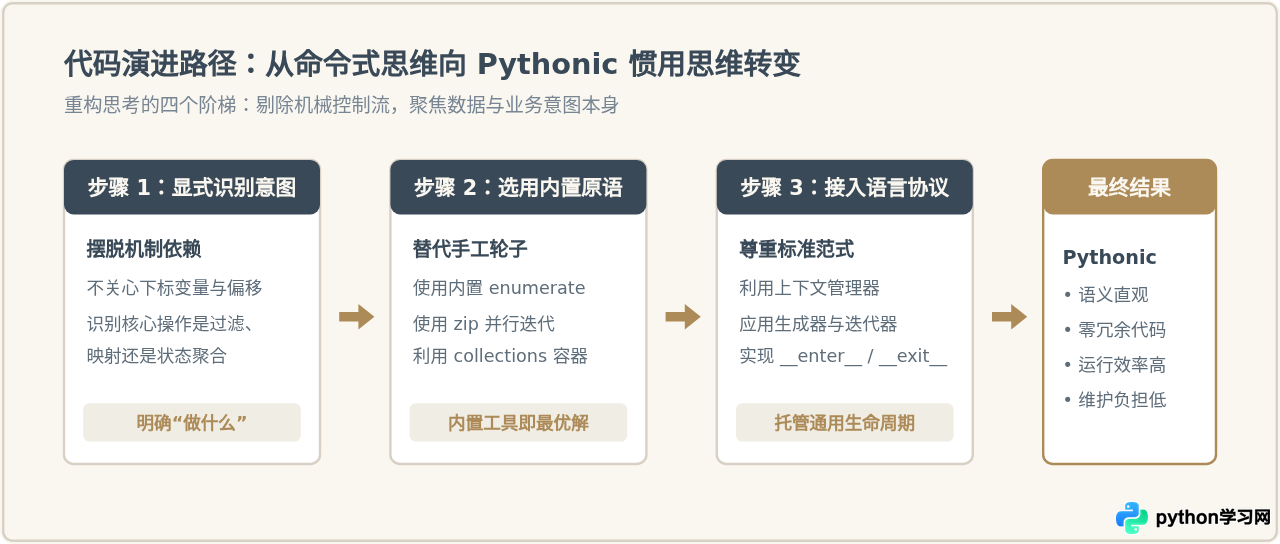
二、典型场景对比一:遍历序列与索引处理
初学 Python 时,最容易暴露“外来语言痕迹”的地方就是循环。许多初学者习惯先用 len(items) 获取长度,再用 range() 生成连续数字,最后通过下标 items[i] 访问元素。
# 带有浓厚 C/Java 风格的下标递增
fruits = ["apple", "banana", "cherry"]

for i in range(len(fruits)):
    item = fruits[i]
print(f"{i}: {item}")# 依靠迭代器协议同时解构序号与值
fruits = ["apple", "banana", "cherry"]
for i, item in enumerate(fruits):
print(f"{i}: {item}")
为什么 range(len(...)) 不受推荐?因为在 Python 中,列表本就是可迭代对象(Iterable),可以直接输出元素本身。当必须获取位置索引时,内置的 enumerate() 能够在每次迭代时生成 (index, item) 元组。这样做不仅代码少写了一行赋值,而且彻底杜绝了下标越界或误写变量名的可能。
类似的问题还出现在多列表的并行读取上。新手常通过同一个下标同步索引多个列表,而 Pythonic 的解法是直接使用 zip() 函数:
names = ["Alice", "Bob"]
scores = [85, 92]

for i in range(len(names)):
print(names[i], scores[i])names = ["Alice", "Bob"]
scores = [85, 92]
for name, score in zip(names, scores):
print(name, score)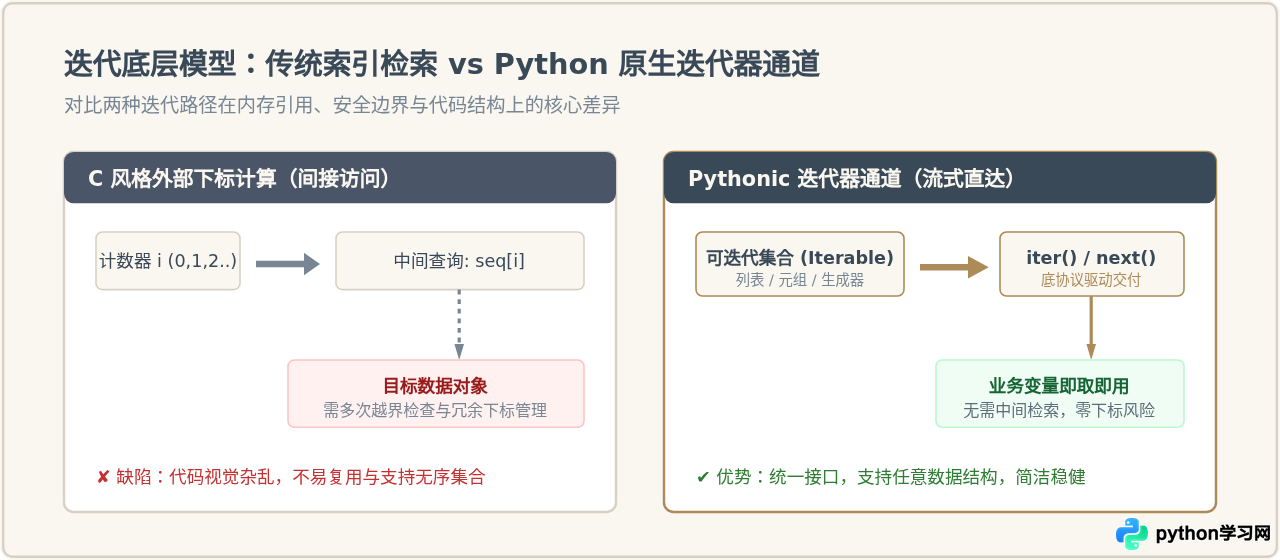
三、典型场景对比二:序列构建与列表推导式
数据过滤与映射是日常开发中最频繁的操作。初学者的直观做法是:先初始化一个空列表,接着写一个 for 循环,在循环体中写 if 判断,满足条件后调用 .append() 方法。
# 传统循环追加:需要多次改变列表状态
numbers = [1, 2, 3, 4, 5, 6]
evens_squared = []

for n in numbers:
    if n % 2 == 0:
evens_squared.append(n ** 2)# 列表推导式:单行声明数据映射意图
numbers = [1, 2, 3, 4, 5, 6]
evens_squared = [n ** 2 for n in numbers if n % 2 == 0]
列表推导式(List Comprehension)不仅大幅降低了代码行数,在 CPython 虚拟机层面也是经过高度优化的——它利用专用的 LIST_APPEND 字节码指令直接向内部数组填装数据,省去了每次在 Python 层面反复查找与调用 .append() 方法的开销,通常比纯循环快 20% 到 30%。
四、典型场景对比三:字典取值与数据分组
在处理字典时,新手极易写出连续的 if key in dict: 守卫逻辑,或者在做计数与分组时编写多层嵌套。Python 提供了丰富的字典内置原语与标准库工具,可以大幅简化这些分支。
user_profile = {"name": "Charlie"}

if "age" in user_profile:
    age = user_profile["age"]
else:
age = 18user_profile = {"name": "Charlie"}
# 一步完成存在性检查与降级缺省
age = user_profile.get("age", 18)
如果需要对具有相同分类的元素进行聚合分组,手动检查字典是否存在键并初始化空列表的做法同样十分笨拙。我们可以采用 setdefault() 或者 collections.defaultdict 进行降维表达。
五、典型场景对比四:资源管理与解构解包
文件操作与网络连接等 I/O 资源的处理,直接关系到程序的稳定性。新手通常使用 try...finally 结构手动调用 close(),这种写法虽然安全,但结构较为臃肿,且嵌套层级较深。
# 手动管理文件句柄
f = open("data.txt", "r", encoding="utf-8")
try:
    content = f.read()
finally:
f.close()# 上下文管理器托管生命周期与异常关闭
with open("data.txt", "r", encoding="utf-8") as f:
content = f.read()
利用 with 语句,Python 保证无论是正常执行完毕还是中途抛出未经捕获的异常,都能精确触发对象的 __exit__() 方法,安全释放系统文件描述符。
此外,在解构序列或交换变量时,新手也容易写出引入临时变量的传统逻辑:
# 传统三步变量交换
temp = a
a = b
b = temp

# 传统切片拆分
first = items[0]
rest = items[1:]# 原生多元赋值与打包解包
a, b = b, a
# 星号表达式直接提取头尾
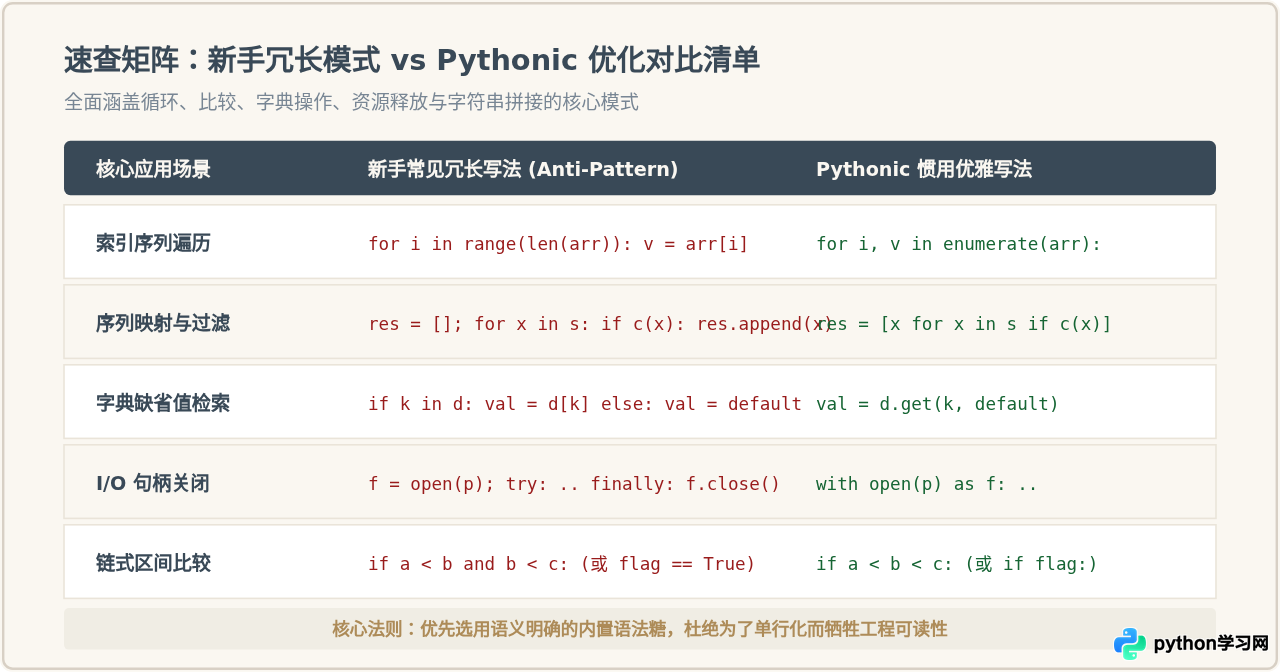
first, *rest = items六、新手常见冗长写法与 Pythonic 优化速查总结
为了便于在日常编写与代码审查中快速识别,下表梳理了新手阶段最普遍的高频冗长写法及对应的惯用优化手段:
七、编写建议:防止“过度优化”与走向极端
追求 Pythonic 风格并不等同于“不惜代价写成单行代码”(One-liner)。在实际工程开发中,必须注意以下两个重要边界:
- 避免写出三层以上的嵌套推导式:如果一个列表推导式包含了多重循环和复杂的逻辑条件,甚至需要换行并阅读数遍才能看懂,那么它已经违背了“可读性优先”的根本原则,此时拆解为标准
for循环更为稳妥。 - 警惕过度滥用 lambda 与 map/filter:当逻辑稍显复杂时,标准的列表推导式往往比多重嵌套的
map(lambda x: ...)具有更高的可读性和更直观的执行流。
enumerate、zip、推导式、with 语句以及标准库容器,你的 Python 代码将兼具清晰的表达力与出色的运行效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















