


零基础学Python要多久?真实学习周期与建议
针对完全没有编程经验的初学者,客观分析零基础学习Python的真实时间周期,拆解各阶段学习目标与检验标准,并提供避坑建议。
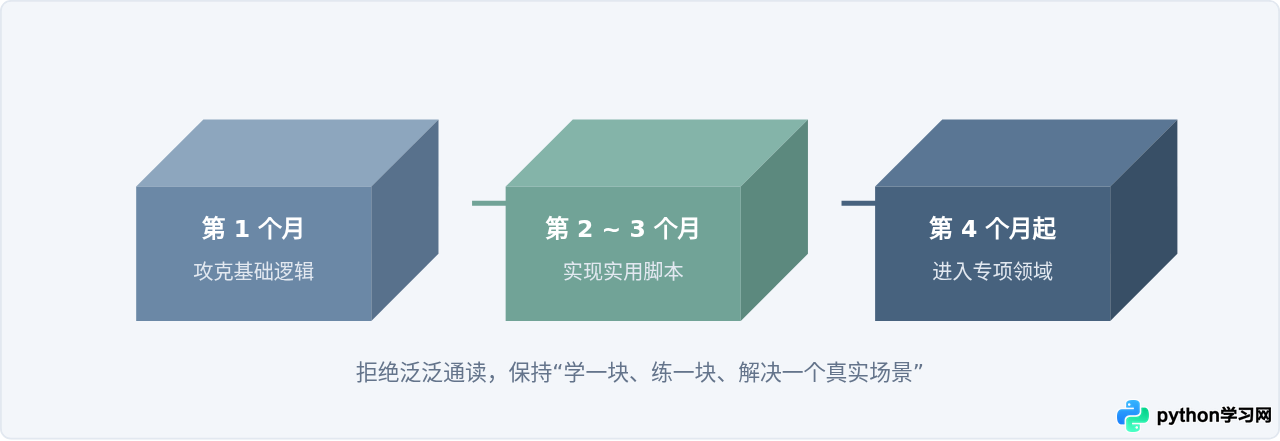
如果是零基础起步,以每天能够投入 1.5 到 2 小时有效学习时间为基准,掌握语法并在电脑上写出能解决实际问题的轻量脚本,通常需要 2 到 3 个月(累计约 100 到 150 小时)。如果学习目标是达到专业岗位初级开发者的要求,则通常需要 6 到 9 个月持续深入的专项训练与项目实战。本文将按照不同的学习目标拆解真实周期,并给出每个阶段的衡量标准与落地建议。
明确目标:你学 Python 到底是为了什么?
“学会 Python”是一个模糊的说法。不同人对“学会”的预期差距极大,所需的耗时自然大不相同。零基础学习者的需求一般可以划分为三个层级:
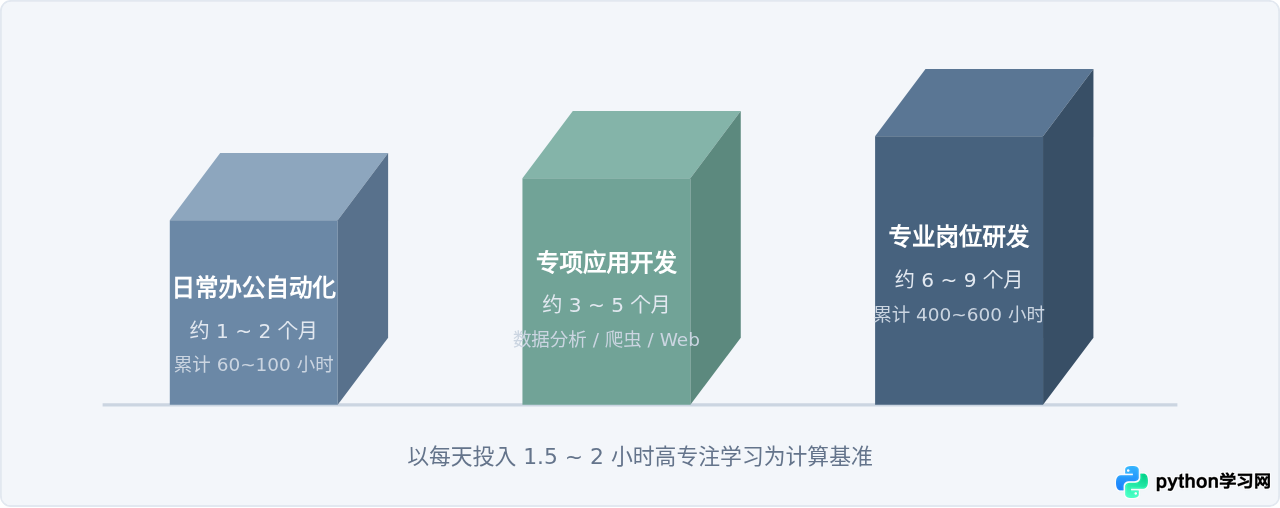
- 第一层:日常工具化应用(周期约 1~2 个月)。目标是编写小程序批量重命名文件、提取文本信息、自动合并多张 Excel 表格,满足职场自动化办公需求。
- 第二层:专项技术领域应用(周期约 3~5 个月)。目标是掌握数据统计分析、基础网络数据抓取(爬虫)或轻量内部管理网站的开发与维护。
- 第三层:达到初级研发就业水准(周期约 6~9 个月)。目标是作为软件工程师求职,需要掌握完整的工程规范、关系型数据库、异步处理、框架底层逻辑及协同开发能力。
各阶段具体要做什么与耗时拆解
明确了整体周期后,不能把这几个月当作一段均质的时间。合理的推进方式是将学习划分为三个递进阶段,每个阶段完成明确的知识积累与实操验证。
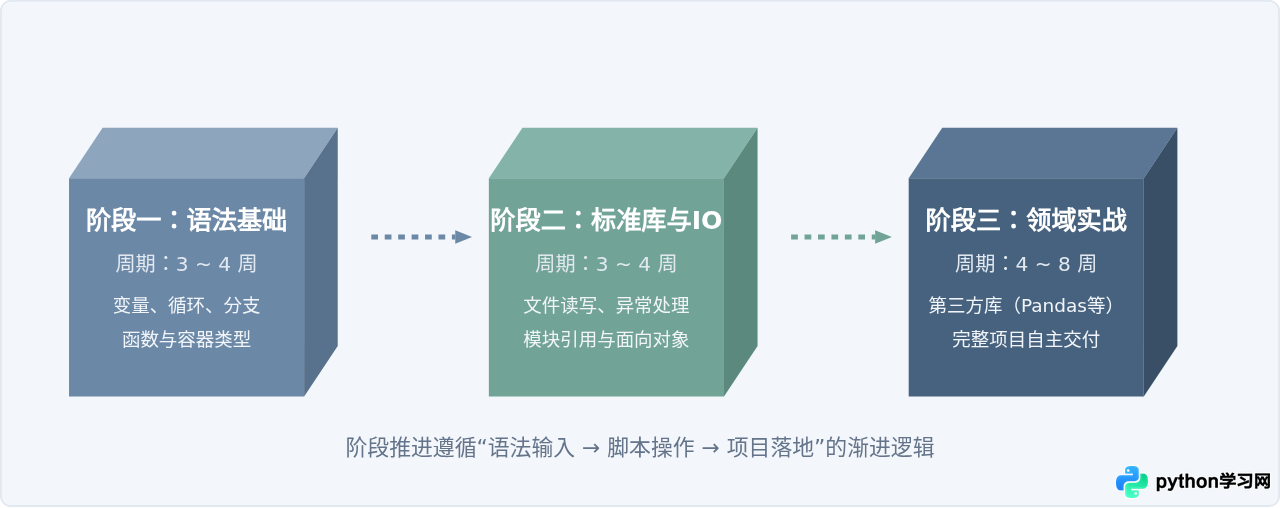
第一阶段:核心语法与逻辑控制(第 1 ~ 4 周)
这个阶段的目标是习惯让计算机按指令处理数据。不要一开始就死记类与装饰器,先掌握以下最常用的基础结构:
- 数据类型:整数、浮点数、字符串、布尔值。
- 容器类型:列表(List)与字典(Dict)。初学者必须熟练掌握字典键值对的读取、更新和遍历。
- 流程控制:
if/else条件判断,以及for、while循环。 - 函数封装:学会把一段重复出现的逻辑提炼成函数,理解形参、实参和
return返回值的作用。
验证指标:无需翻看教程,就能手写一个处理销售清单的脚本。例如,根据单价和数量列表,筛选出金额大于指定值的条目并计算总额。
第二阶段:输入输出、错误处理与标准模块(第 5 ~ 8 周)
程序不仅在内存中计算,还需要和外部环境交互。这一阶段学习让程序处理磁盘上的真实数据:
- 文件读写与路径处理:使用内置的
open()上下文管理器读取纯文本与 CSV 文件,掌握pathlib库遍历本地文件夹。 - 异常捕获:使用
try...except保证程序遇到错误数据(如缺少字段或文件不存在)时不直接崩溃。 - 基础面向对象(OOP):了解
class的基础概念,知道属性与方法的关系。不需要深入研究多重继承或元编程,能看懂并规范调用第三方库的对象即可。
注意:不要在基础语法阶段花费过多时间去刷晦涩的算法题。除非你的目标是计算机专业校招,否则初期大量的链表、二叉树题目容易带来严重的挫败感,并且与实际的自动化操作关联较弱。
第三阶段:专项第三方库与完整小项目(第 9 ~ 12 周)
Python 的生产力主要来自丰富的第三方库。此时需要结合自己的实际需求,选定一个具体方向深入:
- 数据处理方向:学习
pandas读取、清洗、透视 Excel/CSV 数据,使用matplotlib绘制基础趋势图。 - 网络采集方向:掌握
requests发起 HTTP 请求,利用BeautifulSoup解析网页结构,提取所需文字或图片链接。 - Web开发方向:使用轻量框架
Flask或FastAPI搭建一个包含数据增删查改(CRUD)的接口服务。
一个真实的技能验证:从语法到功能落地
许多初学者感觉“看懂了教程却不会写代码”,原因在于缺乏从业务需求向代码逻辑转换的训练。下面通过一个常见的文件批量统计需求,展示第一阶段向第二阶段过渡时,程序应该如何组织。
需求场景:在本地 data/ 目录下存放了多个纯文本日志文件,需要编写一个脚本统计所有文件中包含指定错误关键字(如 ERROR)的行数总和。
import os
from pathlib import Path

def count_error_lines(folder_path: str, keyword: str = "ERROR") -> int:
    """
    遍历指定目录下的所有 .log 文件,统计包含关键字的行数
    """
    target_dir = Path(folder_path)
    if not target_dir.exists() or not target_dir.is_dir():
        print(f"错误:路径 {folder_path} 不存在或不是文件夹。")
        return 0

    total_count = 0
    # 遍历当前目录下的 log 文件
    for file_path in target_dir.glob("*.log"):
        try:
            with open(file_path, "r", encoding="utf-8") as f:
                for line in f:
                    if keyword in line:
                        total_count += 1
        except UnicodeDecodeError:
            # 遇到编码异常跳过或提示,防止程序中断
            print(f"警告:无法按 UTF-8 读取文件 {file_path.name}")
        except PermissionError:
            print(f"警告:无权限访问文件 {file_path.name}")

    return total_count

if __name__ == "__main__":
    # 示例调用
    log_directory = "./data"
    result = count_error_lines(log_directory, "ERROR")
    print(f"统计完成,共发现匹配行数: {result}")
示例输出:
统计完成,共发现匹配行数: 42在这段代码中,涉及了函数定义、默认参数、类型注解、文件路径匹配、上下文管理器(with open)、单行遍历与异常处理。能够在 15 分钟内独立构思并写出类似结构,即代表已经具备了独立完成初级脚本的能力。
影响实际耗时的关键因素对比
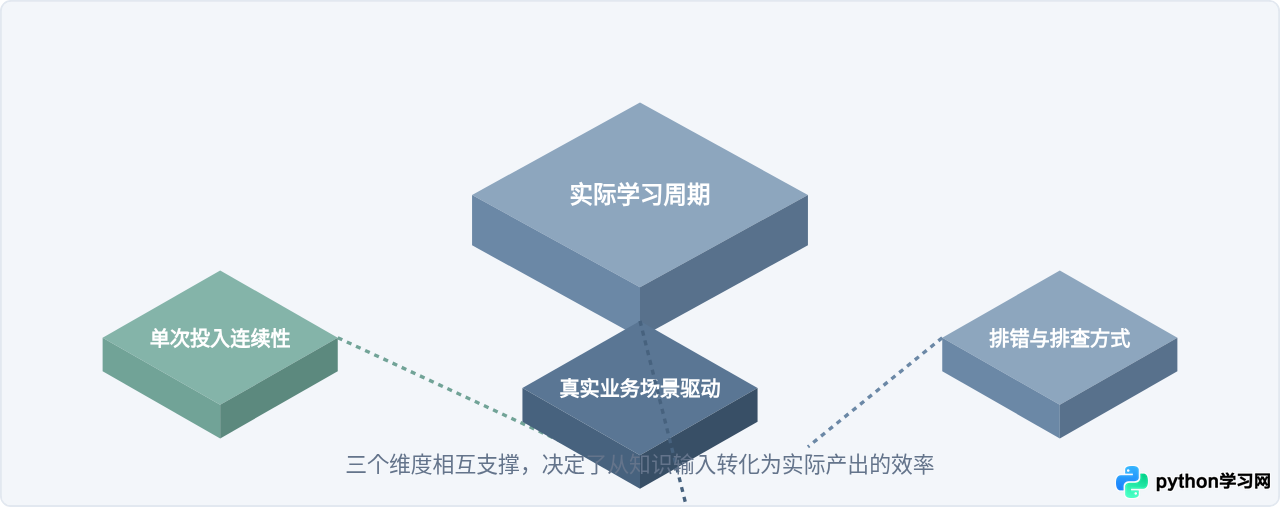
同样是零基础,有人两个半月能独立写出爬虫,有人学了半年依然无法脱离教程。学习周期的伸缩主要受以下几个维度影响:
| 影响因素 | 低效模式(耗时拉长 2~3 倍) | 高效模式(基准预期内完成) |
|---|---|---|
| 时间分配 | 周末集中学 8 小时,工作日完全不碰 | 工作日每天 1.5 小时,周末复盘 3 小时 |
| 学习方式 | 连续看视频刷教程,极少亲自动手敲代码 | 每看 20 分钟知识点,必须在本地运行并修改代码 |
| 反馈机制 | 脱离实际需求,机械运行书本上的数学题 | 用自己的真实工作文件(如报表、目录)作为测试数据 |
| 排错态度 | 一报错就直接向人求助或放弃 | 阅读 Traceback 提示,定位发生错误的行号和错误类型 |
缩短学习周期的 4 个可执行建议
如果你希望在计划时间内扎实掌握 Python,而不是陷入漫长的被动学习,建议在起步时遵循以下原则:
- 本地环境越早配置越好。不要长时间依赖网页在线编译器。尽早在本地安装官方 Python 运行环境和轻量编辑器(如 VS Code),熟悉如何在终端通过
python script.py运行脚本,直面文件路径和环境依赖等必经问题。 - 以目标逆推知识点。如果是为了处理表格,学完基础语法后立刻学习
openpyxl或pandas,不需要先把多线程、网络套接字(Socket)看一遍。只学当前任务用得上的东西。 - 重视报错信息的提示。Python 的错误信息(Traceback)十分明确。最后一行通常指明了错误原因(如
KeyError表示字典中没有这个键,IndexError表示列表越界),倒数第二行给出了报错代码的位置。学会看报错提示,可以省下绝大部分卡顿时间。 - 保留可复用的脚本片段。将自己写通的文件遍历、网络请求、格式转换代码保存为一个工具包。在后续写新需求时直接组合调用,能够极大地建立实操成就感。
总结
零基础学习 Python,核心不是“记住多少语法规则”,而是建立用代码处理数据的直觉。以每天 1.5 到 2 小时的投入来算,1 个月入门语法,2 个月实现办公自动化,3 到 5 个月掌握特定领域的独立开发能力,是一个客观且符合认知规律的时间范围。避免沉迷在被动看教程中,通过解决真实的小问题推进代码量,是确保在预期周期内学成 Python 的最有效途径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















