


TensorFlow静态图与PyTorch动态图的核心区别
深入解析TensorFlow静态图与PyTorch动态图的核心区别,涵盖计算图构建机制、代码执行流程、调试方式与工程选型建议。
一、核心机制:先建图后运行 vs 边建图边运行
深度学习中的张量运算可以抽象为有向无环图(DAG),其中节点代表数学操作(如加法、卷积),边代表流动的张量数据。理解两者的根本差异,首先要看代码执行时计算机到底在何时分配资源和构建拓扑网络。
在经典静态图机制中,程序的编写过程仅仅是在定义一张“空图”或蓝图。在此阶段,系统不会载入具体的数值张量,操作节点只包含形状与数据类型信息。只有在显式创建会话(Session)并将具体数据馈入(Feed)后,底层的C++计算引擎才会启动针对图拓扑的运算。
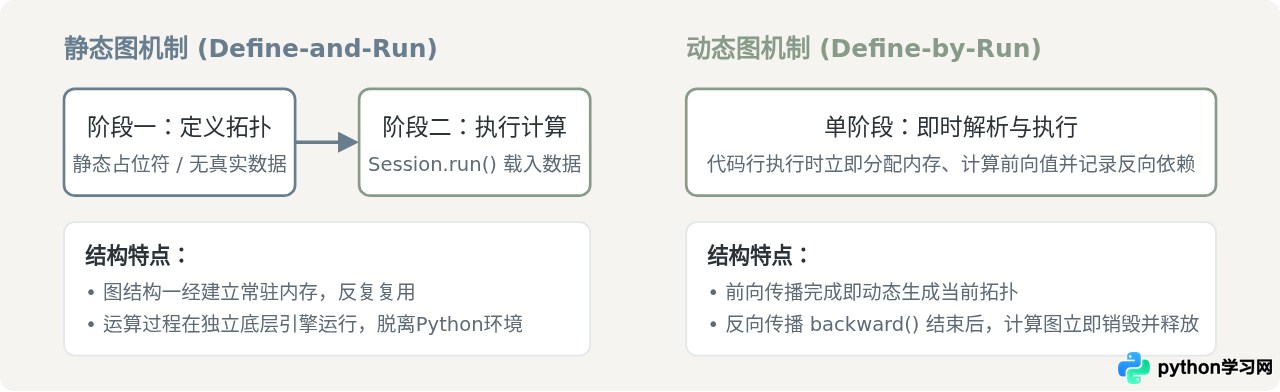
与此相对,PyTorch采用的动态图机制将图的构建融于常规代码流之中。每次Python解释器执行到具体的张量运算语句时,底层不仅立即完成算子调用并返回实际张量,同时在后台自动记录生成该结果的运算链(如 GradFn 节点)。当前轮次反向传播执行完毕后,构成的临时拓扑图默认会被销毁,下一轮前向传播再按需动态生成新图。
二、代码表现与实际执行对比
这种设计理念的差异,直接体现在最基础的代码书写与输出行为上。以下通过一个简单的矩阵加法与乘法来对比两者的执行逻辑。
1. 静态图模式(TensorFlow经典图定义)
在纯静态图范式下,我们声明变量并进行操作,直接打印变量得到的是占位节点对象,而非数值本身。
import tensorflow.compat.v1 as tf
tf.disable_eager_execution()  # 禁用即时执行以展示原生静态图行为

# 步骤 1: 声明计算图拓扑结构
a = tf.placeholder(tf.float32, shape=(2, 2), name="input_a")
b = tf.constant([[1.0, 2.0], [3.0, 4.0]], name="const_b")
c = tf.matmul(a, b)

print("直接打印张量 c 的对象信息:")
print(c)

# 步骤 2: 开启 Session,载入数值执行
with tf.Session() as sess:
    result = sess.run(c, feed_dict={a: [[2.0, 0.0], [0.0, 2.0]]})
    print("\nSession 运行后的实际计算结果:")
print(result)Tensor("MatMul:0", shape=(2, 2), dtype=float32)
Session 运行后的实际计算结果:
[[2. 4.]
[6. 8.]]
2. 动态图模式(PyTorch默认行为)
PyTorch的代码如同编写原生的NumPy程序,定义即计算,张量随时持有实际数据。
import torch

# 即时声明并执行
a = torch.tensor([[2.0, 0.0], [0.0, 2.0]], requires_grad=True)
b = torch.tensor([[1.0, 2.0], [3.0, 4.0]])
c = torch.matmul(a, b)

print("直接打印张量 c:")
print(c)tensor([[2., 4.],
[6., 8.]], grad_fn=<MmBackward0>)
三、调试排错过程对比
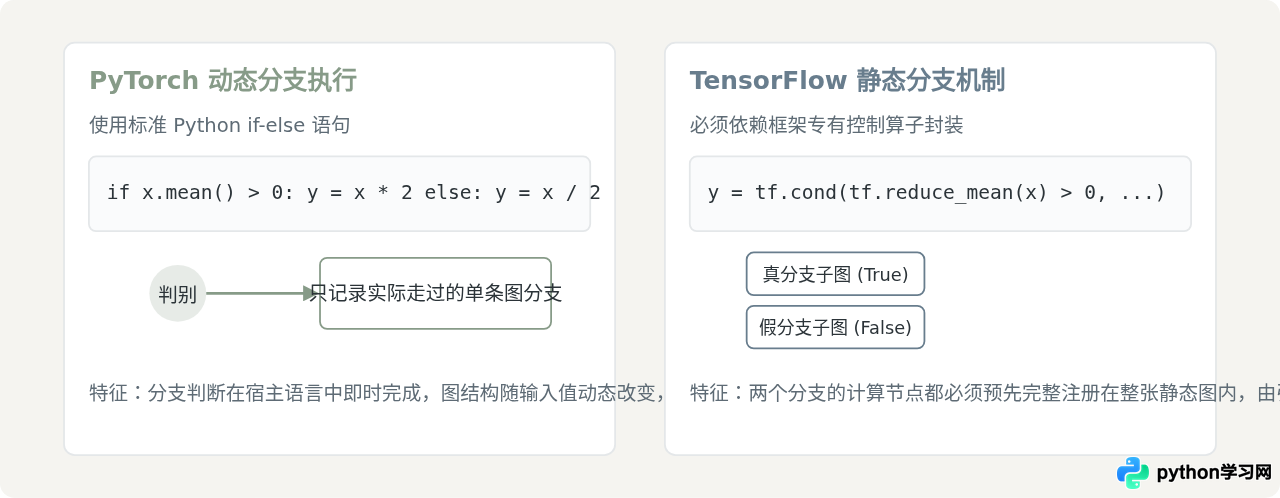
执行方式的不同直接改变了开发者的调试体验。在模型研发过程中,张量形状不匹配或数值溢出(NaN)是最常见的排查场景。
sess.run() 这一行,而非产生错误的具体加乘代码行。这是因为定义代码早已执行完毕,真正的计算发生在脱离Python的底层C++执行期中。
动态图的调试方式与常规Python代码完全一致。开发者可以在任何一层神经网络的前向传播中直接插入 print(tensor.shape),或者使用标准的 pdb.set_trace() 设立断点单步调试。只要代码执行中断,即可通过交互终端直接查看所有已运行张量的中间值和数值分布。
静态图在纯图模式下无法直接单步打印张量值。要观测节点运行状态,通常有以下几种方式:
- 在
sess.run([c, extra_node], ...)的调用列表中显式传入需要观测的内部节点。 - 在图中插入
tf.print()打印算子,使其成为拓扑网络的一部分并等待触发。 - 依赖专用可视化工具(如 TensorBoard 的 Graph 面板)解析序列化后的计算图事件文件。
四、关键差异为什么重要:性能、部署与灵活性的权衡
既然动态图调试如此直观,为何静态图依然在很多工业生产场景中占据核心地位?两者的差异绝非“落后与先进”之分,而是在运行期灵活性与全局优化能力之间的工程取舍。
静态图在执行前就获得了完整的计算拓扑。这为编译器级全局优化提供了先决条件:
- 算子融合(Operator Fusion):编译器可将多个细粒度算子(例如“卷积 + 偏置加法 + ReLU激活”)合并为一个硬件内核(Kernel)执行,大幅减少GPU显存往返读取(I/O延迟)。
- 显存预分配与复用:由于整张图已知,框架可以精准分析各中间张量的生命周期,让不同时段的张量共享同一块显存地址,避免频繁的动态显存分配开销。
- 跨平台脱水部署:静态图可以完全脱离Python解释器环境,直接导出为序列化协议缓冲区(ProtoBuf),在嵌入式设备、C++高性能服务端或移动终端独立运行。
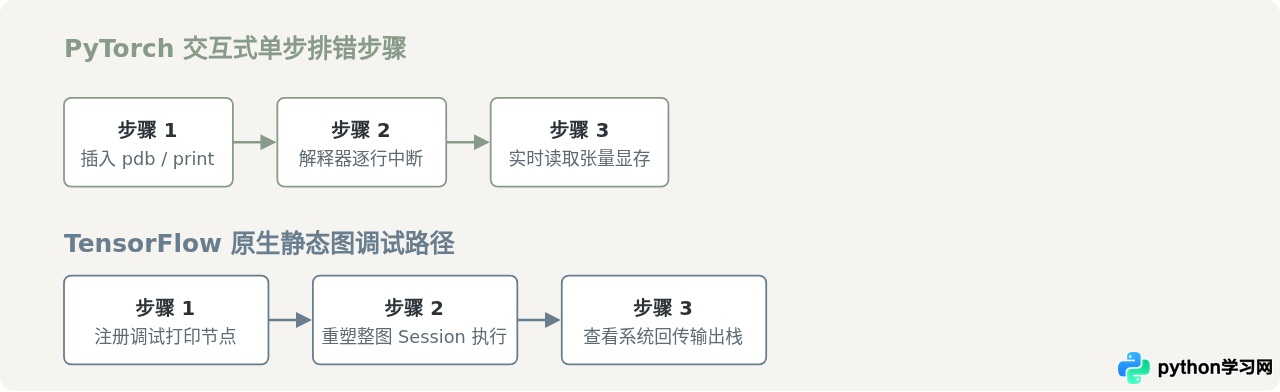
动态图的优势则在于探索与表达。当处理变长输入序列、动态树状结构网络或强化学习策略分支时,用动态图实现无需编写复杂的掩码(Mask)或条件控制流,代码直观且容错率高。
| 对比维度 | TensorFlow 静态图 (Define-and-Run) | PyTorch 动态图 (Define-by-Run) |
|---|---|---|
| 计算图生命周期 | 编译时建立,内存常驻,多次迭代复用 | 运行时按需即时构建,单次反向计算后即销毁 |
| 调试难易度 | 门槛高,依赖图内探针与专用可视化组件 | 门槛低,直接支持原生 Python print 与 pdb 断点 |
| 控制流实现 | 必须使用框架专属条件/循环算子(如 tf.while_loop) | 原生支持 Python 原生 if、for、while 逻辑 |
| 图级别编译优化 | 天然支持(跨算子融合、显存静态精简分配) | 受限于逐行调度,依赖后续编译器(如 TorchDynamo)弥合 |
| 生产部署独立性 | 高,可导出为自包含模型脱离 Python 运行 | 早先对 Python 依赖度高,需经由 TorchScript/ONNX 转化 |
五、工程演进现状与选型建议
现代深度学习框架的发展并非非此即彼,两者的界限正在趋于融合:
TensorFlow自2.0起默认开启了即时执行模式(Eager Execution),使日常交互体验无限贴近动态图;同时提供 @tf.function 装饰器,将经过测试的Python逻辑使用 AutoGraph 追踪编译为高效静态图。
PyTorch在保持动态图开发体验的同时,引入了基于图捕获与JIT编译优化的 torch.compile 机制,通过分析Python字节码自动提取静态计算子图,以此获得比肩原生静态图的高执行效率。
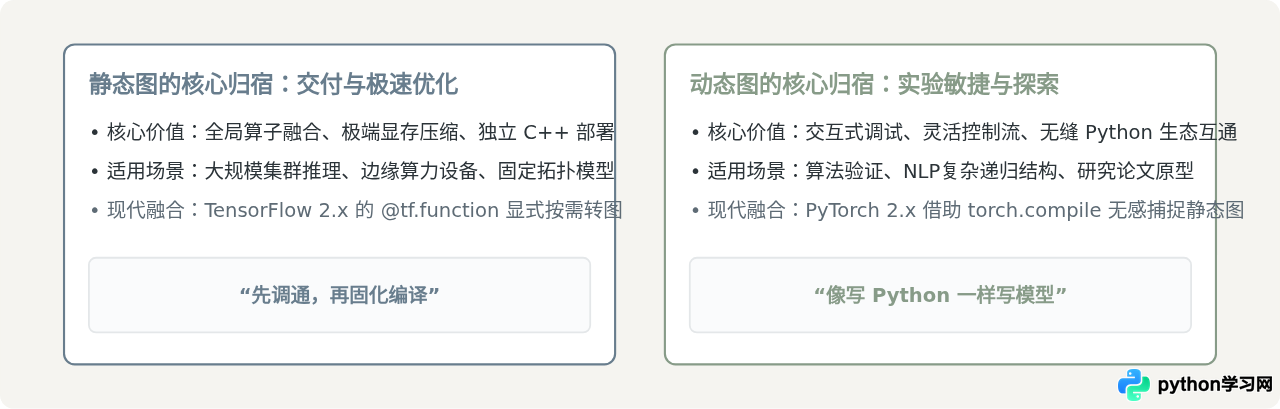
在实际项目选型时,无需将框架与特定模式完全对立。常规研发建议遵循如下原则:在模型设计、实验探索和算法原型阶段,优先依赖动态图模式的高迭代速度和调试便利;当模型结构稳定、面临高吞吐推理或受限硬件部署任务时,再通过静态图导出或编译追踪,将整网固化为经过算子优化的高性能执行图。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















