


在线Python 3编译器无法导入模块怎么办
针对在线Python 3编译器提示ModuleNotFoundError报错的排查与解决方法,涵盖底层运行机制分析、页面内置安装工具使用、纯Python单文件平替以及平台迁移建议。
ModuleNotFoundError: No module named '...',通常不是你的代码逻辑写错,而是因为在线环境缺少对应的第三方库,或是平台架构(沙盒容器或浏览器端 WebAssembly)限制了外部网络访问与系统级安装。解决这一问题,核心在于分清模块归属、确认编译器类型,并依序通过内置包管理机制、无依赖替代方案或更换交互式云平台来解决。
打开浏览器写 Python,省去了安装环境、配置环境变量和折腾编辑器的烦琐步骤。但很多人刚写到第二行,敲下 import requests、import numpy 或 import cv2,点击运行就立刻收到醒目的红字报错:
Traceback (most recent call last):
  File "main.py", line 1, in <module>
    import requests
ModuleNotFoundError: No module named 'requests'
遇到这种情况,很多初学者会下意识在编辑器里输入 pip install requests,结果往往是引发更严重的语法报错 SyntaxError: invalid syntax。因为在线编译器的输入框只接收 Python 代码,不是本地系统的终端命令行。要彻底排查并搞定模块无法导入的障碍,我们需要按序理清其背后的原因与执行路径。
第一步:确认模块类型与拼写细节
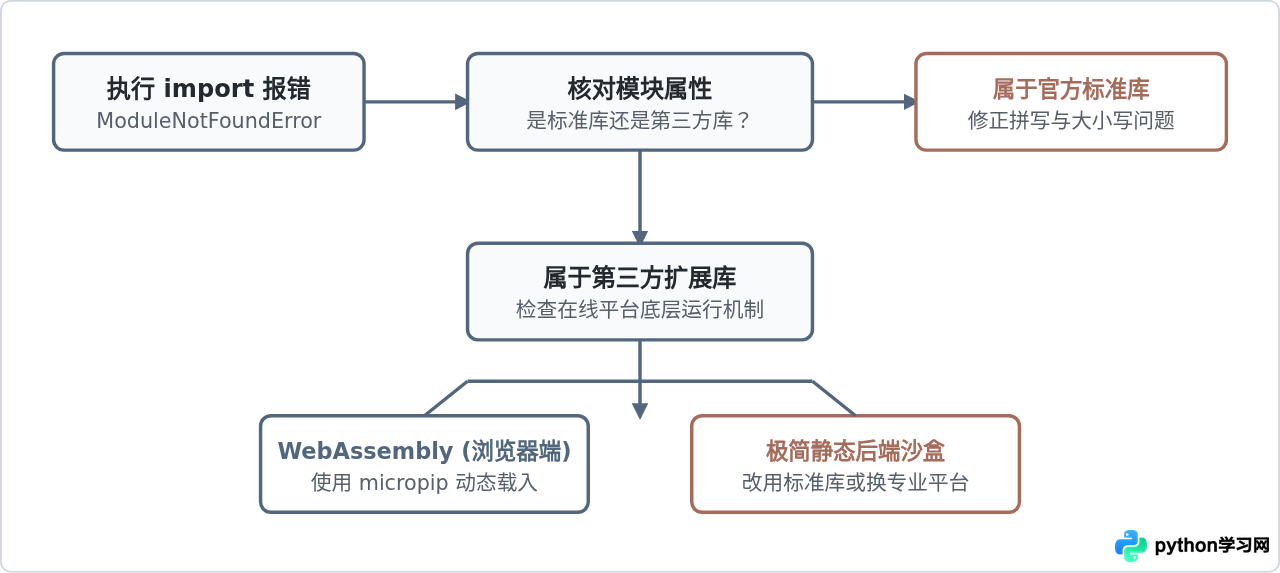
在寻找外部工具之前,先排查一个经常被忽略的细节:你尝试导入的模块,究竟是 Python 自带的“标准库”,还是必须额外下载的“第三方库”。
Python 自带了丰富的标准库,例如 math、json、re、datetime、urllib.request 和 sqlite3。无论在什么平台上,只要是正规的 Python 3 解释器,这些库都不需要安装即可直接 import。如果导入标准库也报错,请重点检查拼写大小写(例如将 tkinter 误写为 Tkinter,或者把 json 敲成了 Json)。
如果确定是第三方库(如 requests、pandas、bs4、matplotlib 等),则意味着当前在线环境的物理磁盘上根本没有这个文件夹。此时必须按照下方的诊断流程排查原因。
第二步:理解在线编译器的两种运作机制
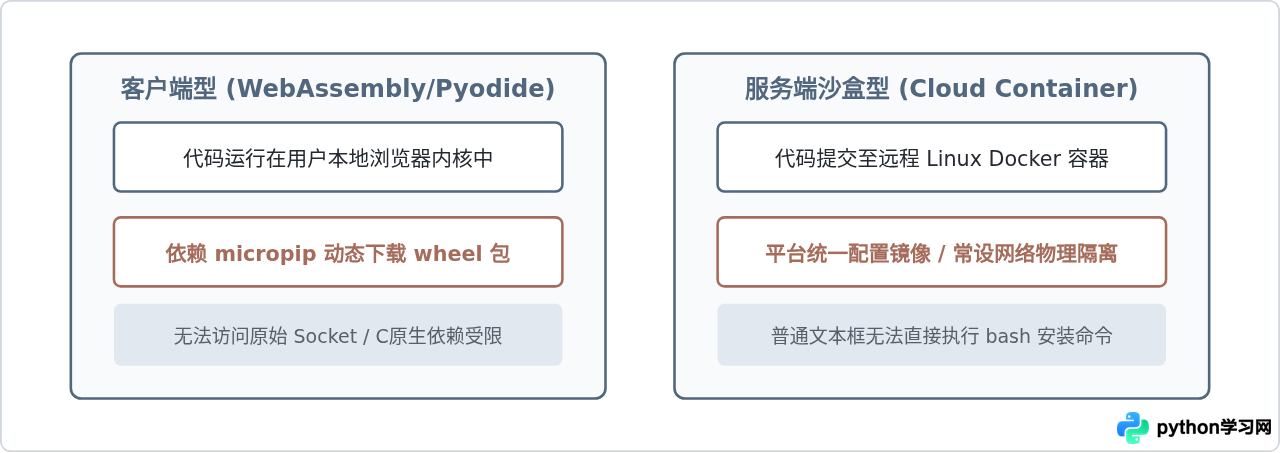
很多开发者以为所有“在线运行网页”都是一样的,但它们的底层实现其实完全分为两大家族。搞清楚当前网站属于哪一种,就能直接决定我们采取什么措施:
第一种是浏览器原生解释器(基于 WebAssembly / Pyodide)。这类网站(例如部分极简在线刷题站点、JupyterLite)并没有真正的远程服务器在为你执行计算,而是把 Python 解释器编译成了 WebAssembly 格式,直接加载在你的浏览器标签页内存里运行。它的特点是启动极快、不需要登录,但它无法直接运行系统的 pip 命令,并且对包含 C 扩展底层的库支持有限。
第二种是远程容器沙盒(Server-side Container)。代码会被发送到云端服务器的 Docker 容器中执行,再把 stdout 标准输出回传到网页。许多轻量级教程网站为了防止被黑客当作挖矿机或发送垃圾邮件,会将容器彻底断网,或者直接阉割掉 pip 权限,仅预装纯 Python 运行环境。
第三步:实操解决方案与具体操作步骤
明确了上述限制后,针对不同在线工具,有以下几套切实可行的解法。
方法一:在代码中调用 micropip(适用于 Pyodide 架构编译器)
如果你使用的平台基于 Pyodide,页面通常内置了微型包管理器 micropip。你不能直接跑 pip 命令,但可以通过异步协程直接在代码首部安装支持的纯 Python 模块:
import micropip
await micropip.install('requests')

import requests
print("模块导入成功!")
只要当前编译环境暴露了 top-level await 机制,这段代码会自动从 PyPI 镜像源拉取 wheel 包并动态注入当前运行域。如果提示 NameError: name 'micropip' is not defined,说明当前环境并非 Pyodide,需要尝试后续方案。
方法二:使用 Python 代码内部动态调用 pip
对于一些允许连接外网、但没有提供网页终端界面的服务端编译器,我们可以利用标准库中的 subprocess 或 pip 自身模块,在代码执行的一瞬间静默拉取外部包:
import sys
import subprocess

# 尝试通过底层子进程调用 pip 工具
try:
    subprocess.check_call([sys.executable, "-m", "pip", "install", "requests"])
    import requests
    print("第三方模块安装并导入成功")
except Exception as err:
    print("安装受阻,当前沙盒已限制外网访问或禁止系统调用:", err)
执行输出示例:
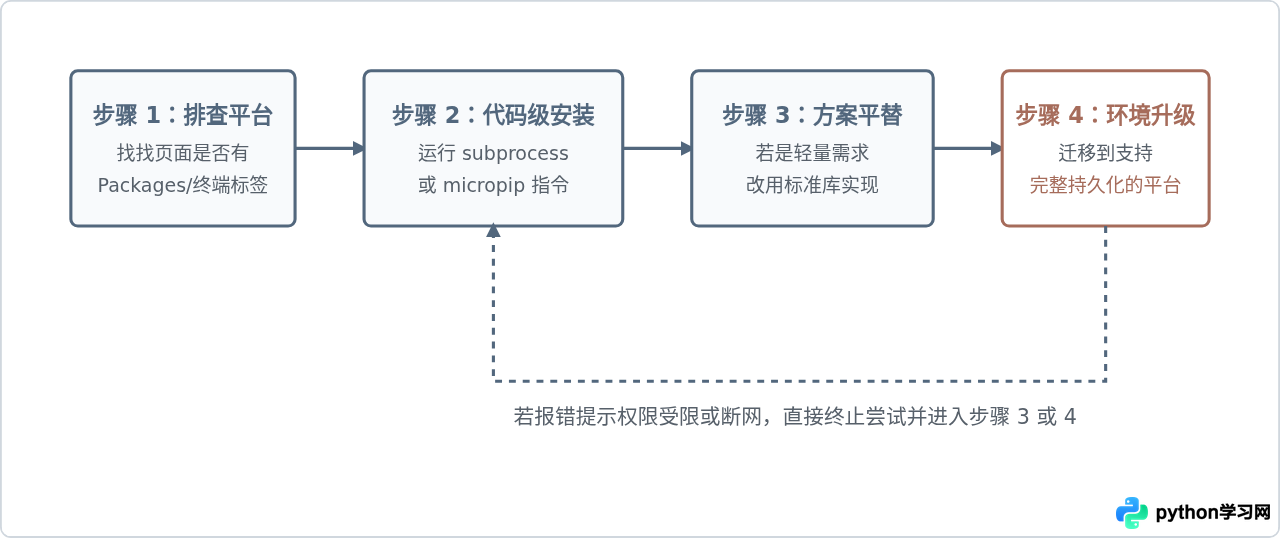
安装受阻,当前沙盒已限制外网访问或禁止系统调用: [Errno 1] Operation not permitted如果在输出窗口中看到类似 Operation not permitted 或 Connection refused,这表明服务提供商从内核层禁用了网络请求与文件写入。在这种严格沙盒下,任何在当前网页中执行“安装”的尝试都注定无效。
第四步:采用内置标准库进行平替
如果你只是为了验证一个算法或完成课后小作业,并非必须深度绑定某个第三方框架,最直接的方法是用 Python 的标准库重写核心逻辑,彻底摆脱安装限制。
以最常报错的 requests 为例,我们完全可以使用标准库自带的 urllib.request 来实现等价的网络数据拉取:
# 原本无法运行的代码:
# import requests
# resp = requests.get("https://api.github.com")
# print(resp.json())

# 平替方案:使用无需安装的内置标准库
import urllib.request
import json

url = "https://api.github.com"
req = urllib.request.Request(
    url,
    headers={'User-Agent': 'Mozilla/5.0'}
)

try:
    with urllib.request.urlopen(req) as response:
        html_data = response.read().decode('utf-8')
        result = json.loads(html_data)
        print("请求成功,状态码:", response.status)
        print("返回节点统计:", len(result))
except Exception as e:
print("网络请求失败(检查在线编译器是否断网):", e)urllib,也可能会报 URLError: <urlopen error [Errno 111] Connection refused>。此时属于网络策略限制,非代码写法问题。
第五步:无法破局时的平台选择策略
如果你的目标是系统学习数据分析、机器学习或 Web 开发(必须使用 pandas、numpy、sklearn 等底层包含编译组件的重量级库),就应当果断放弃轻量级的“单页面代码运行框”,转而选用具备完整运行态的专业云端开发环境:
- 需要做数据分析与图表:优先选择 Google Colab 或 Kaggle Kernels。这类环境在云端直接预装了几乎所有科学计算库,并支持直接用
!pip install 包名自由扩充,还提供免费的硬件算力支持。 - 需要完整 Linux 终端与工程文件系统:使用 Replit、GitHub Codespaces 或 Gitpod。它们提供完整的虚拟终端,支持多文件项目管理,敲击
pip install与本地开发体验几乎没有区别。 - 纯本地单机学习:在线平台受制于云端资源成本和安全规则,天然不适合承载重度实验。遇到复杂库的安装问题,最彻底的解决路径仍然是在个人电脑上安装官方 Python 并配置 VS Code 本地开发环境。
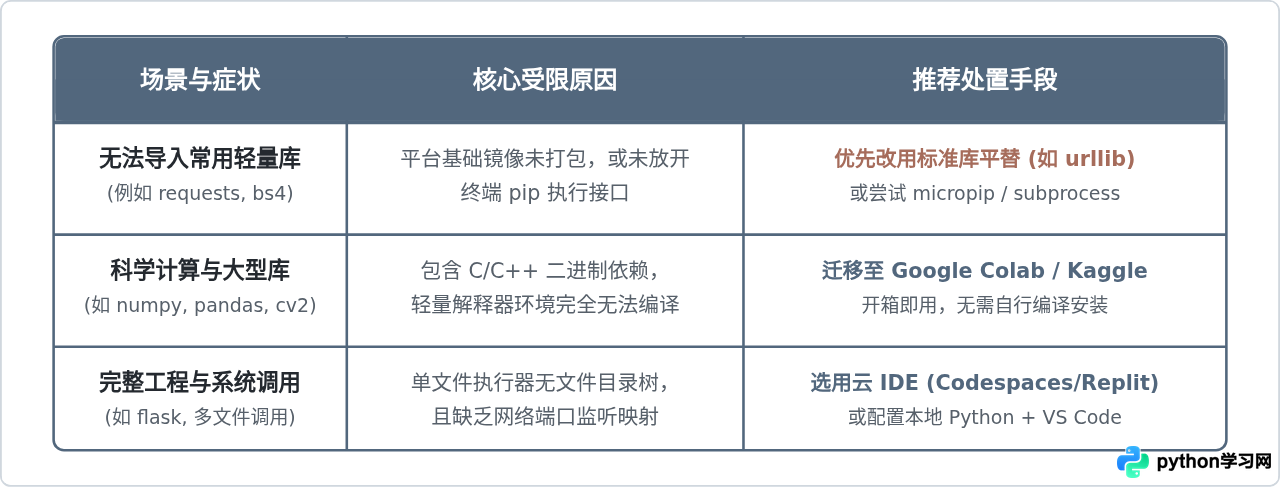
总结与排查要点
遇到在线 Python 3 编译器提示无法导入模块时,不要盲目在编辑器里重复粘贴安装命令。请牢记以下三点结论:
- 第一反应看名字:区分标准库与第三方库,排除手误拼写问题。
- 看环境给不给权限:绝大多数主打“秒开”的在线教程代码框是只读或脱网运行的,不支持任意拓展安装;不要花过多时间尝试越狱沙盒。
- 任务与工具对齐:简单语法学习用标准库测试;重度依赖外部生态的项目,直接使用具备完整终端能力的云环境或本地解释器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















