


《Python程序设计基础》第三版相比第二版更新了哪些内容?
详细梳理国内高校广泛采用的《Python程序设计基础》第三版相比第二版的具体改动,涵盖语言规范演进、语法结构更新、第三方库更替与综合实践案例调整。
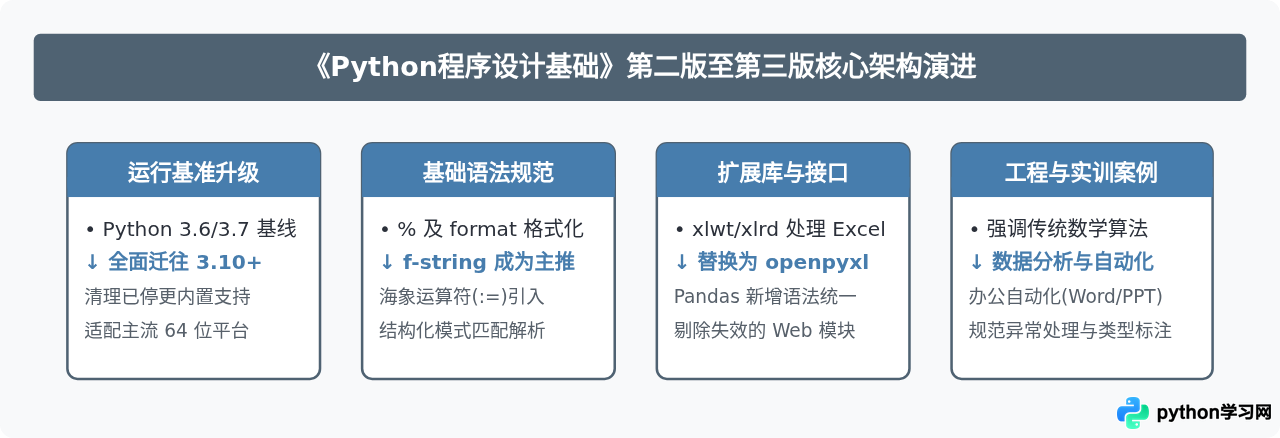
高校教学中使用的《Python程序设计基础》(以董付国等编著的高等教育经典系列教材为典型代表),在第二版出版时主流运行环境多基于 Python 3.5 至 3.7 阶段。随着近年来官方底层特性的迭代以及大量第三方数据分析库的接口调整,第二版中诸如过时的字符串格式化语法、废弃的包安装方法、已被弃用的图形与网络访问接口已脱离现行开发环境。了解第三版的变动,不仅有助于学生平稳过渡课堂作业,也能让教师明确授课与考核调整的重点。
一、语法细节与编程规范的重点翻新
第二版教材编写时,部分现代编程范式尚未在入门教材中普及。第三版直接把行业广泛采用的现代 Python 规范前置到了基础语法章节中,重点体现在格式化输出、条件表达式和类型声明。
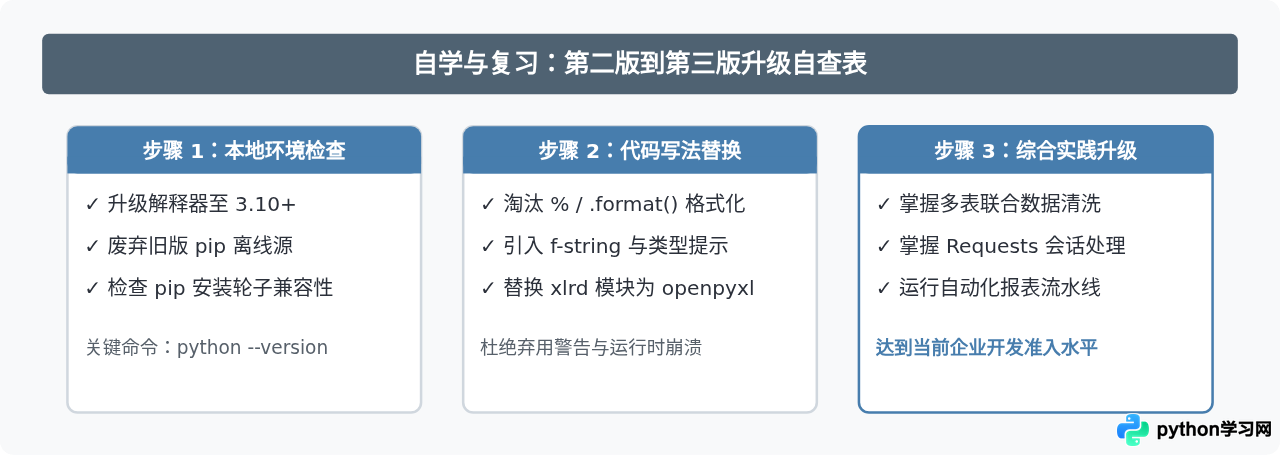
1. 字符串格式化全面以 f-string 为主力
在第二版中,字符串插值主要讲解 % 占位符操作符以及 str.format() 方法,f-string 往往只作为补充知识一笔带过甚至未列入例题。第三版正式确立了以 f"{表达式}" 为基准的教学主线,极大精简了样板代码。
# 第二版典型示例:使用 format 方法
name = "张华"
score = 92.5
msg = "学生:{},成绩:{:.1f}".format(name, score)

# 第三版对应标准写法:主推 f-string 语法
msg = f"学生:{name},成绩:{score:.1f}"
2. 新增海象运算符与模式匹配介绍
第三版在控制结构章节中,补充了 Python 3.8 引入的赋值表达式(海象运算符 :=),并增补了 Python 3.10 带来的 match-case 结构化模式匹配机制。虽然基础循环仍以经典 for / while 为重点,但在处理正则提取和循环读取文件时,给出了更现代的实现方案。
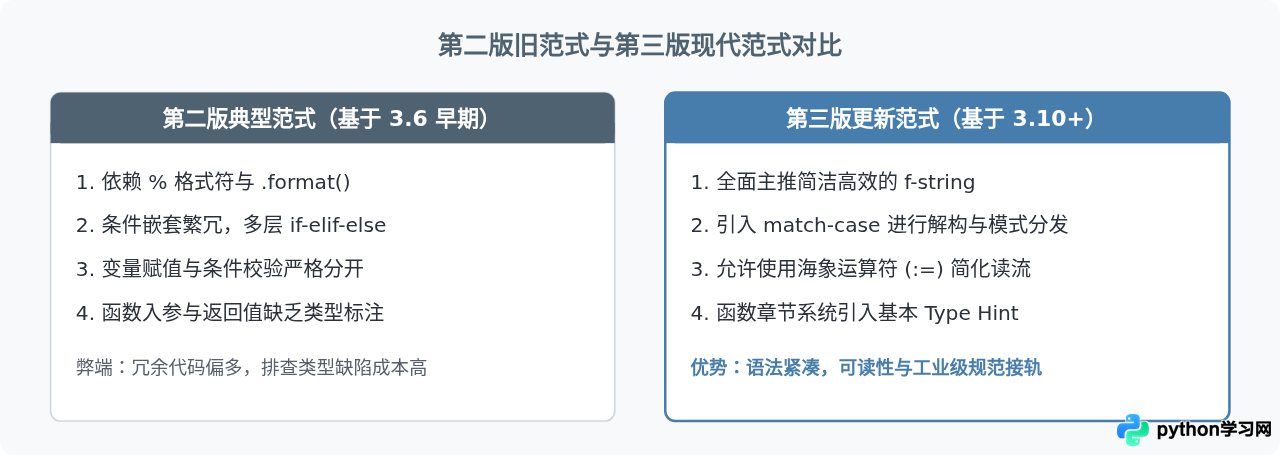
3. 函数与类型标注(Type Hints)正规化
第二版的函数部分仅介绍参数传递的基本规则(位置参数、默认参数、*args、**kwargs)。第三版在保持传统重点的同时,在函数定义和类的定义中规范了类型提示语法(如 def calc_total(prices: list[float]) -> float:)。虽然 Python 运行时本身并不强制检查类型,但教材通过讲解这一规范,让读者在学习期养成规范的工程编码习惯。
二、第三方扩展库与依赖组件的升级更替
由于开源社区的快速迭代,第二版中许多原本被认为“开箱即用”的第三方库,在目前的新版本 Python 中存在兼容失效或官方停止维护的问题。第三版针对这些痛点进行了彻底替换。
xlrd.biffh.XLRDError)以及早期的网络请求模块。第三版代码直接按当前的包生态重写,若在旧版教案中调试,请务必留意所用第三方库的版本约束。
| 应用模块 | 第二版采用方案 | 第三版更新方案 | 替换的核心原因 |
|---|---|---|---|
| Excel文件处理 | xlrd / xlwt |
openpyxl |
xlrd 2.0+ 已移除对 .xlsx 格式的支持;openpyxl 支持现代 Office 格式。 |
| 网页与网络交互 | 原生 urllib 混编 |
全面规范 requests |
简化会话保持、Cookie 处理与 JSON 解析流程,写法更符合主流习惯。 |
| 数据绘图可视化 | 单一依赖基础 matplotlib 面向过程接口 |
面向对象 API 结合 pandas 内置绘图 |
第二版多用 plt.plot(),第三版更注重 fig, ax = plt.subplots() 规范结构。 |
| 中文文本分词 | jieba 简单调用 |
jieba 结合词频统计及停用词表清洗 |
案例由“单纯打印分词结果”升级为“形成可分析的结构化词频矩阵”。 |
三、实训案例与课后习题的重构步骤
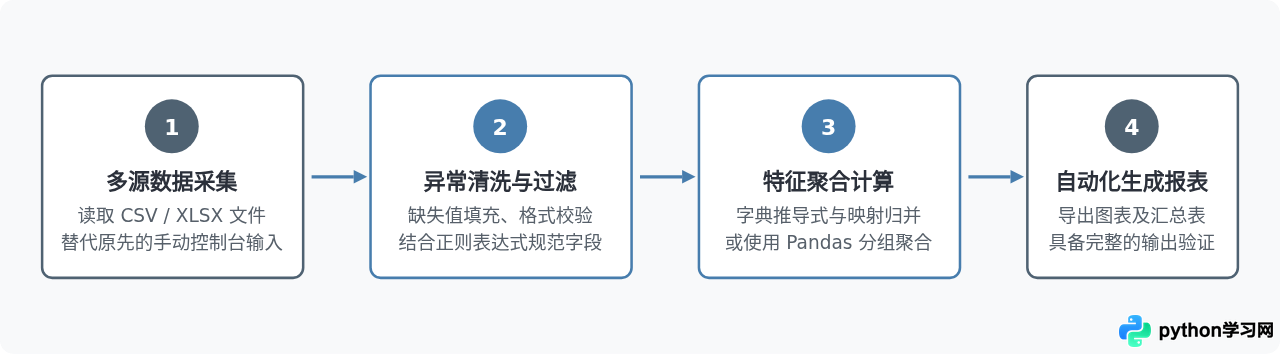
教学案例的改造是第三版另一项肉眼可见的升级。第二版的案例偏重于经典的数学递推、字符串反转、控制台简易学生管理系统。第三版保留了经典的逻辑训练题,但将综合实践部分迁移到了办公自动化与数据清洗领域。
读者在学习第三版新增的“现代文本与数据批处理案例”时,通常遵循以下标准流转流程:
实训示例:清洗并统计非标准输入数据
下面这段代码展现了第三版综合训练题的典型特征:结合类型标注、异常捕获以及推导式完成一步到位的数据汇总:
from typing import List, Dict

def parse_student_scores(records: List[str]) -> Dict[str, float]:
    """解析以逗号分隔的学生信息,过滤非法字符并计算及格数据"""
    cleaned_data = {}
    for item in records:
        try:
            name, raw_score = item.strip().split(',')
            score = float(raw_score)
            if 0 <= score <= 100:
                cleaned_data[name] = score
        except ValueError:
            # 忽略数据行缺失或成绩非数字格式的脏数据
            continue
    return cleaned_data

raw_inputs = ["张三,85", "李四,abc", "王五,92.5", "赵六,-5"]
result = parse_student_scores(raw_inputs)
print(f"清洗完成的数据:{result}")
# 运行结果(示例输出):
# 清洗完成的数据:{'张三': 85.0, '王五': 92.5}
四、两版本选择与学习切换建议
对于正在准备考试、毕业设计或自学 Python 的读者,面对手头的教材版本,可按照以下依据进行决策:
- 高校统招期末考试:以授课老师指定的教材版本为准。如果课程仍指定第二版,注意不要在机试作业中过度依赖 Python 3.10+ 特有的模式匹配等新特性,以免校内机房老旧解释器(如 Python 3.6 环境)报
SyntaxError。 - 全新自学或毕业设计:强烈建议直接选用第三版。第二版中的很多第三方库代码在全新的操作系统和包管理器环境下安装阻力大,第三版所使用的语法和扩展库与目前产业界的技术栈完全一致。
- 已有第二版教材的读者:不必彻底丢弃旧书。核心的流程控制(
if、for、while)、函数作用域、面向对象概念(类与继承)在两个版本中逻辑一致。读者只需补充阅读 Python 3.8+ 语法特性以及openpyxl、requests的独立使用文档即可补齐差距。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















