


Python set去重后无序怎么办?保持原始顺序的去重技巧
详解Python中使用set去重导致元素顺序被打乱的原因,并提供dict.fromkeys()、set.sort(key=list.index)、辅助集合遍历及自定义key函数等多种保持原始顺序的去重方法与代码示例。
在 Python 3.7 及以上版本中,解决 set 去重后顺序被打乱的最快方法是改用 list(dict.fromkeys(items))。如果你坚持使用 set,也可以在去重后结合列表的 index 方法重新排序;而当列表中包含字典、嵌套列表等不可哈希元素时,则可以通过辅助集合配合循环完成保序去重。下面我们从原因入手,逐一讲解不同场景下的具体写法与取舍。
一、为什么 list(set()) 会打乱原始顺序?
很多人在需要给列表去重时,第一反应是写 list(set(items))。这种写法确实能把重复项清理掉,但只要打印结果就会发现,元素排列顺序跟原来的列表完全对不上。
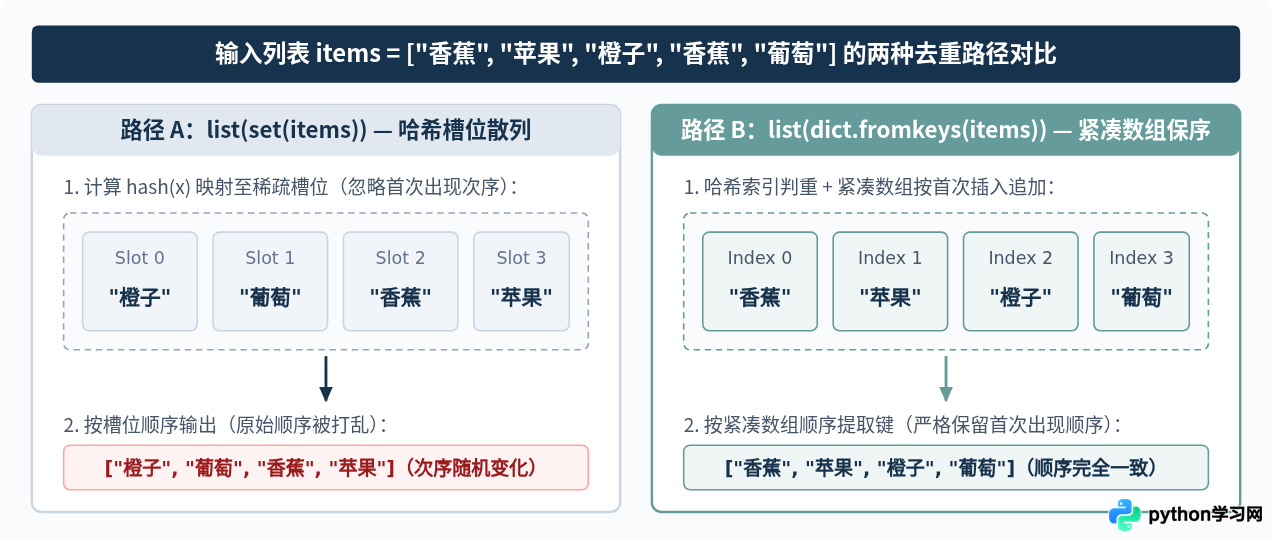
这并不是代码写错了,而是由 set(集合)底层的数据结构决定的。Python 的集合基于哈希表(Hash Table)实现,当你把列表传入 set() 时,Python 会依次计算每个元素的哈希值(hash(x)),并根据哈希值对槽位数量取模,把元素放进对应的内存槽位中。由于不同元素的哈希值分布与它们在原列表中的先后位置没有任何关系,最终遍历集合转回列表时,读取的是哈希槽位的物理顺序,原始的插入顺序自然就丢失了。
此外,Python 为了防范哈希碰撞攻击,默认开启了哈希随机化(Hash Randomization)。对于字符串等类型,每次启动新的 Python 解释器进程时,同一个字符串的哈希值都会发生变化,导致 list(set(items)) 在不同运行批次下的输出顺序都可能不一样。
二、首选方案:使用 dict.fromkeys() 保持顺序去重
对于包含字符串、数字、元组等可哈希(Hashable)元素的普通列表,最简洁且执行速度最快的保序去重写法是使用 dict.fromkeys(),再将字典转回列表。
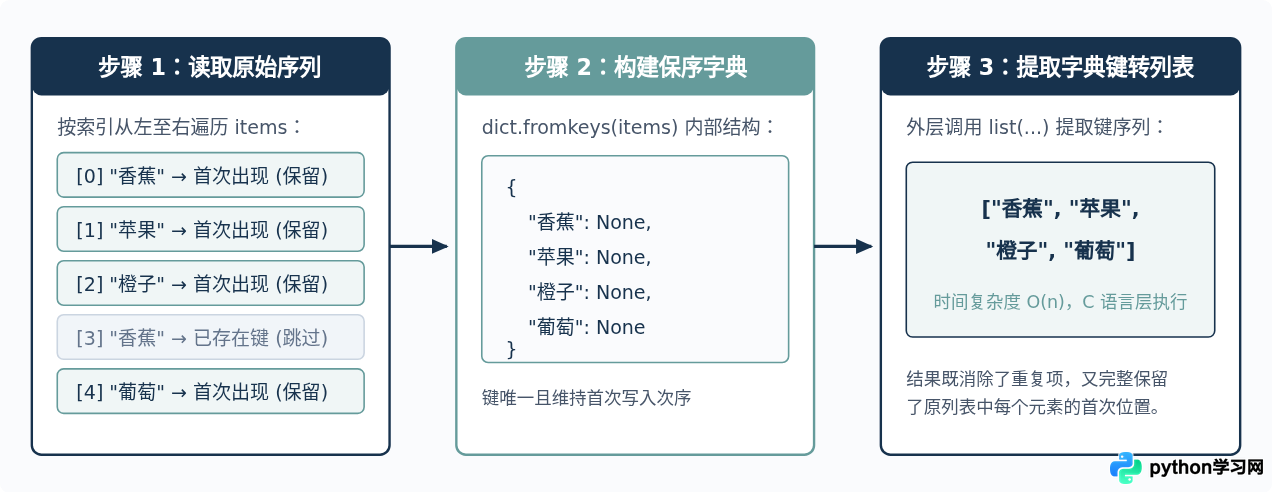
这一方法之所以可靠,是因为从 Python 3.7 开始,语言规范正式保证标准字典(dict)会严格按照键(Key)的首次插入顺序进行存储和遍历。同时,字典的键天生具有唯一性——当 dict.fromkeys(items) 依次读取列表元素时,遇到新元素会按顺序登记为键(默认值为 None),遇到已经存在的重复元素则直接跳过,不会改变该键原先的位置。最后用 list() 提取字典的所有键,就能得到既无重复、又严格保持首次出现顺序的新列表。
你可以在 Python 3.7 及以上版本的交互式终端或脚本文件中直接运行以下代码:
# 适用环境:Python 3.7+
items = ["香蕉", "苹果", "橙子", "香蕉", "葡萄", "苹果"]

# 对比 1:直接使用 set 去重(顺序被打乱)
unordered_result = list(set(items))

# 对比 2:使用 dict.fromkeys 保序去重
ordered_result = list(dict.fromkeys(items))

print("原列表:          ", items)
print("set 去重结果:     ", unordered_result)
print("fromkeys 去重结果:", ordered_result)set 去重结果: ['橙子', '葡萄', '香蕉', '苹果']
fromkeys 去重结果: ['香蕉', '苹果', '橙子', '葡萄']
dict 不具备保序特性,此时可以从标准库导入 OrderedDict,将代码替换为 from collections import OrderedDict 后调用 list(OrderedDict.fromkeys(items)),效果完全相同。
下面通过步骤分解图展示 list(dict.fromkeys(items)) 在内存中的完整处理过程:
三、保留 set 去重后再还原顺序的做法与局限
如果你已经在代码里写了 list(set(items)),或者在面试、旧项目维护中看到有人在 set 去重之后再调用 sort 恢复顺序,它通常是这样写的:
items = ["香蕉", "苹果", "橙子", "香蕉", "葡萄", "苹果"]

# 先用 set 去重转成列表,再按原列表中的首次出现下标排序
unique_items = list(set(items))
unique_items.sort(key=items.index)

print("还原顺序后的结果:", unique_items)这段代码的原理是:items.index(x) 会从头扫描原列表 items,返回元素 x 第一次出现时的索引下标。unique_items.sort(key=items.index) 则以这个首次下标作为排序依据,把去重后的列表重新排回原来的先后次序。你也可以写成一行:sorted(set(items), key=items.index)。
sort(key=items.index) 看起来很直观,但只适合几百个元素以内的短列表。因为每次调用 items.index(x) 都要从头遍历一次原列表(耗时 $O(n)$),对去重后的所有元素都查一遍下标并排序,整体时间复杂度会退化到 $O(n^2)$ 级别。当列表长度达到数万条时,耗时可能是 dict.fromkeys() 的数百倍。因此日常开发中应优先使用 list(dict.fromkeys(items))。
四、进阶场景:不可哈希元素(如字典列表)与自定义规则去重
前面的 set() 和 dict.fromkeys() 都有一个前提:列表里的元素必须是可哈希(Hashable)的,比如整数、字符串、元组。如果列表里装的是字典(dict)或子列表(list),直接传给 set() 或 dict.fromkeys() 会立刻抛出 TypeError: unhashable type: 'dict'(或 'list')。
另外一种常见需求是:虽然元素本身是字符串或对象,但我们希望忽略大小写去重,或者根据字典里的某一个字段(例如用户 id)去重,同时保留首次出现的那条完整记录。这时可以用“辅助集合 seen + 循环判重”的通用模式。
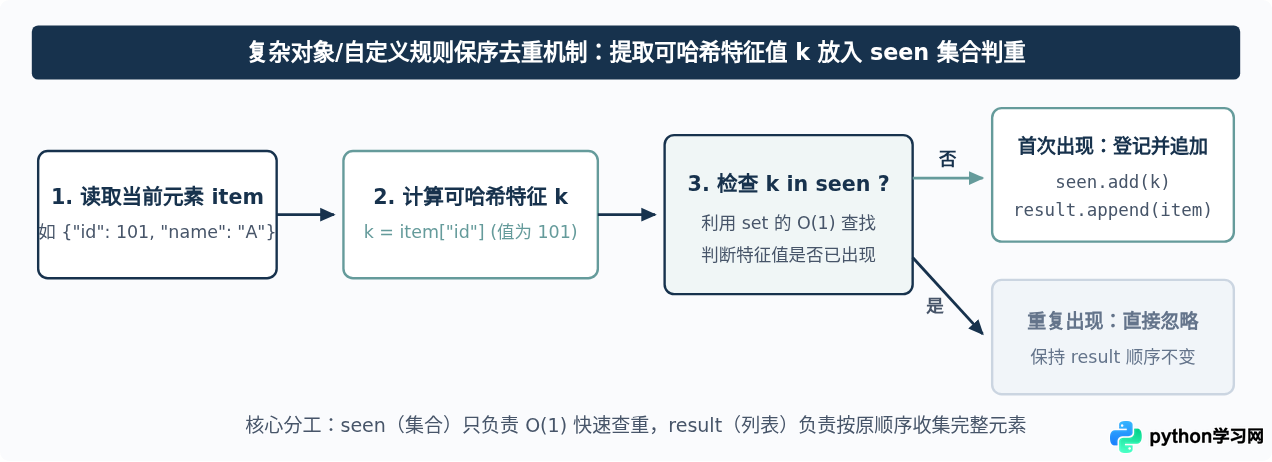
这个思路把“查重”和“保序存储”拆成两步:用一个辅助集合 seen = set() 专门记录已经出现过的可哈希特征值(利用集合 $O(1)$ 的查找速度),再用一个普通列表 result = [] 按遍历顺序收集首次出现的元素。我们可以把它封装成一个通用的保序去重函数:
def dedupe_keep_order(items, key=None):
    """
    保持原始顺序去重通用函数
    :param items: 待去重的可迭代对象
    :param key: 提取去重特征值的函数;若为 None 则直接以元素自身判重
    """
    seen = set()
    result = []
    for item in items:
        # 如果传入了 key 函数,则计算特征值;否则直接使用元素本身
        marker = item if key is None else key(item)
        if marker not in seen:
            seen.add(marker)
            result.append(item)
    return result

# 场景 1:字典列表按指定字段(如 id)去重,保留首次出现的完整字典
users = [
    {"id": 101, "name": "张三"},
    {"id": 102, "name": "李四"},
    {"id": 101, "name": "张三(重复录入)"},
    {"id": 103, "name": "王五"}
]
unique_users = dedupe_keep_order(users, key=lambda x: x["id"])
print("按 id 去重后的用户列表:")
for u in unique_users:
    print(" ", u)

# 场景 2:整个字典完全相同时去重(将字典键值对转为可哈希的 tuple)
raw_dicts = [{"a": 1, "b": 2}, {"a": 1, "b": 3}, {"a": 1, "b": 2}]
unique_dicts = dedupe_keep_order(raw_dicts, key=lambda d: tuple(sorted(d.items())))
print("完整字典去重结果:", unique_dicts){'id': 101, 'name': '张三'}
{'id': 102, 'name': '李四'}
{'id': 103, 'name': '王五'}
完整字典去重结果: [{'a': 1, 'b': 2}, {'a': 1, 'b': 3}]
五、如果重复时想保留“最后一次”出现的位置怎么办?
无论是 dict.fromkeys() 还是上面的 seen 循环,默认保留的都是重复元素第一次出现的位置。但在处理操作日志、配置覆盖或状态更新记录时,我们往往希望去掉前面旧的重复项,只保留元素最后一次出现的位置。
要实现这一点,只需将原列表反转(reversed(items))后再传入 dict.fromkeys(),最后把去重结果再反转回来即可:
items = ["首页", "商品页", "购物车", "商品页", "结算页"]

# 保留首次出现位置:["首页", "商品页", "购物车", "结算页"]
keep_first = list(dict.fromkeys(items))

# 保留最后一次出现位置:先反转去重,再反转还原
keep_last = list(reversed(dict.fromkeys(reversed(items))))

print("保留首次出现:    ", keep_first)
print("保留最后一次出现:", keep_last)保留最后一次出现: ['首页', '购物车', '商品页', '结算页']
reversed(),因此无需在中间多套一层 list(),直接写 list(reversed(dict.fromkeys(reversed(items)))) 即可。
六、常见注意点:布尔值与数字 1、0 的去重冲突
无论你使用 set、dict.fromkeys() 还是辅助集合 seen,只要列表里同时混有布尔值(True、False)和数字(1、0),去重时都会遇到一个容易忽略的现象:True 和 1 会被当成同一个元素,False 和 0 也会被合并。
这是因为在 Python 中,bool 是 int 的子类,True == 1 和 False == 0 均成立,且它们的哈希值也完全相等(hash(True) == hash(1))。当字典或集合判重时,后出现的那个就会被忽略:
mixed_items = [1, "a", True, 0, False, "a"]

# 默认去重:True 被当作 1 的重复项丢弃,False 被当作 0 的重复项丢弃
normal_dedupe = list(dict.fromkeys(mixed_items))

# 如果需要严格区分类型(1 和 True 都保留),可用 (type(x), x) 作为特征键
strict_dedupe = dedupe_keep_order(mixed_items, key=lambda x: (type(x), x))

print("默认去重结果:    ", normal_dedupe)
print("区分类型去重结果:", strict_dedupe)区分类型去重结果: [1, 'a', True, 0, False]
七、方法对比与选型总结
为了方便在实际编码时快速挑选最合适的方式,下表与总结图整理了四种保序去重方案的适用条件、复杂度与核心特点:
| 去重方法 | 时间复杂度 | 元素要求 | 推荐适用场景 |
|---|---|---|---|
list(dict.fromkeys(items)) |
$O(n)$ | 可哈希元素 | 日常首选:字符串、数字、元组列表保留首次顺序去重(Python 3.7+) |
dedupe_keep_order(items, key) |
$O(n)$ | 任意类型(通过 key 转可哈希) |
复杂数据首选:字典列表按字段去重、忽略大小写去重、严格区分 1 与 True |
list(reversed(dict.fromkeys(reversed(items)))) |
$O(n)$ | 可哈希元素 | 需要保留重复元素最后一次出现位置的场景(Python 3.8+) |
sorted(set(items), key=items.index) |
$O(n^2)$ | 可哈希元素 | 仅适合几十到几百项的极短列表,数据量大时不建议使用 |
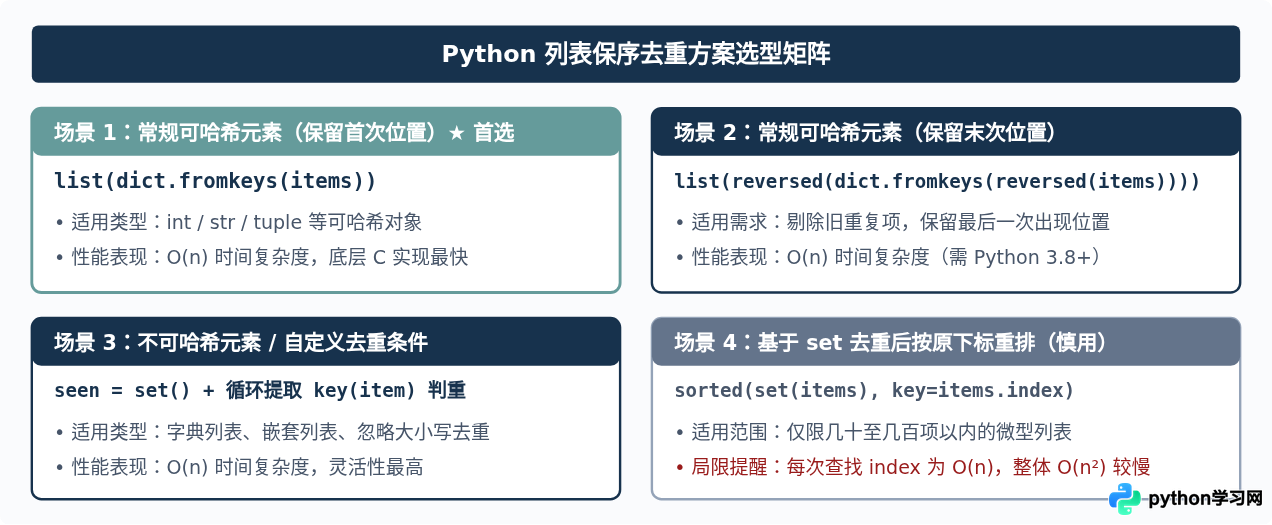
总结来说,日常处理普通列表去重且需要保持原有顺序时,直接将 list(set(items)) 替换为 list(dict.fromkeys(items)) 就能立刻解决问题;如果列表元素是字典或需要按特定属性判重,则使用辅助集合 seen 搭配 for 循环即可兼顾顺序与效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















