


Python解析XML报格式有误,怎么获取详细错误信息?
当Python解析XML仅提示“格式有误”时,往往是因为异常被笼统捕获。本文演示如何利用xml.etree.ElementTree的ParseError属性(如position和code)精确定位错误行号与列号,并通过打印上下文内容快速排查标签不匹配、引号缺失等语法问题,同时区分文件读取错误与解析错误,提升调试效率。
程序只提示“XML格式有误”,真正有用的信息可能被你的异常处理藏起来了。先不要逐行猜标签,应该保留解析器给出的错误类型、原因和位置,再回到原始输入检查。下面使用Python标准库xml.etree.ElementTree,示例已在Python 3.12.14核验,不需要额外安装XML解析包。
别把异常统一改成一句提示
如果代码用宽泛的except捕获所有问题,只打印“格式有误”,文件不存在、读取失败和XML语法错误都会看起来一样。先把解析失败单独捕获,才能知道该查文件还是查内容。
用一个明确有错的字符串复现:
import xml.etree.ElementTree as ET

xml_text = '<root>\n  <item>demo</root>'
try:
    ET.fromstring(xml_text)
except ET.ParseError as exc:
    print(type(exc).__name__)
    print(str(exc))
    print(exc.code)
    print(exc.position)
本例核验输出为:
ParseError
mismatched tag: line 2, column 14
7
(2, 14)
这里不是笼统的“内容不对”,而是标签不匹配。第二行打开了item,却直接关闭root。ParseError的文字说明、code和position是这一路径下可以读取的异常信息,换用其他解析库时应查看对应接口,不要假定属性名称完全相同。
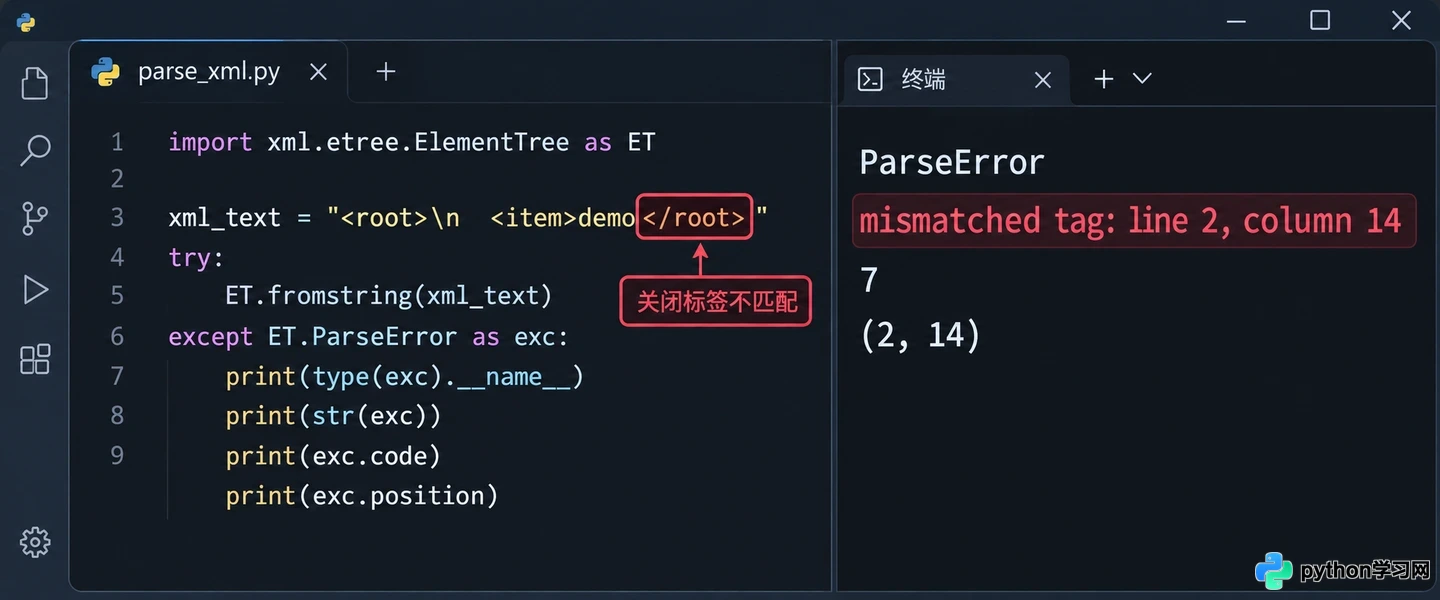
ParseError异常包含具体的错误描述、代码和行列位置
根据行号找附近内容,不只盯着光标
拿到位置后,可以把对应行打印出来:
try:
    ET.fromstring(xml_text)
except ET.ParseError as exc:
    line, column = exc.position
    lines = xml_text.splitlines()
    if 1 <= line <= len(lines):
        print(lines[line - 1])
        print(' ' * column + '^')
这个ASCII示例核验会在第二行附近显示定位箭头。行号按1开始,所以取Python列表时要减1;列位置用于这个简单示例的空格定位。真实文件若包含制表符、宽字符或不同显示方式,箭头只是辅助,应结合编辑器中的实际内容判断。
解析器报告的是发现问题的位置,不一定是最初写错的位置。比如漏了一个引号,后面的标签才触发错误,不能只修改报错列的那一个字符。向前检查成对标签、属性引号和特殊字符,通常比到处补闭合标签更有条理。
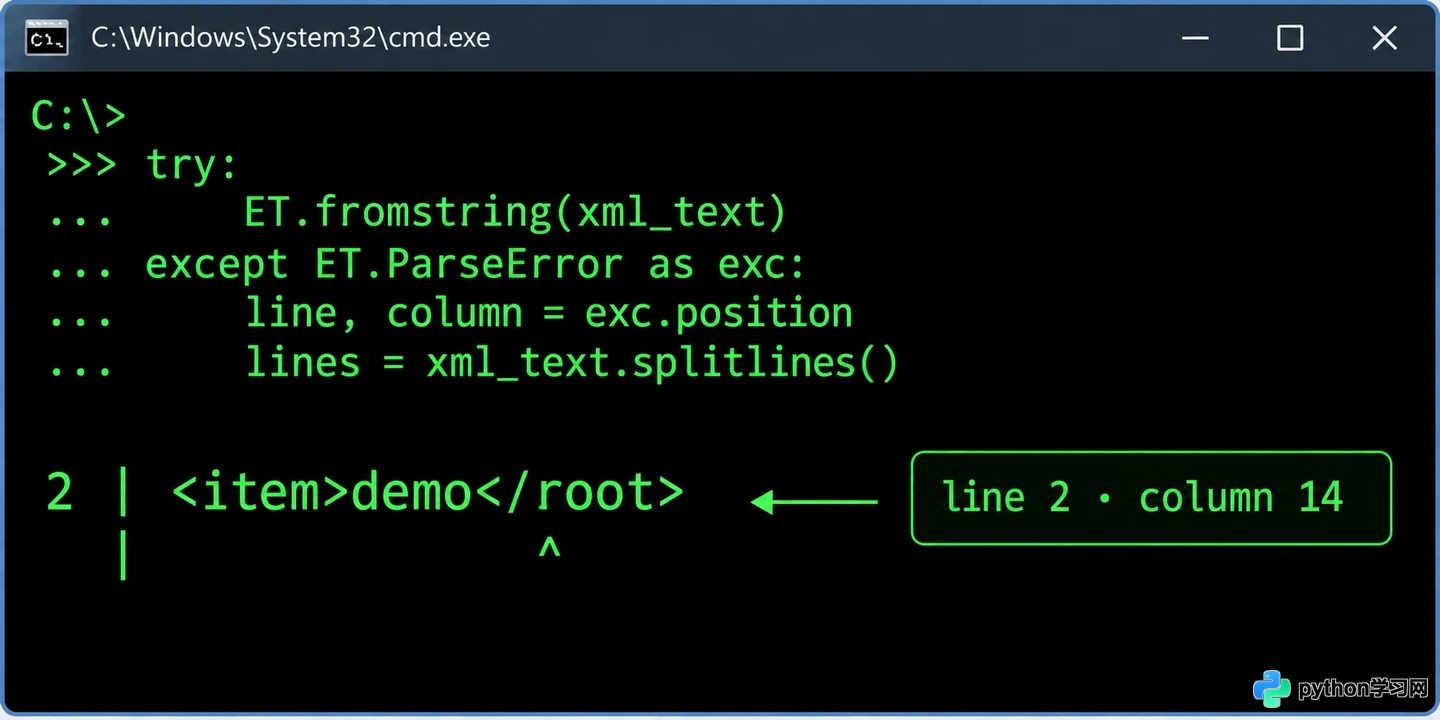
通过splitlines和列位置在终端中定位错误行
文件解析时,把读取问题与语法问题分开
对磁盘文件,可以使用ET.parse,让解析器读取原始文件:
from pathlib import Path
import xml.etree.ElementTree as ET

path = Path('sample.xml')
try:
    tree = ET.parse(path)
except ET.ParseError as exc:
    print('XML解析失败:', exc)
    print('错误位置:', exc.position)
except OSError as exc:
    print('文件读取失败:', exc)
将sample.xml替换为实际文件时,先确认运行目录和文件路径。这个文件分支是接口用法示例,未假装读取过读者电脑上的文件。不要为了显示内容,先用忽略解码错误的方式读成字符串,否则可能丢失关键字节,让排查对象发生变化。
若输入来自接口,也要先保存必要的原始响应信息并确认实际返回的是XML,而不是登录页或错误页面。日志只记录排查需要的部分,避免把令牌、完整客户数据或敏感字段直接打印出去。
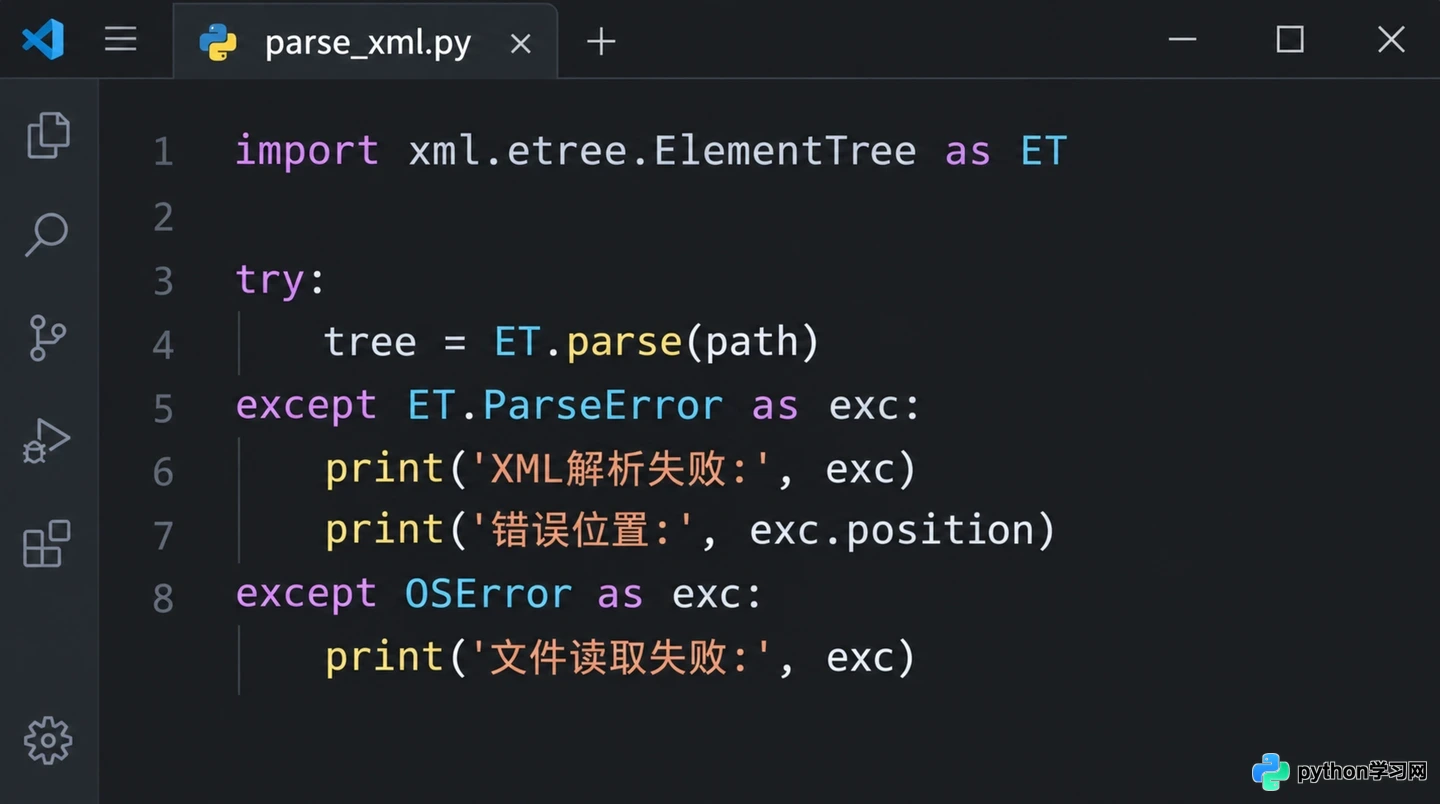
分别捕获OSError和ParseError以明确故障来源
修复后重新解析,成功不等于业务校验完成
把示例的标签补成正确结构:
fixed = '<root>\n  <item>demo</item>\n</root>'
root = ET.fromstring(fixed)
print(root.tag)
本例核验输出是root,说明修正后的内容能建立XML树。实际文件仍应继续检查要求的节点、字段和取值是否存在。语法通过不代表它符合某个系统的数据规范,也不代表内容可信。
保留原输入、原始错误和修复版本,每次只处理有依据的问题,再重新运行解析。先拿到详细异常,按位置回看上下文,最后分开验证语法与业务规则,就不必围着一句“格式有误”反复猜测。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















