


怎么使用Python print的file参数将输出直接写入文件
详细讲解如何使用Python print函数的file参数将输出重定向并写入文件。包含基础步骤、工作原理、模式选择、即时刷新及常见问题辨析。
print() 函数不仅能把文本显示在终端窗口中,还提供了一个专用的 file 参数用于改变输出目标。默认情况下,file 参数指向系统的标准输出流(sys.stdout)。只要将其指定为一个已经以写入模式(如 'w' 或 'a')打开的文件对象,print() 就会自动将内容转换并写入目标文件中。这种方法自带数据类型转换、分隔符配置与行末自动换行,为程序运行结果记录与快速日志落地提供了极其方便的途径。
一、标准操作步骤:配合 with open 语句写入文件
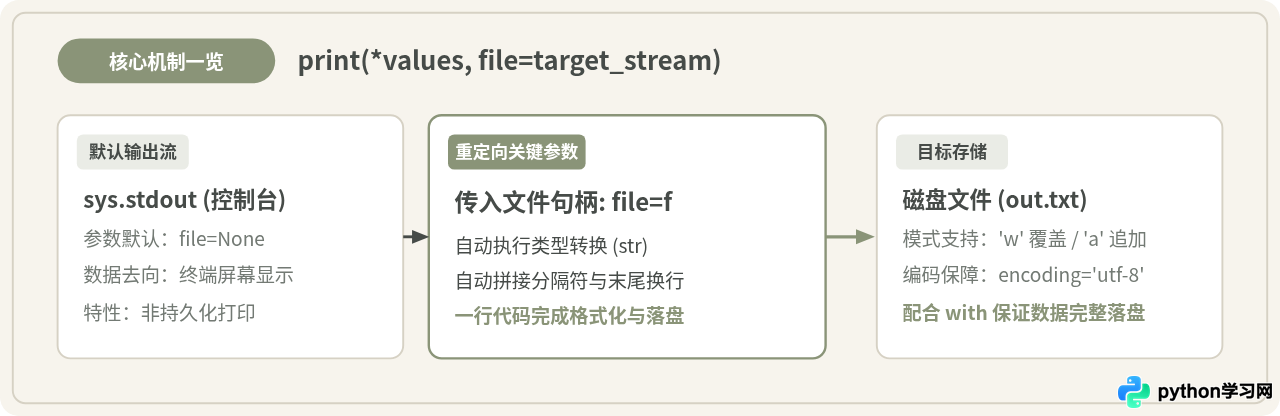
将 print() 的输出写入文件,最安全、标准的做法是配合 with open() 上下文管理器。通过 with 语句打开文件,能确保在代码块执行结束时,操作系统底层的文件句柄能够被及时关闭,内存缓冲区里的所有数据也都能完整刷入磁盘。
完成一次文件输出需要遵循以下三个标准步骤:
- 以写入模式打开文件:调用
open()函数并指定支持写入的模式(例如'w'表示覆盖写,'a'表示追加写),同时显式声明字符编码encoding='utf-8',获得一个有效的文件对象。 - 传递文件对象至 print:在调用
print()时,将该文件对象赋值给关键字参数file,例如file=f。 - 退出上下文自动释放:离开
with缩进代码块,Python 会自动调用文件对象的析构与关闭方法,完成数据持久化。
# step1_print_to_file.py
# 第一步:以写入模式打开文件,取得文件对象 f
with open("system_report.txt", "w", encoding="utf-8") as f:
    # 第二步:将输出重定向至文件句柄 f
    print("=== 系统自检报告 ===", file=f)
    print("服务状态:", "ONLINE", "耗时(ms):", 24, file=f)
    print("CPU使用率:", 32.5, "%", file=f)

# 第三步:退出 with 代码块后,文件自动关闭并落盘
print("写入任务已完成,控制台仅显示本条消息。")服务状态: ONLINE 耗时(ms): 24
CPU使用率: 32.5 %
在上述代码执行过程中,终端窗口仅会打印最后一条说明文字,前面三行带有 file=f 的自检信息则全部直接进入了 system_report.txt 文件。
二、核心机制解析:从 sys.stdout 到文件流对象
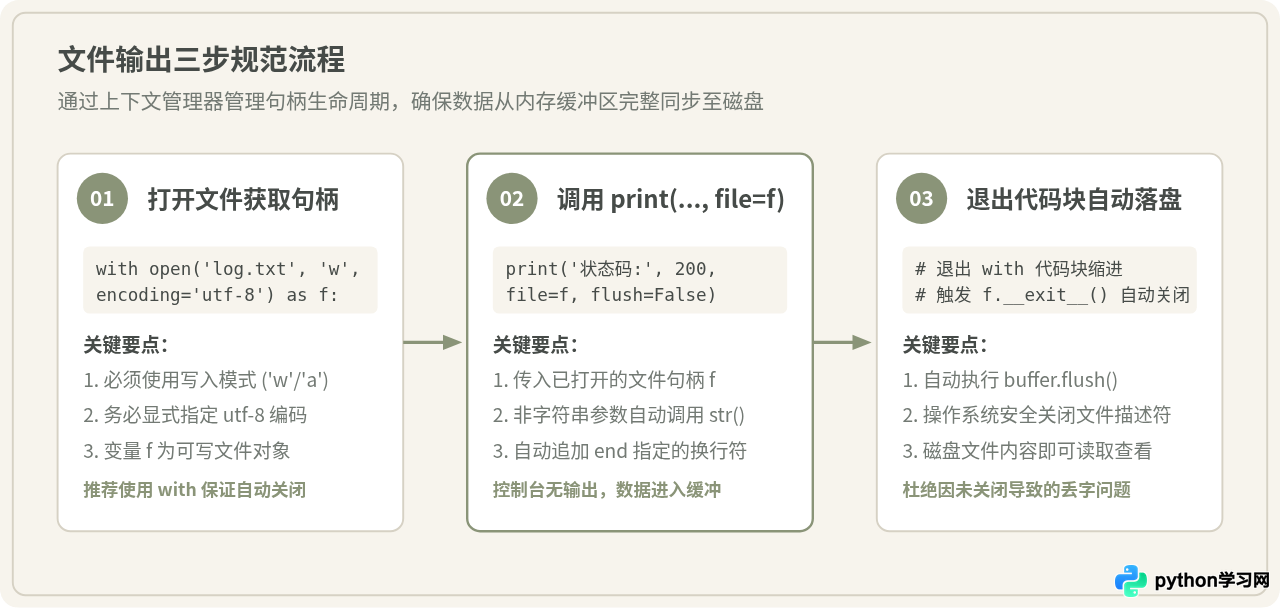
为了准确理解 print() 为什么可以直接写文件,需要了解其内部的函数定义。在 Python 官方文档中,print() 的完整函数签名如下:
print(*values, sep=' ', end='\n', file=None, flush=False)
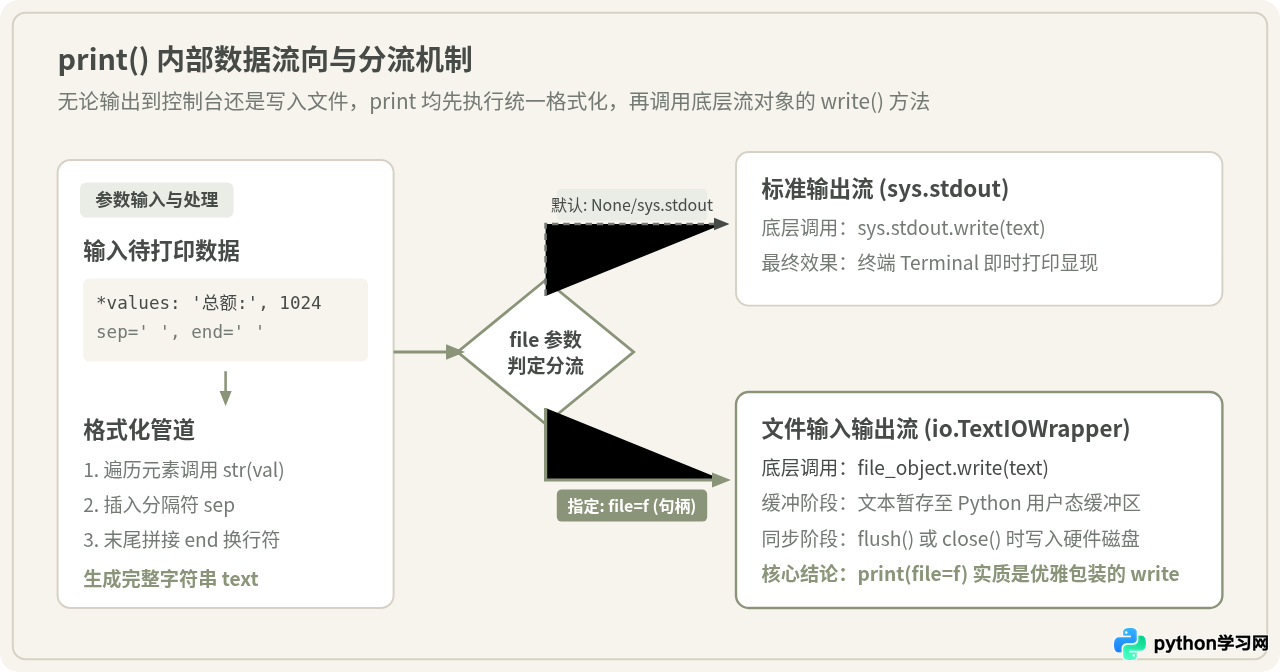
当 file 取默认值 None 时,函数内部会自动将其重设为 sys.stdout(标准输出流)。其底层的工作流程是:
- 首先,
print()将接收到的所有位置参数*values依次调用内置的str()函数转化为字符串; - 接着,在相邻参数转换得到的字符串之间插入
sep指定的内容(默认为单个空格' '); - 然后,在整行末尾拼接
end指定的结尾符(默认为换行符'\n'),拼成一个最终的文本块; - 最后,
print()调用file.write(text)方法将拼接好的文本发送给流对象。
在 Python 的面向对象设计中,这是典型的“鸭子类型”(Duck Typing)。print() 的 file 形参并不要求传入的对象必须是物理文件,它只要求该对象拥有一个接收字符串的 write() 方法。当把 with open() 返回的文本流对象(io.TextIOWrapper)赋给 file 时,print() 就自然而然地把数据推送到了该文件的写入通道中。
三、模式控制与缓冲刷新:覆盖写、追加写与 flush 参数
在实际编写脚本时,合理选择文件的打开模式并理解数据缓冲机制,是避免数据丢失或程序行为不符合预期的关键。
1. 覆盖模式 'w' 与追加模式 'a' 的选择依据
print() 本身并不维护文件的打开状态或光标位置,具体的写入策略完全由 open() 的模式参数决定:
- 模式
'w'(Write):如果目标文件已存在,打开瞬间文件长度会被截断为 0 字节,旧内容被清空;若文件不存在则新建。适合每次运行生成全新报告、重写全量快照数据的场景。 - 模式
'a'(Append):如果文件已存在,原内容被完整保留,文件写入指针被强制定位在文件末尾;若文件不存在同样新建。适合持续记录运行流水、追加事件日志等场景。
# step2_append_log.py
import datetime

now_str = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")

# 使用 'a' 模式追加记录
with open("app_events.log", "a", encoding="utf-8") as log_file:
    print(f"[{now_str}] INFO: 用户登录成功, UID=10042", file=log_file)
2. 缓冲区机制与 flush=True 的适用时机
操作系统和 Python 运行时为了优化磁盘 I/O 效率,并不会在每次调用 write() 时立刻向物理磁盘驱动器发送写操作,而是先将文本暂存在内存的 I/O 缓冲区(Buffer)中。通常只有当缓冲区积满、代码显式执行 flush()、或者文件正常关闭时,数据才会真正刷入物理磁盘。
这解释了一个常见的现象:在一个长耗时的 for 循环中,虽然循环体每秒都在执行 print(..., file=f),但外部打开文件查看时可能长时间显示大小为 0 字节,直到脚本彻底跑完才突然出现全部内容。
若需要实时观察输出(例如在终端使用 tail -f 跟踪写入进度,或关键任务需要在崩溃前立刻保存现场),应当将 print() 的 flush 参数显式设为 True:
import time

with open("task_progress.log", "a", encoding="utf-8") as f:
    for step in range(1, 4):
        # 开启 flush=True,强制立即将单行输出刷入磁盘文件
        print(f"正在执行批处理阶段 {step}/3...", file=f, flush=True)
        time.sleep(2)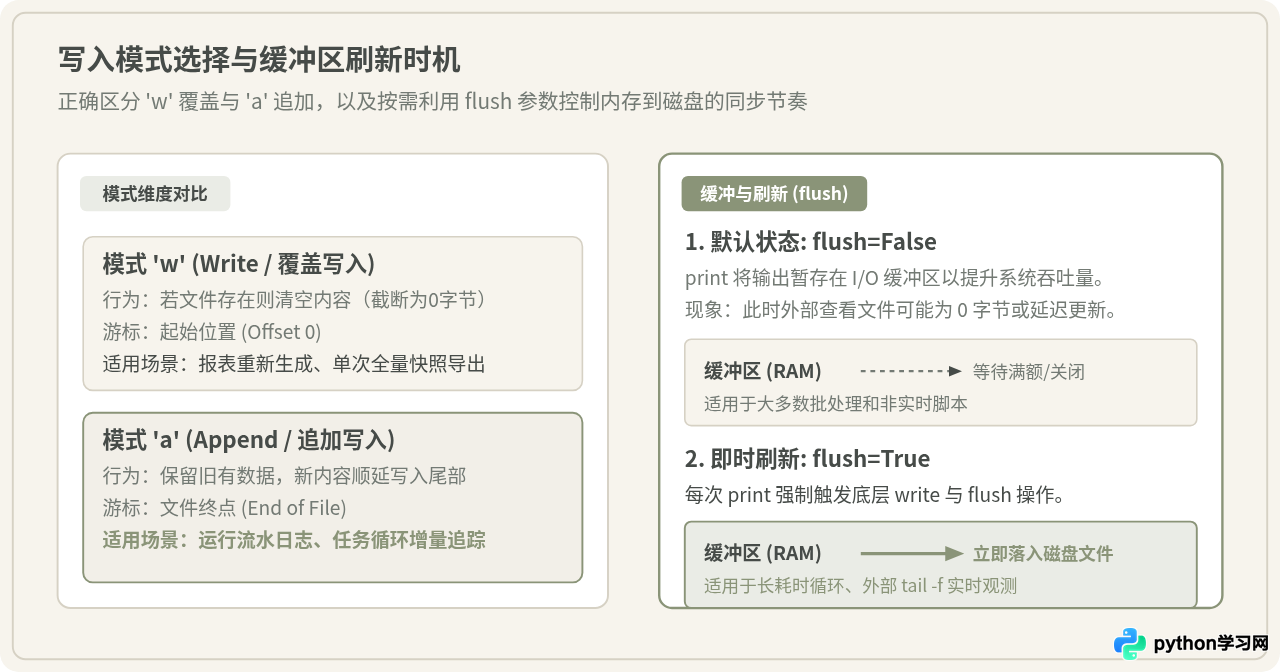
四、容易混淆的说法辨析:print(file=f) 与 file.write() 的适用边界
在技术交流中,常有一种说法:“print(file=f) 只是初学者在控制台写玩具代码的快捷方式,正规项目里写入文件必须全部使用 f.write()。”
这种说法看似有理,但并不全面。它成立的前提是极高吞吐量的高频密集 I/O 场景;而在绝大部分日常开发、数据分析与自动化脚本中,print(..., file=f) 不仅完全合规,而且具有更高的代码可读性与维护效率。
我们可以通过两者的行为差异来看清它们的适用边界:
- 自动类型转换:
f.write()极为严苛,它只接受单个字符串参数。如果传入整数、浮点数或列表(如f.write(100)),会直接抛出TypeError: write() argument must be str, not int。而print()能接受任意数量、任意类型的变量,并在内部自动处理类型转化。 - 换行与分隔符拼接:使用
f.write()时,必须手动在每个变量之间拼接空格,并在尾部显式追加\n(如f.write(f"count: {count}\n"))。若漏写\n,所有内容将挤在同一行。而print()默认具备sep=' '与end='\n',逻辑更清晰。
- 优先使用
print(..., file=f):当需要输出包含多种数据类型的信息、导出带有行列分隔符的文本表格、编写命令行调试脚本转存日志,或者希望代码保持极简结构时。 - 优先使用
f.write()或f.writelines():当已经拥有预格式化好的大块长文本、需要频繁写入数以百万计的细粒度数据行,或者追求极限的系统调用性能开销时。
五、常见报错与易踩误区排查
使用 print() 的 file 参数虽然非常简单,但初学者在脱离模板独立编写时,容易遇到以下几类典型报错:
1. 误将文件名字符串直接传给 file 参数
# 错误写法示例:
print("任务开始", file="output.log")
# 抛出报错:
# AttributeError: 'str' object has no attribute 'write'
原因排查:file 参数接收的是一个具有写入功能的文件对象,而不是文件路径字符串。字符串类型 str 并没有定义 write 方法,因此 Python 在尝试调用时会立刻报错。必须先通过 open("output.log", "w") 建立文件对象后,再将其传给 file。
2. 文件以只读模式 'r' 打开并试图写入
# 错误写法示例:
with open("config.txt", "r", encoding="utf-8") as f:
    print("新增配置", file=f)
# 抛出报错:
# io.UnsupportedOperation: not writable
原因排查:open() 默认模式是只读模式 'r'。只读文件句柄禁止任何写入行为。请确保将打开模式指定为 'w'、'a'、'w+' 或 'a+'。
3. 未使用 with 语句且未手动 close 导致丢数据
如果使用形如 f = open("log.txt", "w") 的传统写法,并在循环之后忘记调用 f.close(),当程序意外终止或遭遇异常退出时,残留在内存缓冲区中的末尾数据往往来不及刷入硬盘,从而导致文件末尾截断甚至生成空文件。最佳实践是永远使用 with open(...) 管理文件生命周期。
4. 忽略编码声明引发 Windows 环境乱码或报错
在 Linux 与 macOS 上,默认文本编码通常为 UTF-8;而在部分中文 Windows 环境中,系统默认编码可能是 GBK / CP936。如果未在 open() 中显式指定 encoding='utf-8',当尝试打印特殊字符或多国语言文字时,可能引发 UnicodeEncodeError: 'gbk' codec can't encode character...。在打开文件时始终添加 encoding="utf-8" 能够确保跨平台一致性。
六、全文总结与选型速查
利用 print() 的 file 参数写入文件,是 Python 简洁优雅设计哲学的典型体现。它巧妙地将内置格式化引擎与底层流式 I/O 结合在一起,免除了繁重的前置类型转换与换行拼接。
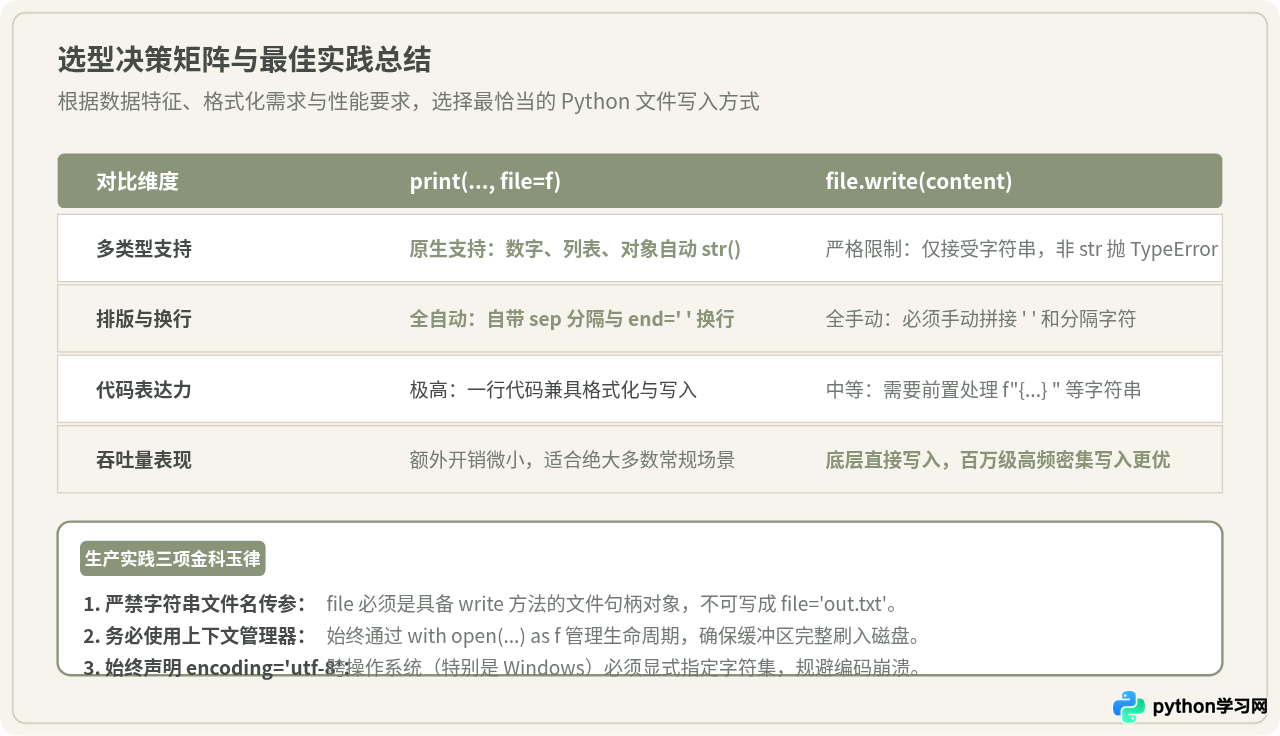
在日常开发中,只要牢记“先用 with open(..., 'w'/'a', encoding='utf-8') as f 获取句柄,再通过 print(..., file=f) 输出,实时性要求高时追加 flush=True”这一核心范式,便能安全、高效地解决绝大多数输出持久化需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















