


Python爬虫能抓取哪些类型的数据:文本、图片与API接口
深入解析Python爬虫能抓取的三大核心数据载体:HTML文本、图片与二进制媒体资源,以及结构化API接口数据。包含工作原理、抓取流程、完整代码示例与常见避坑指南。
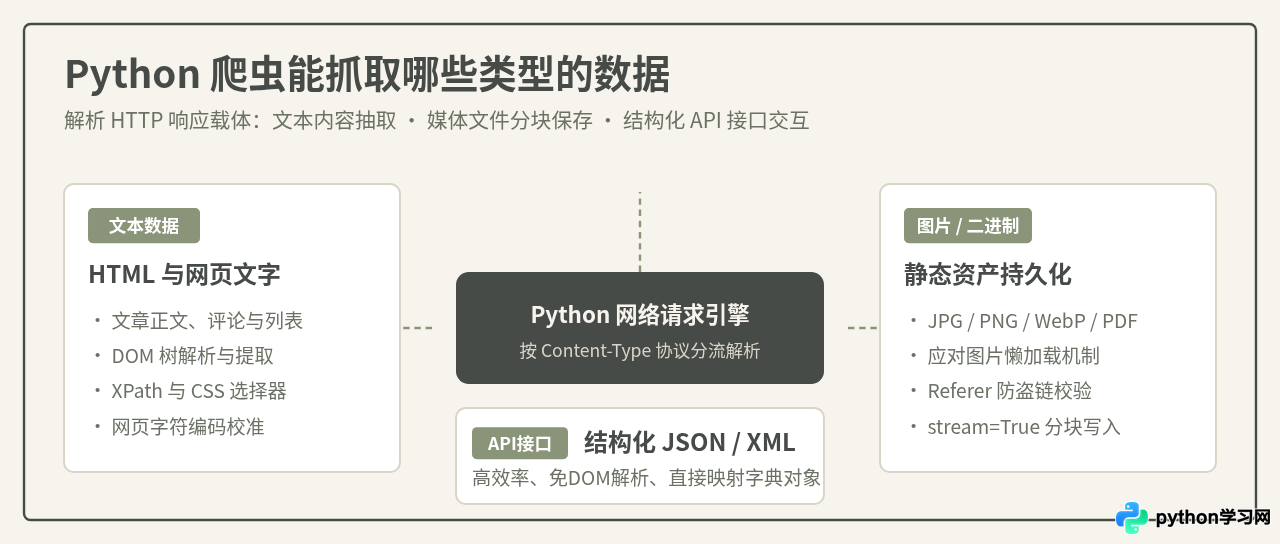
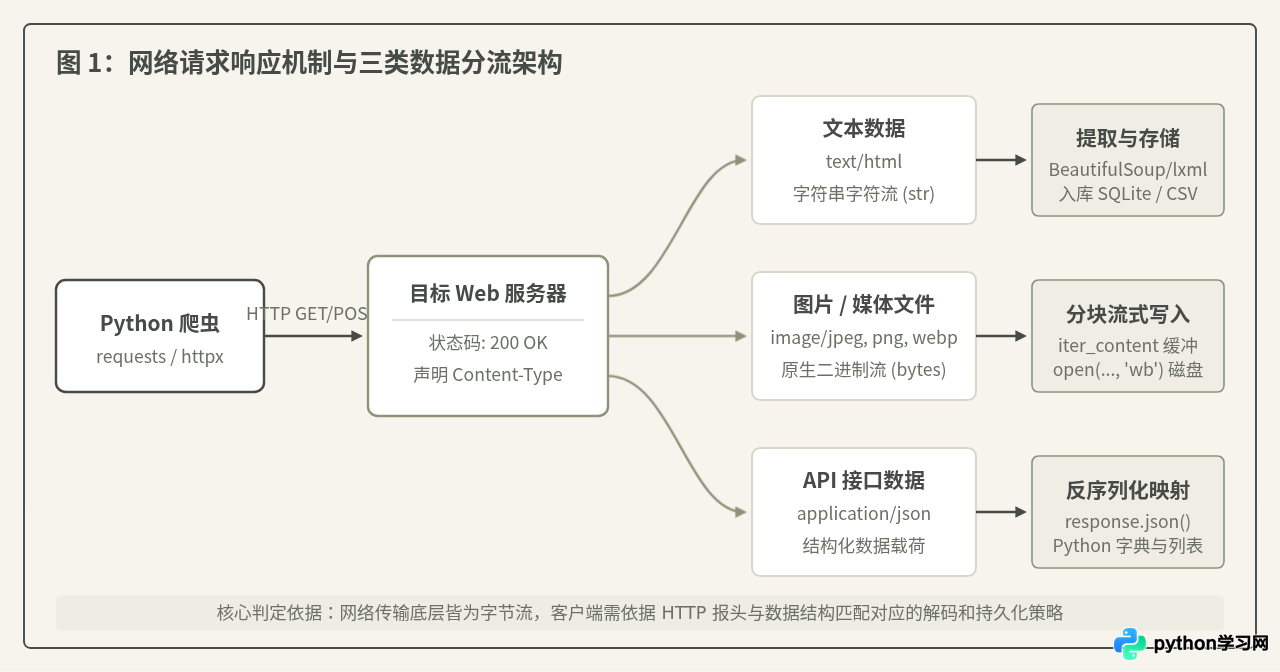
Content-Type 声明以及服务端的数据组织模式,爬虫主要抓取并处理三类核心资产:网页文本数据、图片等二进制媒体资源,以及直接提供结构化报文的API接口。理解这三类数据的差异与解析路径,能够帮助开发者在面对不同爬取需求时,准确选用最精简高效的抓取策略。
一、文本数据:HTML页面源码中的字符抽取
文本数据是网络爬虫最常见、最基础的抓取对象。新闻媒体的文章正文、技术社区的问答列表、电商平台的商品标题与规格参数,大多通过HTML文档的形式呈现给用户。
1. 抓取与解析机制
当我们向网页地址发送HTTP GET请求时,Web服务器通常会返回带有 Content-Type: text/html 的响应。此时响应体本质是一段符合XML/HTML规范的长字符串。Python爬虫通过DOM(文档对象模型)解析引擎将这段字符串解析为一棵具有父子、兄弟关系的节点树,再借助 CSS选择器 或 XPath路径表达式 定位到目标标签,最终提取出其中的纯文本。
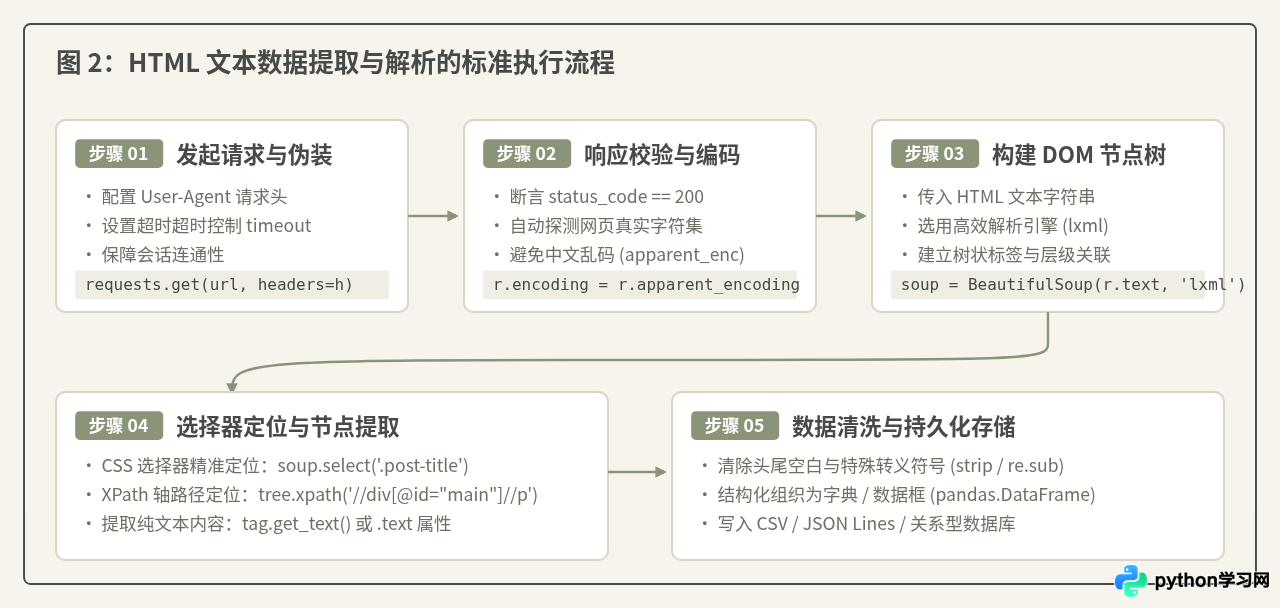
import requests
from bs4 import BeautifulSoup

url = "https://example.com/article/101"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    response.raise_for_status()

    # 校准网页编码,防止中文出现乱码
    response.encoding = response.apparent_encoding

    # 使用 lxml 解析器构建 DOM 树
    soup = BeautifulSoup(response.text, "lxml")

    # 定位标题与段落元素
    title_node = soup.select_one("h1.post-title")
    article_title = title_node.get_text(strip=True) if title_node else "无标题"

    paragraph_nodes = soup.select("div.article-content p")
    paragraphs = [p.get_text(strip=True) for p in paragraph_nodes if p.get_text(strip=True)]

    print("文章标题:", article_title)
    print("提取段落数量:", len(paragraphs))
except requests.exceptions.RequestException as exc:
    print(f"请求失败: {exc}")
这种说法在传统静态页面时代是成立的,但在现代前端开发中往往需要修正。许多网站采用单页应用(SPA)框架或异步延迟加载技术,浏览器初次请求HTML时,返回的源码仅是一个空的结构骨架(如 <div id="app"></div>),真正的文字是页面加载后由JavaScript异步向后端接口请求并渲染出来的。如果仅用 requests.get() 抓取初始网页源码,将无法提取到任何文字。此时应转而抓取其底层的API接口,或者使用无头浏览器(如Playwright)。
二、图片与二进制数据:媒体资产的流式下载
除了文字,互联网上沉淀了巨量的非字符型静态资产,包括商品主图、摄影相片、PDF电子书、音频片段以及短视频等。这些资源在网络传输中均以原始二进制(Raw Bytes)形式存在。
1. 二阶段抓取机制
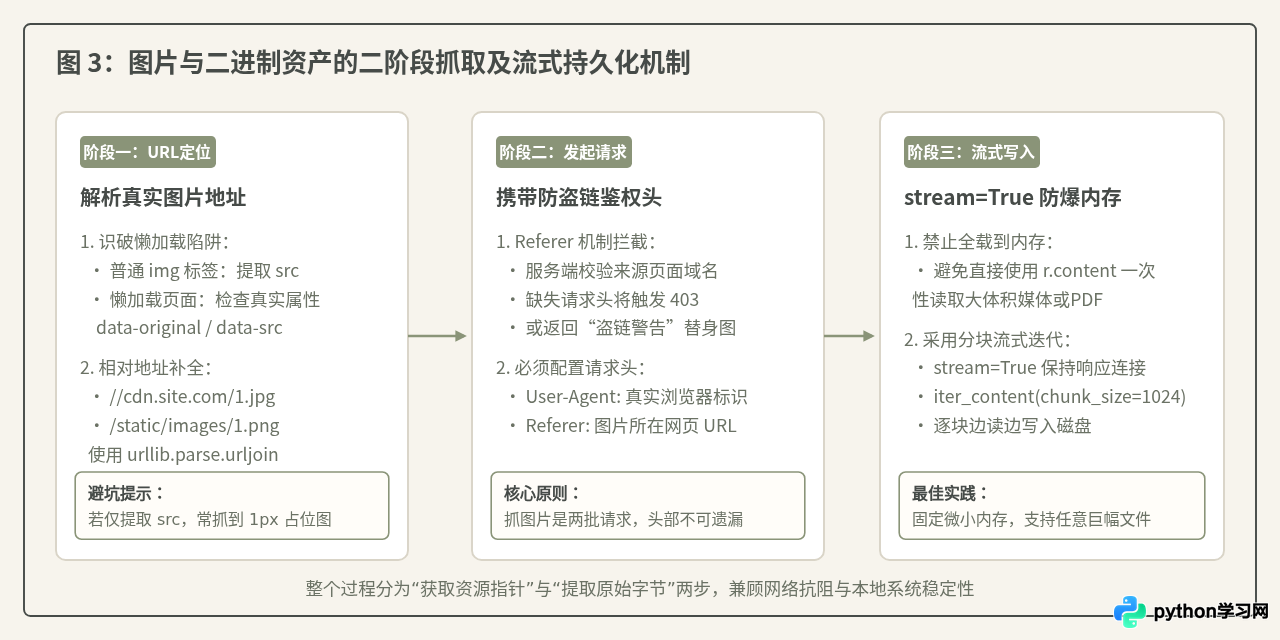
在实际编写爬虫时,经常有初学者产生“一次请求同时把网页和图片一起爬下来”的误解。实际上,图片抓取必然经历两个相互独立的网络阶段:
- 第一阶段(地址解析):先请求包含图片引用的HTML页面,在DOM树中解析出
<img>标签的资源地址。特别需要注意处理以//或/开头的相对路径,使用urllib.parse.urljoin转换为完整的绝对URL。 - 第二阶段(二进制下载):针对每个图片URL单独发起HTTP请求,将服务器返回的媒体字节流直接以二进制写入模式(
wb)保存至本地磁盘文件。
2. 防盗链与内存保护
在下载图片时,有两个极为关键的工程细节:
- Referer 防盗链校验:大部分图床或CDN服务器会检查请求头中的
Referer字段。如果缺少该字段或来源域名不匹配,服务器会直接返回 403 Forbidden 或一张印有“请勿盗链”的警告图。 - 使用 stream=True 流式传输:对于体积较大的图片、高清壁纸或PDF文档,切忌使用
response.content将全部字节一次性读入Python内存。启用stream=True并配合iter_content()逐块写入磁盘,能将瞬时内存控制在几KB以内,彻底杜绝内存溢出。
import os
import requests

image_url = "https://images.example.com/uploads/photo_2026.jpg"
page_referer = "https://example.com/gallery/nature"
output_dir = "./downloads"
os.makedirs(output_dir, exist_ok=True)
save_path = os.path.join(output_dir, "photo_2026.jpg")

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Referer": page_referer  # 必须附带来源页,绕过防盗链机制
}

try:
    # 开启 stream=True,避免立即将整个文件下载到内存
    with requests.get(image_url, headers=headers, stream=True, timeout=15) as response:
        response.raise_for_status()

        # 验证服务器返回确实为图片类型
        content_type = response.headers.get("Content-Type", "")
        if "image" not in content_type and "octet-stream" not in content_type:
            raise ValueError(f"预期图片类型,实际返回: {content_type}")

        # 以 4KB 为缓冲区逐块写入本地文件
        with open(save_path, "wb") as f:
            for chunk in response.iter_content(chunk_size=4096):
                if chunk:  # 过滤保持连接的心跳包
                    f.write(chunk)

    print(f"图片下载成功,已安全持久化至: {save_path}")
except Exception as exc:
    print(f"下载失败: {exc}")
现代网页为了减少首屏网络流量,广泛采用“图片懒加载”(Lazy Load)策略。在初始HTML源码中,<img> 标签的 src 属性往往只放了一个微小的加载占位图,而真正的高清图片URL被存放在如 data-original、data-src 或 data-actualsrc 等自定义属性中。在编写XPath或CSS选择器时,务必先在浏览器开发者工具中观察元素加载前后的属性变化,提取真正存放媒体URL的属性。
三、API接口数据:高效率的结构化JSON抓取
随着前后端分离架构(BFF / RESTful / GraphQL)的普及,网页前端越来越倾向于只负责展示布局,所有核心数据均通过异步请求从后端API拉取。对爬虫而言,能够直接抓取API接口往往是最高效的途径。
1. 为什么优先抓取 API 接口
相比于从臃肿的HTML标签丛林中解析字符,抓取API接口具有显著优势:
- 传输开销极小:API接口通常返回
Content-Type: application/json,不夹杂任何网页样式、布局标签和冗余脚本,带宽消耗仅为完整HTML的几十分之一。 - 结构化直接映射:通过调用
response.json(),Python会直接将JSON字符串反序列化为原生的字典(dict)与列表(list),开发者可直接通过键值访问字段,无需担心前端改版调整标签层级导致的DOM定位失效。 - 支持精细化分页:API通常通过URL参数(如
?page=2&limit=20)进行翻页,爬虫只需在循环中改变参数数值即可连续采集。
import requests

api_url = "https://api.example.com/v1/articles"
params = {
    "category": "python",
    "page": 1,
    "limit": 20
}
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "application/json, text/plain, */*",
    "Authorization": "Bearer your_session_token_if_needed"
}

try:
    response = requests.get(api_url, params=params, headers=headers, timeout=10)
    response.raise_for_status()

    # 直接反序列化为 Python 原生字典对象
    data = response.json()
    articles = data.get("data", {}).get("items", [])

    print(f"成功获取 {len(articles)} 条结构化记录:")
    for item in articles[:3]:
        item_id = item.get("id")
        title = item.get("title")
        view_count = item.get("view_count", 0)
        print(f" - [ID: {item_id}] {title} (浏览量: {view_count})")
except requests.exceptions.JSONDecodeError:
    print("响应并非有效 JSON 格式,请检查接口是否被重定向至验证码拦截页")
except requests.exceptions.RequestException as exc:
print(f"接口请求失败: {exc}")抓取API接口在“数据解析”环节确实更简单,但在“反爬阻拦”环节往往防守更严密。服务端针对API接口普遍部署了更严格的鉴权机制,例如必须携带动态Token、请求签名(Signature)、时间戳校验(Timestamp)或对请求载荷进行AES/RSA加密。初学者在寻找API接口时,应熟练运用浏览器F12中的 Network(网络)-> Fetch/XHR 过滤器,观察请求头与Query参数中是否存在防重放或加密标记。
四、三类数据的核心差异与工程选型矩阵
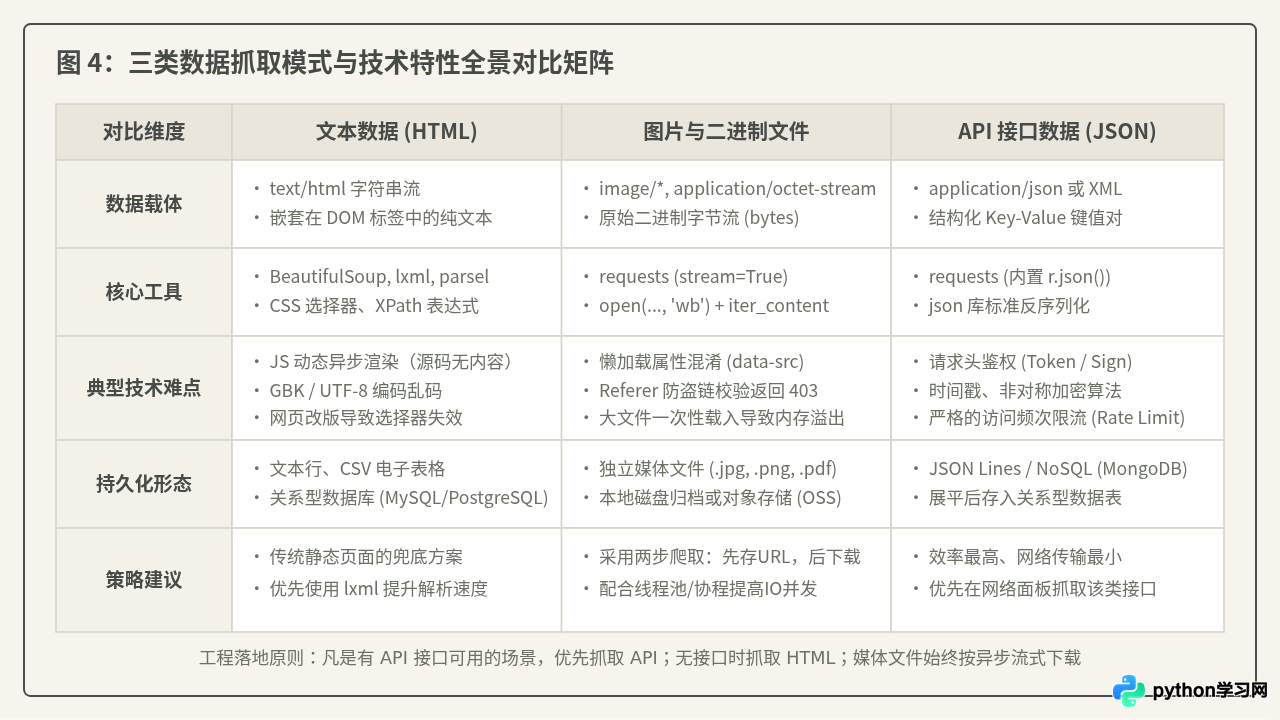
为了在不同业务场景中快速做出技术决断,下表从数据载体、处理工具、技术难点、存储方式和策略优先级五个维度,对文本、图片与API接口的抓取方案进行了系统性归纳:
工程实践选型建议
- 第一优先级(寻找接口):在着手编写爬虫前,首要任务是在浏览器的网络面板中过滤 XHR/Fetch 请求。若目标数据有现成的 JSON 接口暴露,应放弃抓取 HTML,直接模拟调用接口,这是开发成本最低、抓取速度最快、维护最稳固的路线。
- 第二优先级(解析静态源码):如果数据由服务端直接渲染且无公开 API,采用 requests 配合 lxml/BeautifulSoup 进行 DOM 抽取,注意统一字符编码并对缺失字段做异常捕获兜底。
- 媒体数据分步走:图片、视频与文档抓取必须拆解为“先收集 URL,后批量异步或分块持久化”,始终保持
stream=True和规范的Referer来源声明。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















