


Python数据分析新手入门:Pandas与NumPy核心库使用指南
面向Python数据分析初学者的NumPy与Pandas实战指南。系统梳理两者在数据结构、底层内存机制、向量化与广播计算、数据清洗与索引切片上的核心差异与配合方式,提供可直接运行的代码示例与避坑说明。
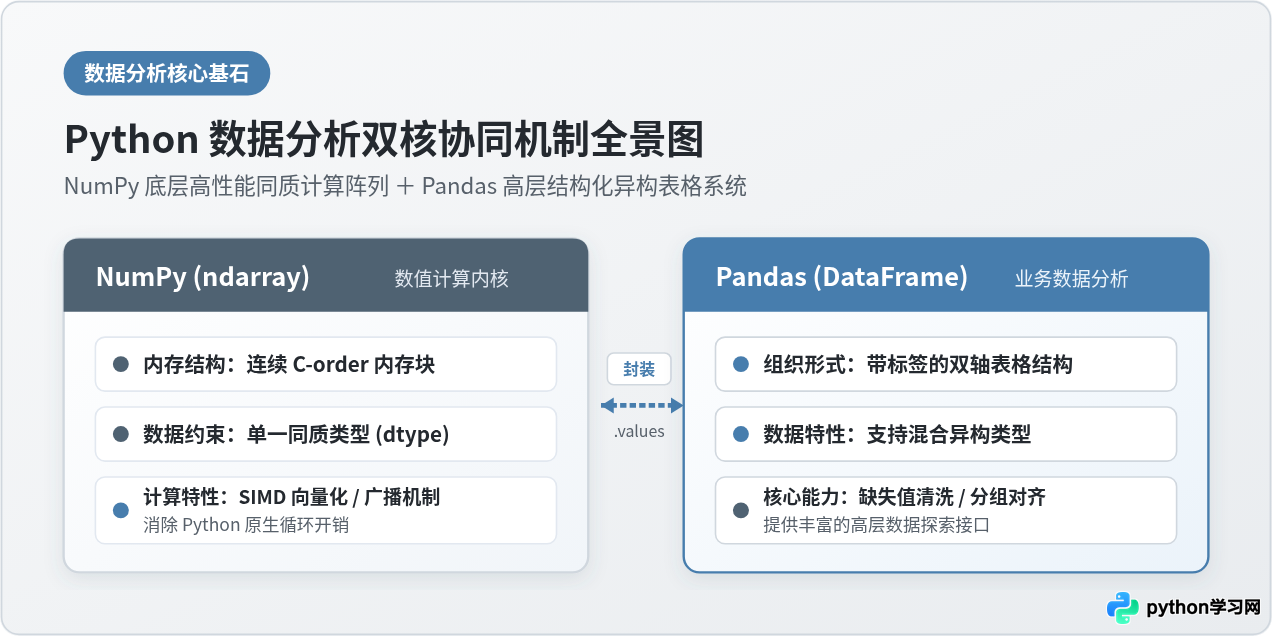
掌握 Python 数据分析的核心路径在于理解分工:NumPy 负责底层高效率的同质数值矩阵运算,而 Pandas 则在其基础之上构建了带有显式行列标签的结构化表格系统。本文直接拆解 NumPy 的多维数组运算与 Pandas 的表格处理逻辑,通过统一的数据案例与可复现代码,帮助读者厘清数据结构差异、高频操作模式以及真实清洗流程中的典型注意事项。
一、核心对象与底层架构:ndarray 与 DataFrame 的本质区别
在 Python 原生环境中,列表(list)是一个可以存储任意对象的指针容器。当对含有数十万元素的列表求和时,解释器需要逐个解包指针、检查类型并进行动态调用,这导致了显著的内存浪费和运行耗时。NumPy 与 Pandas 正是为了解决这一性能瓶颈而诞生,但它们两者的设计定位截然不同。
NumPy 的基本数据单元是 ndarray(N-dimensional Array,N维数组)。在底层,它在 C 语言层面申请一块连续的物理内存,所有元素必须为同一种数据类型(例如全部为 64 位浮点数 np.float64)。这种紧凑的同质布局让 CPU 可以直接进行步长寻址,并利用 SIMD 硬件指令集进行批量并行加速。
Pandas 则封装并扩展了 NumPy 的计算能力,提供了更贴近业务现实的两个核心对象:一维的 Series 和二维的 DataFrame。真实业务数据往往包含混合类型(如一列是商品名称字符串、一列是成交价格浮点数、一列是用户 ID 整数)。Pandas 的底层由分块管理器(BlockManager)组织,内部根据列的数据类型分别维护多个 NumPy 数组,同时对外暴露统一的行索引(Index)与列标签(Columns)。
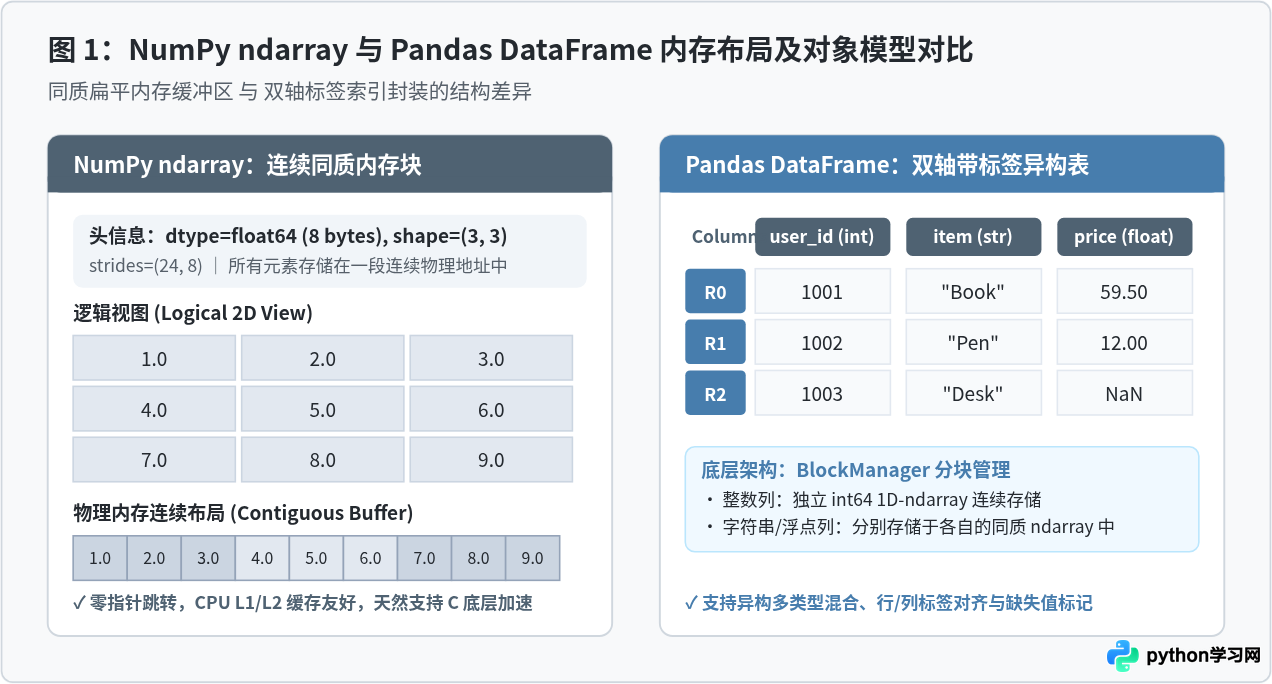
理解两者结构差异最直接的办法,是通过代码观察它们的创建方式与内部类型属性:
import numpy as np
import pandas as pd

# 1. 创建 NumPy 2x3 二维矩阵(单一 float64 类型)
arr = np.array([[10.5, 20.2, 30.8], [40.1, 50.6, 60.3]], dtype=np.float64)
print("NumPy 数组形状与类型:")
print("Shape:", arr.shape, "Dtype:", arr.dtype)

# 2. 创建 Pandas DataFrame(包含整数、文本与浮点异构列)
data = {
    "user_id": [1001, 1002, 1003],
    "city": ["Beijing", "Shanghai", "Shenzhen"],
    "spend": [128.50, 256.00, 89.20]
}
df = pd.DataFrame(data, index=["U1", "U2", "U3"])
print("
Pandas 每列数据类型:")
print(df.dtypes)二、NumPy 核心机制:向量化计算与广播规则
新手编写 Python 代码最常见的习惯是使用 for 循环逐个遍历元素求和或缩放。在 NumPy 中,这种写法会彻底破坏底层的 C 加速优势。NumPy 倡导“向量化运算”(Vectorization),即直接在整个数组级别施加算术运算符,由底层 C 库在内存中一气呵成。
与向量化形影不离的是“广播机制”(Broadcasting)。当参与运算的两个数组形状(shape)不完全相同时,NumPy 会自动根据特定规则将较小的数组在逻辑上沿特定轴延展,而无需产生物理内存的冗余复制。
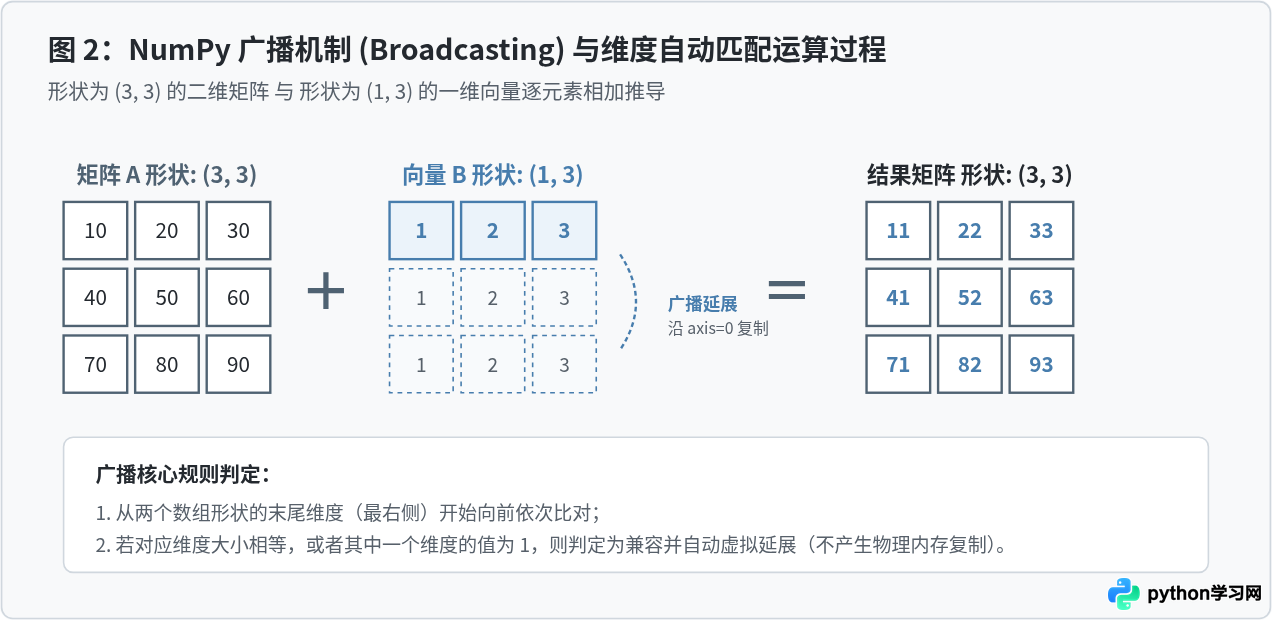
广播判定遵循明确的数学条件:从数组形状的最右端(尾部维度)向前逐一对比:
- 若两个数组在该维度上的大小相等,满足兼容条件;
- 若其中一个数组在该维度上的大小为 1,则该维度会被自动延展以匹配另一个数组;
- 若某个数组缺少某个维度,则在其左侧补 1 后继续对比。若遇到两个不相等且均不为 1 的维度,计算将直接抛出
ValueError: operands could not be broadcast together。
import numpy as np

# 构造 3x3 矩阵
matrix = np.array([
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
])

# 构造 1x3 向量(对每列统一加偏差)
bias = np.array([1, 2, 3])  # 形状 (3,) 在运算中自动等价于 (1, 3)

# 向量化广播相加
result = matrix + bias
print("广播相加结果:
", result)

# 常用聚合函数与轴向参数 (axis)
col_mean = np.mean(result, axis=0)  # 沿着行向下压缩,计算每列均值
row_sum = np.sum(result, axis=1)    # 沿着列向右压缩,计算每行总和
print("
列均值 (axis=0):", col_mean)
print("行总和 (axis=1):", row_sum)三、Pandas 数据选取规范:loc、iloc 与条件过滤
进入 Pandas 后,新手最容易陷入混乱的操作是数据切片与行选取。直接使用中括号(例如 df['col'] 或 df[0:2])虽然部分场景可行,但因为其重载了列选取和行切片两种截然不同的语义,容易导致代码晦涩且极易触发浅拷贝警告。工程规范要求统一使用显式索引器:.loc[] 和 .iloc[]。
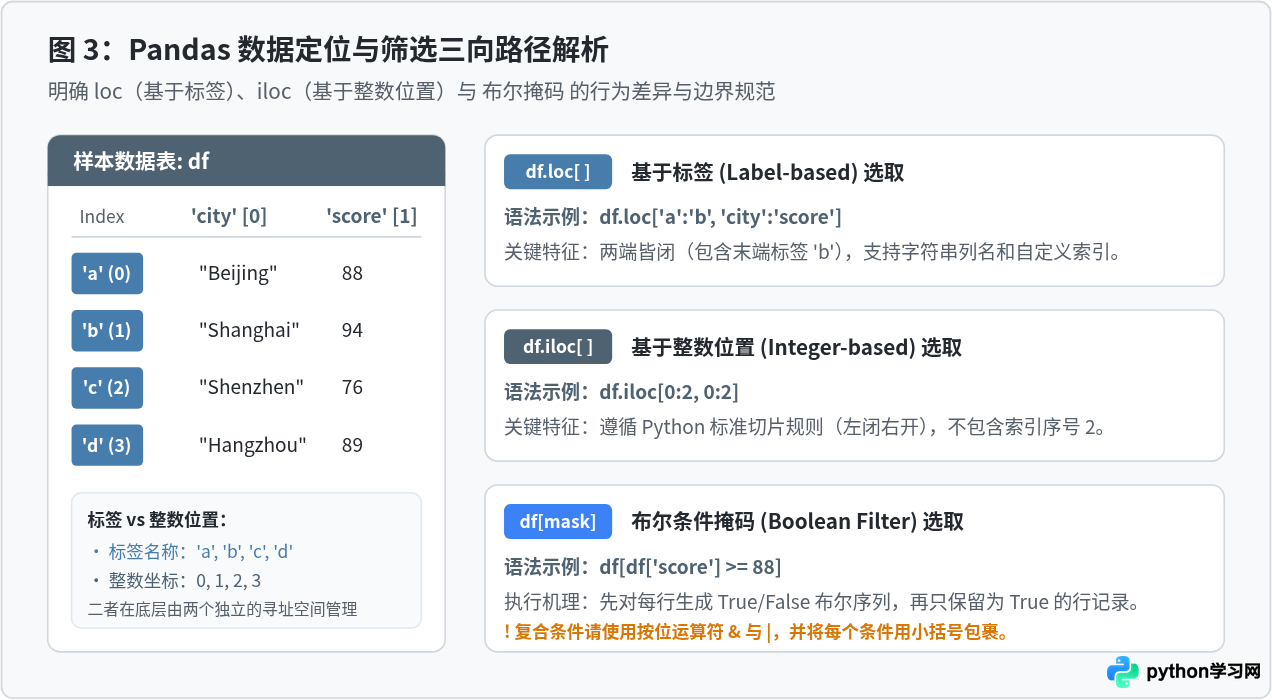
两个索引器的设计准则十分明确:
- df.loc[row_label, col_label]:基于行、列的“名称标签”定位。需要特别注意的是,在进行切片操作时(如
'a':'c'),两端都是闭区间,包含结尾标签'c'。 - df.iloc[row_pos, col_pos]:基于行、列从 0 开始的“整数坐标”定位。切片遵循 Python 标准语法(左闭右开),即
0:2只选取第 0 行和第 1 行,不包含第 2 行。 - 布尔掩码筛选:通过向数据框传递布尔值组成的 Series(例如
df['score'] > 80)提取满足条件的行。当涉及多个复合条件时,必须使用按位与&、按位或|,且每个独立条件必须用圆括号包裹,因为 Python 按位运算符的优先级高于比较运算符。
import pandas as pd

# 准备包含自定义索引的数据表
df = pd.DataFrame({
    "city": ["Beijing", "Shanghai", "Shenzhen", "Hangzhou"],
    "score": [88, 94, 76, 89],
    "active": [True, True, False, True]
}, index=["p1", "p2", "p3", "p4"])

# 1. 使用 loc 按标签提取行 'p1' 到 'p2' 的 'city' 与 'score' 列(两端包含)
loc_slice = df.loc["p1":"p2", ["city", "score"]]

# 2. 使用 iloc 按绝对位置提取前 2 行、前 2 列(左闭右开,不含下标 2)
iloc_slice = df.iloc[0:2, 0:2]

# 3. 复合条件过滤:分数大于等于 88 且处于激活状态
condition = (df["score"] >= 88) & (df["active"] == True)
filtered_df = df[condition]

print("loc 选取结果:
", loc_slice)
print("
条件过滤结果:
", filtered_df)四、标准实战链路:从原始表到聚合分析
在日常数据工作中,一个完整的基础分析流程通常包含四个连续环节:读取核对、数据清洗、衍生特征构造以及分组汇总导出。下面通过标准操作链路演示这两个库如何配合完成实际任务。
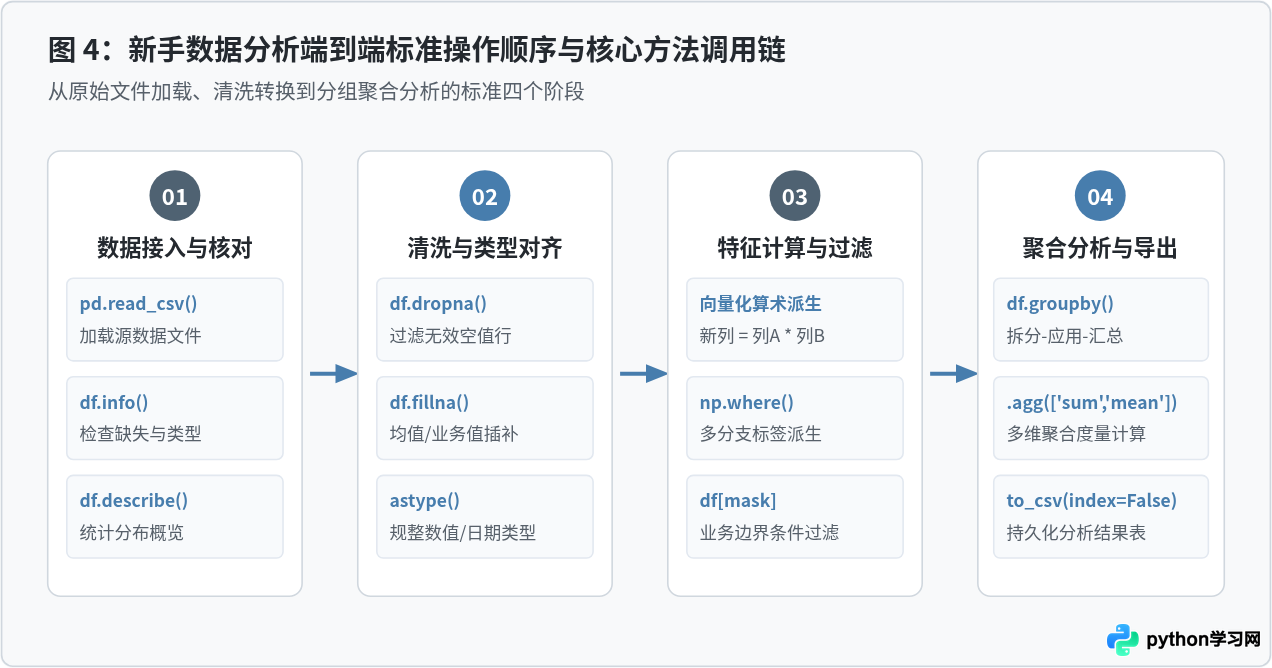
步骤 1:导入与数据结构体检
在加载 CSV 文件后,切忌直接开始计算。首要任务是运行 df.info() 与 df.describe(),确认数据的总行数、列名是否包含多余空格、数据类型是否被误判(如数字列被识别成了字符串 object)以及是否存在大面积空值。
步骤 2:清洗缺失值与类型修正
缺失值在 Pandas 中通常表示为 NaN(Not a Number)。对于包含缺失值的列,可以通过 df.isna().sum() 统计空值量。根据业务规则决定是采用 dropna() 剔除异常行,还是使用 fillna() 用中位数、均值或默认占位符填补。
步骤 3:利用 NumPy 条件函数快速衍生特征
当需要根据列的值划分类别或分段时,避免使用性能低下的 df.apply() 逐行遍历。借助 np.where(condition, value_if_true, value_if_false),可以以底层向量化的速度直接派生新列。
步骤 4:分组聚合与结果输出
使用 groupby() 对分类字段进行切分,结合 .agg() 传入多个统计指标(如 'sum'、'mean'、'count'),最终将分析结果通过 to_csv(index=False) 保存回磁盘。
import numpy as np
import pandas as pd

# 构造模拟订单原始数据(含缺失值与浮点价格)
raw_data = {
    "order_id": [101, 102, 103, 104, 105, 106],
    "category": ["Electronics", "Clothing", "Electronics", "Home", "Clothing", "Home"],
    "quantity": [1, 2, np.nan, 3, 1, 4],       # 存在 1 处空值
    "unit_price": [899.0, 120.0, 450.0, 85.5, 99.0, 45.0]
}
df = pd.DataFrame(raw_data)

# 1. 结构核验与缺失值填补(将购买件数空值填充为中位数 2.0)
median_qty = df["quantity"].median()
df["quantity"] = df["quantity"].fillna(median_qty)

# 2. 向量化算术运算:计算每个订单的总金额 (total_amount)
df["total_amount"] = df["quantity"] * df["unit_price"]

# 3. 借助 np.where() 进行向量化标签派生:金额 >= 300 标记为 High-Value
df["tier"] = np.where(df["total_amount"] >= 300.0, "High-Value", "Standard")

# 4. 分组聚合统计:按品类汇总销售总额与平均件数
summary = df.groupby("category").agg(
    order_count=("order_id", "count"),
    total_sales=("total_amount", "sum"),
    avg_quantity=("quantity", "mean")
).reset_index()

print("清洗与特征加工后的详情表:
", df)
print("
品类汇总分析结果:
", summary)五、高频选型速查与新手避坑清单
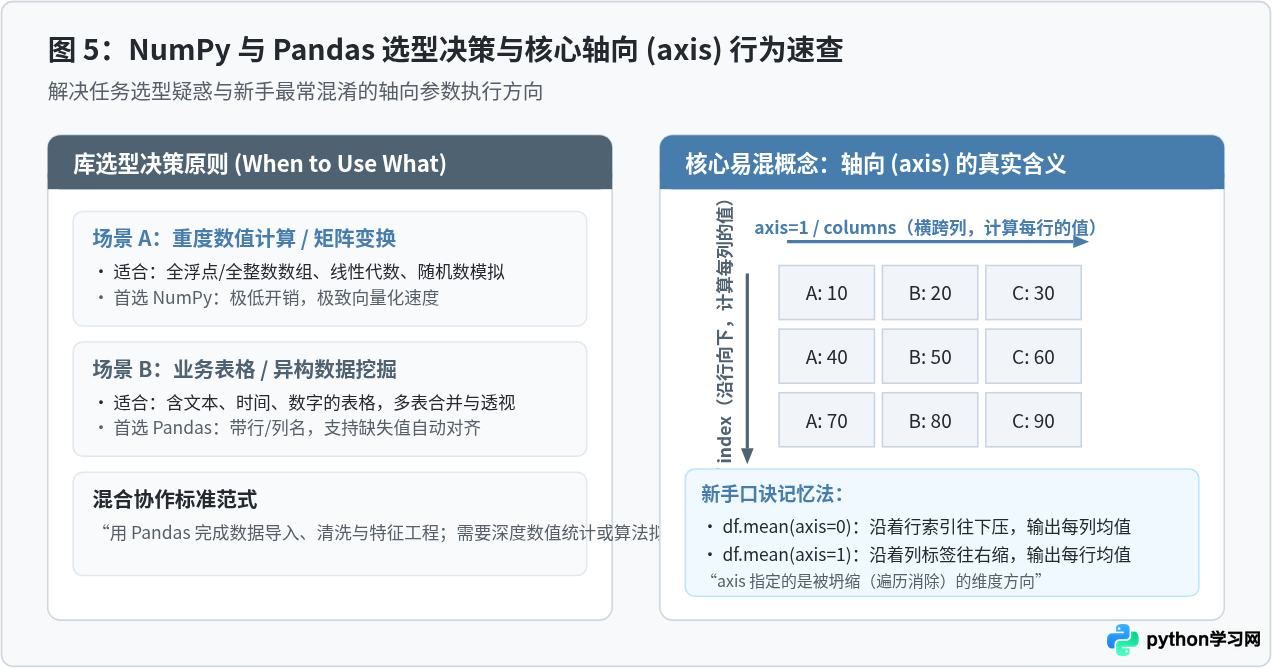
在日常使用中,新手常在库的选型与特定 API 行为上遇到困惑。下表和图解归纳了典型场景下的选型准则及最关键的避坑建议。
| 业务场景需求 | 推荐方案 | 选用理由与典型 API |
|---|---|---|
| 大规模数值模拟 / 矩阵点乘 / 傅里叶变换 | NumPy | 连续内存、低内存元数据开销、SIMD 加速。np.dot(), np.linalg, np.random |
| 读取带有表头的 CSV / Excel / SQL 数据表 | Pandas | 自动解析列名、数据类型识别、缺失值标记。pd.read_csv(), pd.read_sql() |
| 基于字符串字段、日期区间的过滤与清洗 | Pandas | 内置向量化字符串接口与时间序列支持。.str.contains(), pd.to_datetime() |
| 复杂条件打标与向量化分支赋值 | NumPy + Pandas | 使用 NumPy 向量化逻辑极速生成新列,写入 DataFrame。df['flag'] = np.where(...) |
| 将清洗好的特征矩阵传递给 Scikit-learn 模型 | Pandas 导出为 NumPy | 模型算法底层均依赖纯数值数组。X = df[['feat1', 'feat2']].to_numpy() |
新手三个最容易踩坑的关键点
-
警惕 SettingWithCopyWarning(链式赋值风险):
切勿使用形如df[df['age'] > 20]['score'] = 100的语法。这种双重中括号操作会先返回一个临时切片,赋值可能发生在不可见的原数据视图或临时副本上,导致赋值失败并抛出警告。正确做法是使用单次.loc赋值:
df.loc[df['age'] > 20, 'score'] = 100。 -
不要滥用 inplace=True 参数:
在很多早期的网络教程中充斥着df.dropna(inplace=True)。实际上,Pandas 核心团队已经多次声明inplace=True很少真正实现原地内存重用,反而破坏方法链式调用并掩盖副作用。推荐显式重新赋值:df = df.dropna()。 -
牢记 axis 参数的坍缩逻辑:
始终记住:axis=0代表沿着行方向(垂直向下)遍历计算,最终结果保留各列;axis=1代表跨越各列(水平向右)遍历计算,最终结果保留各行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















