


Jupyter Notebook怎么运行本地Python源代码文件
详细讲解在 Jupyter Notebook 中运行本地 Python 源代码文件(.py)的四种核心方案:%run 魔法命令、!python 终端子进程执行、import 模块化调用与 autoreload 热重载、%load 源码展开调试,包含路径配置、底层内存机制对比与高频报错排查。
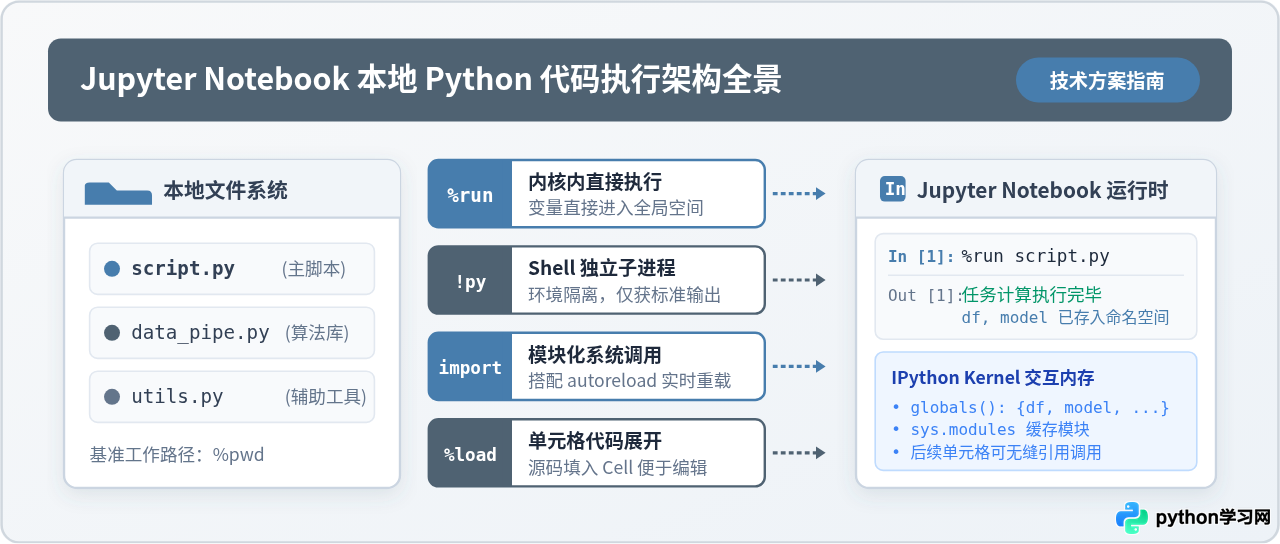
在 Jupyter Notebook 中运行本地 Python 源代码文件(.py),核心答案在于根据是否需要保留变量和修改代码选择合适的指令:最推荐的交互运行方式是使用 %run 魔法命令(如 %run script.py),它会在当前内核命名空间中直接运行脚本,脚本产生的数据与函数在后续单元格中立即可用;若希望完全隔离环境仅查看控制台打印,可使用 !python script.py;若要长期复用其中的函数与类,推荐使用 import 配合内置的 autoreload 自动重载扩展;若需要直接查看并改写源码,则可以使用 %load script.py 展开到当前单元格。
一、前置检查:确认 Jupyter 的工作路径与文件位置
初学者在 Jupyter Notebook 中执行本地 .py 文件时,遇到最多的问题就是 FileNotFoundError。这是因为 Jupyter Notebook 解析相对路径的基准,并不是该文件在磁盘中的物理层级,而是当前打开的 .ipynb 笔记所挂载的内核工作目录。
在执行任何本地脚本前,建议先在空白单元格中运行以下命令明确当前位置:
In [1]# 查看 Jupyter 当前所在的工作目录绝对路径
%pwd
假定输出目录为 /Users/project/analysis,那么接下来引用同级目录下的 data_pipeline.py 就可以直接使用相对文件名;如果脚本存放在子目录中(例如 src/utils.py),则需要传入 src/utils.py。也可以使用系统列表命令查看同级所有文件:
# 列出当前工作目录下的文件
%ls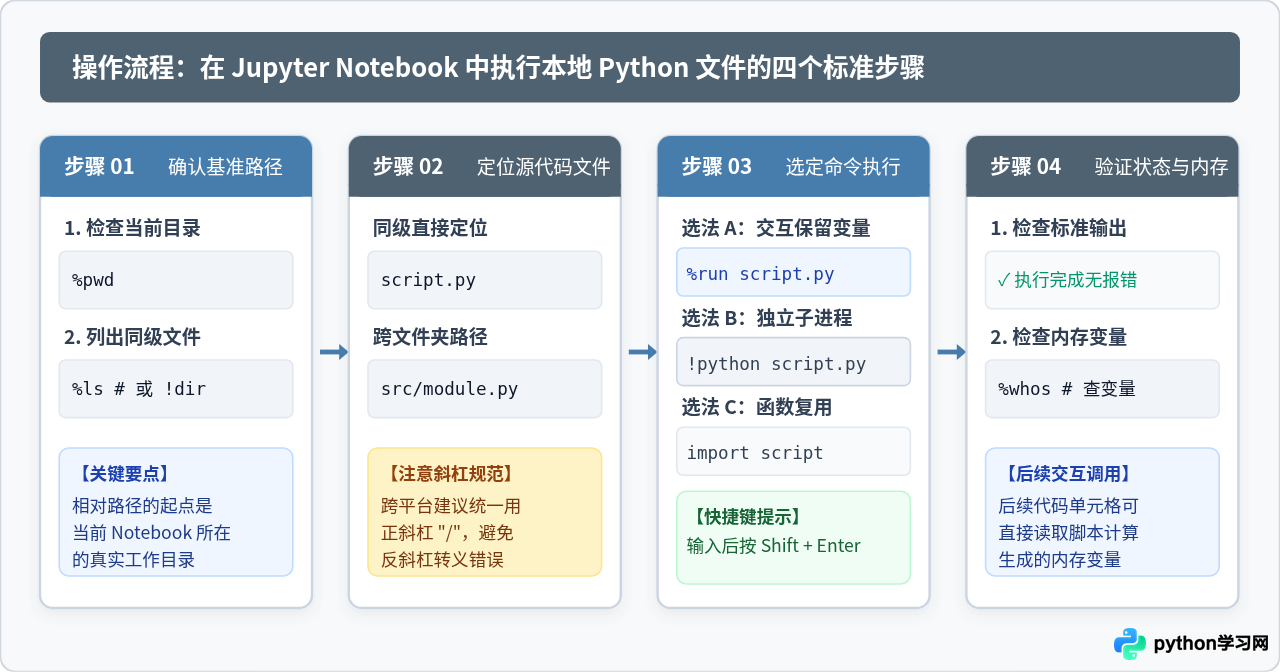
/(例如 subfolder/script.py),避免 Windows 路径中反斜杠 \ 引发转义字符解析异常。
二、方案一:使用 %run 魔法命令(交互式数据分析最常用)
%run 是 IPython 与 Jupyter 环境中最原生、最强大的指令之一。它专门用于把一个外部的 Python 脚本完整读取进当前 Notebook 的解释器中执行。
1. 基本使用示例
假设我们在工作目录下有一个名为 calculate_stats.py 的本地文件,内容如下:
# calculate_stats.py
import numpy as np

scores = [88, 92, 79, 95, 85, 90]
mean_val = float(np.mean(scores))
std_val = float(np.std(scores))

def get_summary():
    return {"mean": mean_val, "std": std_val, "count": len(scores)}

print(f"脚本计算完毕:平均分 = {mean_val:.2f}, 标准差 = {std_val:.2f}")
在 Jupyter Notebook 的单元格中,输入 %run calculate_stats.py 并按下快捷键 Shift + Enter:
%run calculate_stats.py脚本计算完毕:平均分 = 88.17, 标准差 = 5.142. 核心优势:全局变量与函数直接共享
与常规命令行不同,%run 执行完毕后,calculate_stats.py 中定义的全部变量(如 scores、mean_val、std_val)以及函数(get_summary())并不会随脚本退出而丢失,而是直接注册进 Notebook 的全局命名空间中。在后续的任何新单元格中,均可直接读取:
# 直接调用上一脚本中生成的函数与变量
summary = get_summary()
print("在后续单元格直接获取到的字典:", summary)
print("提取变量 mean_val * 2 =", mean_val * 2)
3. 常用扩展参数
%run -i script.py:如果脚本内部需要依赖当前 Notebook 中已经定义好的全局变量,加上-i参数可以让外部脚本直接读取 Notebook 现有的变量命名空间。%run -t script.py:在执行脚本的同时,统计并打印该文件从开始到结束消耗的真实时间(Wall time)与 CPU 时间。%run script.py arg1 arg2:若脚本内部使用了sys.argv接收命令行传参,可直接在文件名后像终端一样附加参数。
三、方案二:使用 !python 终端命令(独立子进程隔离运行)
如果某个本地 .py 文件是一个完整的后台批处理脚本、训练任务,或者你只希望验证它在标准终端环境下的输出,而不希望其内部海量临时变量污染当前 Notebook 的内存,可以使用感叹号 ! 触发系统 Shell 命令。
1. 语法与执行表现
In [5]!python calculate_stats.py脚本计算完毕:平均分 = 88.17, 标准差 = 5.14
表面上看输出文本与 %run 相同,但底层机制完全不同:Jupyter 通过操作系统创建了一个新的 Python 子进程执行该脚本。子进程执行完后立即销毁。
如果在后续单元格尝试打印 mean_val,Notebook 会直接抛出异常:
print(mean_val)
# 抛出 NameError: name 'mean_val' is not defined!python 时调用的 python 是当前操作系统终端 PATH 路径下的默认 Python。如果你的 Jupyter 运行在一个单独的 Conda 虚拟环境中,而系统默认 Python 没有安装相关依赖包,执行 !python 可能会报错缺少模块。此时应确保虚拟环境处于激活状态,或优先使用 %run。
四、方案三:作为模块导入 import 与 autoreload 自动重载
当项目规模扩大时,推荐将数据处理逻辑、数学算法或数据库连接封装为独立的 .py 模块文件。此时不应反复整篇运行脚本,而是采用标准的 import 语法。
1. 标准导入方式
In [7]import calculate_stats as cs
result = cs.get_summary()
print("模块调用结果:", result)2. 解决痛点:修改代码后 import 不生效的问题
在日常开发中,很多开发者会遇到这样的困惑:在外部编辑器修改了 calculate_stats.py,回到 Notebook 重新运行 import calculate_stats,结果发现逻辑并没有任何变化。
这是因为 Python 为保障性能,对已导入的模块只会在首次执行时编译并缓存到 sys.modules 字典中。后续即使再次执行 import,Python 也只是直接返回缓存对象,而不会重新读取磁盘文件。
终极解决方案:开启 IPython 内置的 autoreload 热重载扩展。在导入模块前,在 Notebook 最前方的单元格运行以下两行魔法指令:
In [8]# 加载自动重载扩展
%load_ext autoreload
# 设置为 2 级重载模式:每次执行任何单元格前,自动重新加载所有改动过的模块文件
%autoreload 2
开启 %autoreload 2 后,只要在外部编辑器修改并保存了 .py 源码,Jupyter 单元格在下一次执行时便会自动同步最新代码,无需重启 Kernel。
五、方案四:使用 %load 展开源码至单元格(适合单步调试与快速修改)
如果你手头有一个现成的本地脚本,但希望在 Notebook 中把它拆成几个部分调试,或者需要微调其中的几行超参数,那么可以使用 %load 魔法命令。
1. 操作步骤
- 在一个空白的代码单元格中输入:
%load calculate_stats.py; - 按下快捷键 Shift + Enter(或者点击工具栏上的运行按钮);
- Jupyter 会自动将
%load calculate_stats.py注释为# %load calculate_stats.py,并将磁盘上该文件的完整源代码直接拉取并粘贴填充在该单元格中; - 此时单元格变为了常规的代码编辑状态,你可以根据需要直接改动变量、插入调试语句,再次按下 Shift + Enter 即可正式运行。
%load 是一种单向的内容载入操作。在单元格中对代码进行的任何修改,都只保存在当前的 .ipynb 文件中,不会自动覆盖或同步写回本地磁盘的原 .py 文件。
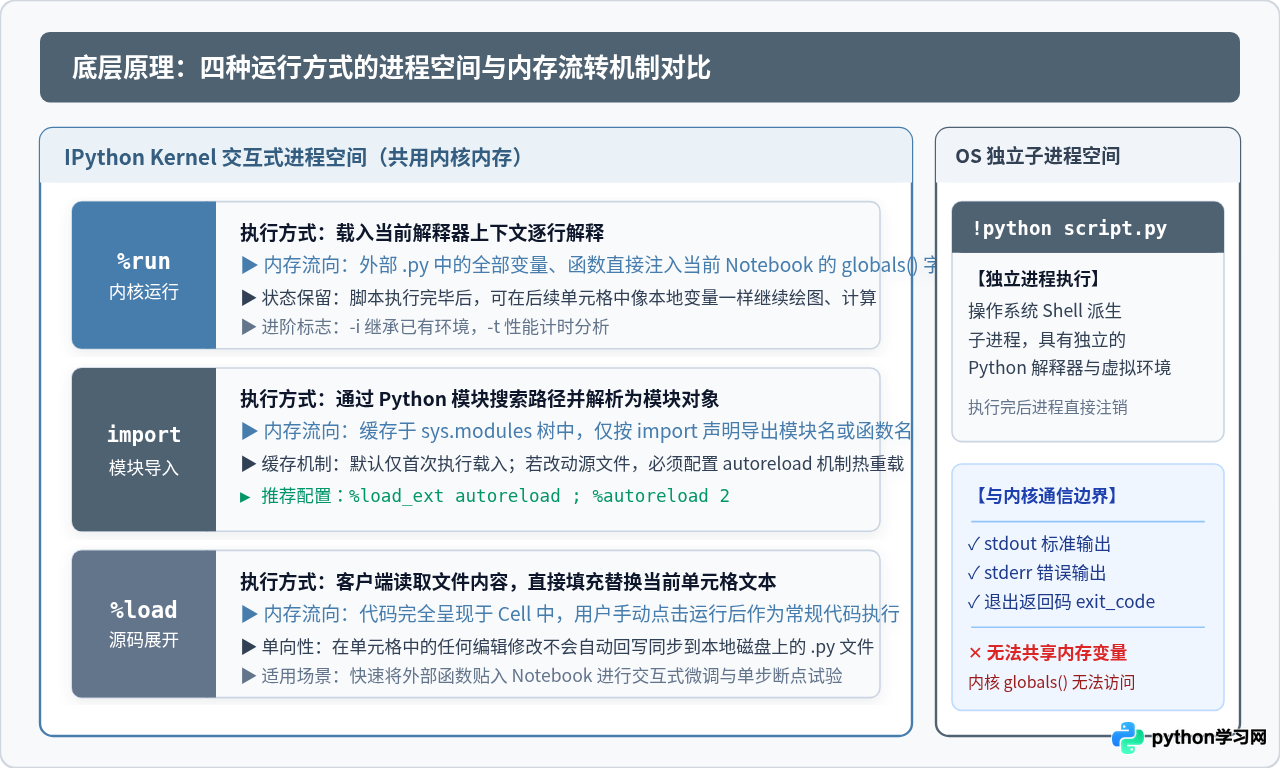
六、原理深究:四种运行方式的底层机制与差异对比
理解不同运行方式在操作系统底层以及 Python 虚拟机内存中的差异,能够帮助我们在复杂的实际项目中准确选型,避免变量覆盖或内存泄露。
| 对比维度 | %run 魔法命令 | !python 终端命令 | import 模块导入 | %load 源码展开 |
|---|---|---|---|---|
| 语法格式 | %run script.py |
!python script.py |
import script |
%load script.py |
| 运行实体 | 当前 Jupyter 内核线程 | 独立操作系统子进程 | 当前 Jupyter 内核(模块树) | 当前单元格前台代码 |
| 变量留存情况 | 全部写入 globals(),全局可用 |
进程结束即销毁,仅捕获控制台打印 | 封装在模块命名空间内,按需调用 | 执行后作为普通单元格变量存留 |
| 修改文件后生效方式 | 重新执行 %run 即可生效 |
重新执行命令即可生效 | 需搭配 %autoreload 2 或重启 |
需重新执行 %load 重新抓取 |
| 典型适用场景 | 数据分析、脚本完整交互运行 | 脚本批处理测试、隔离环境变量 | 规范项目开发、工具类/函数复用 | 外部代码快速调试、片段分析改写 |
七、常见报错原因与排障诊断流程
在运行本地文件的过程中,若遇到执行失败,通常集中在路径解析错误、模块搜索列表不匹配或编码问题三类情形。
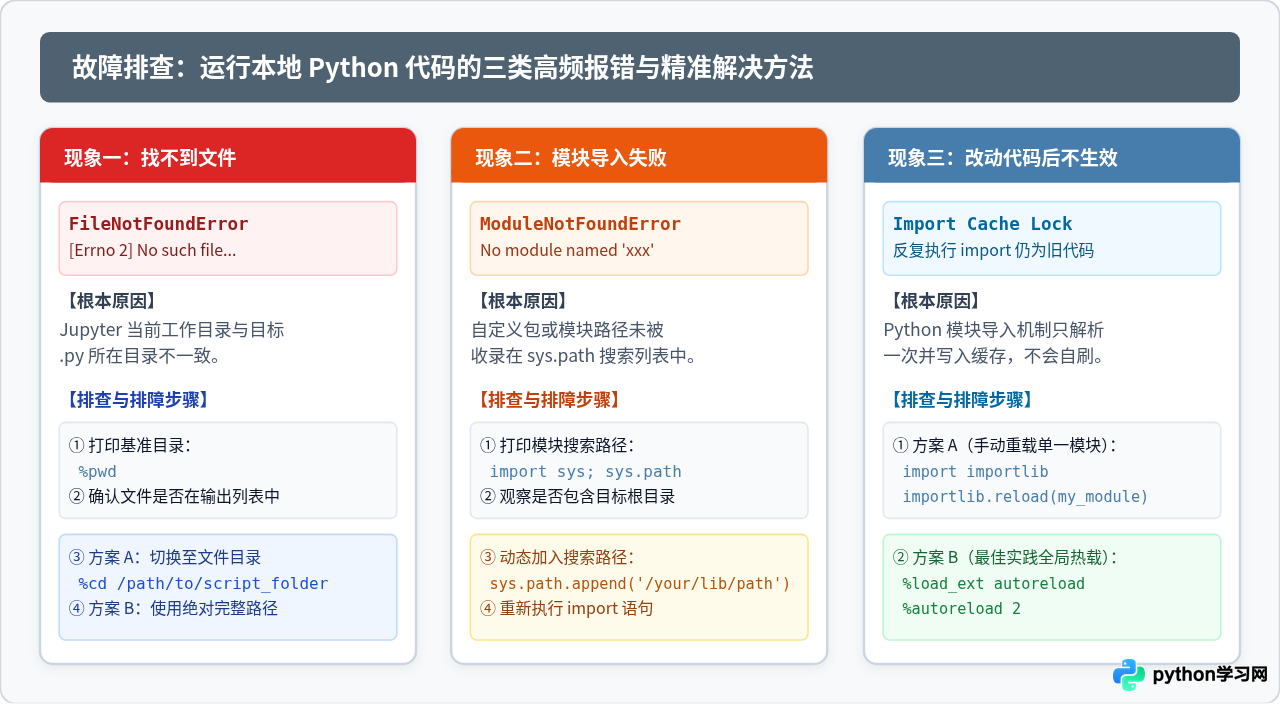
1. 报错:FileNotFoundError: [Errno 2] No such file or directory
这是最常见的问题。产生原因包括:
- Notebook 运行的工作目录与文件存放位置不符。解决方法:先执行
%pwd检查当前路径,若需要切换至目标代码所在目录,可直接执行%cd /your/target/path。 - 文件名拼写错误或扩展名遗漏(例如漏写
.py)。 - 文件路径中包含空格或中文未加引号。若路径存在空格,请用双引号包裹:
%run "my analysis/script.py"。
2. 报错:ModuleNotFoundError: No module named 'xxx'
当使用 import 引入同一项目的其他文件夹下的脚本时,Python 经常会抛出此错误。原因在于该文件夹未被包含在系统的 sys.path(模块搜索路径)中。
可通过在导入前手动将项目根目录追加进 sys.path 进行修复:
import sys
import os

# 将项目所在根目录追加至模块搜索路径
project_root = os.path.abspath("..")
if project_root not in sys.path:
    sys.path.append(project_root)

# 此时即可正常跨文件夹导入自定义模块
import my_custom_module
3. 编码错误:SyntaxError: Non-UTF-8 code starting with...
如果在 Windows 系统下编写的 .py 文件使用了 GBK 编码,且文件中包含中文字符,Jupyter 默认以 UTF-8 方式读取时会触发编码解析错误。建议在代码编辑器中将 .py 文件的编码格式统一保存为 UTF-8,或在文件首行显式声明:
# -*- coding: utf-8 -*-八、开发场景选型与最佳实践总结
面对四种运行方式,开发中的选型逻辑非常清晰:如果你的核心目的是运行算法产出中间变量用于交互分析,首选 %run script.py;如果你正在编写长期复用的组件和逻辑库,应该采用 import 模块化调用并始终开启 %autoreload 2;如果你只想检验整个流程能否在纯命令行端跑通,使用 !python script.py;而当你需要借用已有脚本进行快速改写测试时,使用 %load script.py。
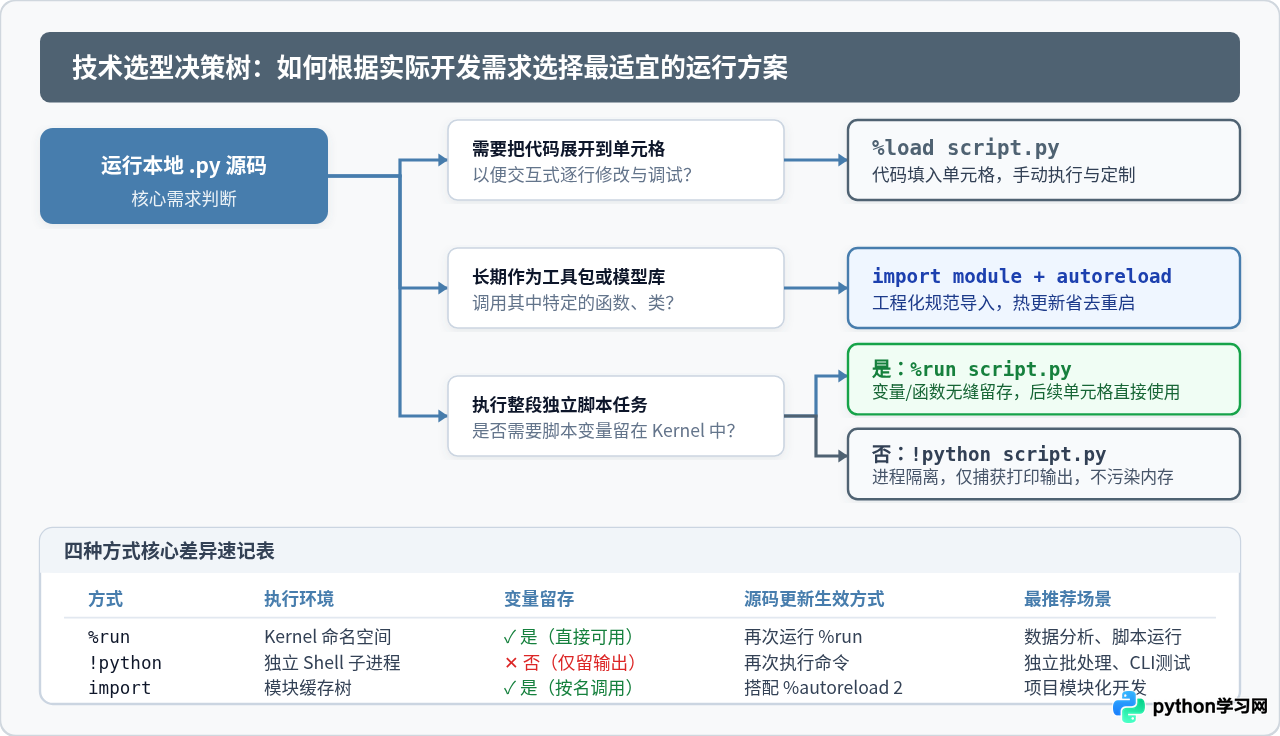
%run 快速试跑脚本逻辑;当逻辑趋于稳定后,将通用数据清洗和模型函数抽取整理到本地 .py 模块中;接着在 Notebook 头部加入 %load_ext autoreload 和 %autoreload 2,通过 import 进行优雅调用,从而兼得脚本工程化与 Notebook 交互可视化的双重优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















