


Python内置数据类型有哪些
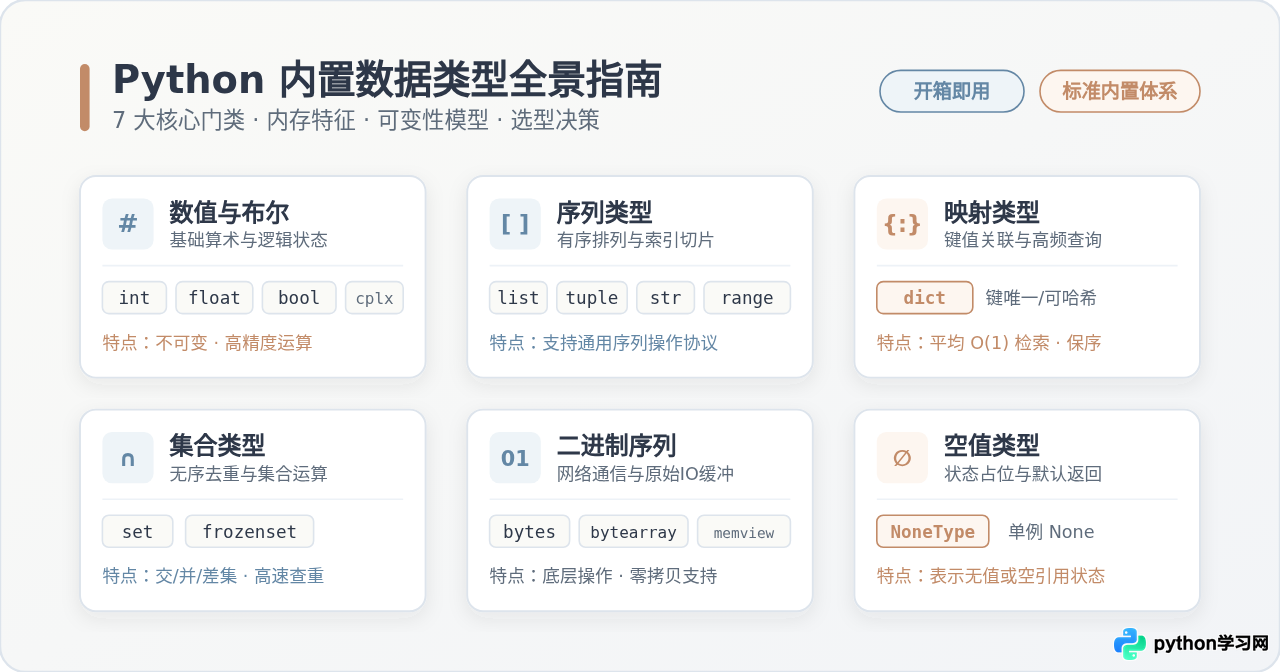
全面梳理Python官方内置数据类型体系,涵盖数值、序列、映射、集合、二进制与空值类型,结合内存机制、可变性模型与业务选型决策流程进行深度解析。
int, float, complex)、布尔类型(bool)、序列类型(str, list, tuple, range)、映射类型(dict)、集合类型(set, frozenset)、二进制序列(bytes, bytearray, memoryview)以及表示空值的NoneType。本文将系统梳理每一类内置类型的定义方式、核心机制、内存可变性与业务场景下的选型逻辑。
一、数值与布尔类型:计算与逻辑控制的基石
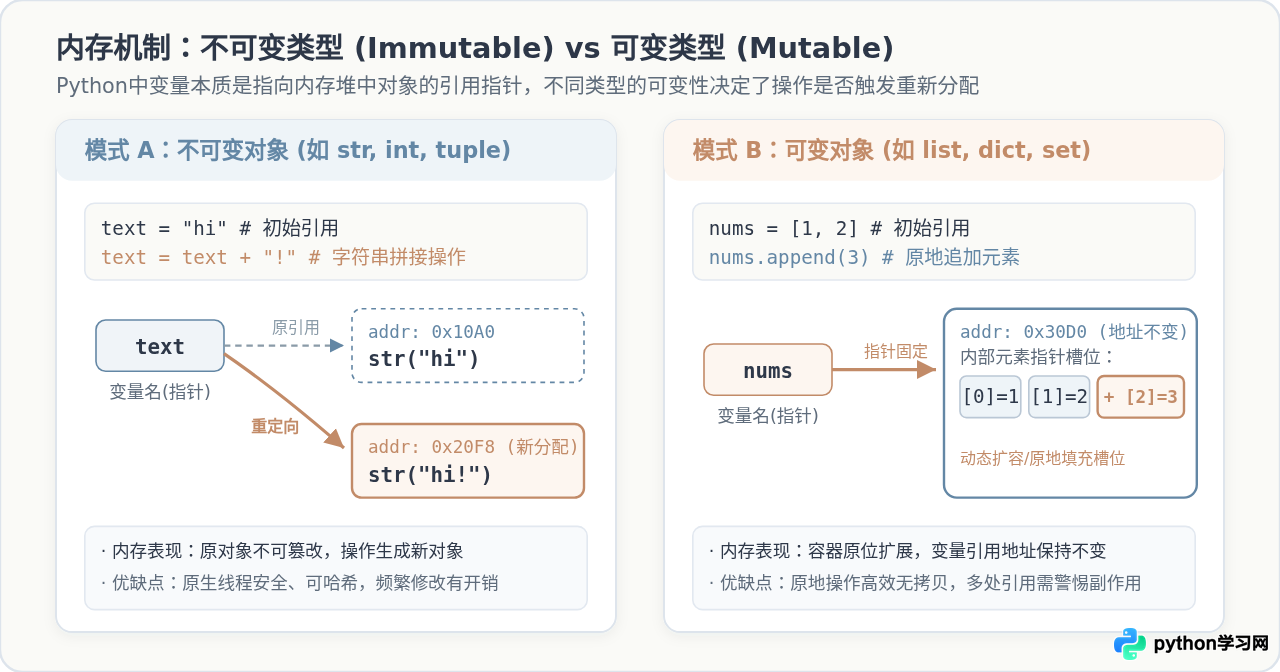
数值与布尔类型属于标量对象,用于表达离散的算术量值与条件真假状态。在Python的实现模型中,所有数值对象均为不可变类型(Immutable),任何算术运算产生的都是新的数值对象。
1. 整数类型(int)
Python 3 中的 int 支持任意精度整数,消除了 C/Java 等语言中因 32 位或 64 位整型溢出引发的逻辑风险。在内存允许的前提下,整数可以表达任意大小的数字。
# 整数支持超长位数与十进制、十六进制等多种字面量
normal_int = 42
large_int = 10 ** 30  # 超大整数运算无需额外大数库
hex_val = 0xFF        # 十六进制,值为 255

# 示例输出:
# large_int -> 1000000000000000000000000000000
2. 浮点数类型(float)与复数(complex)
float 在 CPython 底层对应双精度 64 位 IEEE 754 浮点数,存在固有的二进制舍入误差。因此在进行高精度金融计算时,应使用标准库 decimal 代替直接使用 float。
complex 用于科学计算与信号处理,以 real + imag*j 的形式表达,例如 3 + 4j。
3. 布尔类型(bool)
布尔类型仅包含两个单例值:True 与 False。值得注意的是,在Python的类型继承体系中,bool 是 int 的直接子类(即 issubclass(bool, int) is True),在数值运算中 True 等价于 1,False 等价于 0。
# 布尔值的数值继承特性
print(isinstance(True, int))   # True
print(True + 5)                # 6
二、序列类型:有序集合的数据组织
序列类型(Sequence)是一组按照位置严格保序的元素集合。所有序列类型均支持通用的序列协议:正逆向索引访问(如 seq[0]、seq[-1])、切片截取(seq[start:stop:step])、成员检查(in)、长度查询(len(seq))以及迭代遍历。
1. 列表(list) vs 元组(tuple)
list 是最常用的可变有序序列,支持原位动态扩容、删除与元素更新,使用方括号 [] 声明;而 tuple 是不可变有序序列,使用圆括号 () 声明。
两者核心区别在于可变性与内存策略:list 为了支持快速就地追加元素,会预留多余的槽位容量(Over-allocation);而 tuple 尺寸固定,内存紧凑且无需保留动态扩容指针,分配效率更高且能够作为字典的键。
2. 文本字符串(str)与范围对象(range)
str 是由 Unicode 码点构成的不可变文本序列。Python 3 严格区分了文本字符串与原始字节流,任何对字符串的拼装或替换操作均会生成新的字符串对象。
range 表示不可变的等差整数序列,常用于 for 循环中。range 采用惰性计算机制,仅在内存中保存 start、stop 与 step 三个属性,无论范围跨越 10 个数字还是 10 亿个数字,其占用的内存空间完全恒定(均为 48 字节左右)。
single_t = (42,)。若书写为 single_t = (42),括号仅会被解释器视作普通的数学优先级运算符,变量类型仍为整数 int。
三、映射与集合类型:基于散列表的高性能检索
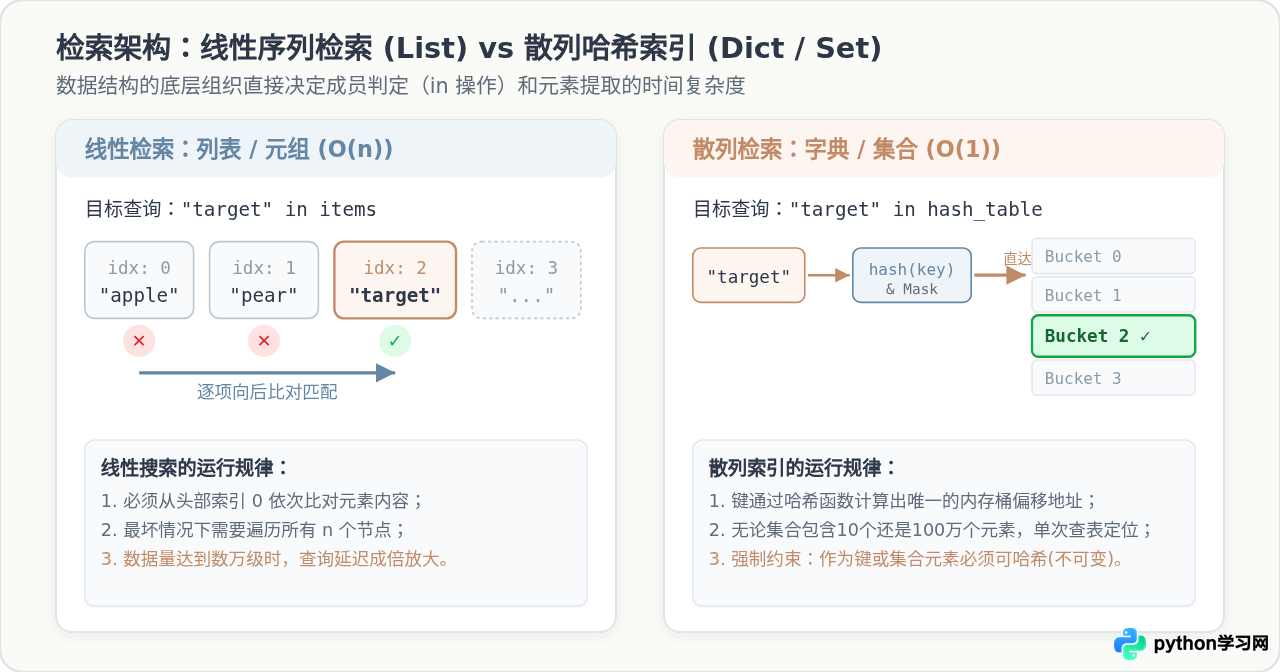
当数据量从数百条增长到数百万条时,序列类型的线性遍历检索(时间复杂度为 $O(n)$)会出现显著的性能瓶颈。Python 提供了基于哈希表(Hash Table)实现的映射类型与集合类型,在平均情况下提供 $O(1)$ 的即时定位与查询能力。
1. 字典(dict)
dict 是 Python 中唯一的标准内置映射类型,存储键值对(Key-Value pairs)。自 Python 3.7 起,官方语言规范正式保证了字典的插入保序性(Insertion-ordered)。
字典的键(Key)具有强制约束:必须是可哈希对象(Hashable)。一个对象可哈希必须满足两个条件:第一,其在生命周期内哈希值(通过 hash() 计算)永不改变;第二,支持通过 __eq__() 进行相等性比较。因此,str、int、tuple(且元组内所有元素均可哈希)可作为字典键,而 list、dict、set 等可变类型则不能作为键。
2. 可变集合(set)与不可变集合(frozenset)
集合是一组无序且无重复元素的容器。set 支持就地添加元素(add())与删除;frozenset 是其不可变版本。
集合底层同样依赖哈希表,因此元素同样必须是可哈希对象。集合原生支持集合代数运算,如交集(&)、并集(|)、差集(-)与对称差集(^)。
# 字典与集合的高频哈希操作示例
user_scores = {"alice": 95, "bob": 88}   # 字典声明
print(user_scores.get("alice"))          # 平均 O(1) 取值

tags_a = {"python", "backend", "fastapi"}
tags_b = {"fastapi", "docker", "cloud"}
common_tags = tags_a & tags_b            # 集合求交集

# 示例输出:
# 95
# common_tags -> fastapi
四、二进制序列与空值类型:底层数据处理与状态表达
除了高层结构化数据,Python 还内置了面向文件IO、Socket网络通信及内存直接操作的底层数据类型。
1. 字节序列(bytes)与可变字节数组(bytearray)
bytes 是不可变的 8 位无符号字节序列(取值范围 0~255),通过字面量前缀 b'...' 创建。网络传输、图片编码、加解密数据在传输层均以 bytes 形式流转。
bytearray 是 bytes 的可变镜像版本,支持原位修改、切片重写与缓冲区原地操作。在处理大型二进制文件或网络协议包拼装时,使用 bytearray 能有效避免重复拷贝带来的内存分配损耗。
2. 内存视图(memoryview)
memoryview 允许 Python 代码在不复制缓冲区底层数据的情况下,直接通过切片访问支持缓冲协议(Buffer Protocol)的对象(如 bytes、bytearray)。这在大吞吐量高频 IO 场景下是实现“零拷贝”(Zero-copy)架构的核心基础。
3. 空值类型(NoneType)
NoneType 只有一个全局单例值 None,用于表示“无”、“未赋值”或函数的缺省返回状态。在代码判断时,应始终使用身份比对操作符 val is None 或 val is not None,避免使用值比对操作符 ==。
五、数据类型选型决策与推导流程
在实际工程开发中,选择合适的数据类型直接决定了程序的健壮性、可读性以及执行性能。开发者应根据数据的访问方式、更新频次及是否需要共享保护来进行推导。
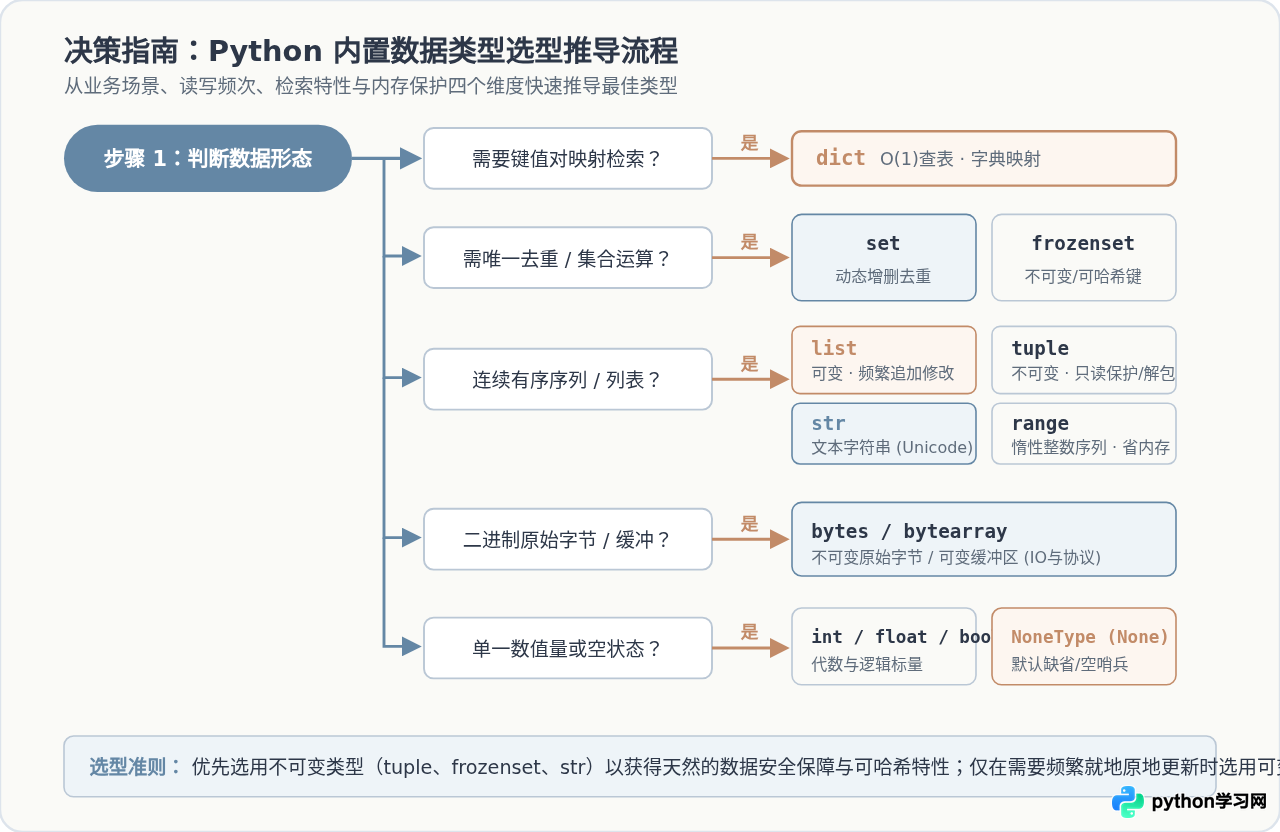
tuple 替代 list,frozenset 替代 set)。不可变对象作为参数传递给函数时具有天然的只读保护,能够从结构上杜绝被下游调用链意外篡改的隐蔽 Bug。
六、核心特性归纳与高频易错点总结
下表和全景归纳图总结了 Python 所有核心内置类型的语法、特性与适用场景:
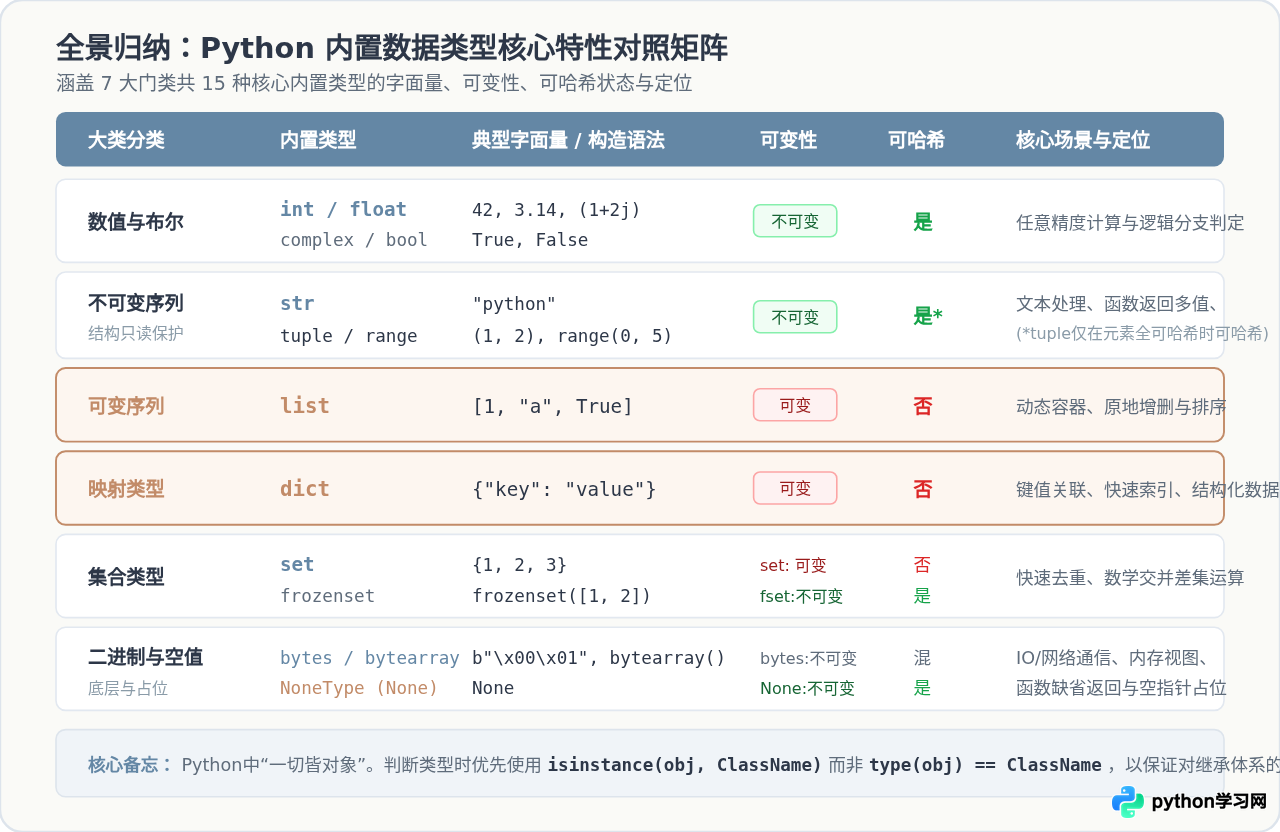
实际编码中的三大典型陷阱与解决策略
-
函数默认参数中的可变对象陷阱:
不要将list或dict直接作为函数默认参数(如def append_item(val, target=[]))。Python 中函数的默认参数在模块加载定义时仅求值一次,后续多次调用会共享同一个列表对象。正确做法是将默认值设为None,在函数体内进行防御性初始化:if target is None: target = []。 -
不可变容器中包含可变对象的混淆:
tuple本身是不可变的(其槽位指针地址不能替换),但若元组内部包含可变元素(例如t = (1, [2, 3])),则内部列表仍然可以就地修改(t[1].append(4))。此时该元组由于包含了不可哈希的列表元素,将无法作为字典的键使用。 -
浮点数直接相等性比对陷阱:
由于二进制浮点舍入精度限制,0.1 + 0.2 == 0.3在 Python 中求值结果为False。在编写业务逻辑时,必须使用标准库math.isclose(a, b)或指定容差阈值来进行浮点数判等。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















