


Python注释用什么符号?单行#与多行三引号写法
全面解析Python注释符号的选用与规范:深入讲解单行注释井号(#)的标准写法、多行连续井号与多行三引号('''或""")的本质差异、Docstring文档字符串机制及常见缩进陷阱。
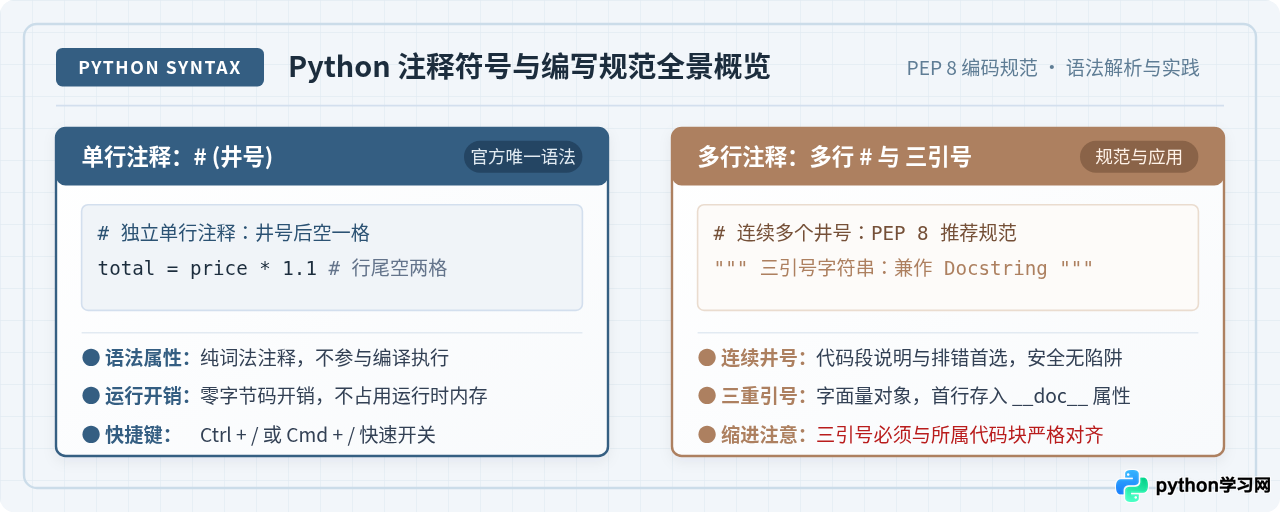
在 Python 中,官方标准的单行注释符号是井号(#),所有位于 # 之后的同一行文本都会被 Python 解释器直接忽略,不参与编译与运行;对于多行注释,官方 PEP 8 规范推荐在每行开头分别添加一个 # 符号,而在实际工程与交互场景中,开发者也常用未赋值的多行字符串(成对的三单引号 ''' 或三双引号 """)来编写长段注释或模块与函数的文档字符串(Docstring)。
一、单行注释的符号与编写规范
Python 单行注释的核心符号是 #(Hash 或 Pound 键)。在 Python 语法中,井号的作用是引导行级说明。当解释器在单行代码中遇到井号时,该符号本身及其所在行右侧的所有字符都将被词法分析器直接忽略,不会被转换为任何执行代码。
单行注释在日常编写中主要有两种应用形式:
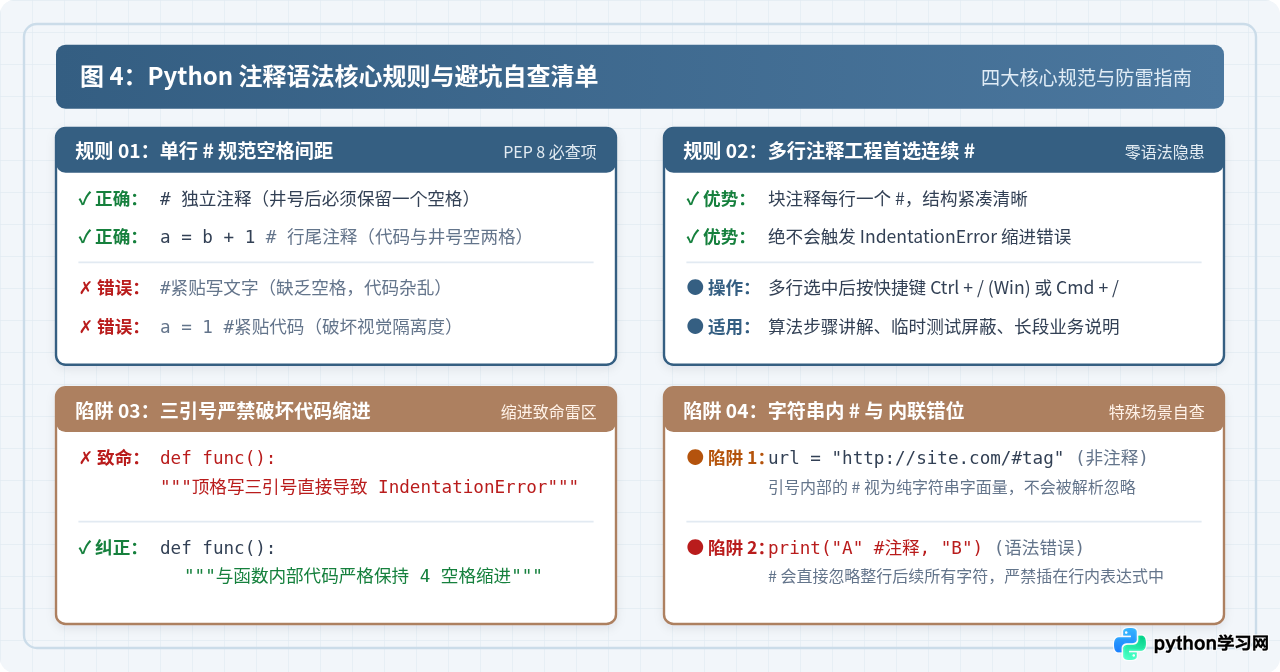
- 独立单行注释:单独占据一行,通常放置在待解释代码块的正上方。按照 PEP 8 规范要求,
#与后续的注释正文之间应保留一个半角空格。 - 行尾注释(行内注释):放置在可执行代码语句的末尾。PEP 8 规范建议,代码末尾与
#之间应当保留至少两个半角空格,以保证代码与注释在视觉上有清晰的隔离。
# 这是一个规范的独立单行注释(井号后空一格)
base_price = 100.0
tax_rate = 0.08

total_amount = base_price * (1 + tax_rate) # 计算含税总额(代码与井号间空两格)# 出现在单引号、双引号或多行字符串的内部,Python 会将其判定为普通字符串字面量的一部分,而不会当作注释解析。例如:api_endpoint = "https://example.com/api#section",此时末尾的 #section 是有效的 URL 片段,不会被忽略。
二、多行注释的两种实现方式
与其他支持类似 /* ... */ 块注释语法的语言(如 C、Java、JavaScript)不同,Python 没有官方专门设立的“多行块注释独立符号”。在 Python 中实现多行注释,行业内主要有两种行之有效的方法:
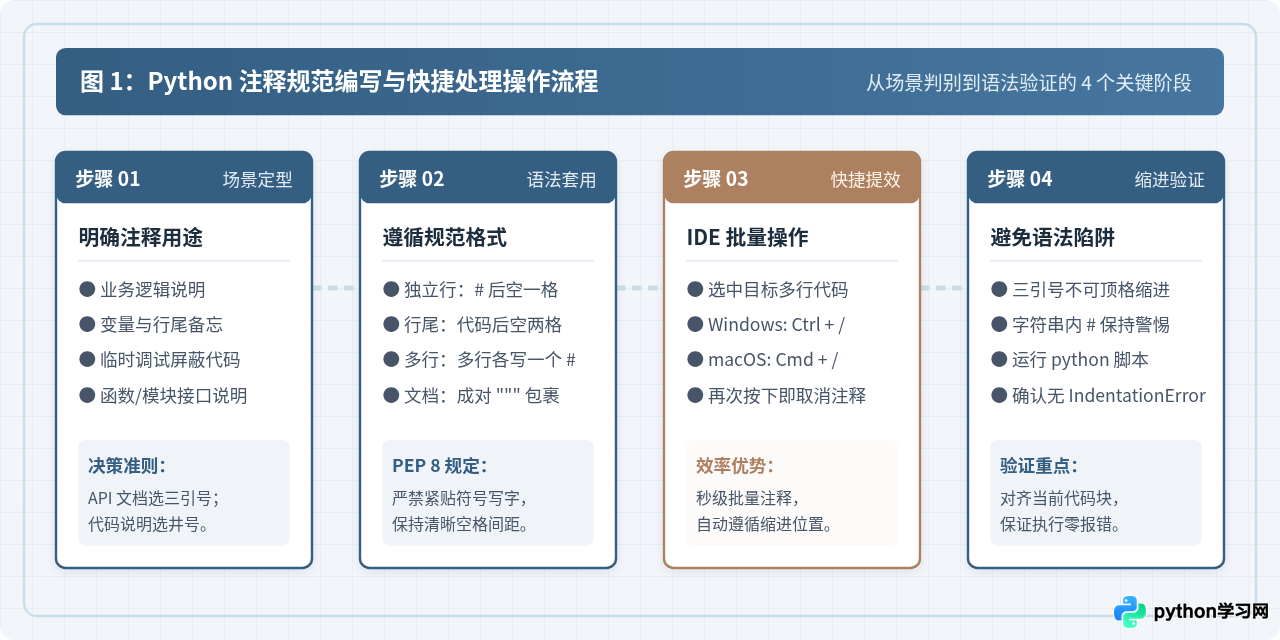
1. 方案一:连续多行使用井号(PEP 8 官方推荐做法)
Python 官方风格指南 PEP 8 明确指出,块注释(Block Comments)应当由一个或多个段落组成,段落中的每一行都必须以 # 和一个空格开头。这种写法在语法层面最为严谨,能够百分之百保证不会产生歧义或副作用。
# 数据预处理阶段:
# 1. 过滤包含空值的异常记录
# 2. 将时间戳字符串转换为 datetime 格式
# 3. 按照用户 ID 进行分组聚合
clean_records = preprocess(raw_records)
在现代代码编辑器(如 VS Code、PyCharm、Sublime Text)中,编写连续井号非常高效。读者只需用鼠标或键盘选中需要注释的多行代码,按下全局快捷键 Ctrl + /(Windows/Linux)或 Cmd + /(macOS),编辑器就会自动在每一行开头插入或移除 # 符号。
2. 方案二:使用成对的三引号(''' 或 """)
Python 支持使用连续的三个单引号 ''' 或三个双引号 """ 来定义跨多行的字符串。如果一段三引号字符串没有赋值给任何变量,也没有作为参数传入任何函数,它虽然在语法上是一个字符串字面量(String Literal),但在没有副作用的情况下,它在运行时不会对程序逻辑产生任何实质影响,因此常被开发者用来充当大段文字的注释。
"""
以下代码用于模拟高并发请求测试。
通过线程池并发触发 HTTP GET 请求,
并记录各请求的响应延迟及状态码。
"""
def run_stress_test():
    pass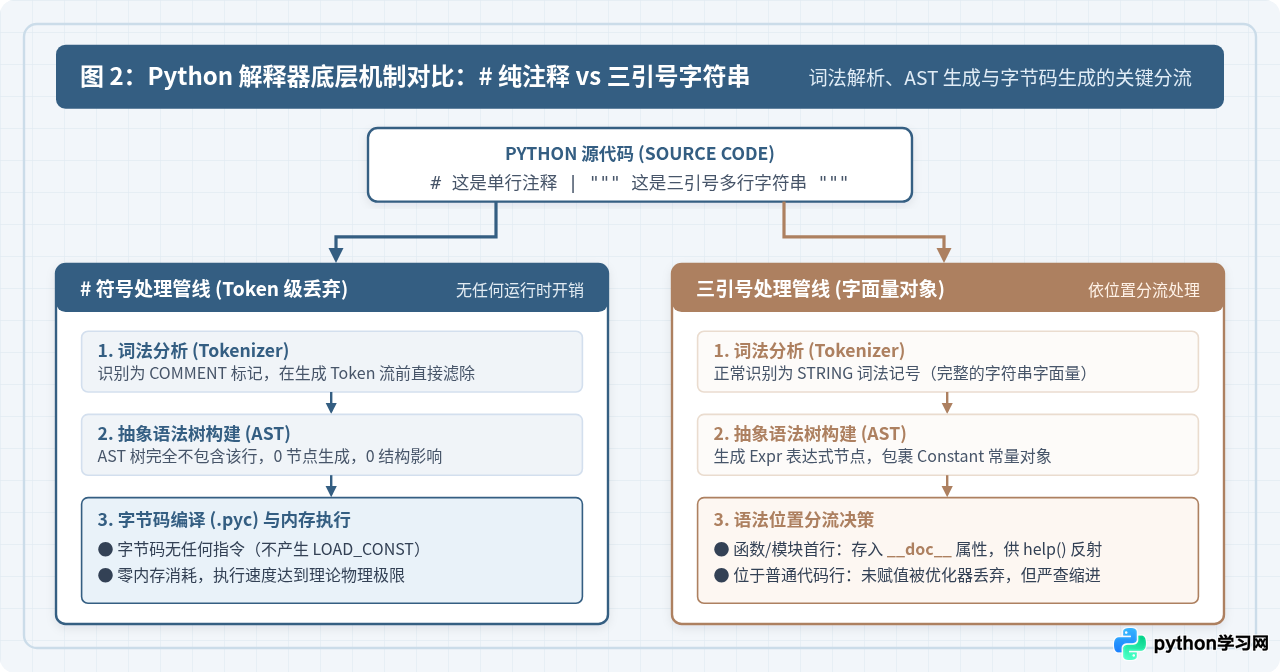
三、三引号多行注释与 Docstring(文档字符串)的区别
很多初学者容易将“普通多行三引号注释”与“Docstring(文档字符串)”混为一谈。从 Python 解释器的底层视角来看,两者的处理机制存在本质不同:
- Docstring(文档字符串):特指紧随模块(Module)、类(Class)或函数(Function)定义第一行出现的三引号字符串。Python 解释器会专门读取并保留该字符串,将其绑定至该对象的
__doc__属性中。第三方工具(如 Sphinx、pydoc)以及交互式环境下的help()函数,都可以动态提取这些内容生成正式文档。 - 代码块内部的未赋值三引号:如果三引号字符串出现在普通业务逻辑代码之间,它不会被存入
__doc__属性。在字节码编译与优化阶段,Python 解释器会判定该表达式无副作用并直接将其剔除。
def calculate_discount(price: float, discount: float) -> float:
    """计算折后最终价格。

    参数:
        price: 原始商品价格(必须大于 0)
        discount: 折扣比率(例如 0.85 代表八五折)

    返回:
        折后总金额(保留两位小数)
    """
    # 检查折扣数值范围是否合法
    if not (0 < discount <= 1):
        raise ValueError("折扣比例必须在 0 到 1 之间")
    return round(price * discount, 2)

# 在终端或脚本中可以通过 __doc__ 访问文档内容
print(calculate_discount.__doc__)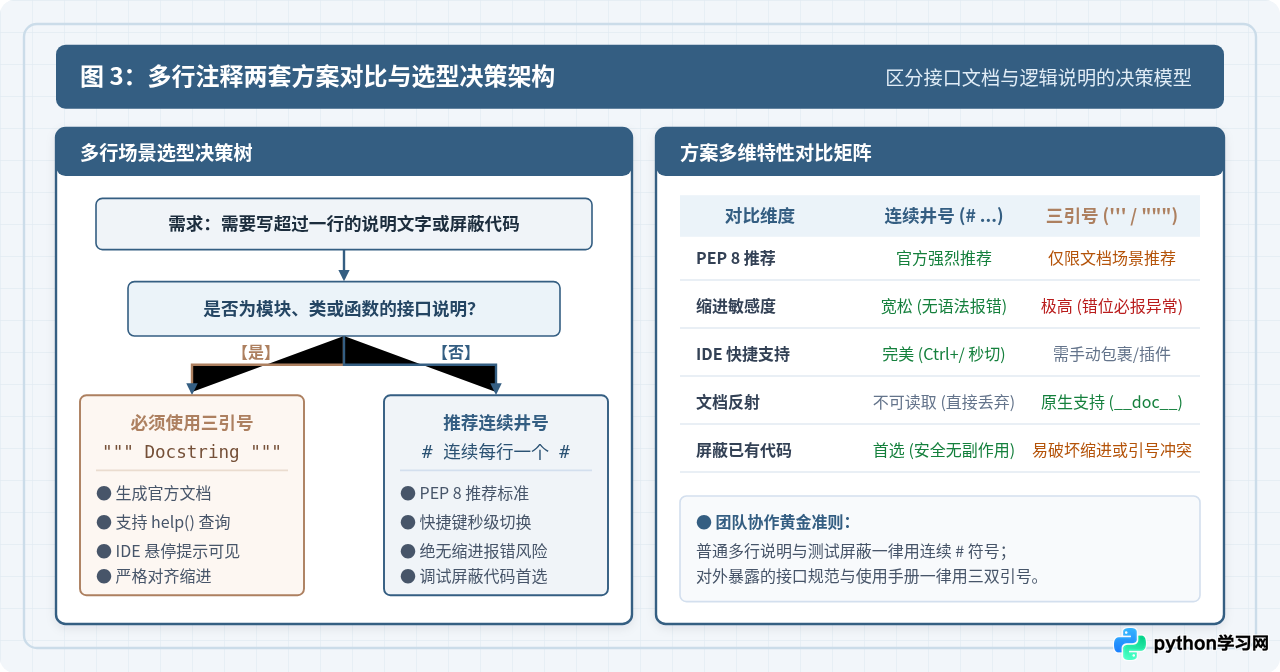
四、常见编写错误与避坑自查
在实际编写 Python 注释的过程中,以下几种常见错误往往会导致程序报错或风格违规,需要特别注意:
1. 误区一:三引号缩进错误导致 IndentationError
这是使用三引号替代多行注释时最容易踩入的语法陷阱。三引号本质上仍是 Python 语法树中的一个语句。当它出现在函数、循环或条件分支内部时,必须与该层级的缩进对齐。如果将三引号顶格书写,Python 解释器会直接抛出 IndentationError 异常并中断执行。
def process_order():
# 错误示范:三引号顶格书写,破坏了函数内部缩进
"""
此操作将触发 Python 语法解析报错:
IndentationError: unexpected unindent
"""
    order_id = 1001
    return order_id
正确修改方式:让三引号及其内部文字严格保持与 order_id = 1001 相同的缩进空格数(通常为 4 个空格)。如果不希望受制于缩进问题,最安全稳妥的替代方式是直接换用多行 #。
2. 误区二:在表达式行内随意插入井号
在函数调用或多行列表中,有时开发者希望对某个特定参数进行说明。需牢记:# 符号一旦出现,其后直至换行符的所有文本均被丢弃。若在括号关闭前提前使用了 #,且未在换行后正确闭合括号,可能导致意外的 SyntaxError。
# 错误示范:井号导致闭合圆括号与参数被误裁切
# result = add_numbers(10, # 第一个数 20)  <-- 后面的 20) 会被直接忽略导致语法报错

# 正确示范:换行后针对单独参数进行注释
result = add_numbers(
    10,  # 基础价格参数
    20   # 浮动服务费参数
)
五、总结与速查对比
综合上述分析,Python 注释符号的选择与使用准则可以归纳为以下表格:
| 注释类型 | 标准语法符号 | 适用典型场景 | PEP 8 规范要求与注意事项 |
|---|---|---|---|
| 单行独立注释 | # 注释内容 |
解释下方代码块的设计思路、算法步骤 | 井号与正文保留 1 个空格;与上方代码保留 1 个空行 |
| 行尾行内注释 | 代码 # 注释内容 |
标记关键变量含义、微调参数说明 | 代码与井号之间至少保留 2 个空格;避免过度叙述显而易见的代码 |
| 多行块注释 | 连续多行 # |
长段逻辑讲解、排查 Bug 时临时屏蔽代码 | PEP 8 官方推荐;现代 IDE 支持 Ctrl + / 一键批量加解 |
| 多行文档字符串 | 成对 ''' 或 """ |
模块、类、函数的接口规范与参数说明(Docstring) | 首行书写存入 __doc__;在函数体内部必须严格匹配代码块缩进 |
在实际项目开发中,建议牢记两条核心原则:业务逻辑用井号,对外接口用三引号。编写注释的目的在于阐明代码“为什么这么写”而非机械复述“代码做了什么”,保持注释准确、精炼且与代码同步更新,是写出整洁优雅 Python 代码的关键基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















