


Python基础语法练习题及答案:变量、循环与函数解析
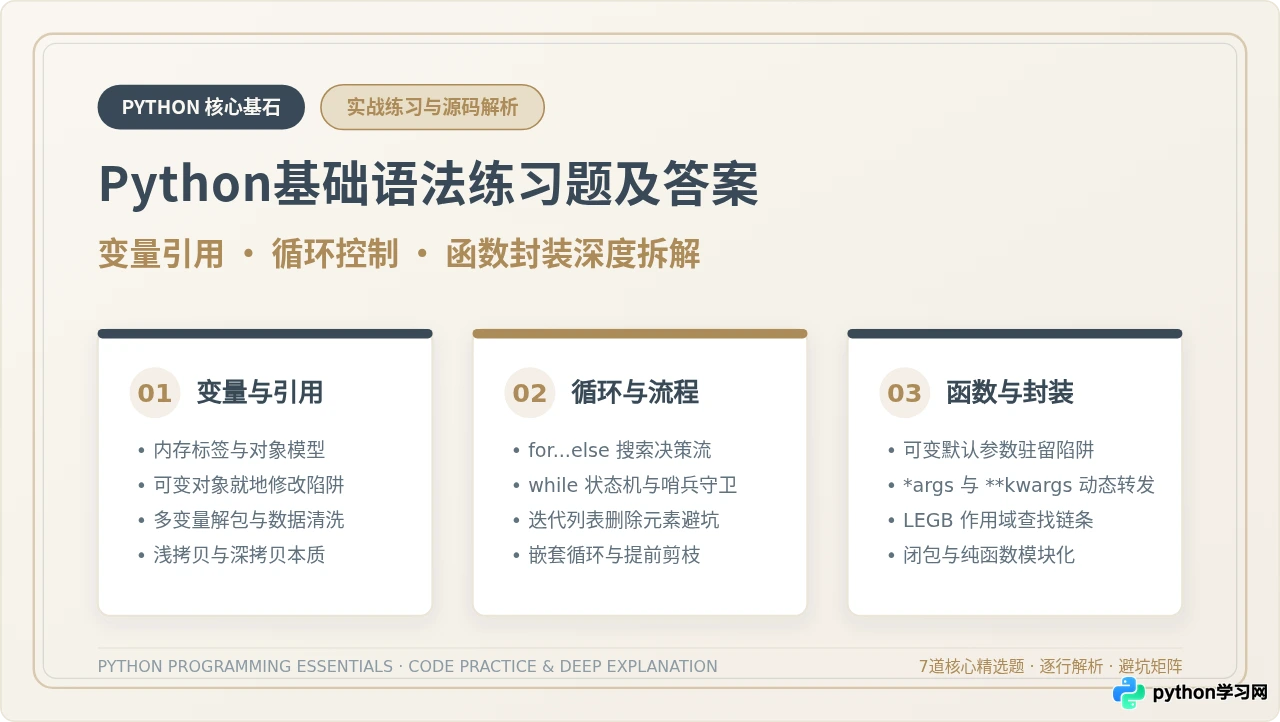
精选Python基础语法核心练习题与详细参考答案解析,深入拆解变量与对象引用模型、for与while循环流程控制,以及函数封装、默认参数陷阱与LEGB作用域查找机制,帮助读者建立系统性编程直觉。
编写高质量 Python 代码的核心基础在于透彻理解“数据如何存储(变量与对象模型)”、“流程如何流转(循环与状态分支)”以及“逻辑如何隔离(函数封装与作用域)”。许多初学者虽然能够写出基础语法,但在实际运行中频频遇到共享引用污染、循环内修改集合导致的诡异跳步,以及可变默认参数跨调用残留等深层隐患。本文围绕变量、循环与函数三大核心模块,精选代表性进阶练习题,提供完整规范的参考实现、逐行深度原理解析与图解推导,帮助读者精准避坑并建立严谨的编程直觉。
第一部分:变量、内存引用与解包赋值解析
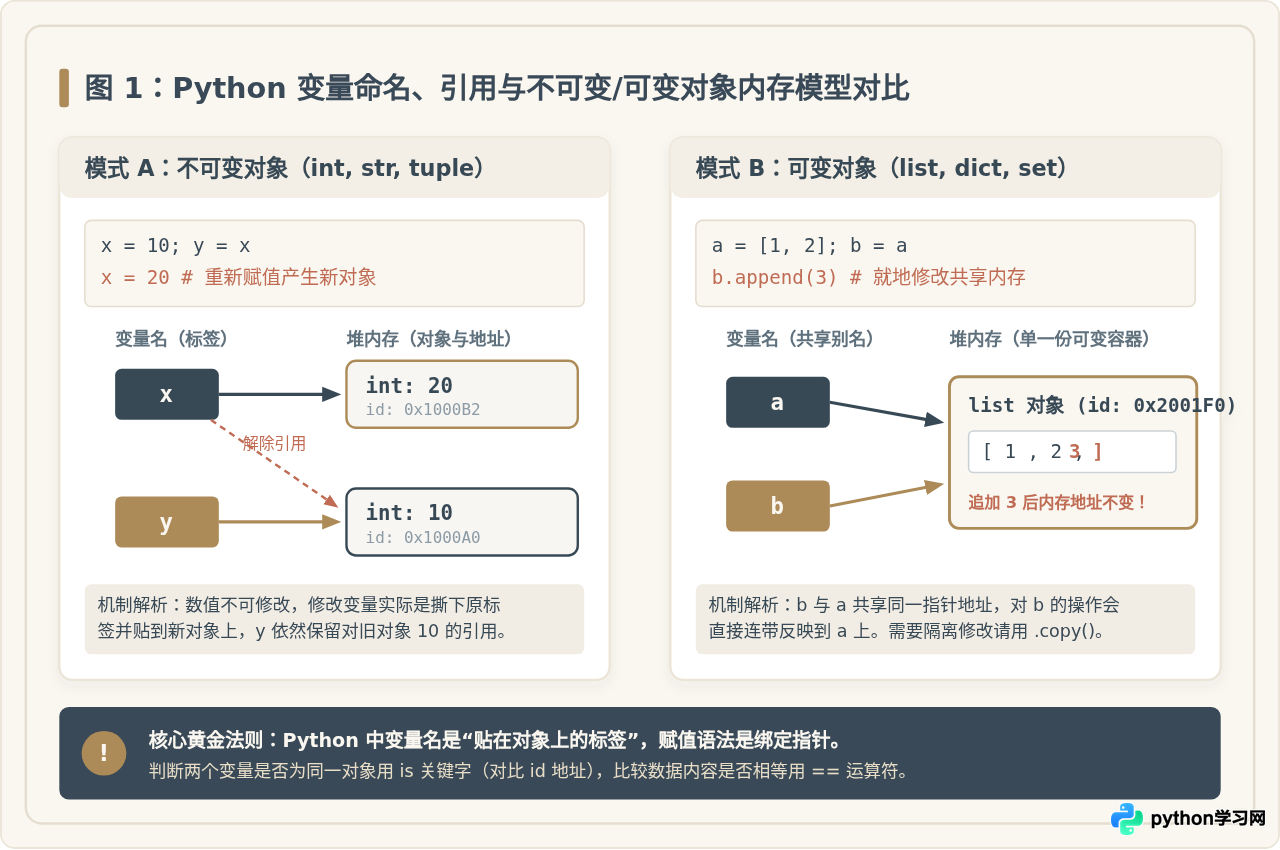
在 Python 中,“变量”并非存放数据的物理盒子,而是一个绑定到堆内存对象的标签(指针)。当执行 x = [1, 2] 时,Python 首先在内存中开辟空间创建列表对象,再将变量名 x 指向该对象;当执行 y = x 时,实际上只是将标签 y 也贴到了同一个对象上。因此,理解可变对象(如列表、字典)与不可变对象(如整数、浮点数、字符串、元组)的赋值差异,是避免逻辑漏洞的先决条件。
练习题 1:多变量引用别名与可变对象浅拷贝陷阱
【题目要求】 给定两个初始列表 source_a = [10, 20, [30, 40]] 和 source_b = [10, 20, [30, 40]]。请通过代码证明并解决以下问题:
- 直接赋值
target_1 = source_a时,修改target_1中的顶层元素和嵌套列表,观察source_a的变化; - 使用浅拷贝
target_2 = source_b.copy()时,修改顶层元素和嵌套元素,观察并解释哪些数据受到污染; - 编写无副作用的安全深拷贝方案,使得新列表的任意修改完全不影响原始数据,并打印内存地址(
id())予以印证。
import copy

# 1. 直接别名赋值测试
source_a = [10, 20, [30, 40]]
target_1 = source_a
target_1[0] = 999
target_1[2].append(50)
print("直接赋值后 source_a:", source_a)
print("source_a 与 target_1 是同一对象:", source_a is target_1)

# 2. 浅拷贝测试
source_b = [10, 20, [30, 40]]
target_2 = source_b.copy()
target_2[0] = 888          # 修改顶层元素(不可变整数引用)
target_2[2].append(60)     # 修改嵌套列表(可变对象引用)
print("浅拷贝后 source_b:", source_b)
print("顶层是否独立:", source_b is not target_2)
print("嵌套列表是否共享同一内存:", source_b[2] is target_2[2])

# 3. 安全深拷贝方案
source_c = [10, 20, [30, 40]]
target_safe = copy.deepcopy(source_c)
target_safe[2].append(70)
print("深拷贝后 source_c 保持原样:", source_c)
print("深拷贝后 target_safe:", target_safe)
print("嵌套列表是否彻底隔离:", source_c[2] is not target_safe[2])source_a 与 target_1 是同一对象: True
浅拷贝后 source_b: [10, 20, [30, 40, 60]]
顶层是否独立: True
嵌套列表是否共享同一内存: True
深拷贝后 source_c 保持原样: [10, 20, [30, 40]]
深拷贝后 target_safe: [10, 20, [30, 40, 70]]
嵌套列表是否彻底隔离: True
target_1 = source_a并没有在内存中新建列表,只是创建了一个新的指针变量。二者指向同一块内存堆,因此任何就地变动都相互可见。source_b.copy()创建了新的外层列表对象(外层id不同),但列表内部存储的元素指针被直接复制。对于不可变整数10,重新赋值相当于给新列表的第一个位置贴上新整数指针,不影响原列表;但对嵌套列表[30, 40],两份外层列表依然持有同一个子列表指针,因而触发联动污染。copy.deepcopy()会递归遍历所有引用并创建全新副本,确保嵌套层次完全物理隔离。
练习题 2:序列多变量解包与复杂字典数据清洗
【题目要求】 在实际工程中,后端服务常返回带有多余字段或不同格式的元组和字典列表。现有学生成绩数据源:
raw_records = [("Alice", 21, 88.5, 92.0, 95.5), ("Bob", 22, 70.0, 65.5), ("Charlie", 20, 95.0, 98.0, 100.0, 94.0)]。
每个元组格式为 (姓名, 年龄, *各科成绩),考试科目数量不固定。请利用 Python 的扩展序列解包(Extended Iterable Unpacking)与字典推导式:
- 提取每个学生的姓名、年龄以及动态科目成绩列表;
- 计算每位学生的平均成绩(保留一位小数),过滤掉平均成绩低于 80 分的学生;
- 生成结构化字典,格式为:
{姓名: {"age": 年龄, "avg_score": 平均分, "exam_count": 考试门数}}。
raw_records = [
    ("Alice", 21, 88.5, 92.0, 95.5),
    ("Bob", 22, 70.0, 65.5),
    ("Charlie", 20, 95.0, 98.0, 100.0, 94.0)
]

cleaned_report = {}

for record in raw_records:
    # 使用星号解包分离定长字段与不定长序列
    name, age, *scores = record

    if not scores:
        continue

    avg = round(sum(scores) / len(scores), 1)

    # 过滤及格标准线
    if avg >= 80.0:
        cleaned_report[name] = {
            "age": age,
            "avg_score": avg,
            "exam_count": len(scores)
        }

print("清洗后优秀学员报表:")
for student, info in cleaned_report.items():
print(f"学生: {student:<8} | 年龄: {info['age']} | 门数: {info['exam_count']} | 均分: {info['avg_score']}")学生: Alice | 年龄: 21 | 门数: 3 | 均分: 92.0
学生: Charlie | 年龄: 20 | 门数: 4 | 均分: 96.8
name, age, *scores = record利用了 PEP 3132 扩展解包语法。前两个位置对应变量分别绑定元组的前两项,带星号的*scores会自动将末尾所有剩余项收纳为一个标准的 Pythonlist,极大精简了切片下标代码(免去record[2:])。- 通过格式化输出中的
{student:<8}控制左对齐宽度,使终端报表保持工业级对齐格式。
第二部分:循环结构与流程控制进阶
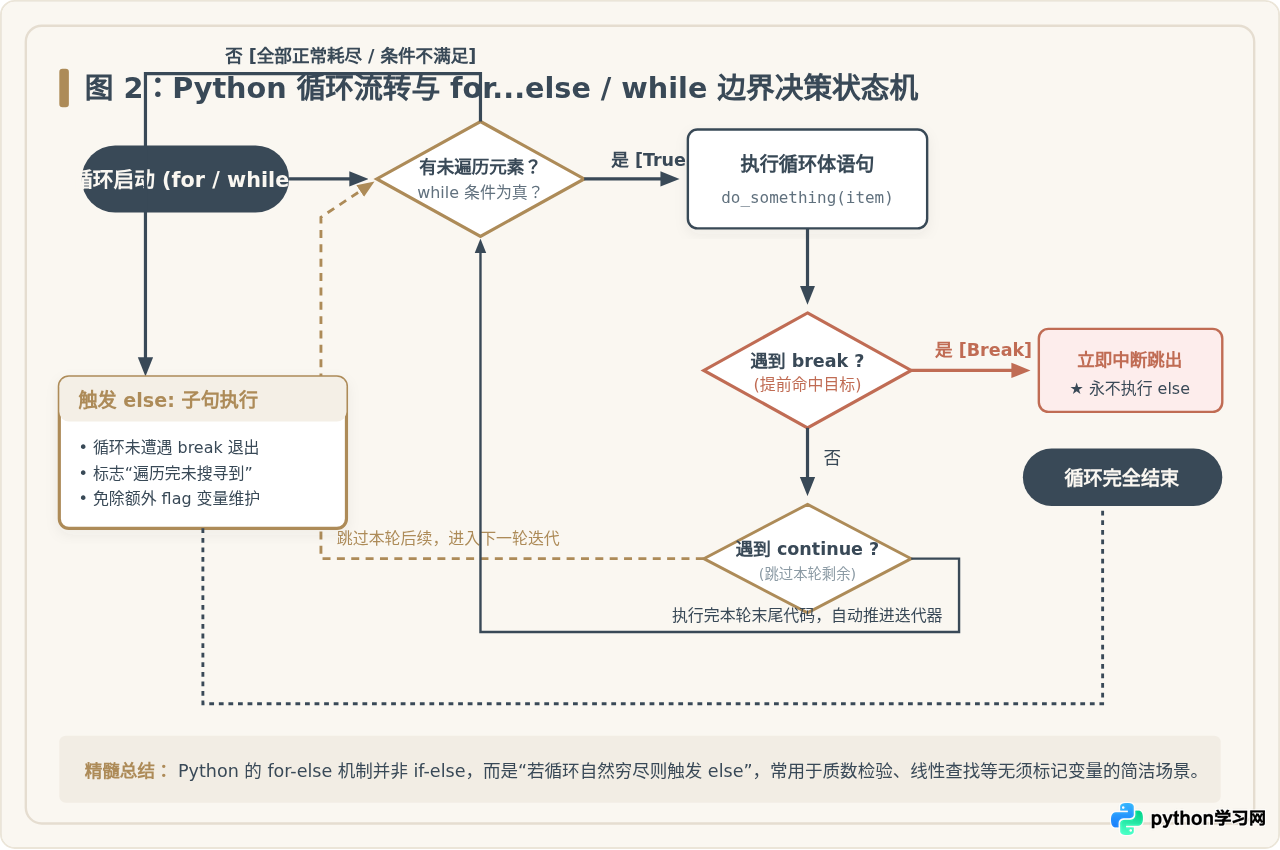
Python 的循环包括 for 遍历与 while 条件判断。除了常规的计数递增,最容易让初学者产生理解偏差的是 for...else 结构 以及在遍历集合时同步删除元素所产生的索引偏移。
练习题 3:区间质数筛选与 for...else 搜索结构
【题目要求】 给定数字区间 [start, end],例如 [10, 30]。请编写代码找出区间内的所有质数(素数)。
- 必须使用双重循环:外层遍历待检验数字,内层遍历可能的因数;
- 内层循环使用数学优化:仅需检测到
int(num ** 0.5) + 1即可提前终止; - 严禁使用任何外部布尔标记(如
is_prime = True),必须利用 Python 原生的for...else语法完成非质数判定与质数收纳。
def find_primes(start: int, end: int) -> list[int]:
    primes = []

    # 边界纠正:质数必须大于等于 2
    actual_start = max(2, start)

    for num in range(actual_start, end + 1):
        # 尝试寻找因数,若能被整除则说明不是质数
        for factor in range(2, int(num ** 0.5) + 1):
            if num % factor == 0:
                break  # 命中因数,立刻中断内层循环
        else:
            # 只有当内层循环正常执行完毕、未遭遇任何 break 时,才会触发 else
            primes.append(num)

    return primes

result = find_primes(10, 30)
print(f"区间 [10, 30] 内的质数列表为: {result}")for...else 当作 if...else 理解!在循环中,else 分支的含义是:“若本循环在没有任何 break 干扰下自然迭代完毕,则执行该分支”。如果循环被 break 提前打断,else 将被彻底跳过。
练习题 4:while 哨兵守卫与迭代中动态删除的“跳项”Bug 排查
【题目要求】 现有一份待清洗的用户输入数据列表:data = [12, 0, 0, 45, 0, 78, 90, 0]。需求是将列表中的所有 0 清除。
- 分析初学者常写代码:
for item in data: if item == 0: data.remove(item)为什么无法完全删掉所有 0,指出具体原因; - 分别给出两种正确的工程解决思路:① 使用
while循环结合动态指针;② 使用列表推导式构建新数据流; - 对比两者的执行效率与安全性。
# 1. 错误复现演示
buggy_data = [12, 0, 0, 45, 0, 78, 90, 0]
for item in buggy_data:
    if item == 0:
        buggy_data.remove(item)
print("直接遍历删除的错误残留结果:", buggy_data)
# 输出: [12, 0, 45, 78, 90],连续的第二个 0 被跳过了!

# 2. 解决方案 A:while 循环精确控制下标
clean_data_while = [12, 0, 0, 45, 0, 78, 90, 0]
i = 0
while i < len(clean_data_while):
    if clean_data_while[i] == 0:
        clean_data_while.pop(i)  # 删除当前元素后,不自增 i,原位重检
    else:
        i += 1                  # 仅当元素保留时才后移指针
print("while 循环精确清洗结果:", clean_data_while)

# 3. 解决方案 B:列表推导式构建纯净副本(最佳实践)
raw_source = [12, 0, 0, 45, 0, 78, 90, 0]
clean_data_comp = [x for x in raw_source if x != 0]
print("列表推导式过滤结果:", clean_data_comp)while 循环精确清洗结果: [12, 45, 78, 90]
列表推导式过滤结果: [12, 45, 78, 90]
for 循环基于内部隐式索引迭代。当在索引 1 处删除了第一个 0 之后,后面的元素自动往前平移,原本处于索引 2 的第二个 0 顺势前移到了索引 1。在下一轮循环中,迭代器直接访问索引 2,恰好把移入索引 1 的第二个 0 完美漏检!因此,在循环遍历集合时,绝对不要原位增加或减少该集合的元素数量。
第三部分:函数设计与参数传递解密
函数是构建复杂逻辑模块的核心。Python 函数是头等对象(First-class Object),具有极强的表达力。然而,函数的参数默认值求值时机与变量查找范围(LEGB 规则)往往是隐蔽 Bug 的多发地带。
练习题 5:可变默认参数“幽灵持久化”陷阱与动态参数转发
【题目要求】 设计一个任务日志归档函数 append_task(task_name, tags=[])。
- 展示当连续调用
append_task("Task 1")与append_task("Task 2")且不传入tags时,默认参数在多次调用间相互污染的现象; - 使用 Python 推荐的不可变哨兵值(
None)修复此漏洞; - 拓展该函数,使其支持任意不定长位置参数(
*metadata)与关键字参数(**attributes)的接收与统一规范化输出。
# 1. 缺陷代码演示:默认参数为可变列表
def flawed_append_task(task_name: str, tags: list = []):
    tags.append(task_name)
    return tags

print("缺陷调用 1:", flawed_append_task("Order_Paid"))
print("缺陷调用 2:", flawed_append_task("Order_Shipped"))
# 发现调用 2 返回了 ['Order_Paid', 'Order_Shipped'],历史数据被保留了!

# 2. 正规修复与动态参数扩展
def safe_append_task(task_name: str, tags: list = None, *metadata, **attributes) -> dict:
    # 使用 None 作为不可变哨兵,在调用时按需创建独立新容器
    if tags is None:
        tags = []
    else:
        tags = list(tags)  # 若传入外部列表,拷贝一份避免外部污染

    tags.append(task_name)

    # 组装返回数据结构
    record = {
        "task": task_name,
        "tags": tags,
        "meta_count": len(metadata),
        "extra_info": attributes
    }
    return record

# 测试安全函数
res1 = safe_append_task("Task_Alpha", None, "v1.0", "internal", priority="High")
res2 = safe_append_task("Task_Beta", None, priority="Low")

print("\n安全调用结果 1:", res1)
print("安全调用结果 2:", res2)缺陷调用 2: ['Order_Paid', 'Order_Shipped']
安全调用结果 1: {'task': 'Task_Alpha', 'tags': ['Task_Alpha'], 'meta_count': 2, 'extra_info': {'priority': 'High'}}
安全调用结果 2: {'task': 'Task_Beta', 'tags': ['Task_Beta'], 'meta_count': 0, 'extra_info': {'priority': 'Low'}}
__defaults__ 属性元组中。如果默认值是列表或字典,后续所有没有传参的调用都会引用同一个容器对象,导致数据跨调用常驻。因此,函数默认参数必须使用不可变对象(如 None、数字或字符串)。
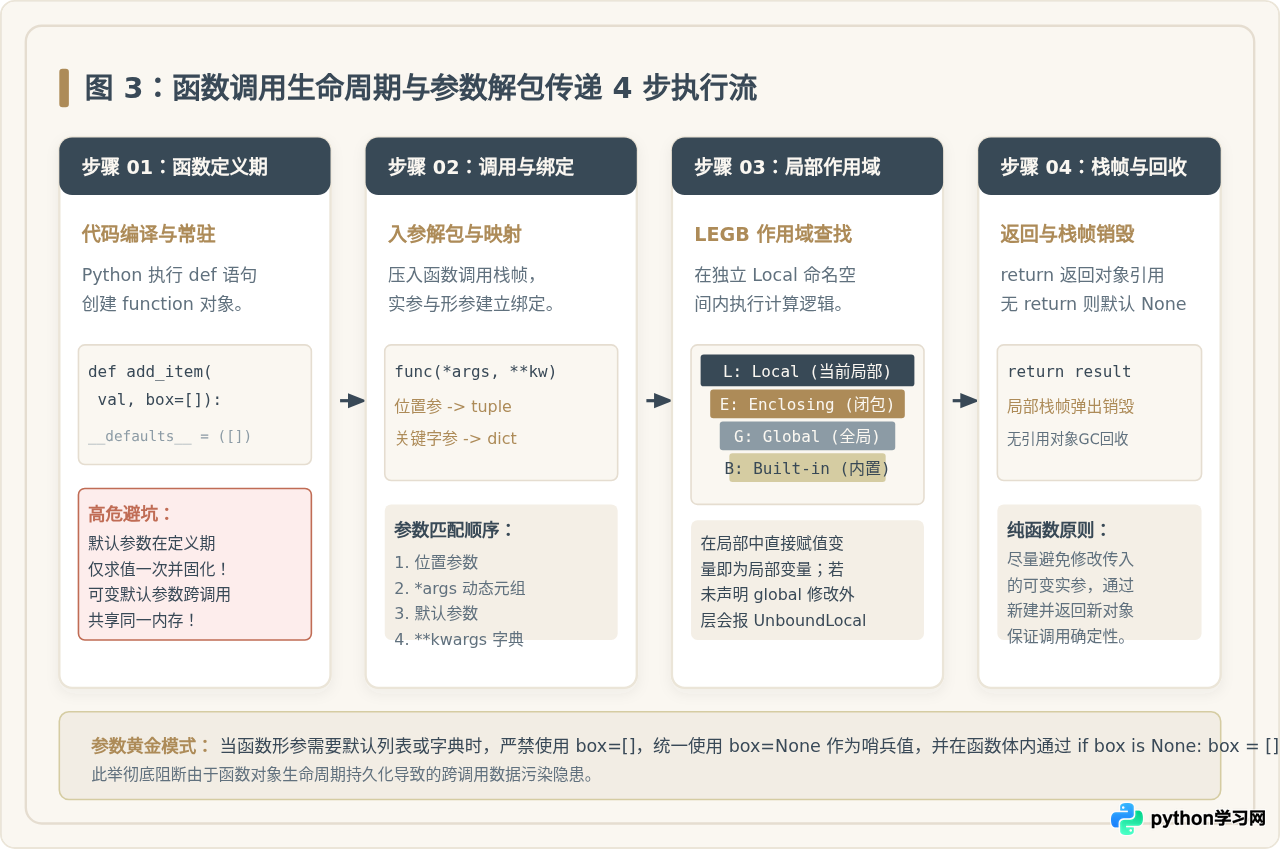
练习题 6:作用域嵌套查找(LEGB)、闭包工厂与 UnboundLocalError 修复
【题目要求】 在实际编程中,编写内部函数访问外部变量时常常触发 UnboundLocalError。
- 复现以下错误:外部定义全局变量
counter = 100,在函数内先执行print(counter),紧接着执行counter = 200,解释为何会报错; - 设计一个闭包计数器工厂函数
create_counter(initial=0),返回一个累加函数。每次调用累加函数增加步长step(默认为 1),并正确使用nonlocal关键字管理外层闭包状态; - 验证两个独立生成的计数器互不干扰。
# 1. 作用域错误成因解析
# def trigger_scope_bug():
#     print(counter)   # UnboundLocalError: local variable 'counter' referenced before assignment
#     counter = 200    # Python 编译期发现本作用域有赋值操作,自动将 counter 标为局部变量

# 2. 闭包计数器工厂实现
def create_counter(initial: int = 0):
    current = initial

    def counter_increment(step: int = 1) -> int:
        nonlocal current  # 明确声明引用外层非全局函数的局部变量
        current += step
        return current

    return counter_increment

# 创建两个互相独立的计数器实例
counter_a = create_counter(10)
counter_b = create_counter(50)

print("Counter A 第一次累加 (+2):", counter_a(2))
print("Counter A 第二次累加 (+3):", counter_a(3))
print("Counter B 第一次累加 (+10):", counter_b(10))
print("Counter A 状态保持独立:", counter_a(1))Counter A 第二次累加 (+3): 15
Counter B 第一次累加 (+10): 60
Counter A 状态保持独立: 16
UnboundLocalError。若需修改上层闭包变量必须显式使用 nonlocal,若需修改模块顶级变量则必须声明 global。
第四部分:三大核心三维协同与实战综合演练
变量、循环与函数并非孤立存在,真实的业务代码往往是将三者融合编织:函数负责封装业务边界与数据转换管线,循环负责状态推进与批量过滤,而变量负责在内存中稳定存储状态。
练习题 7:综合实战——电商交易流水多条件过滤与聚合统计报表
【题目要求】 现有未经清洗的电商多批次支付流水数据。每笔交易包含:order_id(订单编号)、user_id(用户ID)、amount(金额)、channel(支付渠道:'alipay', 'wechat', 'unionpay')以及 status(状态:'success', 'failed', 'refunded')。
请编写一个模块化函数 generate_channel_report(transactions, min_amount=0.0),要求:
- 纯函数实现:严禁修改传入的原始交易列表;
- 使用循环与条件控制:过滤掉所有非
'success'订单以及金额低于min_amount的订单; - 聚合各渠道的总成交金额、有效成单数、独立付费用户数(使用 set 自动去重)以及平均客单价;
- 处理边界异常:若某个渠道没有任何有效成交,客单价必须安全返回
0.0,严防除零异常(ZeroDivisionError)。
def generate_channel_report(transactions: list[dict], min_amount: float = 0.0) -> dict:
    """
    聚合统计各支付渠道业务指标的纯函数
    """
    # 初始化报表容器
    channel_stats = {}

    for tx in transactions:
        # 解构获取变量
        status = tx.get("status")
        amount = tx.get("amount", 0.0)
        channel = tx.get("channel", "unknown")
        user = tx.get("user_id")

        # 1. 过滤未成功或低于门槛的订单
        if status != "success" or amount < min_amount:
            continue

        # 2. 初始化渠道状态字典(若初次遇到)
        if channel not in channel_stats:
            channel_stats[channel] = {
                "total_amount": 0.0,
                "order_count": 0,
                "unique_users": set()  # 利用集合快速去重
            }

        # 3. 累加指标数据
        channel_stats[channel]["total_amount"] += amount
        channel_stats[channel]["order_count"] += 1
        channel_stats[channel]["unique_users"].add(user)

    # 4. 二次计算平均指标并格式化输出结构
    final_report = {}
    for ch, stats in channel_stats.items():
        count = stats["order_count"]
        total = stats["total_amount"]

        # 规避除零异常
        avg_ticket = round(total / count, 2) if count > 0 else 0.0

        final_report[ch] = {
            "total_revenue": round(total, 2),
            "paid_orders": count,
            "paying_users": len(stats["unique_users"]),
            "avg_ticket": avg_ticket
        }

    return final_report

# 真实模拟流水测试
sample_transactions = [
    {"order_id": "T001", "user_id": "U101", "amount": 150.0, "channel": "alipay", "status": "success"},
    {"order_id": "T002", "user_id": "U102", "amount": 80.0,  "channel": "wechat", "status": "failed"},
    {"order_id": "T003", "user_id": "U101", "amount": 200.0, "channel": "alipay", "status": "success"},
    {"order_id": "T004", "user_id": "U103", "amount": 320.0, "channel": "wechat", "status": "success"},
    {"order_id": "T005", "user_id": "U104", "amount": 40.0,  "channel": "alipay", "status": "success"},
    {"order_id": "T006", "user_id": "U103", "amount": 180.0, "channel": "wechat", "status": "success"},
]

report = generate_channel_report(sample_transactions, min_amount=50.0)

print(f"{'渠道':<10} | {'总营收':<10} | {'有效订单':<8} | {'付费人数':<8} | {'客单价':<8}")
print("-" * 56)
for ch, data in report.items():
print(f"{ch:<10} | ¥{data['total_revenue']:<9.2f} | {data['paid_orders']:<12} | {data['paying_users']:<12} | ¥{data['avg_ticket']:.2f}")--------------------------------------------------------
alipay | ¥350.00 | 2 | 1 | ¥175.00
wechat | ¥500.00 | 2 | 1 | ¥250.00
- 防御式编程:使用
dict.get()安全提取键值,即使某行日志缺失字段也不会触发KeyError崩溃。 - 空间换时间去重:在循环聚合时,使用原生的
set()收集user_id,添加元素时间复杂度为 \(O(1)\),在循环终点通过len(set)即可秒级得出准确独立访客数。 - 条件短路优化:
if status != "success" or amount < min_amount: continue在循环体最开头快速拦截无效数据,减少无效的嵌套分支。
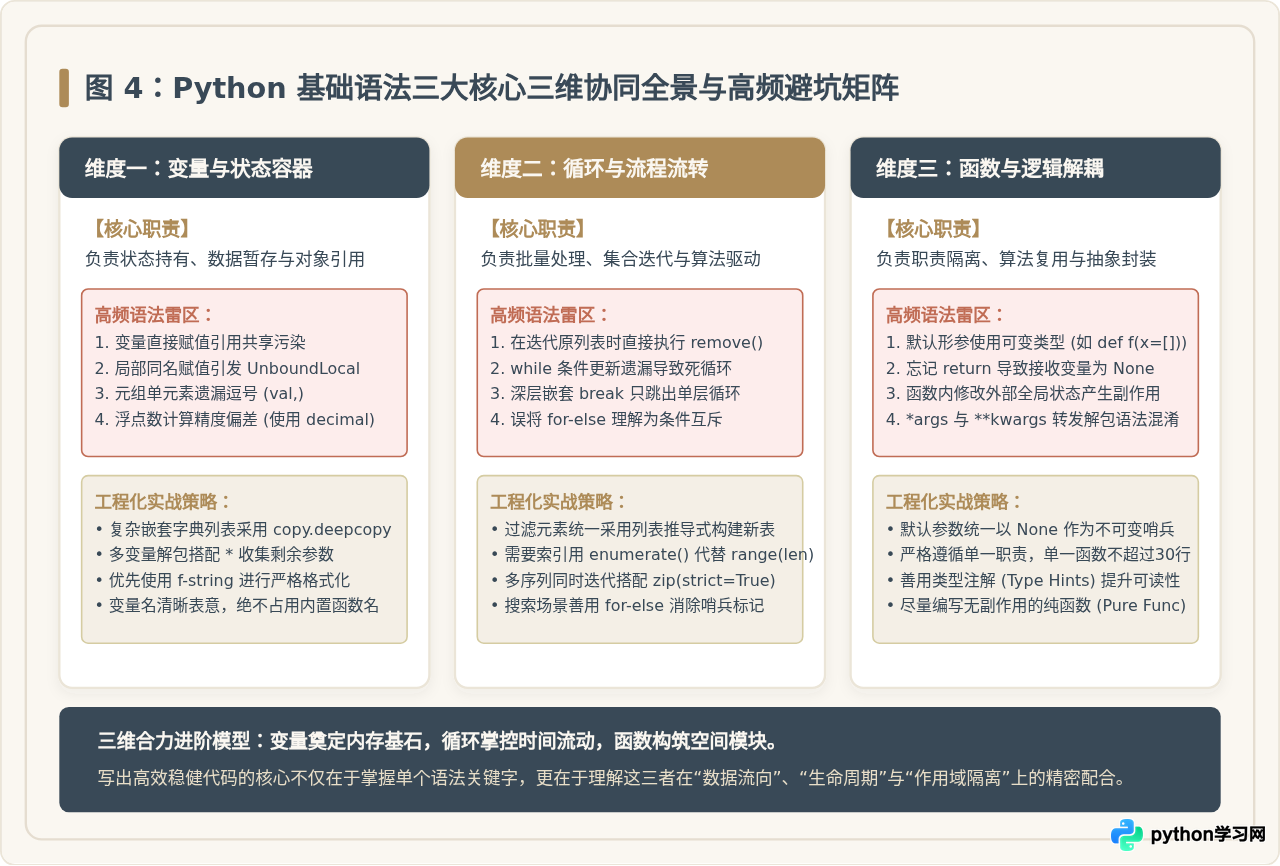
第五部分:核心基础语法避坑速查表
| 语法维度 | 高频错误代码写法 | 典型报错 / 隐患后果 | 推荐安全工程写法 |
|---|---|---|---|
| 变量与引用 | list_b = list_a |
共享内存别名,修改 b 导致 a 同步被污染 | list_b = list_a.copy() 或 deepcopy() |
| 变量与作用域 | 在局部先使用变量,后面再同名赋值 | 抛出 UnboundLocalError |
遵循 LEGB 规则,必要时使用 nonlocal 或传递入参 |
| 循环与集合 | for x in lst: lst.remove(x) |
索引向前平移,造成连续相同元素漏删 | 使用推导式新建列表:[x for x in lst if cond] |
| 循环搜索分支 | 维护布尔变量 found = False 标记搜寻 |
代码臃肿,嵌套深,易出现标志位更新遗漏 | 善用 for...else,未遇到 break 自然执行 else |
| 函数参数设计 | def func(item, cache=[]) |
默认参数只编译一次,跨调用共享同一容器 | 使用哨兵:def func(item, cache=None) |
| 函数返回值 | 函数分支中遗漏 return 语句 |
调用方接收到隐式返回的 None 引发后续异常 |
每个分支均显式返回明确类型数据 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















