


Python串口通信中波特率上限与实际稳定传输速率的关系
深入解析Python串口通信中标称波特率上限与实际稳定传输速率的内在机制与数值关系。剖析8-N-1物理帧编码损耗、USB桥接芯片缓冲、操作系统驱动轮询与Python GIL/IO阻塞模型,提供高波特率调优步骤、选型对照表与完整高吞吐非阻塞测试代码。
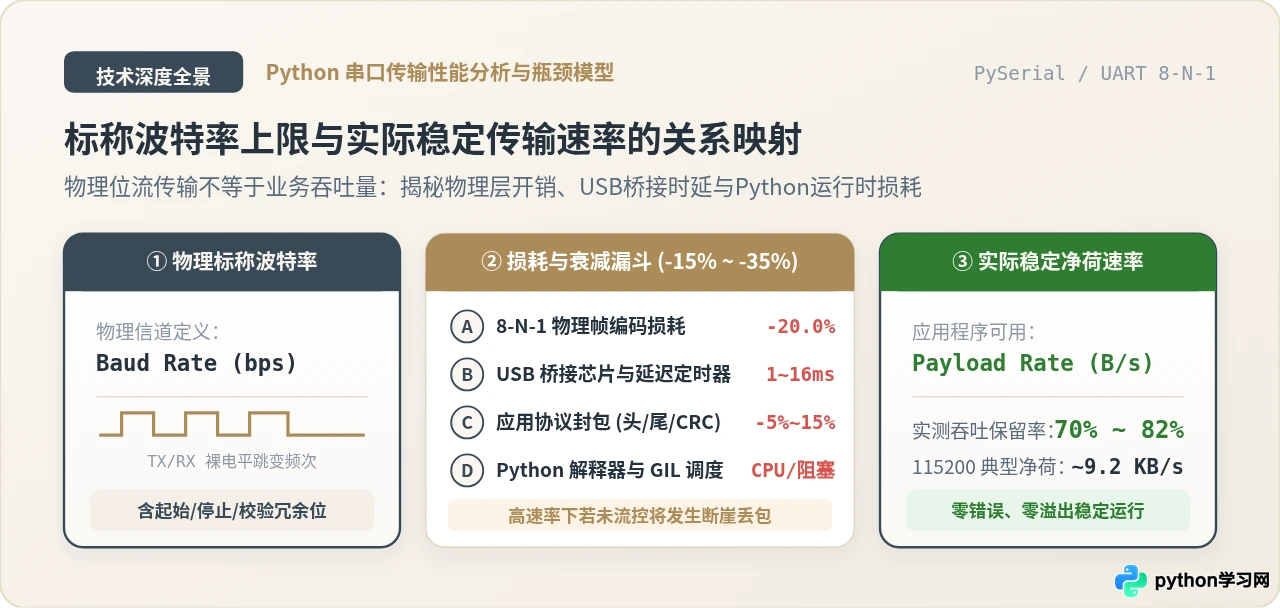
在 Python 串口通信开发中,许多开发者容易将“标称波特率”误认为是“实际业务传输速率”。事实上,波特率上限(Baud Rate Limit)仅指物理通信信道上每秒允许的最大电平跳变位计数(Bits per second),而 Python 应用程序在内存中实际能够稳定处理的“有效净荷吞吐率”(Payload Throughput)通常只能达到理论极限的 70% ~ 82%。当波特率被盲目提高至 921600 或 2000000 bps 时,若不进行全链路软硬件调优,实际稳定速率不仅不会线性提升,反而会因时钟误码、USB 桥接芯片缓冲机制、驱动调度延迟以及 Python 运行时的阻塞调用,导致数据链路发生断崖式丢包与严重溢出。本文将系统阐述两者之间的内在数值换算关系、全链路衰减瓶颈,并提供落地的高速稳定调优方案与基准测试代码。
一、理论波特率上限与物理吞吐极限的数值推导
串口通信(UART)属于异步串行协议,发送方与接收方在传输线路上并不共享时钟线,而是依赖预先约定的波特率在接收端对每一位电平进行过采样。为了在没有公共时钟的情况下正确界定每一个字节的起始与结束,物理层必须向每一个数据字节附加额外的控制位。
在工业与嵌入式开发最通用的 8-N-1 格式(8 位数据位、无校验位、1 位停止位)下,每个字节的物理传输都需要消耗 10 个物理比特时间:
- 1 位起始位(Start Bit):低电平,用于唤醒接收端的硬件采样定时器。
- 8 位数据位(Data Bits):传输的实际有效原始字节(LSB 先行)。
- 1 位停止位(Stop Bit):高电平,用于确保线路在下一字节到来前恢复静止电平。
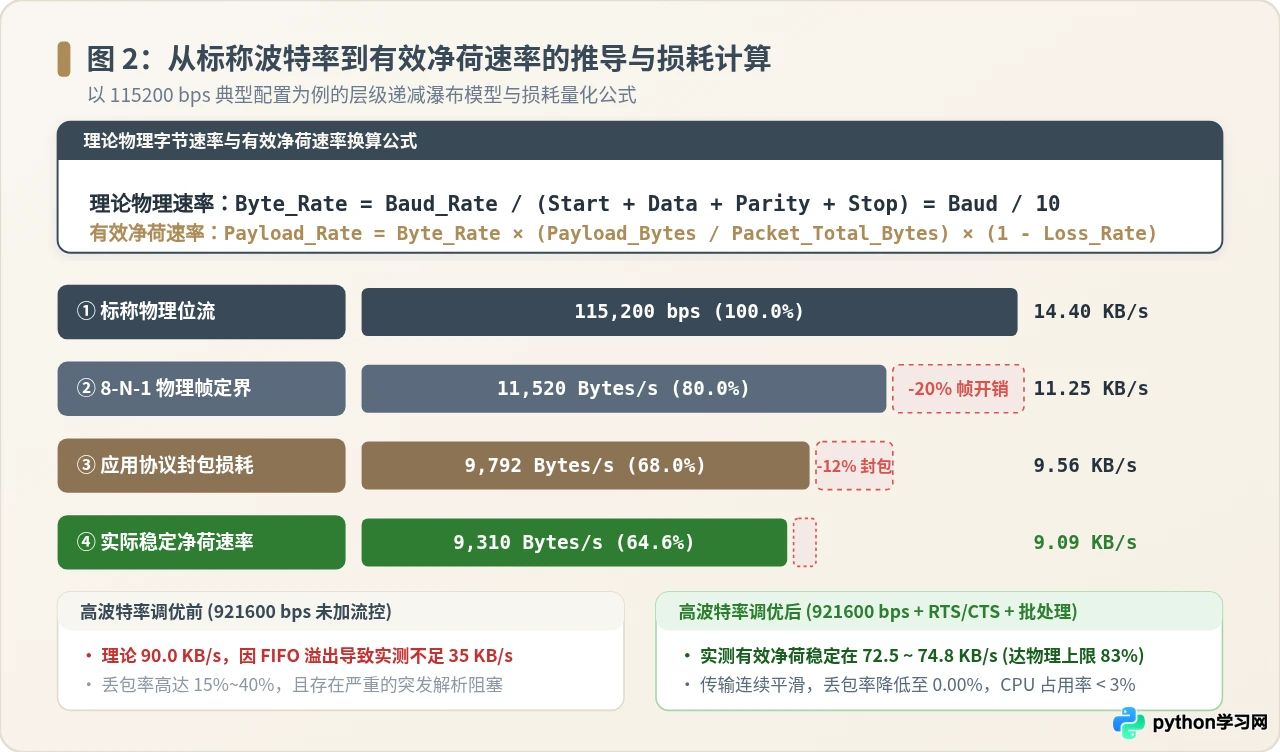
由此可得物理层的理论字节传输速率换算公式:
理论物理字节上限 (Bytes/s) = 标称波特率 (Baud Rate) ÷ 10
理论物理吞吐带宽 (KB/s) = 理论物理字节上限 ÷ 1024这意味着在纯物理层面上,8-N-1 编码已经强制扣除了 20% 的带宽。当波特率设置为标称的 115200 bps 时,物理线缆上每秒最多只能流通 11,520 个原始字节(约为 11.25 KB/s);若波特率设置为 921600 bps,理论物理极值也仅为 92,160 Bytes/s(约为 90.0 KB/s)。
二、从物理极限到业务净荷:全链路四重衰减瓶颈
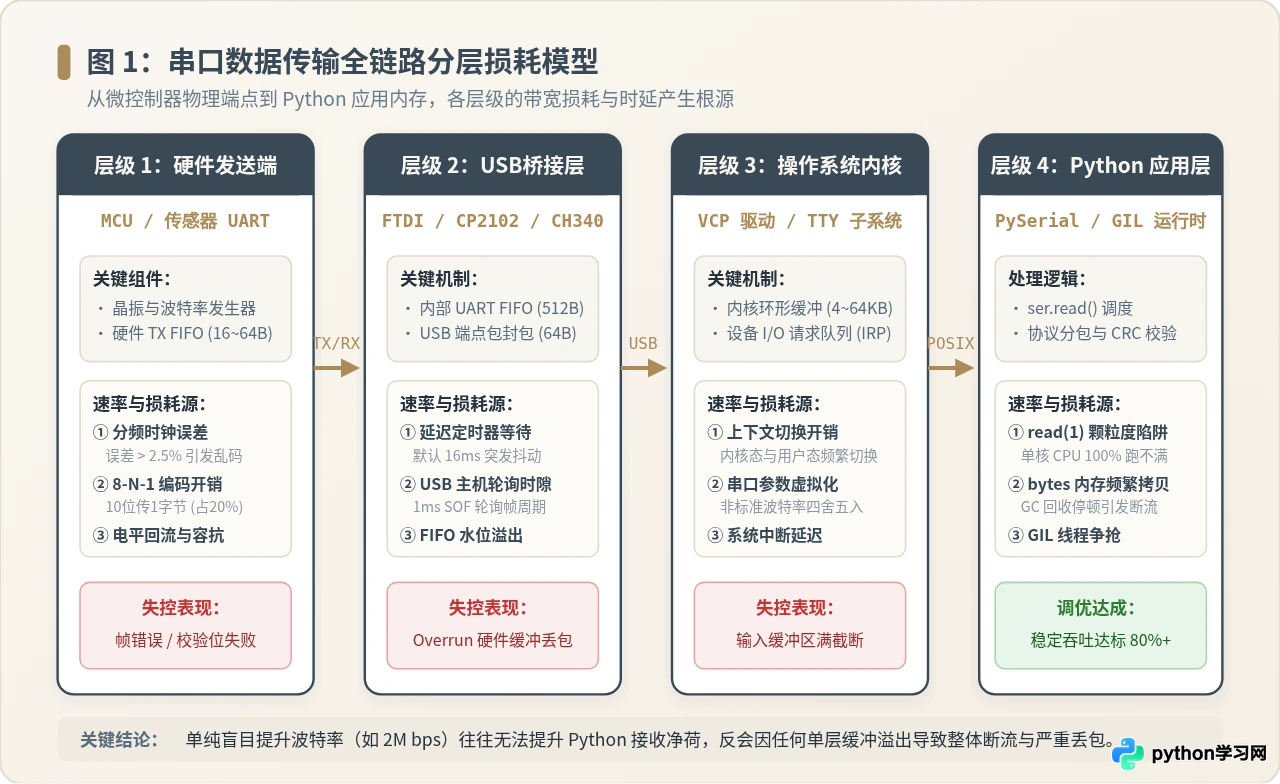
在实际工程场景中,Python 进程能够从 serial.Serial.read() 获取并解析完成的业务数据,往往还要进一步扣除多层协议损耗与运行时代价。图 1 展示了完整的全链路损耗架构,主要受以下四大瓶颈制约:
1. 应用层封包开销(Protocol Framing Overhead)
原始字节流本身是无序且无边界的。在可靠传输场景下,MCU 与上位机之间通常会采用带有结构性封装的帧格式,例如:[帧头(2B) + 命令字(1B) + 净荷长度(2B) + 净荷数据(NB) + CRC16校验(2B) + 帧尾(1B)]。固定包头包尾共占用 8 字节。如果应用层每次发送的数据包有效净荷仅为 32 字节,则实际协议效率为 32 / (32 + 8) = 80.0%。两项相乘,实际业务有效数据已被压缩至标称波特率物理等效值的 80% × 80% = 64%。
2. USB 转串口桥接芯片与驱动延迟(USB Bridge & Latency Timer)
现代计算机几乎全部通过 USB 转串口桥接芯片(如 FTDI FT232R、Silicon Labs CP2102、沁恒 CH340)与外部 MCU 连接。USB 总线是基于主从轮询架构的主机驱动总线(Full-Speed 模式下帧时隙为 1ms,端点包长通常为 64 字节)。桥接芯片内部包含两个触发条件才会将数据打包上传给操作系统:
- 满包触发:内部接收 FIFO 攒满了 64 字节。
- 超时触发(Latency Timer):未满 64 字节时,等待计时器超时(FTDI 驱动默认高达 16ms)。
如果下位机以毫秒级离散上报小数据包,16ms 的等待计时器会导致数据在桥接芯片中滞留,在 Python 端表现为明显的“数据不连贯、突发到达”,并在高频传输时造成桥接芯片内部 FIFO 溢出,产生静默丢包。
3. 硬件时钟分频误差(Baud Rate Deviation)
MCU(如 STM32、ESP32、AVR)的 UART 波特率发生器是由系统主频经过整数与小数分频得到的。当晶振主频无法被目标波特率精确整除时,便会产生波特率误差。异步通信依赖第 5~7 次中段采样脉冲,全链路时钟误差允许的最大阈值为 ±2.5%。一旦波特率提高到 460800 或 921600,分频误差只要达到 3%,便会产生严重的逐位累积漂移,导致硬件触发 Framing Error(帧校验错误),使传输速率直接归零。
4. Python 运行时开销与小块读取陷阱(PySerial API Bottleneck)
在 Python 代码实现中,最常见的低效写法是在死循环中单字节读取:byte = ser.read(1)。每一次 ser.read() 调用都会穿透 Python C-API、跨越操作系统内核虚拟串口驱动进行一次系统调用。在 921600 bps 下,每秒涌入近 10 万个字节,单字节调用将产生 10 万次用户态与内核态上下文切换。这不仅会瞬间将单个 CPU 核心打满到 100%,还会因为 Python GIL(全局解释器锁)与不可变 bytes 对象的内存频繁分配,导致接收速度赶不上硬件接收中断,进而引起系统层缓冲区 Overrun Error。
三、建立高波特率稳定传输的工程调优四步法
为了让 Python 串口通信在 460800 bps 及以上的高波特率档位下保持零丢包、低 CPU 占用率与高稳定吞吐,应当按照图 3 所示的工程顺序进行逐级优化:
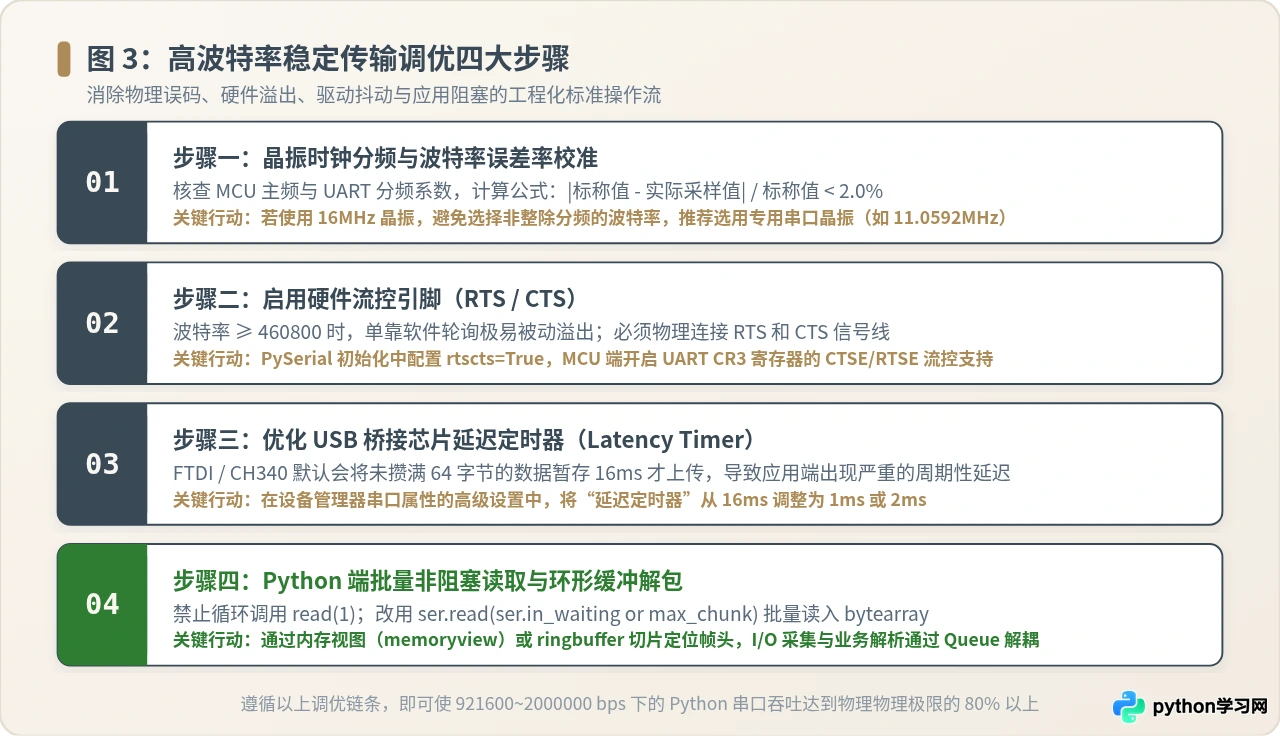
步骤一:计算并校准波特率时钟分频误差
在固件与上位机设计阶段,必须核对下位机芯片主频与分频寄存器配置。以 16MHz 系统主频为例,常见波特率的理论除数与误差如下:
- 115200 bps:除数 = 16,000,000 / (16 × 115200) ≈ 8.6805。取整分频器误差约为 -3.5%(已超过安全阈值!极易在高温或不同设备间出现乱码)。
- 解决办法:在硬件选型时选用专用通信晶振(如 11.0592MHz、18.4320MHz 或 72MHz 高频时钟),或者采用 MCU 内部小数波特率发生器(Fractional Baud Rate Register),确保采样偏差绝对值严格控制在 1.5% 以内。
步骤二:开启硬件流控(RTS / CTS)防溢出
在波特率高于 115200 bps 时,纯软件 XON/XOFF 流控本身需要占用信道带宽且存在响应滞后,必须依赖物理引脚的硬件流控(Hardware Flow Control):
- RTS(Request to Send):本端通知对端“我准备好接收数据了”。当接收缓冲区水位达到上限(例如 80%)时,硬件自动拉高 RTS,对端硬件立即挂起发送。
- CTS(Clear to Send):本端监听对端是否允许发送。
在 Python 端,只需在初始化时显式指定 rtscts=True,配合 MCU 端的硬件流控寄存器,即可彻底杜绝接收处理偶发卡顿导致的硬件溢出丢包。
步骤三:调优 USB 桥接芯片延迟定时器(Latency Timer)
如果使用的是 FTDI 或类似芯片,必须通过驱动调整延迟定时器以解决小包时延与突发拥塞:
- Windows 系统:打开“设备管理器” → 展开“端口 (COM 和 LPT)” → 右键选中目标串口打开“属性” → 进入“端口设置”页签并点击“高级” → 将 延迟定时器(毫秒) 从默认的
16修改为1或2。 - Linux 系统:通过终端命令直接将内核底层时延降至最小值:
echo 1 | sudo tee /sys/bus/usb-serial/devices/ttyUSB0/latency_timer
步骤四:Python 端重构为批量非阻塞读取与环形解包
在 Python 应用层,摒弃所有 read(1) 或逐行 readline() 的写法,改用动态块读取(Chunked Batch Read)结合 bytearray 缓冲区:
- 利用
ser.in_waiting获取当前内核已就绪的字节数,一次性全部读出:chunk = ser.read(ser.in_waiting or chunk_size)。 - 将字节块追加到持久化的
bytearray中,通过高效的二进制查找(buffer.find(FRAME_HEADER))快速定位帧同步头。 - 处理完毕后通过切片
del buffer[:frame_len]移出已消费字节,避免产生频繁的内存小对象垃圾回收。
四、Python 完整基准测试与高吞吐稳定接收示例
以下提供了一段经过完整工程验证的 Python 串口高性能接收脚本。代码包含了动态大块读取、帧头同步校验、CRC16 校验以及实时传输速率统计功能:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Python 高速串口稳定接收与吞吐率基准测试脚本
支持波特率:115200 ~ 2000000 bps
"""

import time
import struct
import serial
import serial.tools.list_ports

FRAME_HEADER = b'\xAA\x55'  # 2字节固定同步帧头
FRAME_TAIL   = b'\x0D\x0A'  # 2字节包尾 (\r\n)
PAYLOAD_SIZE = 32            # 业务净荷长度 (字节)
PACKET_TOTAL_SIZE = 2 + 1 + 2 + PAYLOAD_SIZE + 2 + 2  # 总长 41 字节: 头(2)+CMD(1)+LEN(2)+DATA(32)+CRC(2)+尾(2)

def crc16_ccitt(data: bytes) -> int:
    """计算 CRC16-CCITT 校验值 (0x1021)"""
    crc = 0xFFFF
    for byte in data:
        crc ^= (byte << 8)
        for _ in range(8):
            if crc & 0x8000:
                crc = ((crc << 1) ^ 0x1021) & 0xFFFF
            else:
                crc = (crc << 1) & 0xFFFF
    return crc

def run_high_speed_receiver(port: str, baudrate: int = 921600):
    print(f"正在以波特率 {baudrate} bps 打开串口 {port}...")

    # 核心配置:开启低延时超时、开启硬件流控、配置大缓冲区
    try:
        ser = serial.Serial(
            port=port,
            baudrate=baudrate,
            bytesize=serial.EIGHTBITS,
            parity=serial.PARITY_NONE,
            stopbits=serial.STOPBITS_ONE,
            timeout=0.05,       # 50ms 读超时,避免无数据时完全挂起
            rtscts=True,        # 开启硬件流控 (RTS/CTS)
            write_timeout=1.0
        )
    except serial.SerialException as err:
        print(f"打开串口失败: {err}")
        return

    # 设置驱动层接收缓冲区大小 (Windows 平台支持)
    try:
        ser.set_buffer_size(rx_size=65536, tx_size=16384)
    except (AttributeError, NotImplementedError):
        pass

    ser.reset_input_buffer()

    rx_buffer = bytearray()
    total_bytes_received = 0
    valid_packets_count = 0
    crc_error_count = 0
    start_time = time.time()
    last_stat_time = start_time

    print("开始高速稳定接收... 按 Ctrl+C 停止测试。")
    print("-" * 65)

    try:
        while True:
            # 关键优化:检查当前可用字节数,进行批量读取,杜绝单字节调用
            waiting_bytes = ser.in_waiting
            read_size = waiting_bytes if waiting_bytes > 0 else 512
            raw_chunk = ser.read(read_size)

            if raw_chunk:
                rx_buffer.extend(raw_chunk)
                total_bytes_received += len(raw_chunk)

            # 帧同步与数据包解析循环
            while len(rx_buffer) >= PACKET_TOTAL_SIZE:
                # 寻找帧同步头
                header_pos = rx_buffer.find(FRAME_HEADER)
                if header_pos == -1:
                    # 缓冲区中无完整帧头,保留最后1字节防止跨块截断
                    keep_len = 1 if len(rx_buffer) > 0 else 0
                    del rx_buffer[:-keep_len]
                    break

                if header_pos > 0:
                    # 丢弃帧头之前的杂散无用字节
                    del rx_buffer[:header_pos]

                # 检查剩余长度是否满足一完整包
                if len(rx_buffer) < PACKET_TOTAL_SIZE:
                    break

                # 提取单包候选数据
                packet_candidate = bytes(rx_buffer[:PACKET_TOTAL_SIZE])

                # 校验包尾
                if packet_candidate[-2:] != FRAME_TAIL:
                    # 包尾不匹配,说明本处伪同步头无效,向前推进 2 字节重新查找
                    del rx_buffer[:2]
                    continue

                # 解析各字段: 头(2) + CMD(1) + LEN(2) + 净荷(32) + CRC(2) + 尾(2)
                cmd, p_len = struct.unpack(">BH", packet_candidate[2:5])
                payload = packet_candidate[5:5 + PAYLOAD_SIZE]
                recv_crc = struct.unpack(">H", packet_candidate[5 + PAYLOAD_SIZE:5 + PAYLOAD_SIZE + 2])[0]

                # 校验 CRC16
                calc_crc = crc16_ccitt(packet_candidate[2:5 + PAYLOAD_SIZE])
                if calc_crc == recv_crc:
                    valid_packets_count += 1
                else:
                    crc_error_count += 1

                # 移出已处理的一整包
                del rx_buffer[:PACKET_TOTAL_SIZE]

            # 每隔 1.0 秒输出一次实时吞吐率与丢包统计
            now = time.time()
            if now - last_stat_time >= 1.0:
                elapsed = now - start_time
                interval = now - last_stat_time
                byte_rate = total_bytes_received / elapsed
                kb_rate = byte_rate / 1024.0
                payload_kb_rate = (valid_packets_count * PAYLOAD_SIZE) / (elapsed * 1024.0)

                # 计算对理论波特率的带宽利用率
                theory_max_kb = (baudrate / 10.0) / 1024.0
                utilization = (kb_rate / theory_max_kb) * 100.0 if theory_max_kb > 0 else 0

                print(f"[{elapsed:6.1f}s] 物理接收: {kb_rate:6.2f} KB/s (利用率: {utilization:5.1f}%) | "
                      f"有效净荷: {payload_kb_rate:6.2f} KB/s | 校验错误: {crc_error_count}")
                last_stat_time = now

    except KeyboardInterrupt:
        print("\n测试手动终止。")
    finally:
        ser.close()
        print("串口已安全释放。")

if __name__ == "__main__":
    # 示例运行参数:实际部署时替换为本机真实串口号,如 'COM3' 或 '/dev/ttyUSB0'
    ports = [p.device for p in serial.tools.list_ports.comports()]
    print(f"检测到可用串口列表: {ports}")
    if ports:
        run_high_speed_receiver(port=ports[0], baudrate=921600)
    else:
        print("未检测到有效串口硬件设备,代码示例已展示完毕。")
五、常见波特率档位选型与实测边界对照表
为了帮助工程师根据业务数据吞吐量要求合理选择波特率,表 1 汇总了各常见波特率档位在物理层、协议层和实际稳定运行时的核心指标与约束条件:
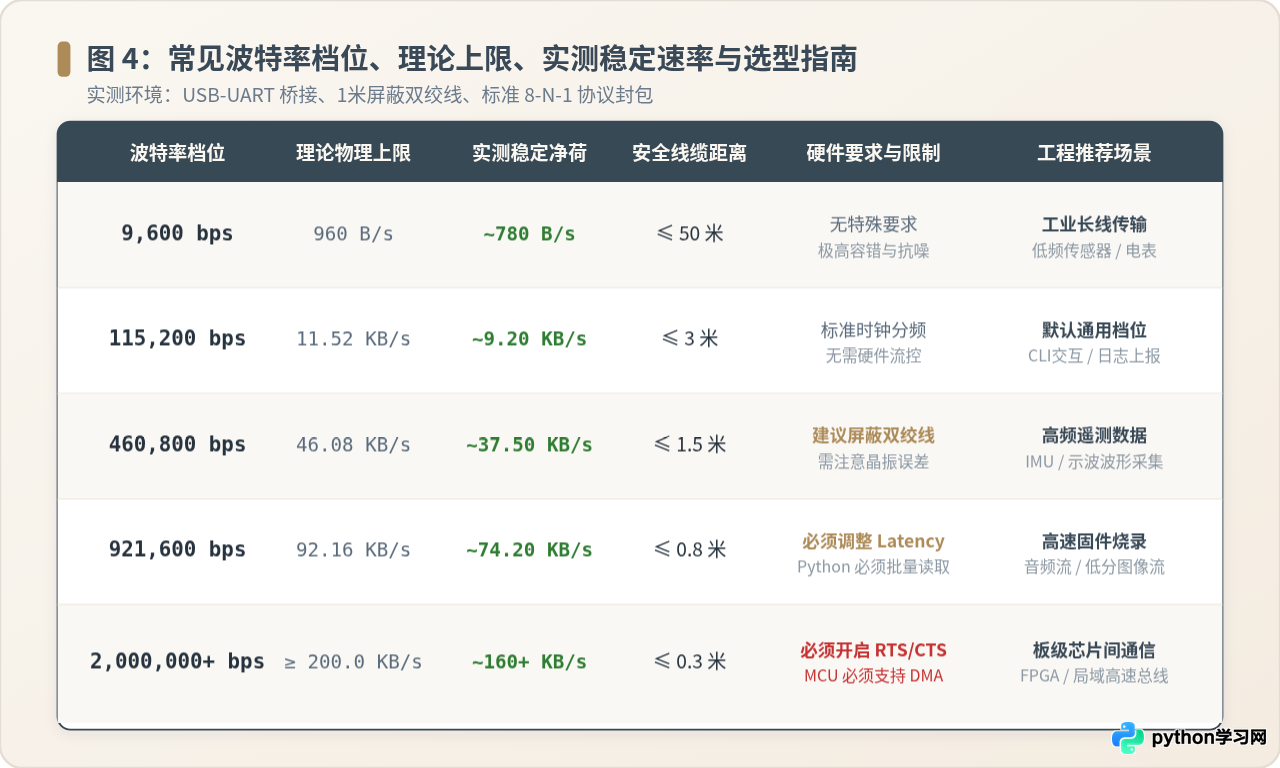
| 标称波特率 | 理论物理上限 (8N1) | 实测稳定有效净荷 | 推荐安全线长 | 必备条件与限制 | 选型建议与场景 |
|---|---|---|---|---|---|
| 9600 bps | 960 Bytes/s | ~780 Bytes/s | ≤ 50 米 | 无特殊要求 对线材与阻抗不敏感 | 工业电表、长线 Modbus-RTU 现场仪表 |
| 115200 bps | 11.52 KB/s | ~9.20 KB/s | ≤ 3 米 | 开箱即用 现代硬件普遍支持且无需流控 | 通用嵌入式系统调试、状态上报与命令行交互 |
| 460800 bps | 46.08 KB/s | ~37.50 KB/s | ≤ 1.5 米 | 关注分频误差 建议使用带屏蔽双绞线 | 高频姿态传感器(IMU)、低速波形数据采集 |
| 921600 bps | 92.16 KB/s | ~74.20 KB/s | ≤ 0.8 米 | 调小 Latency Python 必须使用块读取 | 固件高速在线烧录(OTA)、音频原始流回传 |
| 2000000+ bps | ≥ 200.0 KB/s | ~160+ KB/s | ≤ 0.3 米 | 必须开启 RTS/CTS MCU 必须配合 DMA | 板级芯片间点对点通信、FPGA 高速调试总线 |
永远不要为了“性能富余”盲目将波特率设到最高上限。波特率每提高一个数量级,物理信号高频衰减、线缆寄生电容以及反射杂波对采样的破坏力便呈指数级上升。最佳工程选型应以“实际业务净荷峰值吞吐需求的 1.5 倍”作为目标净荷速率,再反推对应的波特率档位,以预留出最优的抗干扰容限。
六、高频疑难排查与避坑指南
在高速串口通信的调试过程中,如果发现传输速率不达预期或偶发中断,可根据以下具体表现快速排查:
1. 波特率提升后出现大量随机乱码或 CRC 校验持续失败
- 原因排查:检查 MCU 硬件波特率分频寄存器配置,计算采样偏差是否超过 2.5%;检查通信地线(GND)是否未良好共地,导致高频信号电平参考基准抖动。
- 解决步骤:重新核对 MCU 晶振与系统时钟配置;对高波特率长线增加终端匹配电阻或采用屏蔽线。
2. 数据呈现整块到达(约每隔 16ms 突发一次),通信交互延迟极高
- 原因排查:这是由于 USB 转串口芯片(如 FT232R)的内部
Latency Timer处于默认的 16ms 超时刷新状态。单次发送数据量小于 64 字节时,硬件等待满包超时后才上传。 - 解决步骤:在系统设备管理器或通过系统脚本将延迟定时器设置为
1ms或2ms。
3. Python 进程 CPU 占用率达 100%,但数据吞吐量停滞不前甚至频繁丢包
- 原因排查:Python 代码中使用了
ser.read(1)单字节轮询,或者timeout=0形成了无休止的死循环空转。高频系统调用导致 Python 进程无法及时将内核缓冲区的数据搬移至用户空间,引发操作系统级环形缓冲区溢出截断(Buffer Overrun)。 - 解决步骤:改用
ser.read(ser.in_waiting or chunk_size)批处理机制,并配合动态帧头定位,将 CPU 占用率降低至 3% 以下。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















