


Python字符串切片语法详解:[start:stop:step]参数规则与默认值
深入详解Python字符串切片语法[start:stop:step],全面解析正负索引、默认值计算规则、切片三步判定法与经典实用场景。
在 Python 中,字符串切片是通过基础语法 sequence[start:stop:step] 从已有序列中提取子串或生成新序列的核心操作。理解切片的关键在于认清区间“左闭右开”的本质,掌握当 start 和 stop 省略时默认值如何由 step 的正负符号动态决定,以及弄清负步长下序列逆向游走的底层机制。本文将系统拆解这三个参数的取值逻辑、判定顺序与边界安全规则。
一、核心语法与基础模型:区间为何是左闭右开?
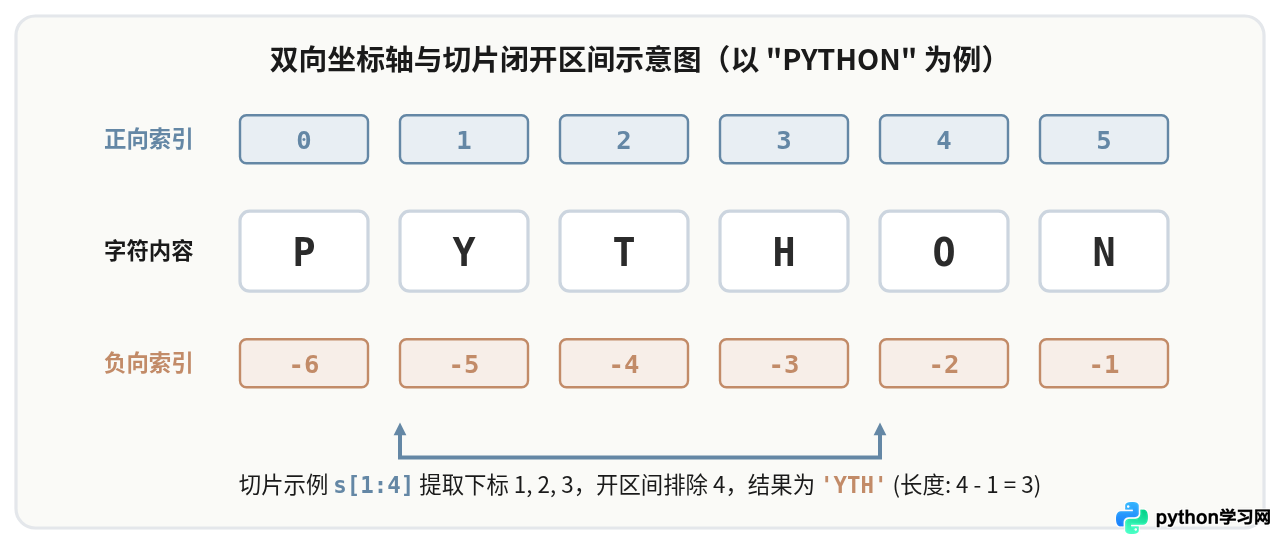
Python 字符串切片最基础的形式是 s[start:stop]。它的区间数学表示为 [start, stop),即提取出来的子序列包含下标为 start 的字符,但严格排除下标为 stop 的字符。
这种“左闭右开”设计的最大工程优势在于数学性质的整齐性:当步长为 1 时,切片结果包含的字符数量恰好等于 stop - start。例如对于字符串 s = "PYTHON",切片 s[0:3] 返回长度为 3 - 0 = 3 的子串 'PYT'。此外,相邻区间的切片拼接非常自然:s[:i] + s[i:] 永远无缝还原整个序列 s,不需要做令人头疼的加一或减一修正。
正负双向索引系统也是 Python 序列的一大特色:正索引从 0 开始向右递增,指向首字符;负索引从 -1 开始向左递减,-1 精确指向最后一个字符。
二、步长(step)与默认值规则:底层如何动态切换?
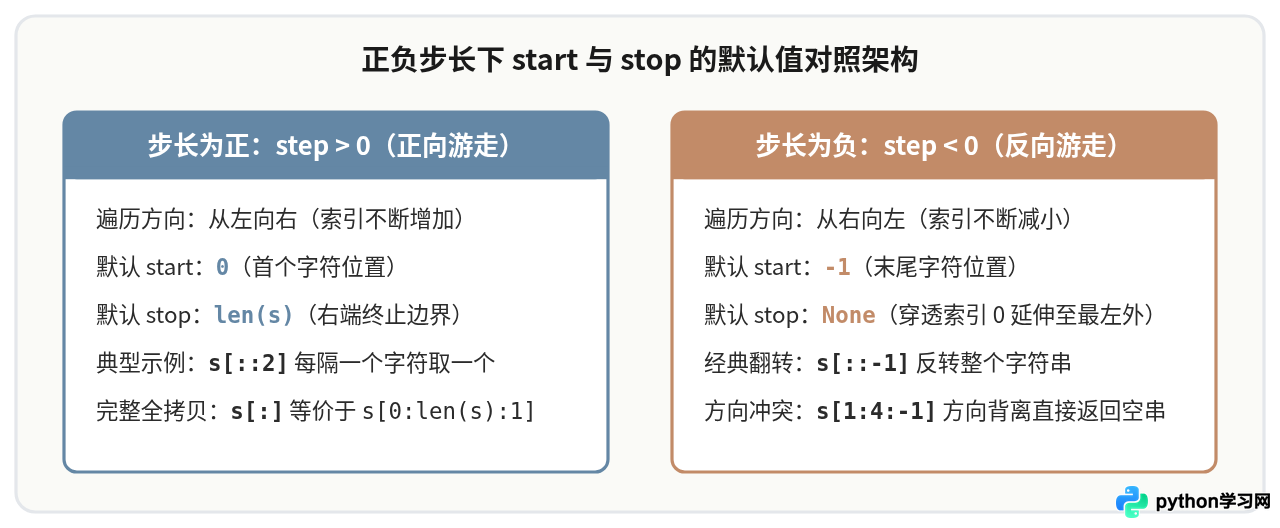
完整的切片语法写为 s[start:stop:step]。很多初学者常犯的误区是认为“start 默认就是 0,stop 默认就是末尾”。其实在 Python 规范中,默认值完全取决于 step 的正负号:
- 当
step > 0(或省略step时,step默认取1):- 提取方向从左向右(下标递增)。
start默认值为0(序列物理最左端)。stop默认值为len(s)(越过最后一个字符右侧的边界位置)。
- 当
step < 0时:- 提取方向从右向左(下标递减,逆序提取)。
start默认值为-1(序列物理最右端的首个有效字符)。stop默认值为序列最左侧之前的位置(概念上的-len(s)-1),保证下标为0的字符能够被完整提取。
- 特别注意:
step绝对不能为0,如果传入0,Python 将直接抛出ValueError: slice step cannot be zero。
三、切片判定的核心流程:三步推导法
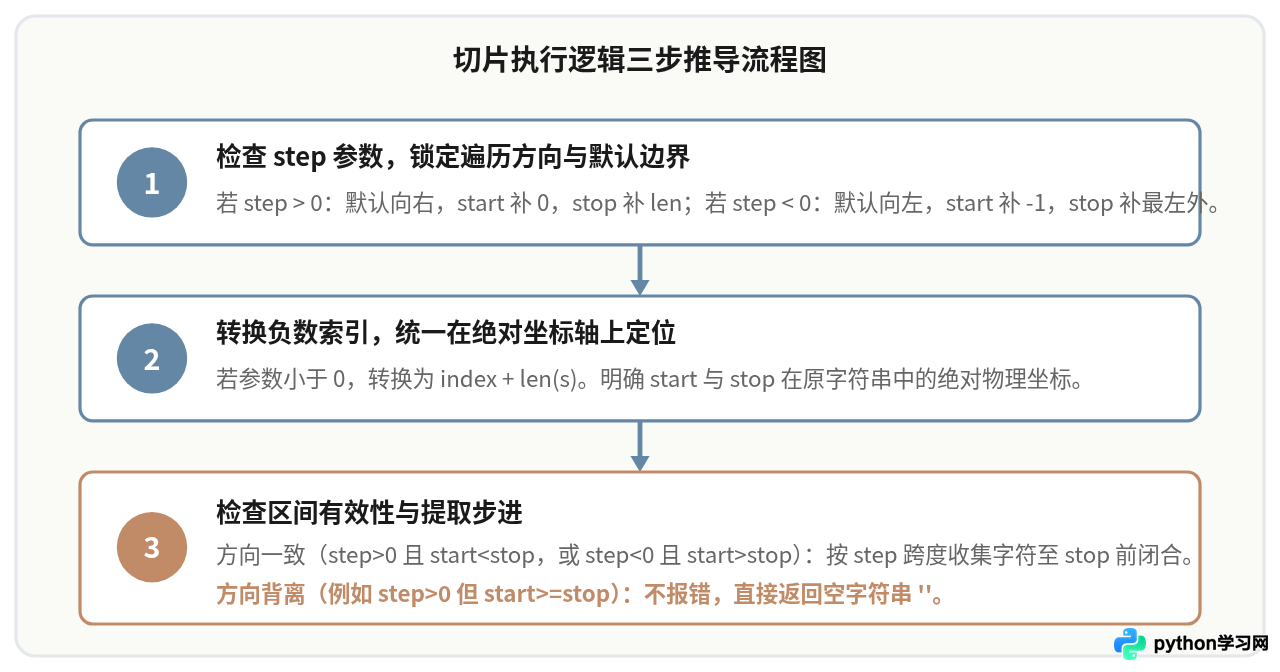
在阅读或编写切片代码时,遇到带有正负混合索引的切片,切忌凭直觉猜测。按照 Python 解释器的内部计算逻辑,只需执行清晰的三步推导即可精确得出切片结果:
- 第一步:审视
step确定方向与默认值。先看step是正数还是负数。确定游走方向是自左向右还是自右向左。若start或stop省略,依据步长正负补全默认边界。 - 第二步:统一负数索引。如果参数中存在负数,将其加上字符串长度
len(s)换算为标准的正数绝对坐标,方便在脑海中对齐。例如在长度为 6 的字符串中,-1对应下标5,-4对应下标2。 - 第三步:验证起点与终点的行进相容性。观察从
start到stop是否与step的方向一致:- 若
step > 0,必须满足start < stop,否则无法向右前进,结果直接返回空字符串''。 - 若
step < 0,必须满足start > stop,否则无法向左迈步,结果同样返回空字符串''。
- 若
四、切片与单索引的核心差异:越界容错机制
在 Python 中,单字符索引 s[i] 与区间切片 s[start:stop] 在对待越界索引时有着根本性的行为差异:
- 单字符索引是严格访问:如果指定的索引超出了
[-len(s), len(s)-1]的合法范围,Python 会立即引发运行时异常IndexError: string index out of range。 - 切片操作是安全裁剪:切片本质上是在序列上划定一个窗口,传入的数字只是窗口的期望范围。Python 会自动将超出边界的数值裁剪到有效范围
[0, len(s)]内,绝对不会引发 IndexError。
# 环境:Python 3.x 交互式解释器环境
s = "Python"

# 1. 单字符索引越界直接报错
# s[100]  --> 触发 IndexError: string index out of range

# 2. 切片越界会自动截断,表现安全
print("示例输出 1:", s[2:100])    # 预期输出: 'thon'
print("示例输出 2:", s[50:100])   # 预期输出: '' (完全越界时返回空串)
print("示例输出 3:", s[-100:3])   # 预期输出: 'Pyt' (左侧自动归拢至下标0)
五、高频经典切片场景剖析
掌握了 [start:stop:step] 的规律后,我们可以来看几个 Python 开发中极具代表性的高频切片写法:
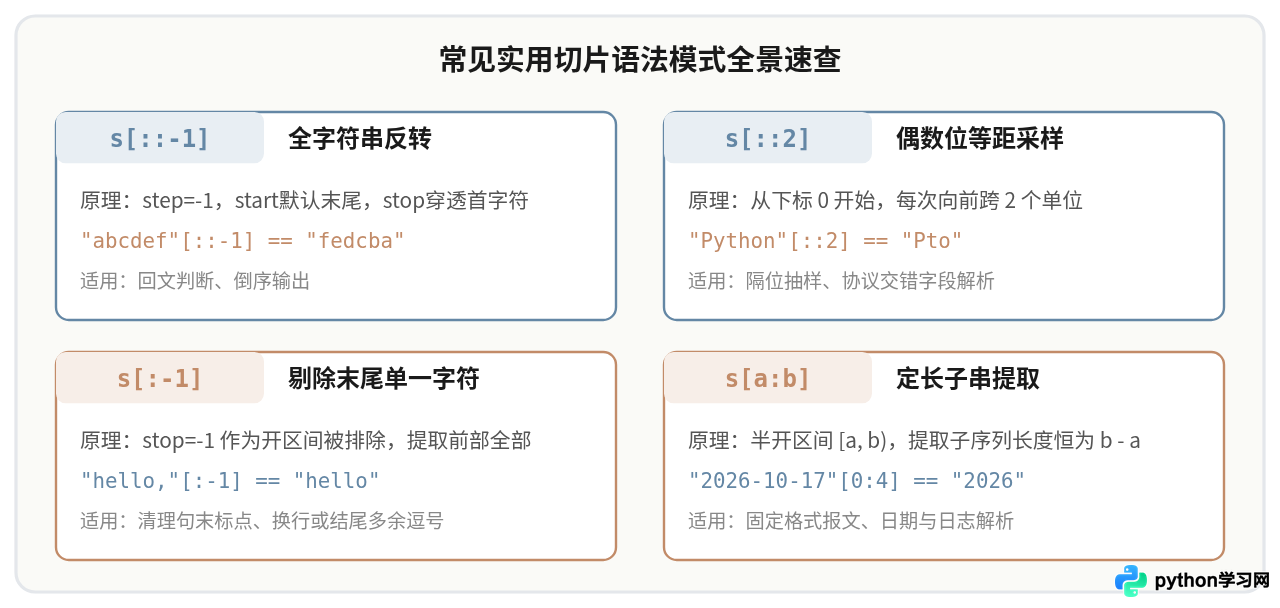
1. 字符串全量浅拷贝:s[:]
在 step 默认为 1 时,省略 start 和 stop 会完整覆盖整个字符串范围。虽然对不可变的字符串来说直接赋值已足够,但在列表或自定义可变序列中,s[:] 是快速完成全量切片浅拷贝的惯用手法。
2. 完整反转序列:s[::-1]
由于 step = -1 为负数,其 start 自动取末尾索引 -1,stop 取最左边界之外。每次下标递减 1,从而以高效的 C 底层循环一次性生成逆序字符串。
3. 奇偶间隔抽样:s[::2] 与 s[1::2]
指定 step = 2,从索引 0 开始提取即为偶数位字符集合(第 1, 3, 5... 个字符);从索引 1 开始提取即为奇数位字符集合。
4. 剥离前缀或后缀:s[1:] 与 s[:-1]
利用负索引切片可以轻松裁掉末尾字符。例如 s[:-1] 表示从下标 0 开始,一直提取到倒数第一个字符前(不含最后一个字符),常用于去除末尾多余的分隔符或换行符。
六、总结与速查对照表
为了在实际编码中快速查阅与验证,下表梳理了各类切片形态对应的内部默认参数与执行特征:
| 切片写法 | 实际等价形式 | 步长与方向 | 输出效果与说明 |
|---|---|---|---|
s[:] |
s[0:len(s):1] |
+1(正向) | 获取原序列的完整浅拷贝 |
s[start:] |
s[start:len(s):1] |
+1(正向) | 从 start 提取到字符串末尾 |
s[:stop] |
s[0:stop:1] |
+1(正向) | 从开头提取到 stop - 1 位置 |
s[::2] |
s[0:len(s):2] |
+2(正向隔位) | 提取所有偶数下标对应的字符 |
s[::-1] |
s[-1:-(len(s)+1):-1] |
-1(反向倒序) | 将整个字符串反转输出 |
s[4:1:-1] |
s[4:1:-1] |
-1(反向) | 依次提取下标 4, 3, 2 的字符(开区间排除 1) |
s[1:4:-1] |
s[1:4:-1] |
-1(方向矛盾) | 起点在终点左侧却要求向左游走,返回空串 '' |
注意:在编写复杂业务逻辑时,切片参数应尽量保持意图清晰。如果涉及复杂的动态索引计算,建议优先使用命名切片对象 slice(start, stop, step),例如 DATE_PART = slice(0, 10); s[DATE_PART],既能提升代码可读性,也便于单元测试与逻辑复用。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















