


Python怎么实现办公自动化
本文系统解析Python实现办公自动化的核心逻辑、常用第三方生态库与标准五步实施流程,结合Excel多表清洗汇总与Word/邮件批量分发两大真实场景,提供完整可落地的实战代码与工程避坑指南。
一、办公自动化的底层逻辑与工具链
日常办公中涉及的表格汇总、合同拟定、票据归档等工作,本质上都是对结构化文件(Excel、CSV)、半结构化文件(Word、PDF)或通信协议(SMTP邮件、网络API)的操作。手动操作的瓶颈在于效率低下且极易受疲劳影响而出错,而办公软件底层的数据存储格式(如 .xlsx 和 .docx 实际上是压缩的 XML 集合)完全可以通过程序接口直接解析和批量写入。
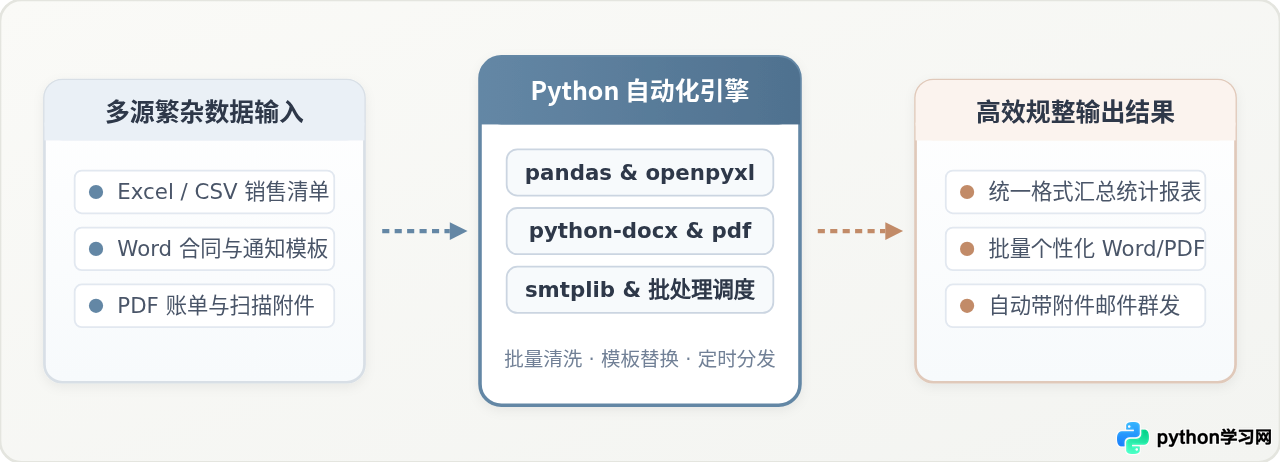
Python 之所以成为办公自动化的首选语言,核心在于其拥有极度成熟且经过广泛验证的三方生态库。根据不同办公场景的物理介质,主流工具库可以清晰地划分为四大层级:
- 表格数据处理层:
openpyxl专长于读写 Excel.xlsx文件,能够完整保留和修改单元格样式、公式和图表;而pandas则擅长对成千上万行的数据执行高速过滤、分组聚合、关联匹配与透视统计。两者结合可以兼顾计算深度与展示外观。 - 文档与报告排版层:
python-docx允许以编程方式新建或读取 Word 文档,通过精确遍历段落和表格实现文本替换与动态图文排版;pdfplumber则能够精准提取 PDF 内部的表格与字符坐标,解决票据与对账单的结构化提取难题。 - 本地文件与系统调度层:标准库中的
pathlib提供了跨平台的面向对象路径操作,彻底避免了 Windows 反斜杠与 macOS/Linux 正斜杠的路径兼容问题;shutil与os负责完成文件的高速复制、重命名、自动归档与临时缓存清理。 - 通信与定时触发层:
smtplib与email构成了标准邮件发送引擎,支持 HTML 格式正文及多格式附件自动组装;通过系统自带的计划任务或轻量级第三方调度库,可以使脚本在指定时间自动离线执行。
二、从零开始的标准五步实施流程
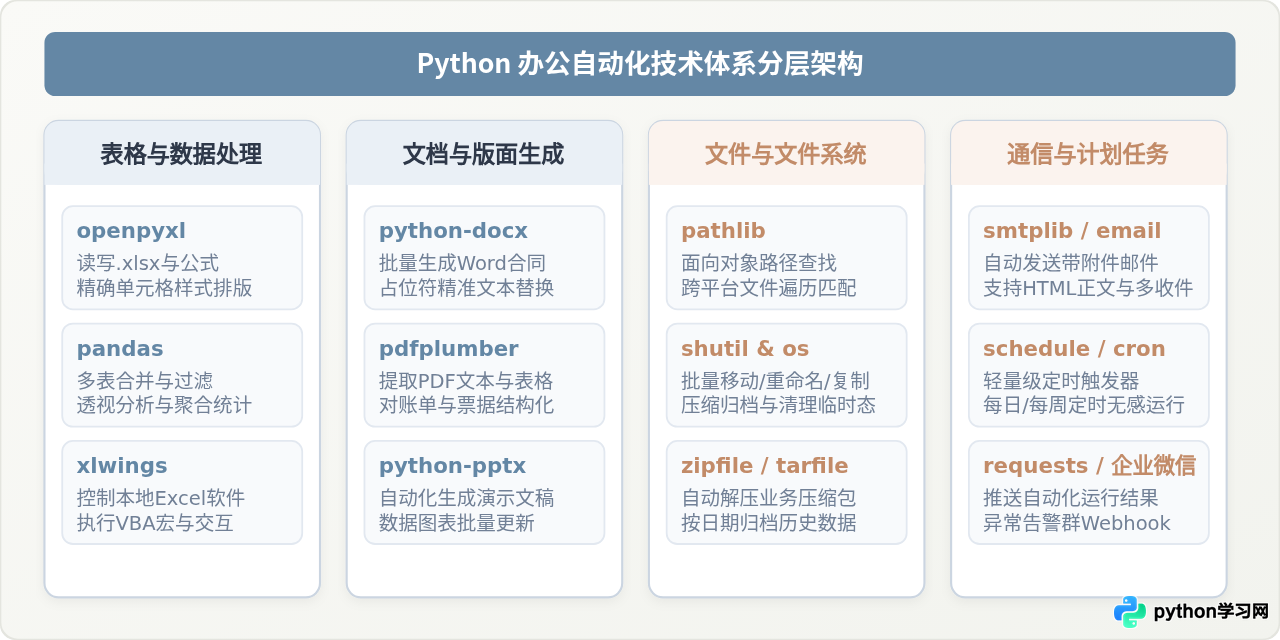
很多初学者在编写办公脚本时容易陷入“边写边改、一遇到异常就手动修数据”的被动状态。要想构建出在实际生产中长期稳定运行的自动化流程,需要遵循结构化的五步实施路径:
- 固化业务规则与输入规范:在动手写代码前,先梳理人工操作的每一个微小动作。明确待处理文件的统一存放目录、文件命名匹配规则(如
2026-10-*.xlsx)、关键字段列名以及空值或异常值的处理原则。 - 准备独立的 Python 运行环境:使用虚拟环境隔离项目依赖,通过包管理工具安装所需的专业模块。常规数据与文档处理环境仅需一行命令:
pip install openpyxl pandas python-docx - 单样本单文件逻辑调通:从真实业务中挑选 1 份具有代表性的文件作为样本,编写核心处理逻辑,完成读取、字段清洗、计算转换与输出,核对结果直至与人工计算毫厘不差。
- 批量化循环与防御性异常隔离:利用
pathlib.Path.glob()扫描目录中所有待处理文件,使用循环结构批量处理。在处理每份文件的核心代码外包裹异常捕获语句,确保某一份格式破损的文件不会导致整体脚本半途中断,并将错误明细记录至日志中。 - 部署交付与自动化触发:将脚本保存为固定任务,根据执行频率配置系统的定时任务(Windows 的“任务计划程序”或 macOS 的
cron),或创建桌面一键启动快捷脚本,实现无人值守运作。
三、典型场景一:多份Excel销售报表批量清洗与汇总
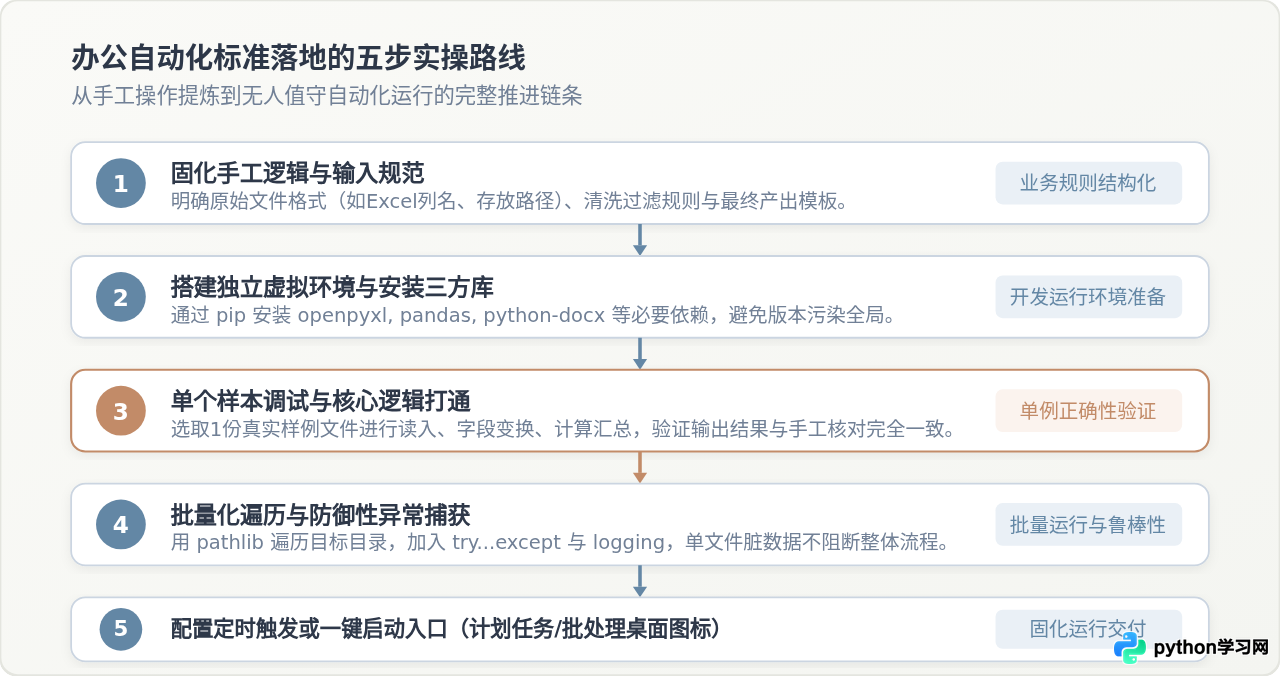
业务场景:每月初,总部需要汇总来自全国 10 个分支区域提交的销售明细报表。各报表文件存放在同一文件夹下,文件名格式如 区域A_销售明细.xlsx。每个文件包含名为“销售记录”的工作表,但表格内部存在多余空行、金额列夹杂符号、个别订单缺少日期等脏数据。要求:提取所有区域的明细记录,过滤掉无效行,按销售员汇总销售总额,最终输出一份格式统一的“全国销售汇总统计表.xlsx”。
完成该任务的核心代码如下,代码采用 pathlib 遍历,pandas 负责高速合并与清洗,openpyxl 负责输出结果的美化:
import logging
from pathlib import Path
import pandas as pd
from openpyxl import load_workbook
from openpyxl.styles import PatternFill, Font, Alignment, Border, Side

# 1. 配置日志记录,监控批量处理过程
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def batch_consolidate_sales(input_dir: Path, output_file: Path):
    all_records = []
    excel_files = list(input_dir.glob("*_销售明细.xlsx"))

    if not excel_files:
        logging.warning("未在指定目录下找到符合条件的销售明细文件。")
        return

    # 2. 遍历各区域表格文件
    for file_path in excel_files:
        try:
            # 读取目标工作表,指定使用 openpyxl 引擎
            df = pd.read_excel(file_path, sheet_name="销售记录", engine="openpyxl")

            # 清除前后多余空格与完全空白的行
            df.columns = df.columns.astype(str).str.strip()
            df = df.dropna(how="all")

            # 校验必需的业务列是否存在
            required_cols = {"销售员", "订单金额", "订单日期"}
            if not required_cols.issubset(df.columns):
                logging.error(f"文件 {file_path.name} 缺少必要列名,跳过处理。")
                continue

            # 数据清洗:剔除销售员为空的行,转换金额为浮点数
            df = df[df["销售员"].notna()].copy()
            df["订单金额"] = pd.to_numeric(df["订单金额"], errors="coerce").fillna(0.0)

            # 记录来源区域并存入汇总池
            region_name = file_path.name.split("_")[0]
            df["所属区域"] = region_name
            all_records.append(df[["所属区域", "销售员", "订单金额", "订单日期"]])
            logging.info(f"成功处理文件: {file_path.name},提取有效记录 {len(df)} 条。")

        except Exception as e:
            logging.error(f"读取文件 {file_path.name} 失败,错误信息: {e}")

    if not all_records:
        logging.error("没有成功提取到任何有效数据,终止生成。")
        return

    # 3. 合并全量明细并计算销售员业绩汇总
    full_df = pd.concat(all_records, ignore_index=True)
    summary_df = (
        full_df.groupby(["所属区域", "销售员"])["订单金额"]
        .agg(["sum", "count"])
        .reset_index()
        .rename(columns={"sum": "销售总额", "count": "订单数量"})
    )

    # 4. 写入合并后的汇总结果到 Excel
    with pd.ExcelWriter(output_file, engine="openpyxl") as writer:
        summary_df.to_excel(writer, sheet_name="业绩汇总", index=False)
        full_df.to_excel(writer, sheet_name="明细合集", index=False)

    # 5. 使用 openpyxl 进行表格样式美化
    wb = load_workbook(output_file)
    ws = wb["业绩汇总"]

    header_fill = PatternFill(start_color="6487A5", end_color="6487A5", fill_type="solid")
    header_font = Font(name="PingFang SC", size=11, bold=True, color="FFFFFF")
    data_font = Font(name="PingFang SC", size=10)
    thin_border = Border(
        left=Side(style="thin", color="CBD5E1"),
        right=Side(style="thin", color="CBD5E1"),
        top=Side(style="thin", color="CBD5E1"),
        bottom=Side(style="thin", color="CBD5E1"),
    )

    for col_idx, col in enumerate(ws.iter_cols(min_row=1, max_row=ws.max_row), start=1):
        for cell in col:
            cell.border = thin_border
            if cell.row == 1:
                cell.fill = header_fill
                cell.font = header_font
                cell.alignment = Alignment(horizontal="center", vertical="center")
            else:
                cell.font = data_font
                if col_idx == 3:  # 销售总额列设置货币显示格式
                    cell.number_format = "¥#,##0.00"
                    cell.alignment = Alignment(horizontal="right")
                else:
                    cell.alignment = Alignment(horizontal="center")

    wb.save(output_file)
    logging.info(f"汇总报表已成功生成并美化至: {output_file}")

# 示例调用
if __name__ == "__main__":
    work_dir = Path(__file__).resolve().parent
    data_folder = work_dir / "raw_reports"
    result_path = work_dir / "全国销售汇总统计表.xlsx"
# batch_consolidate_sales(data_folder, result_path)在使用 pd.read_excel 时,务必指定 engine="openpyxl"。若原表头含有隐藏字符或换行符,容易造成 KeyError,因此必须先通过 str.strip() 清除列名首尾空格。对金额或数字字段使用 pd.to_numeric(..., errors="coerce") 可以自动将无法解析的文字(如“暂无”“暂缓”)置为 NaN,再通过 fillna(0.0) 赋予默认值,防止汇总求和时发生类型报错。
四、典型场景二:批量生成个性化合同并自动发邮件
业务场景:销售部门已完成核账,有一份客户确认清单(包含“客户姓名”、“企业名称”、“合同金额”、“电子邮箱”)。业务人员需要根据预设好的标准 Word 模版 合同模板.docx(其中预埋有占位符 {{客户姓名}}、{{企业名称}} 和 {{合同金额}}),为每位客户生成专属合同文档,随后调用企业邮箱将合同作为附件自动发至客户邮箱。
在对比人工操作与自动化实现时,这种多步联动(读表 → 替换生成 → 附件包装 → 邮件传输)最能体现 Python 的执行优势:
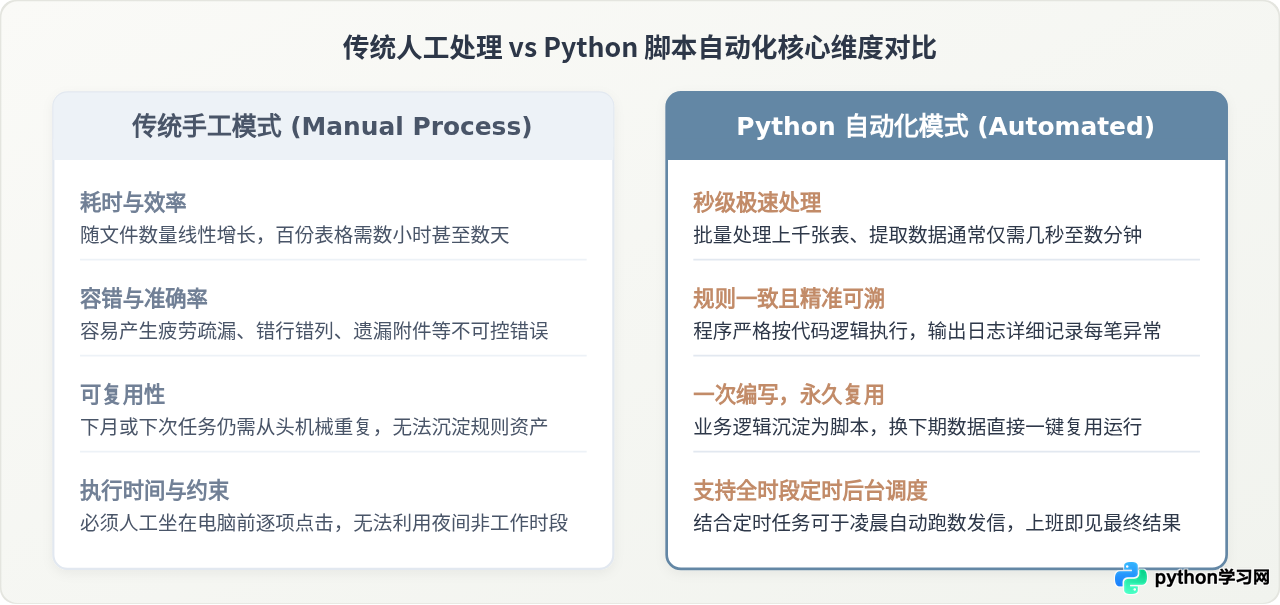
以下为批量替换 Word 占位符并发送带附件邮件的完整实现代码:
import os
import smtplib
from email.mime.multipart import MIMEMultipart
from email.mime.text import MIMEText
from email.mime.application import MIMEApplication
from pathlib import Path
import docx

def replace_placeholder_in_paragraph(paragraph, replacements: dict):
    """精准替换段落中的占位符,保持原有字体样式"""
    for key, value in replacements.items():
        if key in paragraph.text:
            text = paragraph.text.replace(key, str(value))
            paragraph.text = text

def generate_custom_contract(template_path: Path, output_path: Path, data: dict):
    """读取模板并生成专属 Word 合同"""
    doc = docx.Document(template_path)

    # 替换正文段落
    for paragraph in doc.paragraphs:
        replace_placeholder_in_paragraph(paragraph, data)

    # 替换表格中的单元格内容
    for table in doc.tables:
        for row in table.rows:
            for cell in row.cells:
                for paragraph in cell.paragraphs:
                    replace_placeholder_in_paragraph(paragraph, data)

    doc.save(output_path)

def send_contract_email(smtp_server: str, port: int, sender: str, auth_code: str,
                        recipient: str, client_name: str, attachment_path: Path):
    """构建带附件的邮件并通过 SSL 安全发送"""
    msg = MIMEMultipart()
    msg["From"] = sender
    msg["To"] = recipient
    msg["Subject"] = f"【商务合作】{client_name} 专属采购服务合同"

    body_content = f"""
    <p>尊敬的 {client_name}:</p>
    <p>您好!感谢您对我们业务的信任与支持。根据我们此前的约定,合同文件已生成完毕,详见本邮件附件。</p>
    <p>请查收附件并完成盖章确认。如有任何疑问,请随时与我们联系。</p>
    <br>
    <p style="color: #6487A5;">自动化协同服务中心</p>
    """
    msg.attach(MIMEText(body_content, "html", "utf-8"))

    # 添加 Word 附件
    with open(attachment_path, "rb") as f:
        part = MIMEApplication(f.read())
        part.add_header("Content-Disposition", "attachment", filename=attachment_path.name)
        msg.attach(part)

    # 建立 SSL 连接并安全发送
    with smtplib.SMTP_SSL(smtp_server, port) as server:
        server.login(sender, auth_code)
        server.send_message(msg)

def run_contract_workflow(client_records: list, template_file: Path, out_dir: Path):
    """串联生成与分发流水线"""
    out_dir.mkdir(parents=True, exist_ok=True)
    smtp_host = "smtp.company.com"
    smtp_port = 465
    sender_account = os.environ.get("CORP_EMAIL_USER", "service@company.com")
    sender_token = os.environ.get("CORP_EMAIL_TOKEN", "your_auth_token")

    for client in client_records:
        name = client["客户姓名"]
        contract_filename = f"服务合同_{name}.docx"
        target_path = out_dir / contract_filename

        replacements = {
            "{{客户姓名}}": name,
            "{{企业名称}}": client["企业名称"],
            "{{合同金额}}": f"¥{client['合同金额']:,}"
        }

        # 生成个性化合同
        generate_custom_contract(template_file, target_path, replacements)
        print(f"已生成合同文件: {target_path.name}")

        # 触发邮件发送
        try:
            send_contract_email(smtp_host, smtp_port, sender_account, sender_token,
                                client["电子邮箱"], name, target_path)
            print(f"已成功将合同发送至客户邮箱: {client['电子邮箱']}")
        except Exception as e:
            print(f"发送至 {client['电子邮箱']} 失败,错误: {e}")
在使用 python-docx 替换占位符时,Word 在内部可能把一个连续词汇拆散到多个不同的 run 对象中(例如 {{ 和 客户姓名 分属不同 run)。在段落整体层面执行 paragraph.text = text 是最简便的替换方式;若需要极其严格地保留每个局部词语的高级格式,建议使用业界成熟的 docxtpl 库。
在邮件发送环节,企业邮箱或个人邮箱登录必须使用在邮箱设置中生成的独立客户端授权码,而非网页端登录密码;同时敏感密钥应从系统环境变量 os.environ 中读取,严禁明文硬编码在代码仓库中。
五、工程落地必须建立的四道防线
在个人本地电脑调通脚本仅仅迈出了第一步。当脚本需要交付其他部门同事使用,或者配置在服务器上定期运行时,代码将直面复杂、非理想的真实文件系统。必须在编写初期就设立好以下四道防御机制:
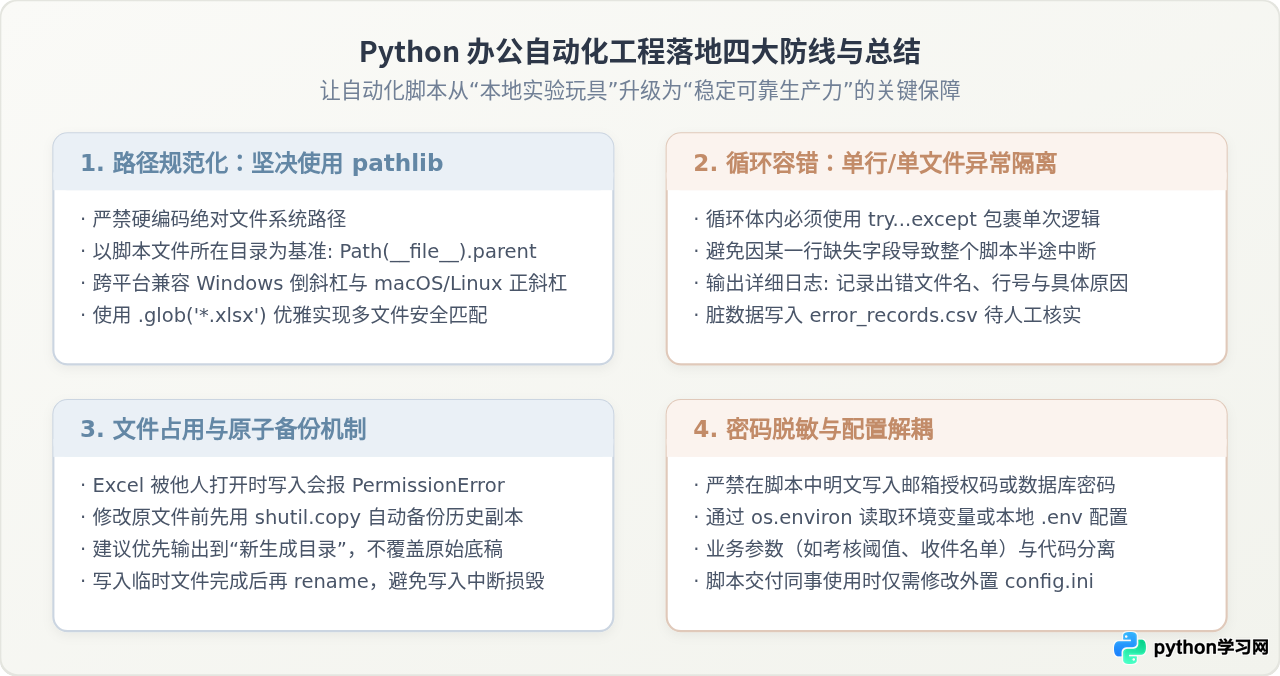
- 防线一:路径动态规范化:绝对不能在代码中书写绝对的本地磁盘驱动器路径。推荐统一采用
Path(__file__).resolve().parent作为基础根目录,所有输入输出目录均以相对路径拼装。这样无论文件夹被复制到同事电脑的哪个磁盘分区,脚本均能即开即用。 - 防线二:文件占用防御与原子备份:在 Windows 操作系统中,若目标 Excel 或 Word 正被某个用户在软件中打开,Python 尝试写入时将直接抛出
PermissionError: [Errno 13] Permission denied。规避策略是:对被修改的原文件先使用shutil.copy2备份一份历史时间戳副本;将新生成的文件先写入临时文件,全部写入成功后再执行原子替换(Rename)。 - 防线三:脏数据隔离与日志追溯:批量处理数百张表格时,极大概率会遇到缺少表头、空文件或乱码字符。切忌让单个异常导致整个批处理进程崩溃退出。在遍历循环内部必须加入精细化捕获,将损坏文件移动至
error/隔离目录,并在独立的error.log中记录发生时间与追踪栈,确保合格文件 100% 正常处理。 - 防线四:参数与密码脱敏解耦:业务参数(如考核达标阈值、邮件接收组名单)与认证凭证(如邮箱授权码、ERP 数据库连接串)应与核心逻辑彻底解耦。普通业务参数建议存储在外部的
config.ini或settings.json中,便于不熟悉 Python 的同事修改;而密码与秘钥必须通过操作系统的环境变量加载,保障办公自动化体系的信息安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















