


Python在人工智能和机器学习领域有什么用?主流框架与应用场景解析
深入解析Python在人工智能与机器学习领域的核心定位、运行机制、主流开发框架与工程化应用场景,涵盖Scikit-learn、PyTorch、Hugging Face及生产部署实践。
一、核心机制:Python为什么成为AI研发的事实标准?
很多人初次接触编程时都会产生一个直觉疑问:Python 解释执行速度慢、存在全局解释器锁(GIL),为什么对算力与时延要求极高的人工智能领域反而几乎全员采用 Python?
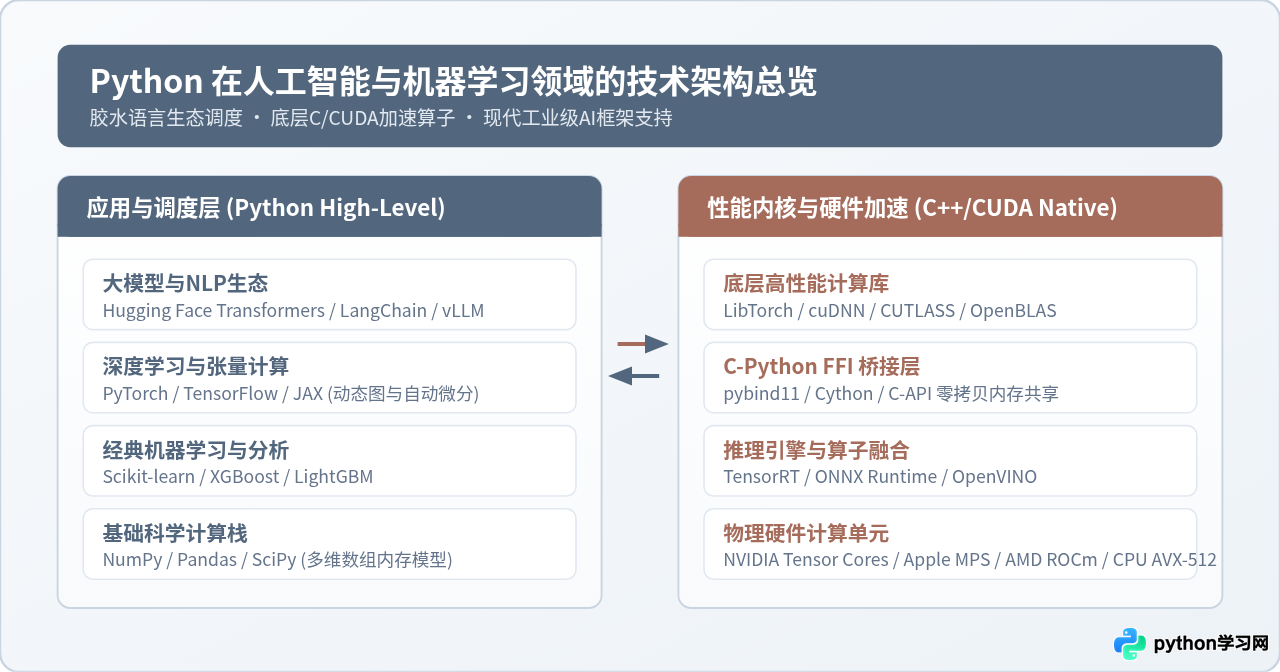
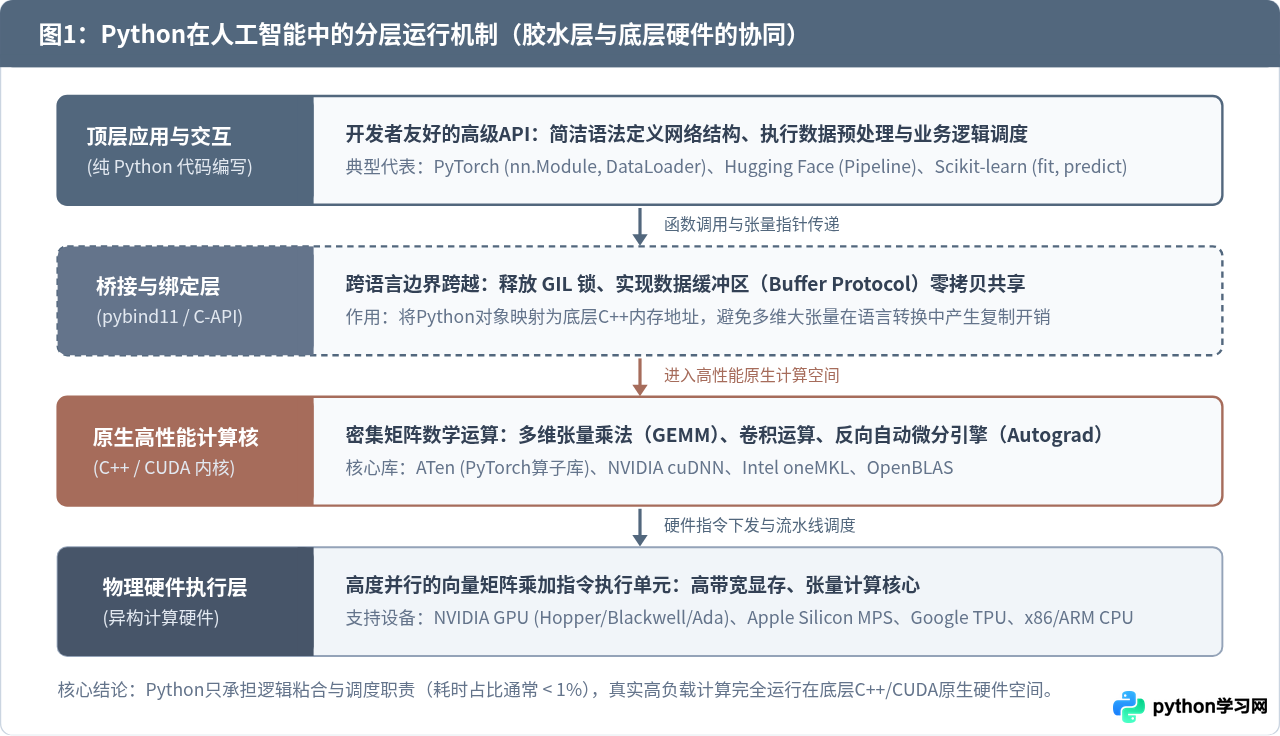
答案在于软件架构上的“分工解耦”。人工智能应用在代码执行层面具有明显的二八定律:99% 的运行时间消耗在密集的浮点数矩阵乘加运算(GEMM)上,而只有不到 1% 的时间消耗在控制流、模型拓扑拼接和超参数调度上。
Python 恰恰接管了那 1% 的调度逻辑,并将 99% 的繁重计算完全下沉到 C++ 和 GPU 硬件驱动中。通过 C-API 与基于 pybind11 的低开销绑定机制,Python 进程在向底层硬件派发计算任务时,可以直接传递指针地址实现内存零拷贝(Zero-Copy),同时立即释放 GIL 锁,让硬件计算核心全速并行运转。
除了运行时的架构契合,Python 拥有任何其他语言都无法替代的科学计算连贯生态:
- 多维数组统一内存协议:
NumPy确立了ndarray的连续内存排布标准,使得 Pandas 表格数据、OpenCV 图像矩阵以及 PyTorch 张量可以无缝互转,彻底消除了数据跨库传递时的序列化损耗。 - 学术界与工业界的快速复现:前沿论文(如 Transformer、Diffusion、MoE)的代码开源 98% 以上首发为 Python 库,工程师无需重写算法逻辑即可直接验证模型效果。
- 丰富的跨学科工具扩展:统计学(SciPy)、信号处理、可视化(Matplotlib/Seaborn)均可在同一个 Python 脚本内完成闭环交互。
二、开发生命周期:从数据到模型的具体操作流程
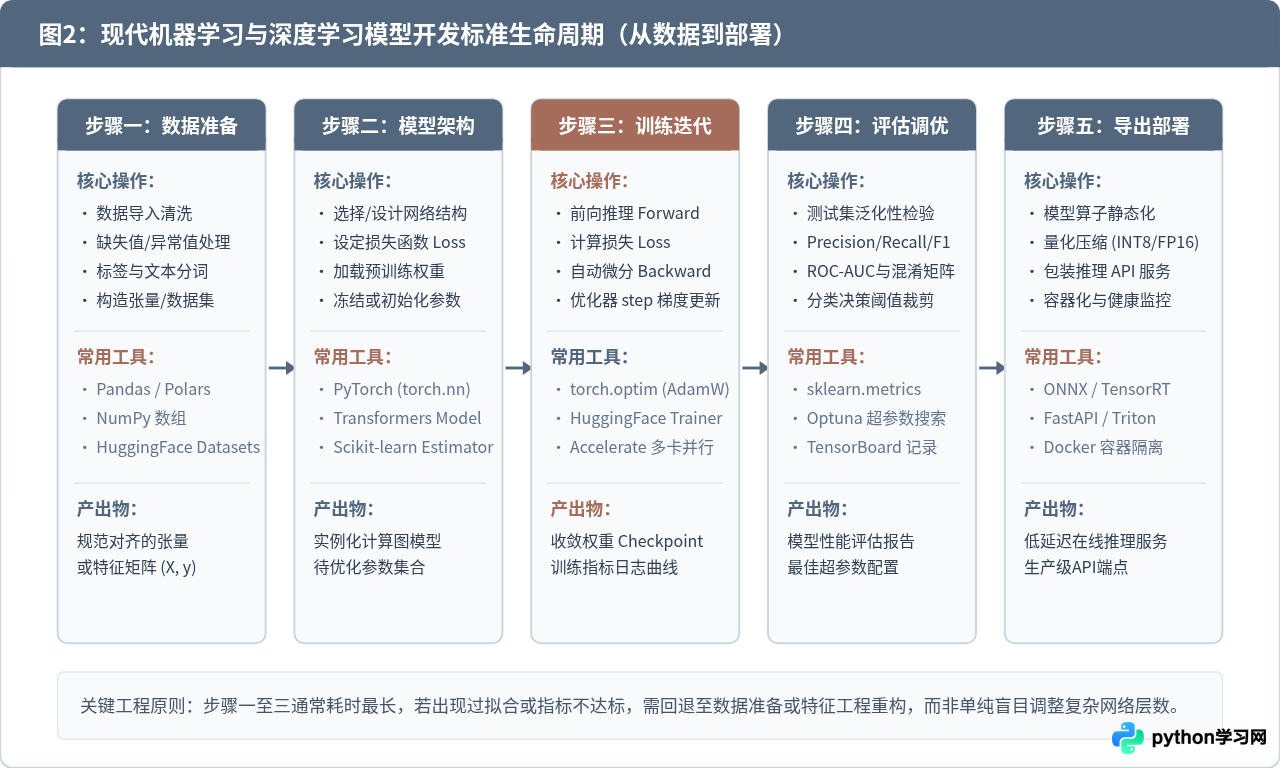
在实际工程研发中,一个标准的机器学习或深度学习项目通常遵循清晰的五步流水线。无论使用何种算法,整体开发过程均由 Python 代码贯穿始终。
1. 经典表格数据机器学习实战(以 Scikit-learn 为例)
对于结构化表格数据(如金融征信、用户行为预测),传统机器学习算法(随机森林、GBDT)在准确率和可解释性上往往优于复杂的深度学习模型。以下为一段使用 Scikit-learn 构建分类预测模型的完整代码:
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, roc_auc_score

# 1. 模拟生成结构化分类数据集 (1000条样本, 10个特征)
X, y = make_classification(
    n_samples=1000,
    n_features=10,
    n_informative=7,
    random_state=42
)

# 2. 划分训练集与测试集 (分层抽样保持标签比例)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 特征标准化处理 (避免数据泄露,仅在训练集拟合均值方差)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 构建并训练随机森林模型
clf = RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42)
clf.fit(X_train_scaled, y_train)

# 5. 模型推理与评估指标计算
y_pred = clf.predict(X_test_scaled)
y_prob = clf.predict_proba(X_test_scaled)[:, 1]

print("=== 分类性能评估报告 ===")
print(classification_report(y_test, y_pred, digits=4))
print(f"ROC-AUC 得分: {roc_auc_score(y_test, y_prob):.4f}")StandardScaler 或任何特征归一化操作时,必须严格执行“在训练集上 fit_transform,在测试集/生产集上仅执行 transform”。如果将全量数据合并后再做统计缩放,会将测试集的统计信息提前泄露给模型,导致线下指标虚高、上线后效果骤降。
2. 深度学习神经网络前向与自动求导(以 PyTorch 为例)
当任务转向计算机视觉或序列数据时,开发者需要直接操作张量(Tensor)并定义网络层。PyTorch 的核心优势在于“所见即所得”的动态计算图机制:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 检查物理算力设备 (优先使用 GPU / Apple MPS)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 2. 定义双层全连接分类网络
class ClassifierNet(nn.Module):
    def __init__(self, in_features, hidden_dim, num_classes):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(in_features, hidden_dim),
            nn.BatchNorm1d(hidden_dim),
            nn.ReLU(),
            nn.Dropout(p=0.2),
            nn.Linear(hidden_dim, num_classes)
        )

    def forward(self, x):
        return self.network(x)

# 3. 实例化模型并转移至计算设备
model = ClassifierNet(in_features=10, hidden_dim=32, num_classes=2).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.AdamW(model.parameters(), lr=0.001, weight_decay=1e-4)

# 4. 单步前向计算与梯度回传模拟
dummy_input = torch.randn(16, 10).to(device)   # Batch size = 16
dummy_labels = torch.randint(0, 2, (16,)).to(device)

model.train()
optimizer.zero_grad()                         # 清空历史累计梯度
outputs = model(dummy_input)                  # 前向传播
loss = criterion(outputs, dummy_labels)       # 计算交叉熵损失
loss.backward()                               # 自动微分回传梯度
optimizer.step()                              # 参数更新

print(f"当前批次损失值: {loss.item():.4f}")
print(f"输出张量尺寸: {outputs.shape} | 执行设备: {outputs.device}")三、主流开发框架横向解析与选型依据
在实际项目启动时,最忌讳的是“盲目追求最新技术”。不同的框架有明确的适用边界与设计哲学,选型错误会成倍增加研发成本与硬件开销。
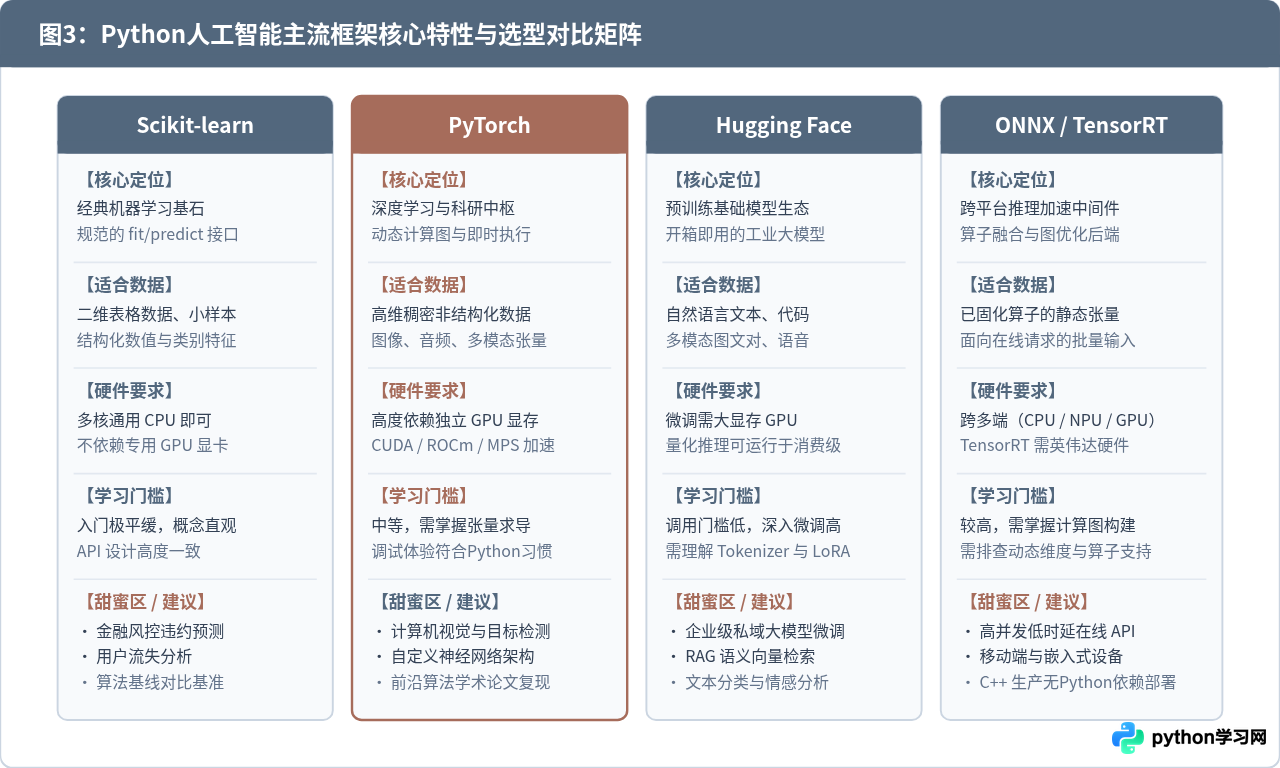
| 框架名称 | 典型应用场景 | 核心优势 | 主要局限 |
|---|---|---|---|
| Scikit-learn | 表格预测、风控、聚类、降维 | 轻量快捷、无GPU依赖、API高度标准化 | 无法原生支持GPU并行与非结构化深度学习 |
| PyTorch | 图像分类、检测分割、前沿科研 | 动态图调试极为直观、学术界支持生态极强 | 原生部署开销大,需借助编译工具优化 |
| Hugging Face | LLM微调、RAG向量检索、智能客服 | 提供海量预训练权重与工业级 Pipeline | 高层封装较厚,高度定制网络内部结构需深入底层 |
| ONNX Runtime | 跨平台在线推理、端侧设备集成 | 计算图优化、多后端加速、跨语言支持 | 仅负责推理执行,不支持反向训练求导 |
四、核心落地应用场景分析
Python 在人工智能领域的价值最终体现在各类真实业务场景的落地变现上。以下四大领域代表了目前工业界最主流的应用方向:
1. 计算机视觉(Computer Vision, CV)
在工业质检、医疗影像分析和自动驾驶中,Python 配合 OpenCV 与 PyTorch (torchvision),能够完成图像去噪、特征提取、目标检测(如 YOLO 算法族)与像素级语义分割。开发者通过 Python 仅需几十行代码即可调用已预训练的视觉骨干网络(ResNet、Vision Transformer),通过微调即可识别特定工业零件的划痕或缺陷。
2. 自然语言处理与大语言模型应用(NLP & LLM)
当前以大语言模型为核心的技术升级中,Python 是整个应用链条的实际载体:
- 企业级私域微调:借助
PEFT库通过 LoRA / QLoRA 技术,仅用单张消费级显卡即可完成对开源大模型(如 Llama 3、Qwen)的垂直领域知识注入。 - 检索增强生成(RAG):结合
LangChain或LlamaIndex,将企业内部文档切片向量化存入向量数据库,并与 LLM 串联,解决大模型生成事实幻觉的问题。 - 高并发模型服务:利用 Python 异步框架编写的
vLLM,通过 PagedAttention 显存优化技术,使大模型推理吞吐量提升数倍。
3. 金融风控与结构化业务决策
在银行反欺诈、信用卡违约概率预估和电商销量预测中,核心依赖 LightGBM 与 XGBoost。这些库基于梯度提升决策树(GBDT)原理,以 C++ 编写内核并深度封装为 Python 接口。它们不仅能够在千万级行数的特征表格上快速收敛,还能通过特征重要性(Feature Importance)或 SHAP 分析直接输出模型决策依据,满足金融监管的合规要求。
4. 智能推荐系统与序列建模
内容资讯与电商平台通过构建召回(Retrieval)与精排(Ranking)模型,处理千人千面的个性化流推荐。Python 在其中负责大规模用户行为日志清洗、特征工程交叉以及深度协同过滤网络的训练。
五、工程落地避坑指南与选型决策
掌握 Python AI 库的基本调用只是起点,在实际业务工程交付中,以下三类常见陷阱直接决定了项目是稳定上线还是因性能故障崩溃:
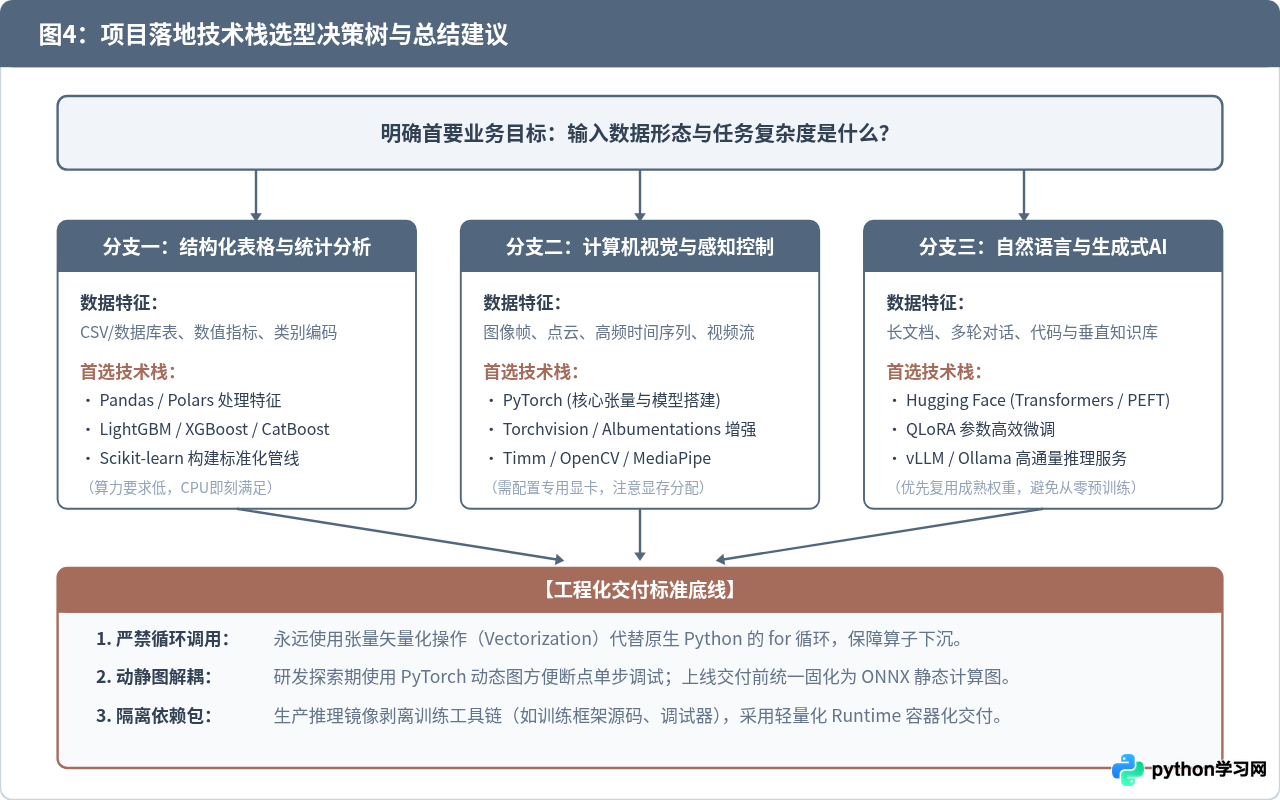
- 拒绝使用原生 Python 循环处理大规模数组:在处理上万条数据记录时,切勿使用
for row in data:逐行运算。必须利用 NumPy 或 PyTorch 的广播机制(Broadcasting)执行矢量化计算。矢量化操作会直接调用底层 CPU SIMD 向量指令集或 GPU 并行核心,运行速度相较于 Python 循环通常可提升 50 至 200 倍。 - 警惕显存泄露与计算图驻留:在 PyTorch 验证循环中,若执行
total_loss += loss,由于loss携带完整的反向传播计算图历史,会导致 GPU 显存随着循环不断飙升直至 OOM(CUDA out of memory)。正确写法必须显式提取标量数值:total_loss += loss.item(),并在推理阶段包裹with torch.no_grad():明确禁止生成计算图。 - 开发环境与生产推理环境严格解耦:训练阶段通常依赖庞大的 PyTorch 全量开发包(体积通常超过 2GB),如果将包含训练编译器、测试代码的全量镜像直接部署到线上生产容器,会带来极大的冷启动延迟和资源浪费。推荐的标准做法是将模型固化为 ONNX 格式,生产线上仅安装轻量级且高度裁剪的
onnxruntime推理引擎(体积不足 50MB),实现跨语言、高吞吐的纯净部署。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















