


Python NumPy矩阵索引与切片获取特定行列
全面解析在Python中使用NumPy对二维数组进行索引与切片的核心方法。详解连续切片、步长采样、离散行列提取、布尔筛选及视图与副本机制,帮助读者高效准确提取特定行列。
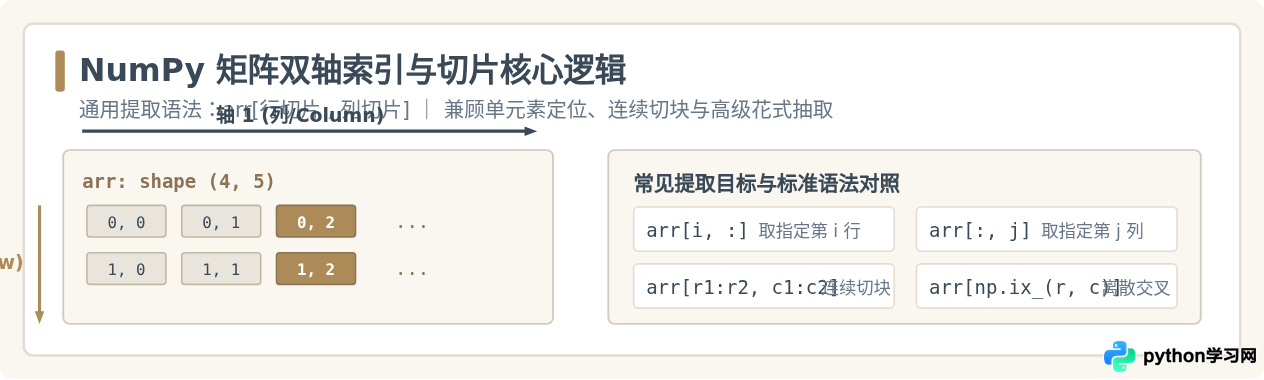
在 Python 的 NumPy 库中,二维数组(矩阵)行列提取的核心原则是“逗号分隔双轴:左边定位行,右边定位列”。无论是获取单一连续行切块、单独列向量,还是提取非连续的离散行列组合,都可以通过统一的 arr[row_spec, col_spec] 语法完成。掌握切片范围、单索引降维与保持维度的区别,以及“基础切片(视图)”与“高级花式索引(副本)”的底层差异,是精确高效操作 NumPy 数据的基础。
一、二维矩阵轴向与切片语法基础
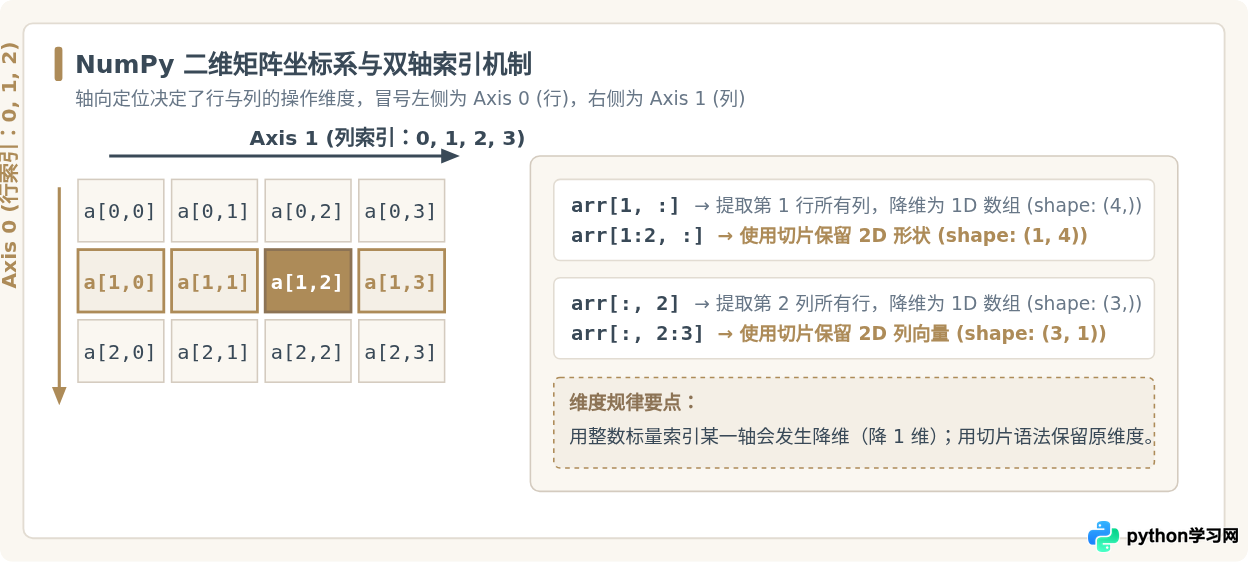
NumPy 中的二维 ndarray 拥有两个轴:轴 0(Axis 0)沿垂直方向延伸,代表“行”;轴 1(Axis 1)沿水平方向延伸,代表“列”。在标准的 Python 原生嵌套列表中,如果想要访问第 1 行第 2 列,通常需要写成 lst[1][2];而在 NumPy 中,推荐使用多维坐标索引语法 arr[1, 2],既更加直观,也具备极高的底层执行性能。
提取特定行或列时,切片符号 : 起到“范围选择”的作用。单个独立的冒号 : 代表选取该轴上的“所有元素”,而 start:stop:step 则代表从 start 开始到 stop-1 为止、步长为 step 的切片。
1. 提取单行与单列
最常见的场景是从二维表中提取某一个特定的样本(某一行)或特定属性特征(某一列)。在 NumPy 中,可以直接通过传入目标索引以及冒号实现:
import numpy as np

# 构建 4 行 5 列的示例二维矩阵
matrix = np.array([
    [10, 11, 12, 13, 14],
    [20, 21, 22, 23, 24],
    [30, 31, 32, 33, 34],
    [40, 41, 42, 43, 44]
])

# 提取第 1 行(索引从 0 起算,即第二行)
row_1 = matrix[1, :]

# 提取第 3 列(即第四列)
col_3 = matrix[:, 3]
matrix[1, :] 提取单行或 matrix[:, 3] 提取单列时,由于行或列坐标使用的是单一标量整数,NumPy 会将输出结果降低一个维度,返回一维数组(shape 为 (5,) 或 (4,))。如果后续计算需要保持二维形态(例如矩阵点乘或拼接操作),应改写为切片写法 matrix[1:2, :] 或 matrix[:, 3:4]。
二、连续与规则行列切片的操作步骤
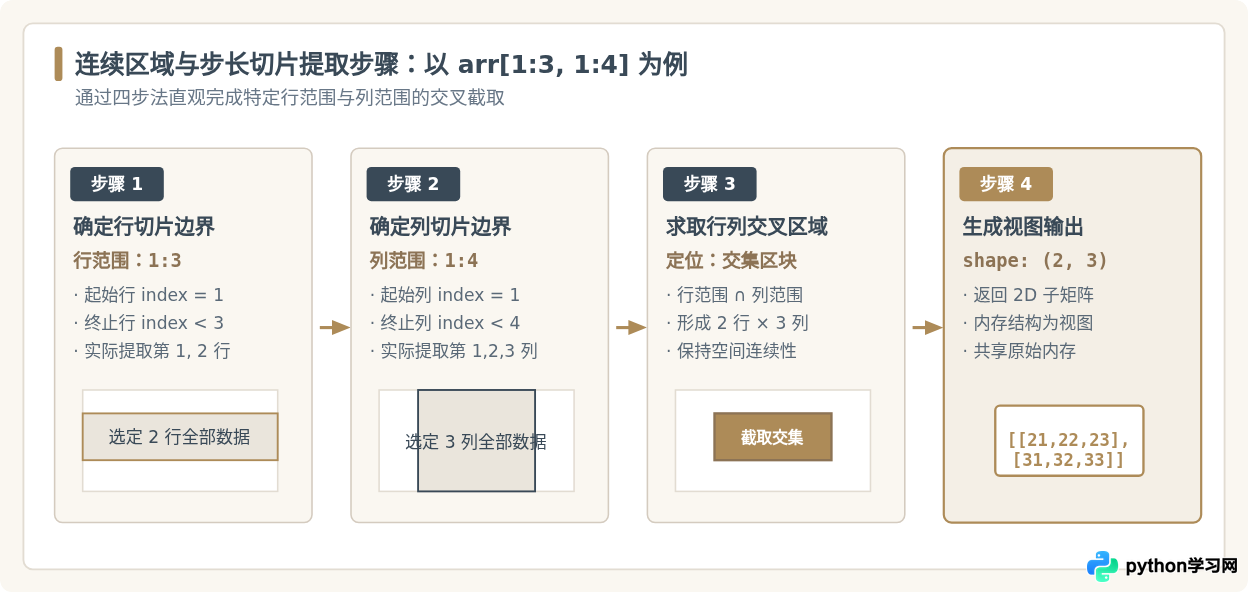
当需要获取连续的多行或多列,或者按照固定步长跳跃采样时,切片参数 start:stop:step 便发挥作用。请注意,NumPy 切片严格遵守 Python“左闭右开”(包含 start,不包含 stop)的规则。
2. 典型切片操作示例
下面通过具体代码展示提取“特定前几行”、“特定后几列”以及“隔行、隔列采样”的操作方式:
import numpy as np

# 建立 5 行 6 列测试矩阵
data = np.arange(10, 40).reshape(5, 6)

# 1. 提取第 0 行到第 2 行(前 3 行),且只保留第 1 列到第 3 列
sub_rect = data[0:3, 1:4]

# 2. 提取所有行的偶数列(步长 step=2)
even_cols = data[:, ::2]

# 3. 提取奇数行(从第 1 行开始,步长为 2),且逆序排列所有列
odd_rows_reversed = data[1::2, ::-1]
三、非连续行列提取:高级索引与布尔掩码
当需要提取的行列并不连续(例如需要第 0 行、第 2 行与第 4 行,或者第 1 列与第 3 列)时,普通的冒号切片无法直接表达这种离散选择。此时需要使用 NumPy 的高级索引(Advanced Indexing),主要包含整数数组索引(花式索引 Fancy Indexing)与布尔掩码(Boolean Masking)。
1. 整数列表/数组提取离散行或列
若仅针对某一个轴进行离散提取,只需在该轴上传入 Python 列表或 1D NumPy 整数数组:
arr[[0, 2, 4], :]:提取第 0、2、4 行,保留所有列。arr[:, [1, 3]]:保留所有行,仅提取第 1 和第 3 列。
2. 同时提取离散行与离散列的常见陷阱
许多初学者常犯的错误是直接书写 arr[[0, 2], [1, 3]],误以为这会提取出 2 行 × 2 列的矩形子矩阵。然而,NumPy 在两个轴同时接收整数数组时,会执行元素级坐标配对(Pairwise Indexing),即提取 (0, 1) 和 (2, 3) 两个孤立点,最终返回形状为 (2,) 的一维数组。
若要获取离散行与离散列构成的二维矩形子矩阵,标准解决方案是使用 np.ix_() 开放网格函数,或进行链式切片:
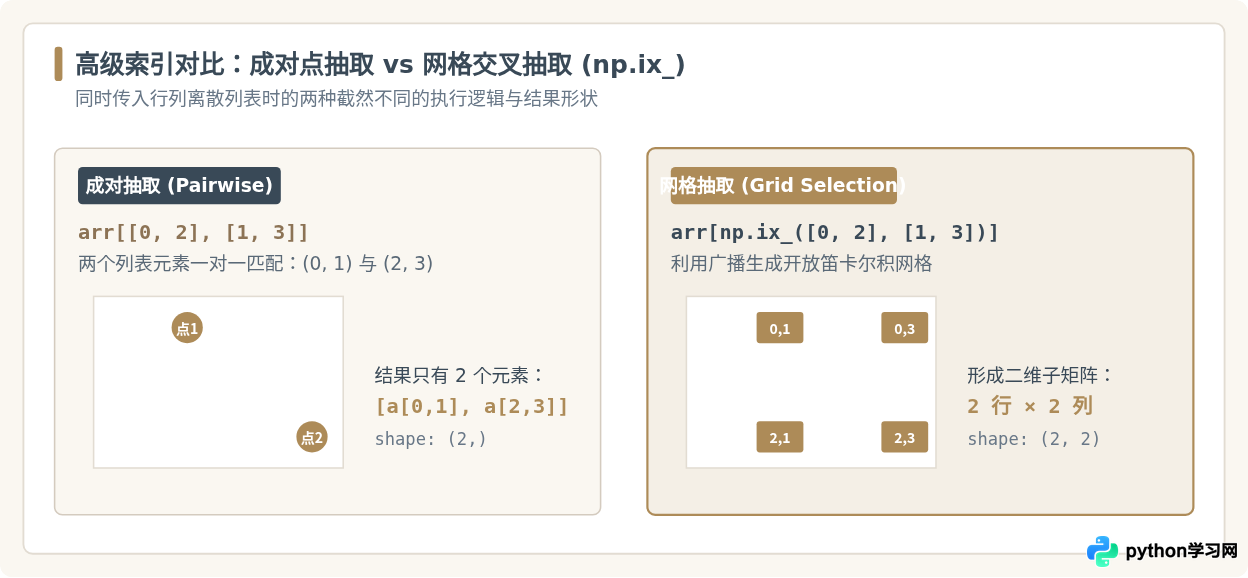
代码验证如下:
import numpy as np

arr = np.array([
    [10, 11, 12, 13],
    [20, 21, 22, 23],
    [30, 31, 32, 33],
    [40, 41, 42, 43]
])

# 错误直觉:提取的是点 (0,1) 和 (2,3),输出 1D 数组
points = arr[[0, 2], [1, 3]]

# 正确做法 1:使用 np.ix_ 提取 2x2 矩形子块
sub_matrix = arr[np.ix_([0, 2], [1, 3])]

# 正确做法 2:两次切片提取(先抽行再抽列)
sub_matrix_chained = arr[[0, 2]][:, [1, 3]]
3. 布尔掩码按条件提取行或列
在实际数据清洗中,经常需要“提取所有首列大于某个阈值的行”。此时可以直接使用布尔数组作为轴 0 的索引:
# 筛选第 0 列数值大于 20 的所有行
condition = arr[:, 0] > 20
filtered_rows = arr[condition, :]
四、关键机制:视图(View)与副本(Copy)的区别
在执行切片和索引操作时,最重要但也最容易引发隐蔽 Bug 的机制是视图与副本的区分。修改切片得到的新变量,是否会导致原始矩阵发生变化?这取决于采用的是基础切片还是高级索引。
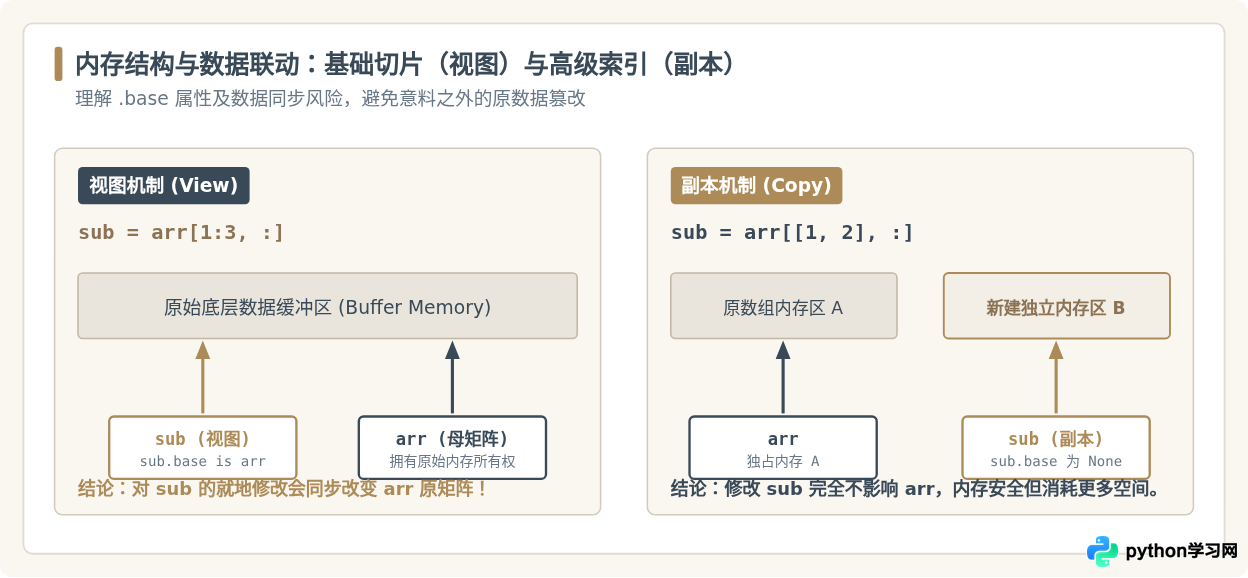
代码验证内存归属:
import numpy as np

source = np.array([[1, 2], [3, 4], [5, 6]])

# 1. 基础切片:返回视图 (View)
view_slice = source[0:2, :]
print("view_slice.base is source:", view_slice.base is source)  # True

# 修改视图中的元素
view_slice[0, 0] = 999
print("修改视图后原矩阵:\n", source)  # source[0, 0] 变成了 999

# 2. 花式索引:返回副本 (Copy)
copy_slice = source[[0, 1], :]
print("copy_slice.base is None:", copy_slice.base is None)      # True

# 修改副本中的元素
copy_slice[0, 0] = 111
print("修改副本后原矩阵并未改变:\n", source)  # source[0, 0] 依然是 999
arr[r1:r2, c1:c2] 提取行列后,需要对提取出的子矩阵进行归一化、填充或修改,且不希望破坏原矩阵数据,请务必显式调用 .copy() 方法,例如:safe_sub = arr[1:3, :].copy()。
五、行列提取方法选型指南与常见总结
为了帮助读者在面对不同的行列提取需求时能够快速选择最恰当的语法,下表对各类典型场景进行了全面归纳:
| 目标场景 | 推荐代码语法 | 输出维度 (Shape) | 内存机制 |
|---|---|---|---|
| 提取单行(降维) | arr[i, :] |
1D (N,) |
视图 (View) |
| 提取单行(保持二维) | arr[i:i+1, :] |
2D (1, N) |
视图 (View) |
| 提取单列(降维) | arr[:, j] |
1D (M,) |
视图 (View) |
| 提取单列(保持列向量) | arr[:, j:j+1] |
2D (M, 1) |
视图 (View) |
| 连续子矩阵块 | arr[r_start:r_stop, c_start:c_stop] |
2D (H, W) |
视图 (View) |
| 隔行/隔列均匀采样 | arr[::step_r, ::step_c] |
2D (H', W') |
视图 (View) |
| 离散多行、保留全部列 | arr[[0, 2, 3], :] |
2D (K, N) |
副本 (Copy) |
| 离散多行与多列的网格截取 | arr[np.ix_([0, 2], [1, 3])] |
2D (K, P) |
副本 (Copy) |
| 根据条件动态提取行 | arr[arr[:, 0] > 10, :] |
2D (Count, N) |
副本 (Copy) |
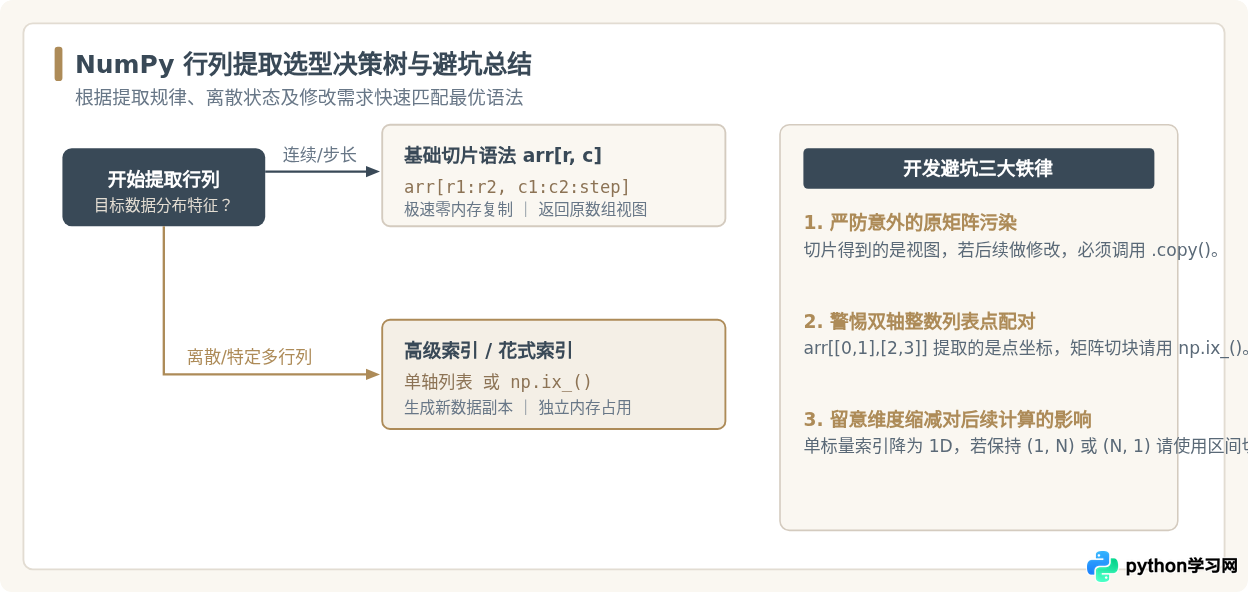
总结而言,熟练掌握 NumPy 矩阵的行列提取,关键在于建立清晰的“双轴思维”:第一维决定行,第二维决定列;连续切片求交集用冒号,离散网格取子块用 np.ix_,需就地修改且隔离原数据时显式使用 .copy()。遵循这些核心原则,可以在保障代码简洁可读的同时,充分发挥 NumPy 高性能底层向量化计算的优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















