


Python中“且”运算用and还是&?逻辑与位运算的区别
深入解析Python中and与&运算符的核心区别。从逻辑判断与二进制位运算的基本定义出发,剖析短路求值机制、返回值规则、运算符优先级陷阱,以及在Pandas和NumPy多条件过滤中选择&的底层原因。
一、核心机制对比:逻辑与位运算的本质定位
要正确区分 and 和 &,首先需要明确 Python 语法对两者的根本定义:
and(逻辑与):Python 的内置关键字。它用于对两个表达式进行逻辑真假(Truth Value)判定。and不关心底层二进制位,而是根据操作数的布尔真值决定运算路径,并且具备短路求值(Short-circuit Evaluation)机制。此外,and属于语言层面的控制结构,任何类都无法通过重载方法改变它的行为。&(按位与):Python 的双目操作符。它作用于整型对象时,会对数字对应的二进制补码进行逐位比对;对于布尔值,执行标准的布尔代数运算;更重要的是,它可以被 Python 类通过__and__和__rand__魔法方法进行运算符重载。数据科学库(如 NumPy 和 Pandas)正是利用重载机制,让&实现了多维数组或数据列的逐元素(Element-wise)逻辑运算。&不具备短路求值能力,两边表达式必须全部计算。
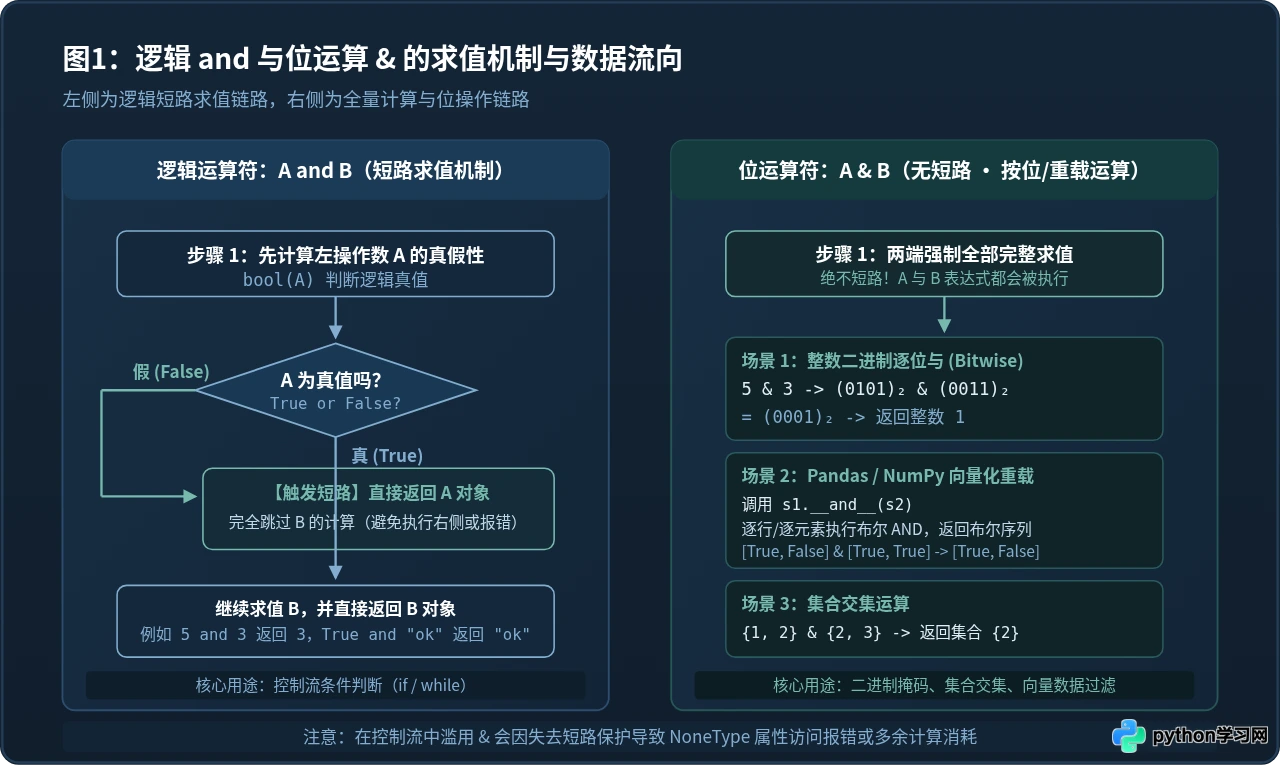
从图1可以看出,二者最显著的执行差异在于是否会强制计算右侧表达式。正是这一机制,决定了它们在代码鲁棒性与性能上的不同表现。
二、短路求值与返回值差异:为什么 5 and 3 与 5 & 3 结果完全不同
在 Python 交互式环境中输入以下两行代码,会得到截然不同的结果:
# 示例代码:交互式环境测试
>>> 5 and 3
3
>>> 5 & 3
1
1. and 的短路规则与真值返回机制
初学者常误以为 5 and 3 会返回布尔值 True。事实上,Python 官方规范对 x and y 的定义如下:
“求值表达式 x;如果 x 为假值(Falsey),则直接返回 x 的值;否则,继续求值 y 并返回 y 的计算结果。”
因此,在 5 and 3 中,左操作数 5 判定为真(非零整型均为真),and 继续计算右侧并返回 3。而在 0 and 3 中,左操作数 0 为假,Python 立即短路,直接返回 0,甚至不会去碰右边的 3。
短路机制在业务开发中极为关键,常用于防御性编程。例如在访问深层属性或解引用时,避免抛出空指针或越界异常:
# 利用 and 短路保护机制:若 user 为 None,右侧 user.profile 绝不会执行
if user is not None and user.profile.is_authenticated:
    allow_access()
如果将上述代码中的 and 错误地写成 &:
if (user is not None) & user.profile.is_authenticated:
当 user 为 None 时,由于 & 没有短路机制,Python 仍会无条件执行右侧的 user.profile,导致程序直接崩溃并抛出 AttributeError: 'NoneType' object has no attribute 'profile'。
2. & 的二进制按位运算规则
对于 5 & 3,Python 把它当作二进制运算处理。数值 5 转换为二进制为 0b101,数值 3 为 0b011。两者按位进行与运算:
  0b101   (整数 5)
& 0b011   (整数 3)
-------
  0b001   (整数 1)
只有当两个对应位置都为 1 时,该位的结果才为 1。因此 5 & 3 的计算结果为 1。它处理的是数值的底层二进制状态,常用于低层位掩码(Bitmask)或标志位(Flag)提取。
三、运算符优先级陷阱:为什么 Pandas 过滤必须加括号
在数据分析中,很多开发者都遇到过这种令人生惑的报错:
# 错误写法:未加括号的 Pandas 多条件查询
df = pd.DataFrame({'age': [15, 22, 30], 'score': [85, 90, 72]})
result = df[df['age'] > 18 & df['score'] > 80]
# 抛出异常:TypeError: Cannot perform 'rand_' with a dtyped [int64] array and scalar of type [bool]
出现这一报错的根源在于 Python 语言规范中规定的运算符优先级:
位运算符 & 的优先级高于比较运算符(>、<、== 等),而逻辑运算符 and 的优先级低于比较运算符。
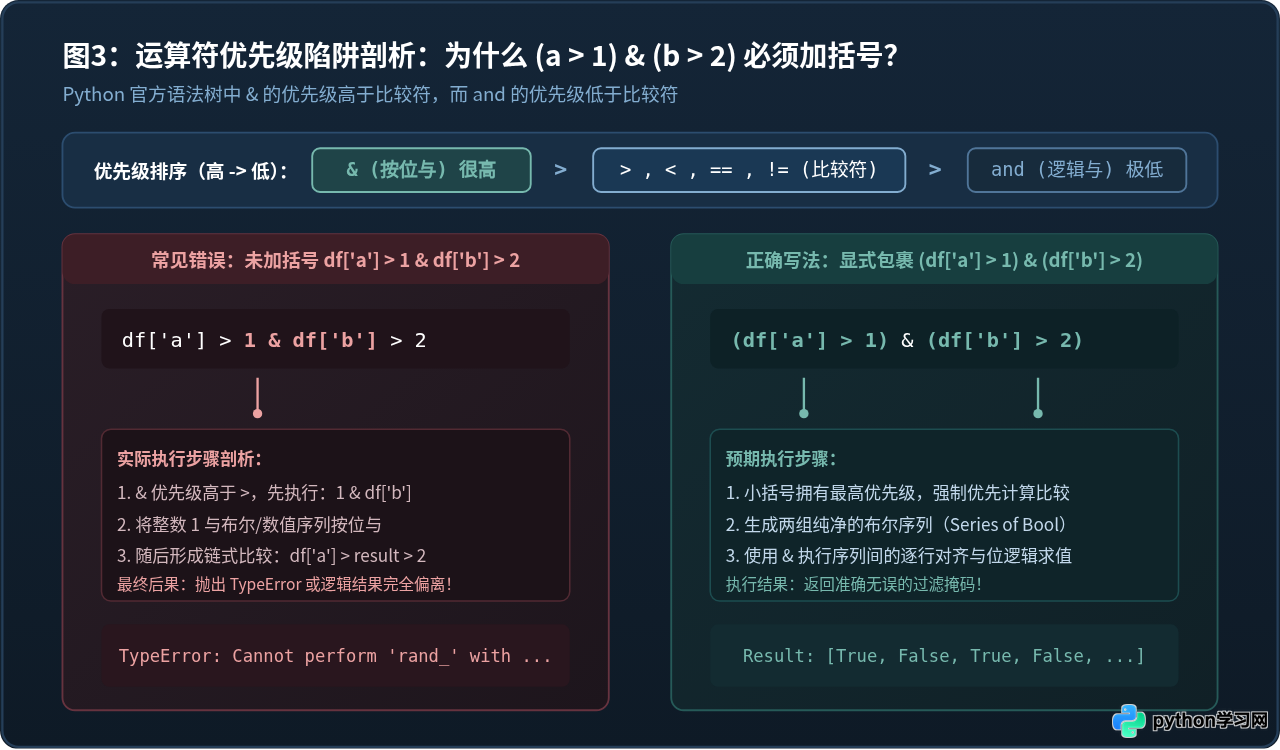
如图3所示:
- 在普通逻辑表达中,
a > 10 and b < 20之所以能正常运行,是因为比较符>和<先执行,最后由and连接两个比较结果。 - 但在
df['age'] > 18 & df['score'] > 80中,Python 词法分析器会优先将&与其紧挨的操作数绑定,解析为:
df['age'] > (18 & df['score']) > 80
这意味着 Python 尝试把整数 18 与包含整型列的 df['score'] 进行按位与运算,随后构造了一个非预期的三元链式比较。这不仅使逻辑彻底崩塌,还会因 Pandas 无法对序列进行链式真值判断而直接抛出 TypeError 或 ValueError。
解决方案:必须对每个子条件显式添加小括号。小括号具有最高的运算优先级,能确保两侧的比较先独立生成布尔序列,再由 & 完成元素级的位与运算:
# 正确做法:显式添加小括号隔离比较运算符
correct_result = df[(df['age'] > 18) & (df['score'] > 80)]
# 输出过滤结果:仅保留第 2 行(age=22, score=90)
四、数组与数据分析场景:为什么 Pandas / NumPy 必须用 &
既然 and 不存在优先级混淆问题,那为什么在 Pandas 中不能直接写 (df['age'] > 18) and (df['score'] > 80) 呢?
# 尝试在 Pandas 中使用 and 连接条件
result = df[(df['age'] > 18) and (df['score'] > 80)]
# 抛出经典错误:
# ValueError: The truth value of a Series is ambiguous. Use a.empty, a.bool(), a.item(), a.any() or a.all().
这一报错揭示了 and 的底层实现限制:
and会强制调用左侧对象的bool()方法来判定其真假。df['age'] > 18返回的是一个包含多个布尔值的 PandasSeries。对于一个包含多个True和False的序列,Python 无法断定整个序列是真还是假——究竟是一个为真算真,还是全部为真才算真?因此 Pandas 设计者在Series.__bool__()中主动抛出ValueError,禁止这种产生歧义的隐式类型转换。- 更关键的是,
and是 Python 原生保留字,不受__and__等任何魔法方法控制,Pandas 无法重写and的执行逻辑。
相反,& 映射到底层魔法方法 __and__。Pandas 在 Series 类中重载了该方法,将其实现为对两个序列逐行进行逻辑与运算,并输出一个全新的布尔序列。因此,在 Pandas 和 NumPy 的多条件过滤中,必须使用 &。
五、如何准确选择?决策步骤与选型流程
在实际编码中,读者可以通过以下步骤快速确立选型路径:
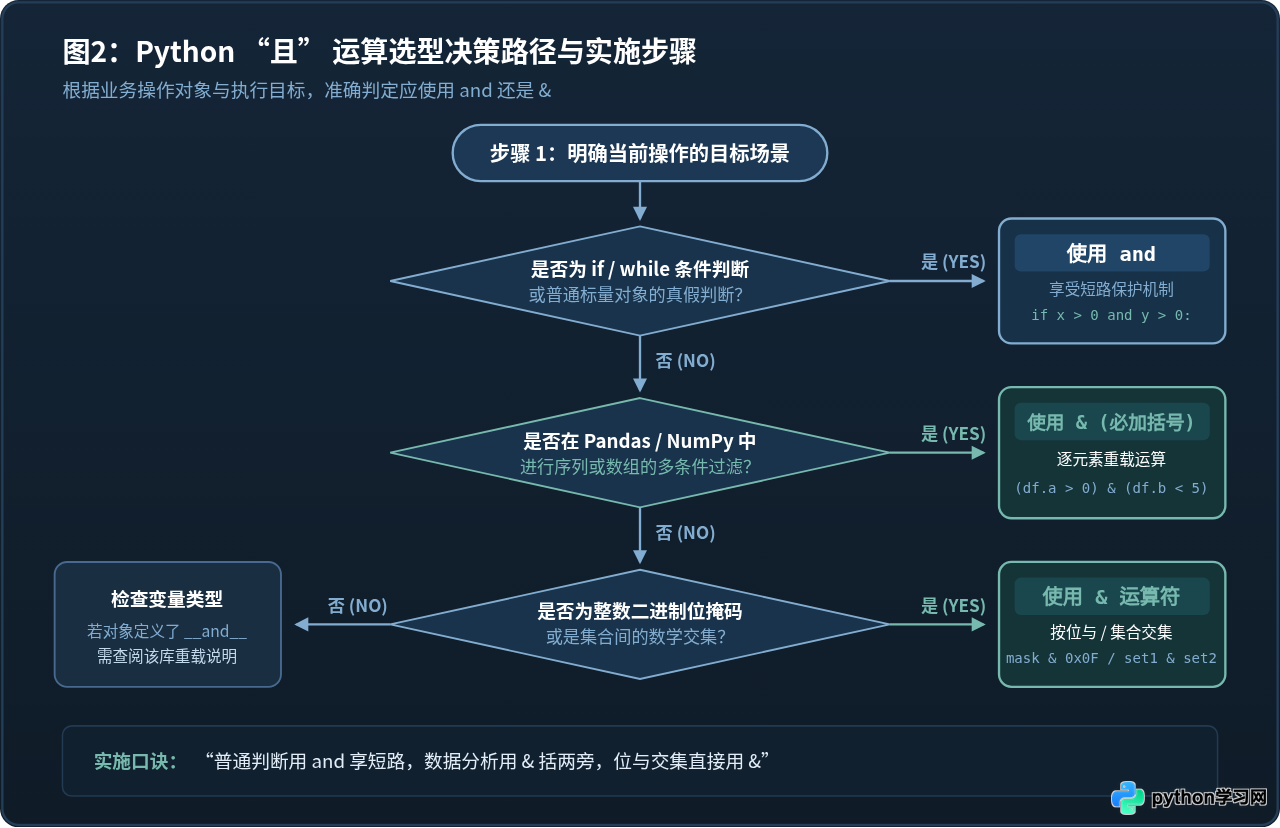
按照图2所示的操作流程,选型可以归纳为明确的三步排查:
-
步骤 1:判断当前代码是否处于控制流(
if/while)中?
如果判断对象是普通的单值布尔变量、标量比较(如score >= 60)或对象存在性检查,必须使用and。这样不仅符合 Pythonic 风格,还能充分利用短路特性提高执行效率、防止空指针异常。 -
步骤 2:判断是否在对 NumPy 数组或 Pandas DataFrame/Series 进行多条件向量筛选?
如果需要对序列进行逐元素过滤,必须使用&,同时必须对每个比较子条件包裹小括号(如(s > 10) & (s < 50))。 -
步骤 3:判断是否进行底层二进制位运算或集合求交集?
如果是提取系统状态码的位标志(如status & 0x04),或者对两个set集合求交集(如set_a & set_b),使用&运算符。
六、全维度特性速查与常见易错点总结
为了帮助读者在日常开发中形成清晰对照,下表整理了 and 与 & 在各个核心维度的具体差异:
| 对比维度 | 逻辑运算符 and |
按位运算符 & |
|---|---|---|
| 本质定义 | Python 关键字,用于标量布尔逻辑 | Python 二元操作符,用于二进制或重载操作 |
| 短路特性 | 支持(左侧为假时右侧完全不执行) | 不支持(左右两侧均会强制计算) |
| 返回值规则 | 返回决定真值的操作数对象本身 | 返回按位与后的整数、新集合或布尔序列 |
| 运算符重载 | 不可重载(类无法修改其行为) | 支持重载(通过 __and__ 与 __rand__) |
| 运算符优先级 | 低于比较运算符(无需额外加括号) | 高于比较运算符(必须为比较式加括号) |
| 典型应用场景 | if a > 0 and b > 0:防御性判空检查 |
(df.a > 0) & (df.b > 0)二进制掩码操作、集合求交集 |
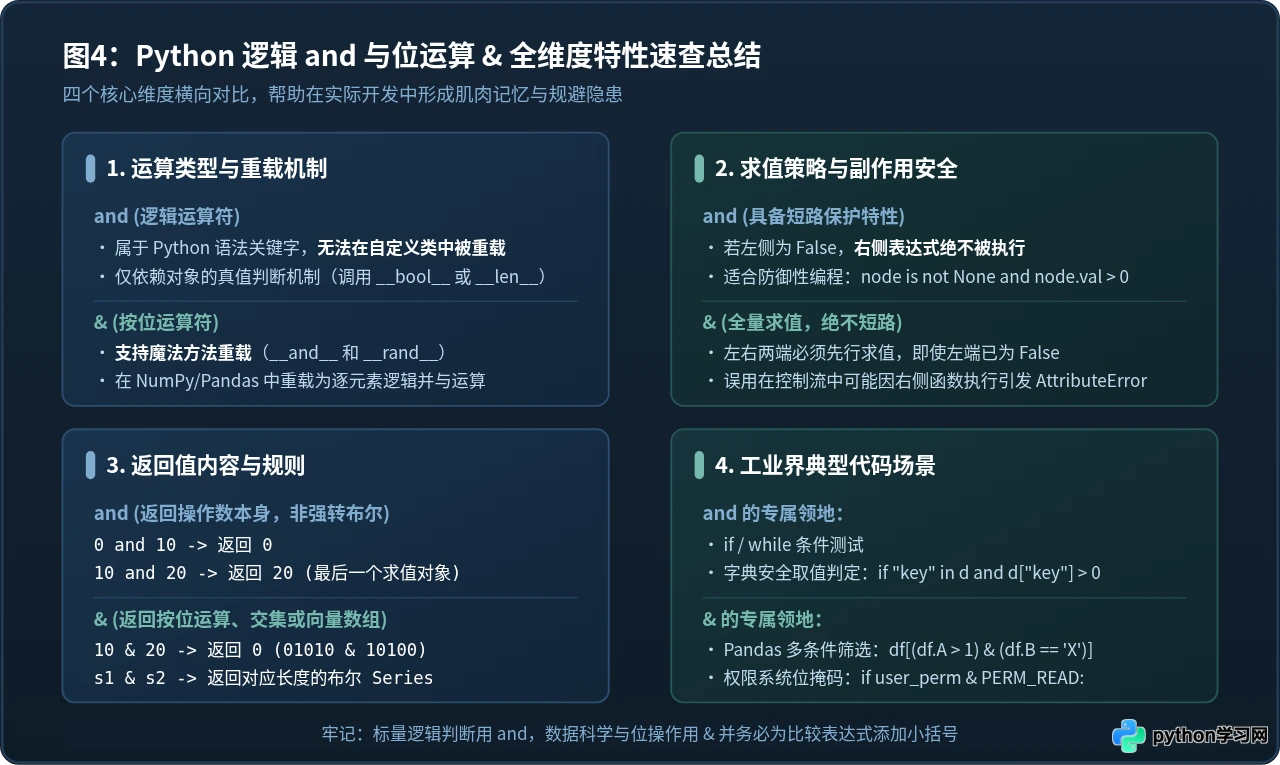
常见易错点清单:
- 遗漏小括号:在 Pandas 条件查询中写出
df[df['a'] > 0 & df['b'] < 10]。记住原则:只要在数据分析中使用&,比较表达式必须用括号完整包覆。 - 在条件分支中混淆使用:写出
if func_a() & func_b():。由于&没有短路能力,即使func_a()返回了False,耗时的func_b()依然会被执行,造成多余性能开销甚至意外副作用。 - 误解
and的返回值:将result = a and b的结果直接当作严格的bool类型使用。若a和b是列表或字典,返回的将是原始对象而非布尔值。若需要严格的布尔类型,应显式使用bool(a and b)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















