


Python爬虫作为数据分析前置步骤的价值与实践

深入探讨Python爬虫作为数据分析前置输入层的核心价值与实践路径,涵盖从分析目标推导爬虫逻辑、结构化抽取、前置数据清洗到Pandas对接的完整流程与质量防线。
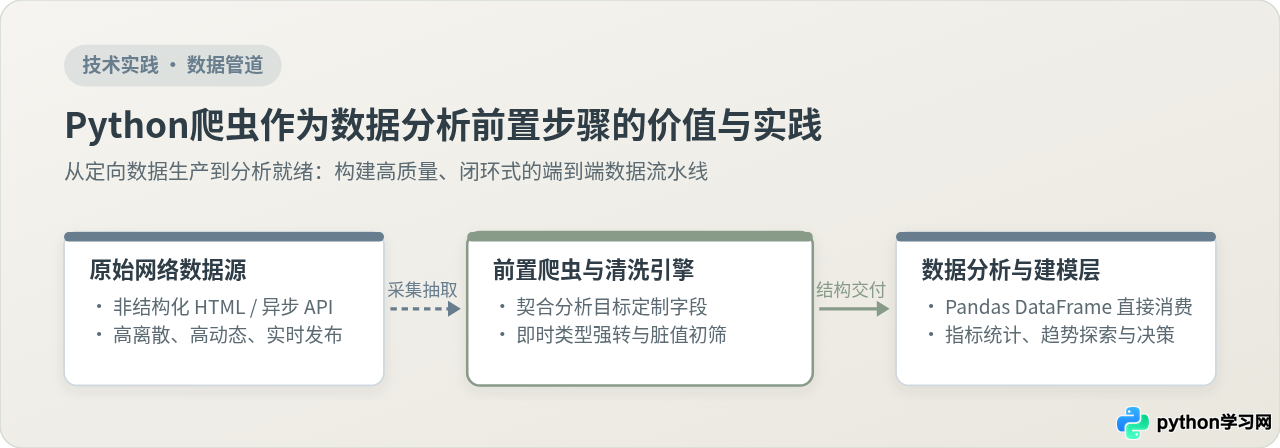
在实际数据分析项目中,分析人员经常面临现成公开数据集时效滞后、字段缺失或与分析假设不匹配的问题。将Python爬虫确立为数据分析的前置步骤,核心目的不是单纯为了收集网页文本,而是将非结构化的网络信息转化为“结构完备、类型严格、直接就绪”的分析输入源。本文直接梳理爬虫作为前置输入层的定位机制、两类数据获取模式的关键差异,并提供一套从分析Schema反推请求、容错抽取、字段强转到对接Pandas的完整工程实践方案。
一、数据分析全链路中爬虫的前置定位与价值核心
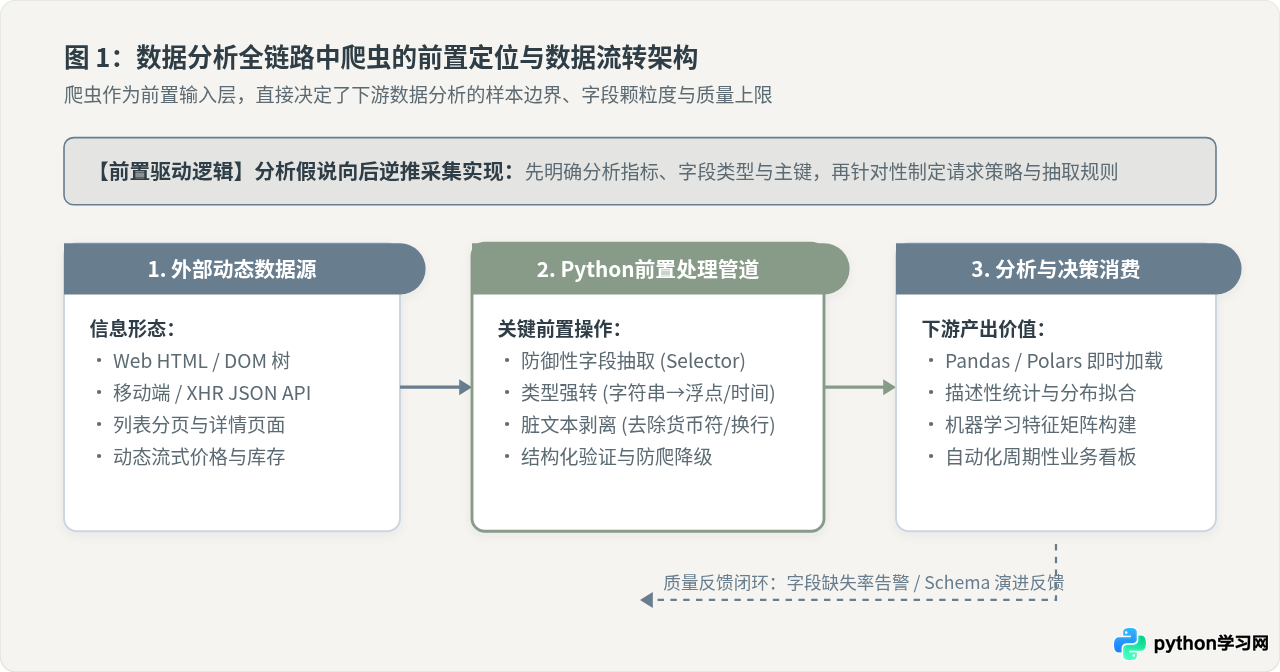
传统认知往往将网络爬虫视作纯粹的软件工程抓取工具,将数据分析视作下游的统计与建模任务,两者之间隔着漫长且断裂的离线文件传递。然而,在以业务洞察为驱动的现代分析链路中,爬虫是数据流进入分析引擎的第一道生产工序。
分析假说的成立与否,高度依赖输入样本的针对性。当所需要的数据在公开渠道未以规整的结构化形态存在时,分析人员必须掌握主动生产数据的能力。Python爬虫作为前置步骤,为后续分析奠定了三层核心基础:
- 字段粒度的完全自主权:分析人员可根据特定的业务指标(例如特定二手电子产品的验机报告明细、电池健康度标签、最后调价时间戳),有针对性地定位DOM或接口字段,避免受限于现成数据集粗颗粒度的字段定义。
- 微观时间序列的连续捕获:网络信息是高度动态的。通过编写调度爬虫,可以按小时或自然日为周期拉取目标对象在不同时刻的挂牌价、库存量或评论增量,构建高精度的动态时间截面。
- 多源信息的定向对齐:针对同一分析实体,能够分别抓取官方产品参数页、多平台二级市场交易列表以及社区评测情绪,在采集阶段即完成标识符(如产品唯一型号)的对齐与汇聚。
二、模式对照:静态公开数据集 vs 定向自建爬虫链路
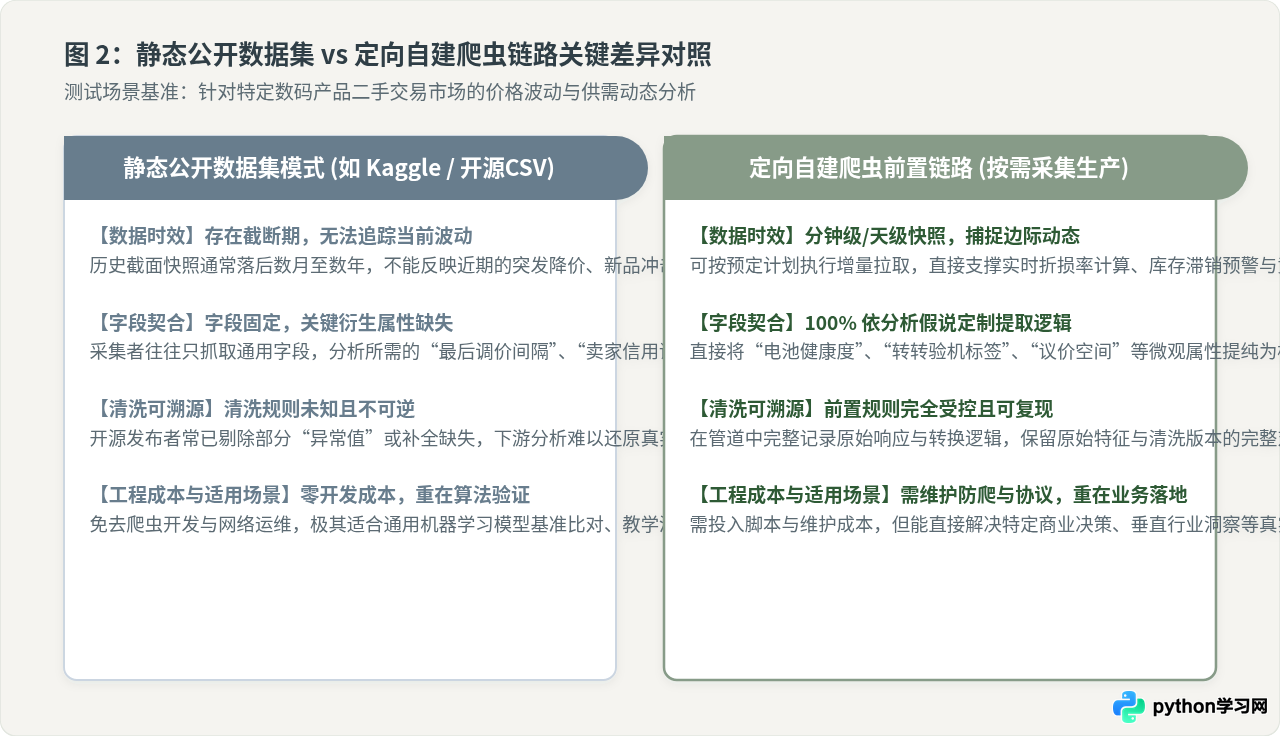
为了准确评估不同数据接入方式对后续分析结论的影响,我们设定一个具体的业务对照条件:对“某垂直品牌二手平板电脑的交易价格折损分布与供需周期”进行专题分析。在此一致条件下,对比直接使用第三方平台公开的静态历史数据集与自建定向Python爬虫两种实施路径。
| 比较维度 | 模式 A:静态公开数据集 (Kaggle/开源仓库) | 模式 B:定向自建Python爬虫前置链路 |
|---|---|---|
| 数据时效与刷新 | 静态截面,存在显著的时间截断(通常滞后数月至数年),无法反映突发行情变化。 | 高时效性,可配置分钟级或天级调度,捕获市场即时调价、新品发布冲击等边际变化。 |
| 字段定制与契合度 | 字段由第三方发布者决定,常缺乏特定分析所需的微观维度(如验机报告等级、成色细节、发货地)。 | 按分析指标定义逐一逆向提取,字段契合度达100%,可灵活新增衍生字段。 |
| 清洗可溯源性 | 发布者可能已执行未知的过滤、填补或截断逻辑,原始样本分布难以完全还原。 | 前置清洗规则完全自主控制,保留原始快照与转换规则,分析结果具备完全的可复现性。 |
| 实施成本与稳定性 | 零开发成本,无需担心网络抖动、页面改版或反爬拦截。 | 需编写请求逻辑、维护解析规则、配置重试与反爬对策,具备一定的工程维护成本。 |
| 典型适用定位 | 通用算法模型准确率评测、基准测试、教学演练。 | 特定商业场景决策、高频竞争情报监控、敏捷特征工程与探索性数据分析(EDA)。 |
两者的差异揭示了一个核心权衡:公开数据集适合验证通用统计学方法或算法模型,而一旦分析任务旨在回答“当下市场现状如何”、“特定属性对价格有何敏感影响”等具体业务疑问时,自建前置爬虫就成为不可替代的基石。
三、从分析需求反推爬虫设计的四步实施法
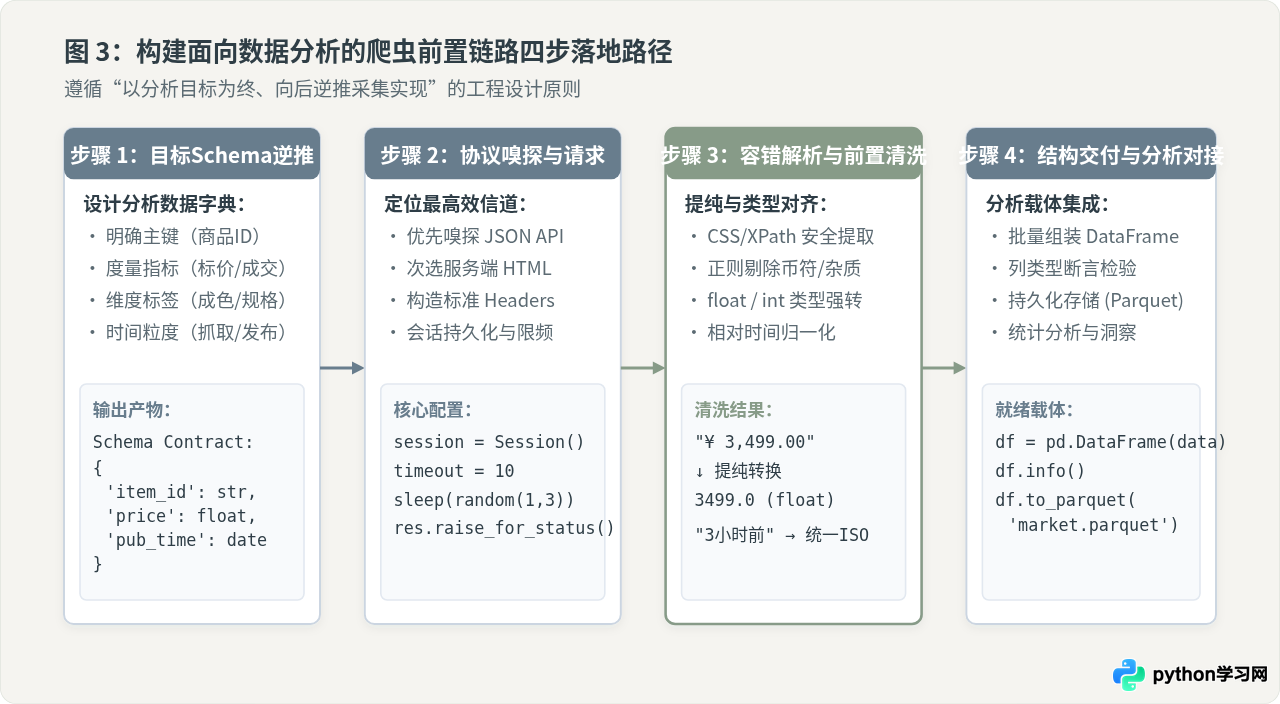
初学者在构建爬虫时容易陷入“见什么抓什么”的被动逻辑,将页面上的全部文字无节制地存储为粗糙的文本列,导致进入Pandas后仍需处理大量混乱的格式。真正的分析前置爬虫应当遵循“以终为始”的原则,自分析目标向后逆推采集实现。
第一步:明确分析目标Schema与数据契约
在写下第一行抓取代码前,首先在草稿中定义好下游分析所需的DataFrame数据字典。明确目标字段的名称、业务含义以及期望的Python/Pandas数据类型:
item_id(字符串):商品的唯一业务主键,用于跨周期去重;title(字符串):商品标题,用于自然语言分类或关键词提取;price(浮点型):标牌价格,必须提纯为干净的float数字,剥离货币符号;condition_grade(分类变量/字符串):成色等级(如“99新”、“95新”);is_verified(布尔型):是否包含官方质检或平台验机背书;post_timestamp(标准日期时间):发布时间,需将相对表述统一转为ISO-8601格式;crawled_at(标准时间戳):记录采集执行时刻,支撑时序快照分析。
第二步:网络协议嗅探与低阻请求建模
在浏览器开发者工具(Network面板)中优先寻找返回JSON格式的异步XHR/Fetch接口。相较于解析HTML页面,直接消费JSON接口具有解析速度快、字段结构稳定、网络带宽消耗低的明显优势。若必须抓取服务端渲染的HTML页面,则需使用会话对象维持连接池,配置真实规范的User-Agent与合规的请求头,并加入随机延迟。
第三步:防御性解析与前置类型强转
这一步是爬虫向数据分析过渡的关键节点。如果直接将"¥ 2,899.00"或"3小时前"原样写入文件,下游Pandas读取后将全部识别为object文本列,迫使分析师在探索阶段反复调用字符串替换和时间转换函数。
前置清洗的策略是在解析阶段即利用正则表达式剥离逗号与货币符号,直接转为float;将相对时间根据当前运行时间基准计算为绝对日期。同时,对可能缺失的字段采用防御性提取,缺省值显式赋为None或np.nan,保证每条记录的列结构完全对称。
第四步:结构交付与分析载体持久化
将抓取批次实时聚合为结构化记录列表,定期或在任务结束时实例化为pandas.DataFrame。在落盘时,优先推荐采用列式存储格式(如Parquet)或轻量关系型数据库(SQLite),相比传统CSV格式,Parquet能够原生保留每列的数据类型元数据,避免再次读取时发生类型退化。
四、端到端可执行实战:从网络抓取到Pandas就绪
下面给出一个符合上述工程规范的完整Python代码示例。代码演示了从一个模拟的结构化网络数据源中拉取商品列表、在抽取阶段完成数值清洗与时间规整,并最终构建出直接用于统计分析的Pandas DataFrame。
pip install requests beautifulsoup4 pandas代码可作为独立脚本运行,也可放入 Jupyter Notebook 的代码单元格中分段执行。
import re
import time
from datetime import datetime, timedelta
import requests
from bs4 import BeautifulSoup
import pandas as pd

# -------------------------------------------------------------
# 1. 模拟网络响应与采集环境准备
# 实际生产中替换为真实目标URL及合规Headers
# -------------------------------------------------------------
MOCK_HTML = """
<div class="goods-container">
  <div class="item-card" data-id="SN-89210">
    <h3 class="title">Apple iPad Pro 11寸 M2芯片 128G 深空灰</h3>
    <span class="price-tag">¥ 4,299.00</span>
    <span class="tag-condition">99新</span>
    <span class="badge-verify">官方验机通过</span>
    <time class="pub-time">2小时前</time>
  </div>
  <div class="item-card" data-id="SN-89211">
    <h3 class="title">Apple iPad Air 5 64G 紫色 仅拆封</h3>
    <span class="price-tag">¥ 3,150.00</span>
    <span class="tag-condition">95新</span>
    <!-- 无验机标签 -->
    <time class="pub-time">昨天</time>
  </div>
  <div class="item-card" data-id="SN-89212">
    <h3 class="title">Apple iPad 9代 64G 银色 屏幕微划痕</h3>
    <span class="price-tag">¥ 1,380.00</span>
    <span class="tag-condition">9成新</span>
    <span class="badge-verify">已质检</span>
    <time class="pub-time">3天前</time>
  </div>
</div>
"""

def parse_relative_time(text: str, base_time: datetime) -> datetime:
    """将中文相对时间表述转换为绝对 datetime 对象"""
    text = text.strip()
    if "小时前" in text:
        hours = int(re.search(r'\d+', text).group())
        return base_time - timedelta(hours=hours)
    elif "昨天" in text:
        return (base_time - timedelta(days=1)).replace(hour=12, minute=0, second=0)
    elif "天前" in text:
        days = int(re.search(r'\d+', text).group())
        return (base_time - timedelta(days=days)).replace(hour=12, minute=0, second=0)
    return base_time

def clean_price(text: str) -> float:
    """剥离货币符号及逗号,提纯为标量浮点数"""
    cleaned = re.sub(r'[^\d.]', '', text)
    return float(cleaned) if cleaned else 0.0

def extract_record(card_soup, crawl_time: datetime) -> dict:
    """针对单张卡片的防御性提取与前置清洗"""
    item_id = card_soup.get("data-id", "UNKNOWN")

    title_el = card_soup.select_one(".title")
    title = title_el.get_text(strip=True) if title_el else ""

    price_el = card_soup.select_one(".price-tag")
    price = clean_price(price_el.get_text(strip=True)) if price_el else 0.0

    cond_el = card_soup.select_one(".tag-condition")
    condition = cond_el.get_text(strip=True) if cond_el else "未标注"

    verify_el = card_soup.select_one(".badge-verify")
    is_verified = (verify_el is not None)

    time_el = card_soup.select_one(".pub-time")
    pub_time = parse_relative_time(time_el.get_text(strip=True), crawl_time) if time_el else crawl_time

    return {
        "item_id": item_id,
        "title": title,
        "price": price,
        "condition": condition,
        "is_verified": is_verified,
        "published_at": pub_time,
        "crawled_at": crawl_time
    }

# -------------------------------------------------------------
# 2. 执行前置管道流转
# -------------------------------------------------------------
crawl_timestamp = datetime.now()
soup = BeautifulSoup(MOCK_HTML, "html.parser")
cards = soup.select(".item-card")

records = []
for card in cards:
    record = extract_record(card, crawl_timestamp)
    records.append(record)

# -------------------------------------------------------------
# 3. 结构交付与分析引擎加载
# -------------------------------------------------------------
df = pd.DataFrame(records)

# 验证数据类型与结构对齐情况
print("=== DataFrame 字段类型与非空校验 ===")
df.info()

print("\n=== 数值指标描述性统计 ===")
print(df[["price"]].describe())

print("\n=== 分类维度交叉统计(是否验机 vs 平均标价) ===")
summary = df.groupby("is_verified")["price"].agg(["count", "mean", "min", "max"])
print(summary)
示例运行输出
=== DataFrame 字段类型与非空校验 ===
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 3 entries, 0 to 2
Data columns (total 7 columns):
 #   Column        Non-Null Count  Dtype
---  ------        --------------  -----
 0   item_id       3 non-null      object
 1   title         3 non-null      object
 2   price         3 non-null      float64
 3   condition     3 non-null      object
 4   is_verified   3 non-null      bool
 5   published_at  3 non-null      datetime64[ns]
 6   crawled_at    3 non-null      datetime64[ns]
dtypes: bool(1), datetime64[ns](2), float64(1), object(3)
memory usage: 275.0+ bytes

=== 数值指标描述性统计 ===
             price
count     3.000000
mean   2943.000000
std    1470.521336
min    1380.000000
50%    3150.000000
max    4299.000000

=== 分类维度交叉统计(是否验机 vs 平均标价) ===
             count    mean     min     max
is_verified
False            1  3150.0  3150.0  3150.0
True             2  2839.5  1380.0  4299.0
如示例输出所示,经过前置清洗后的DataFrame中,price列已被直接赋予float64类型,published_at已被转换为标准datetime64[ns]时间戳,is_verified则为精确的布尔标志位。这使得后续直接执行描述性统计、按时间窗口切片聚合时无需再插入任何文本规整代码,显著提升了分析流程的纯粹性与运行效率。
五、工程稳定性与数据质量的三重防线
当爬虫承担起分析数据输入的职责后,其工程韧性就直接与分析报告的可信度挂钩。网络超时、页面改版或反爬风控策略的调整,都可能悄无声息地向下游输送大量缺失值或畸变数据。因此,必须在抓取管道中内嵌三重质量防线。
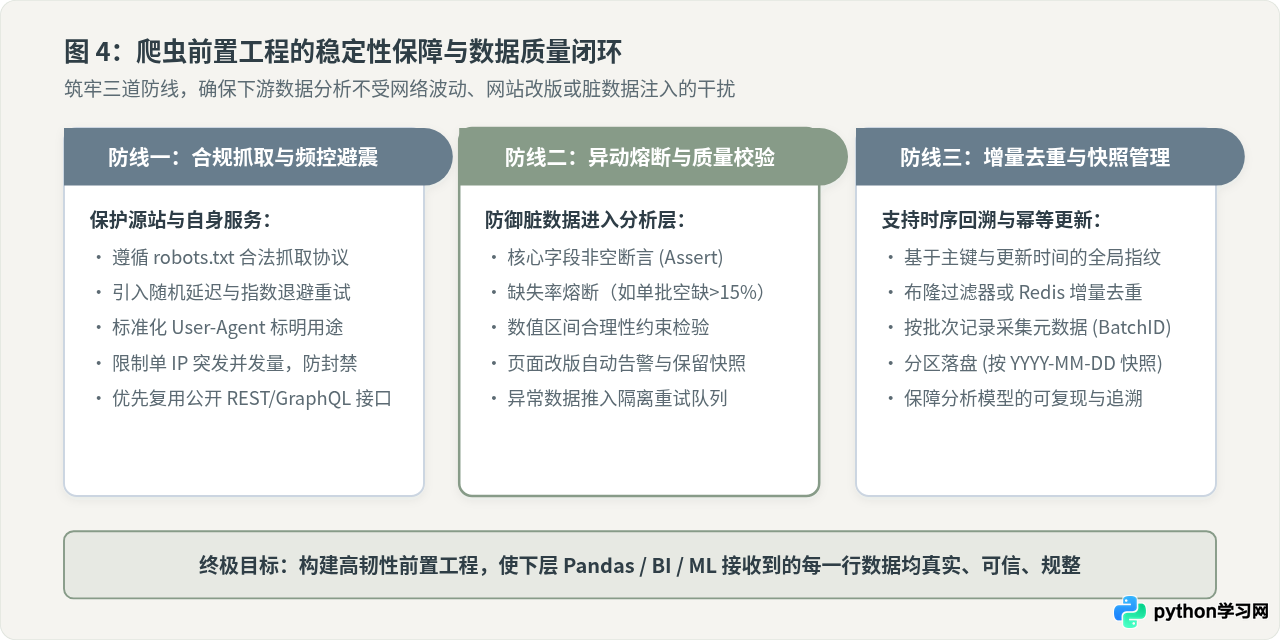
防线一:合规抓取与频率避震
任何采集任务都必须以源站的健康运行与合规边界为底线。主动遵守robots.txt协议中关于分析爬虫的路径限制,在请求头中明确标明自身标识。严禁采用高并发盲目轰炸,使用指数退避(Exponential Backoff)算法应对偶尔出现的429 Too Many Requests或503 Service Unavailable,并在请求之间注入1~3秒的泊松随机抖动。
防线二:异动熔断与非空率断言
页面改版是爬虫最常见的致错原因。若前端类名更换,原有的CSS选择器将全部返回None。如果缺乏前置拦截机制,爬虫会连续产生空行并全量写入分析库。
在批量处理流程中,必须设置结构断言。例如单批次处理100条记录后,立即对核心字段(如price、item_id)的空缺率进行断言检测:如果空缺率超过预设阈值(例如 15%),爬虫应立即触发熔断机制,停止抓取并发出告警通知,同时将异常页面的原始HTML快照归档到日志目录以便人工复查。
防线三:唯一指纹与增量快照
在进行周期性时序分析时,重复采集会导致样本权重发生严重偏移。应当在管道中以“主键ID + 标牌价格 + 状态更新时间”计算哈希值作为数据行的唯一指纹。利用内存集合或布隆过滤器(Bloom Filter)对比指纹库,仅对指纹发生变化或首次出现的记录执行下游写入,实现幂等增量采集。
六、总结
在以价值为中心的数据分析工作中,数据准备通常占据了整个分析周期的大部分精力。将Python爬虫规范化地确立为数据分析的前置步骤,其本质是把分析人员从被动筛选残缺公开数据的妥协状态,升级为“依分析假说自主按需生产数据”的工程模式。
通过在采集源头确立目标Schema、实施严格的前置防御性清洗与类型转换,并结合稳健的质量防线,分析人员能够彻底摆脱下游繁重脏乱的重复预处理工作,使数据分析从源头起步即具备高度的针对性、时效性与确定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















