


Python 3报错NameError:name 'cmp' is not defined怎么解决
详细解析Python 3中报错NameError: name 'cmp' is not defined的根本原因与全场景解决方案。包含基础比较替代公式、排序函数cmp_to_key转换、自定义类富比较重构及验证方法。
在 Python 3 中遇到
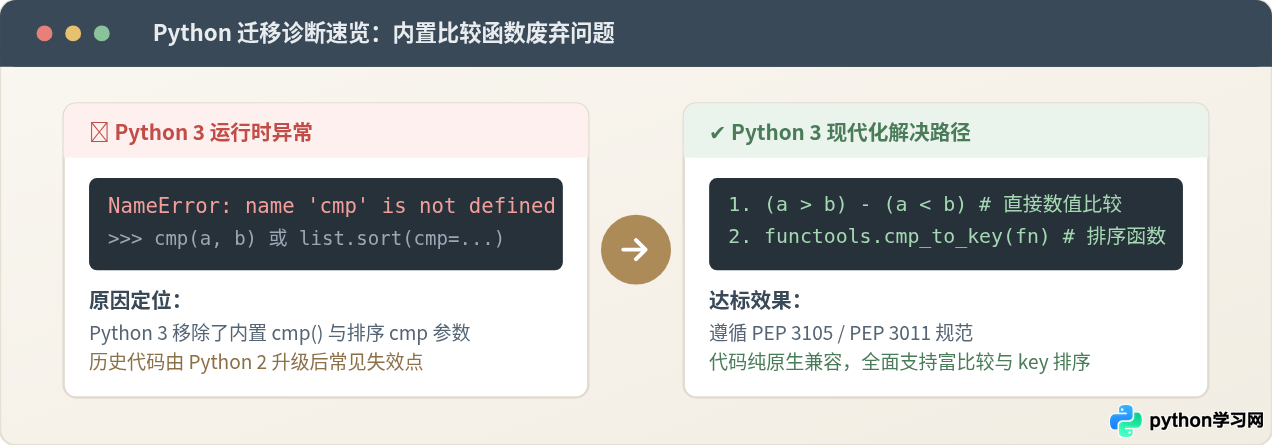
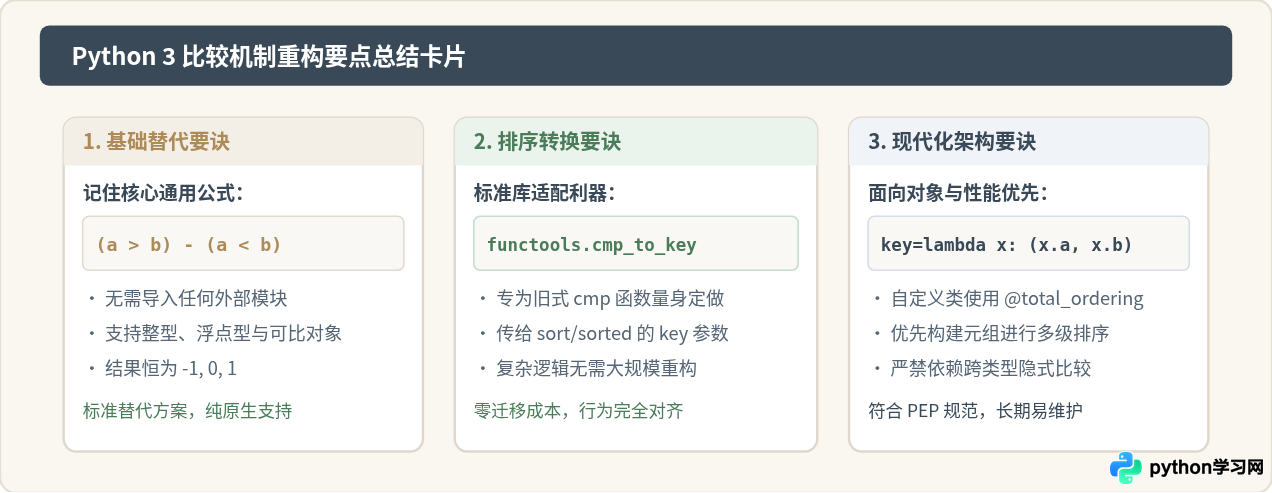
NameError: name 'cmp' is not defined,根本原因是 Python 3 彻底移除了内置的 cmp() 函数。若你需要直接比较两个对象的大小,可用通用布尔表达式 (a > b) - (a < b) 代替;若是在 sort() 或 sorted() 的排序规则中使用自定义比较函数,请引入标准库模块,使用 key=functools.cmp_to_key(your_cmp_func) 进行适配替换。
一、报错出现的直接原因与版本差异
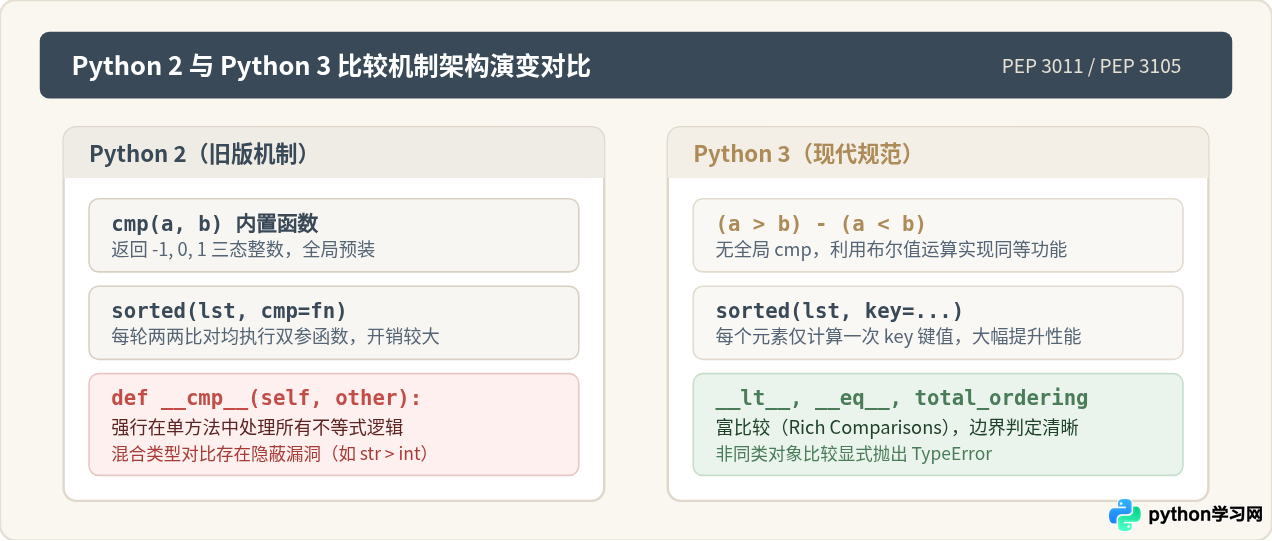
在 Python 2 中,cmp(a, b) 是一个内建的核心函数,用于比较两个对象的大小。其返回值规则非常固定:若 a < b 则返回 -1;若 a == b 则返回 0;若 a > b 则返回 1。同时,列表对象的 list.sort() 方法以及内建函数 sorted() 均支持通过 cmp= 参数接收一个双参数比较器。
进入 Python 3 之后,Python 官方设计团队根据 PEP 3105 和 PEP 3011 的规范,对语言体系中的比较机制进行了彻底精简与重构:
- 移除全局
cmp()内置函数:避免了为任意类型强行推导全序比较带来的逻辑混乱。直接调用cmp()时,Python 3 的解释器在全局命名空间中找不到该名称,便抛出NameError: name 'cmp' is not defined。 - 移除排序函数的
cmp参数:list.sort()和sorted()仅支持key和reverse参数。若强行传入cmp=...,还会抛出TypeError: 'cmp' is an invalid keyword argument for sort()。 - 弱化类内部的三方比较魔术方法:移除了自定义类中的
__cmp__方法,全面转向基于__lt__、__eq__等方法的富比较(Rich Comparisons)机制。
二、场景排查与具体解决步骤
在迁移或调试 Python 3 代码时,导致该报错的代码通常分布在三种典型场景中。请先查看异常堆栈信息(Traceback),确认报错发生在哪一行,再选择对应的修复方法。
场景一:代码中直接调用了 cmp(x, y)
如果你的代码只是需要比较两个数字、字符串或可排序对象,并期望得到 -1, 0, 1,请不要尝试在外部安装第三方包,直接使用 Python 官方推荐的布尔运算替代公式即可。
在 Python 中,bool 类型是 int 的子类,True 等于 1,False 等于 0。因此:
- 当
a > b时:(True) - (False)结果为1; - 当
a < b时:(False) - (True)结果为-1; - 当
a == b时:(False) - (False)结果为0。
# 修复方案 A-1:定义一个与 Python 2 cmp 完全等价的辅助函数
def cmp(a, b):
    return (a > b) - (a < b)

# 示例验证
print(cmp(10, 5))   # 输出示例: 1
print(cmp(5, 5))    # 输出示例: 0
print(cmp(3, 8)) # 输出示例: -1if cmp(a, b) == 1:),请直接改写为标准的 Python 3 逻辑运算 if a > b:,既提升执行速度,又更符合 Pythonic 编码风格。
场景二:列表排序或 sorted() 中使用了自定义比较函数
在 Python 2 中,复杂排序通常会编写一个接收两个入参并返回 -1, 0, 1 的比较函数,例如按字符串长度倒序排列。在 Python 3 中,直接传给 cmp= 会直接失败。
错误示范(Python 2 旧写法):
# 在 Python 3 中运行此代码将报错
def custom_cmp(x, y):
    return len(y) - len(x)

words = ["apple", "banana", "pear", "orange"]
words.sort(cmp=custom_cmp)  # 报错: TypeError 或 NameError
正确解决方式:使用 functools.cmp_to_key
Python 3 在标准库 functools 中专门提供了 cmp_to_key 适配函数,它可以将旧式的双参数比较函数无缝转换为现代 key= 所需的键提取器,无需重写复杂的比较规则。
import functools

# 原有比较函数逻辑保持完全不变
def custom_cmp(x, y):
    return (len(y) > len(x)) - (len(y) < len(x))

words = ["apple", "banana", "pear", "orange"]

# 修复:将比较函数包装后传递给 key 参数
words.sort(key=functools.cmp_to_key(custom_cmp))

print(words)
# 输出示例: ['banana', 'orange', 'apple', 'pear']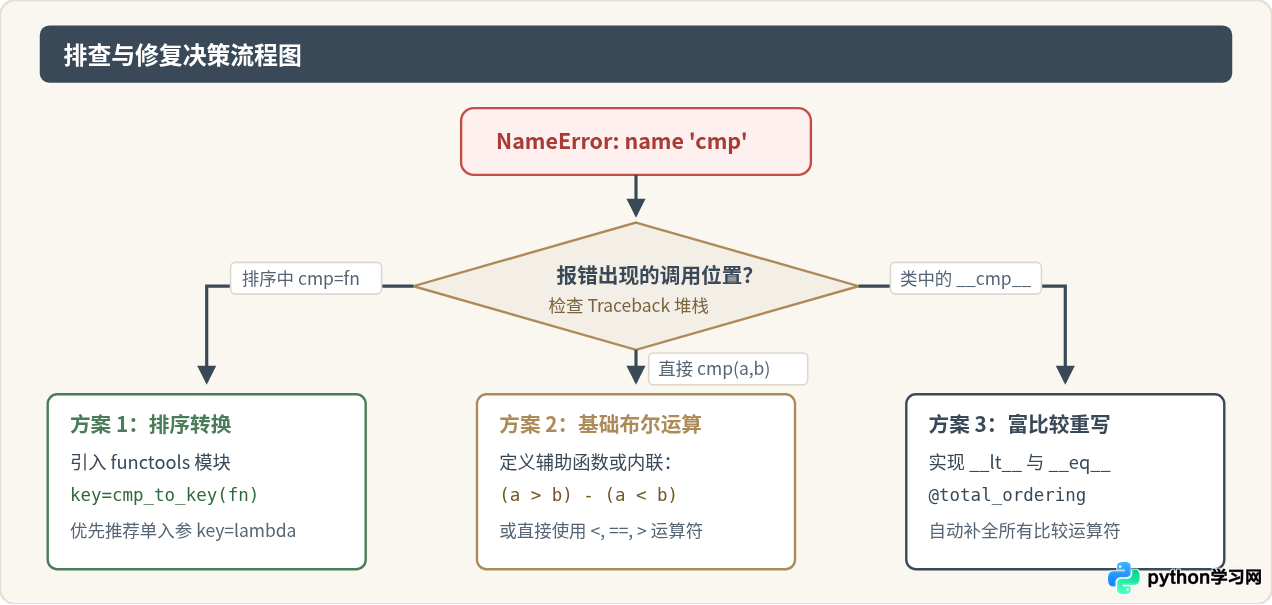
场景三:自定义类中依然残留 __cmp__ 方法
在 Python 2 中,如果你想让自定义类的实例支持 >、< 比较或排序,通常只需要重写 __cmp__:
# Python 2 旧式类写法(在 Python 3 中无效)
class Student(object):
    def __init__(self, name, score):
        self.name = name
        self.score = score

    def __cmp__(self, other):
        return cmp(self.score, other.score)
在 Python 3 中,解释器在执行 s1 < s2 时根本不会查找 __cmp__,而是查找 __lt__。如果类中只有 __cmp__,既会因内部调用未定义的 cmp() 抛出 NameError,也会在比较对象时因缺少运算符重载抛出 TypeError: '<' not supported between instances of 'Student' and 'Student'。
Python 3 正确重构方案:使用 functools.total_ordering 装饰器,只需编写 __eq__ 和 __lt__(小于)两个方法,装饰器会自动补齐 <=、>、>= 的逻辑。
from functools import total_ordering

@total_ordering
class Student:
    def __init__(self, name, score):
        self.name = name
        self.score = score

    def __eq__(self, other):
        if not isinstance(other, Student):
            return NotImplemented
        return self.score == other.score

    def __lt__(self, other):
        if not isinstance(other, Student):
            return NotImplemented
        return self.score < other.score

# 验证测试
s1 = Student("Alice", 92)
s2 = Student("Bob", 85)

print(s1 > s2)   # 输出示例: True
print(s1 <= s2)  # 输出示例: False
students = [s1, s2]
students.sort()
print([s.name for s in students]) # 输出示例: ['Bob', 'Alice']三、核心技术细节:cmp_to_key 的运作机制
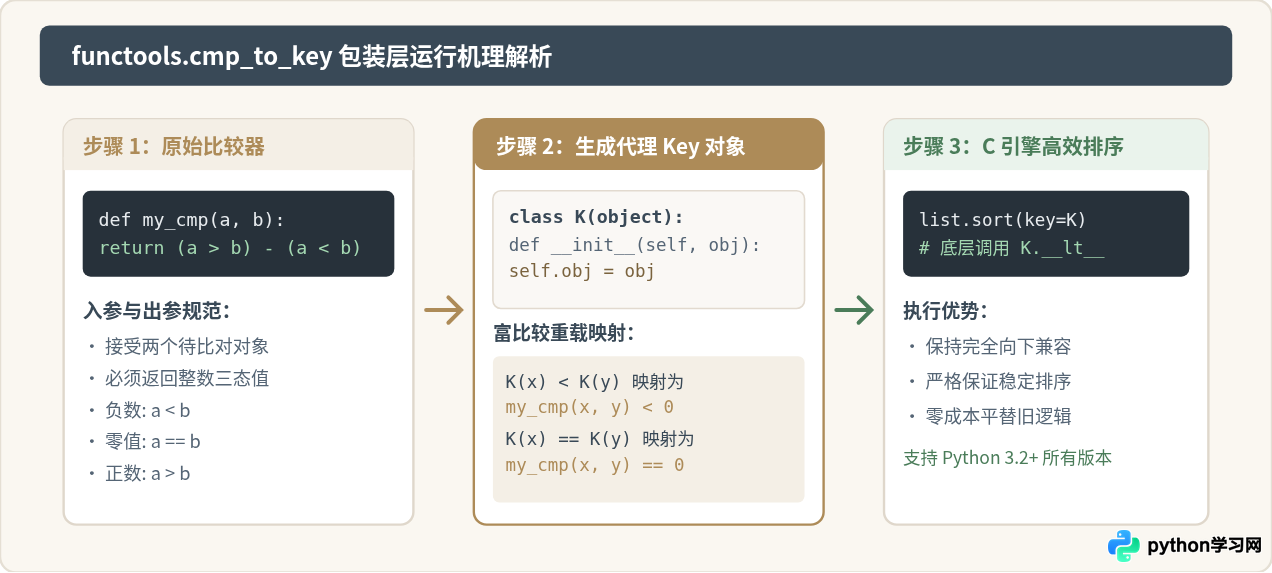
为什么 Python 3 要全面抛弃 cmp 并推崇 key?理解这一底层设计原理有助于写出更高性能的 Python 代码。
在旧版 Python 2 的 cmp 模式下,排序算法(Timsort)在每次需要比较列表中两个元素的大小时,都会调用一次传入的 cmp(a, b) 函数。如果列表有 $N$ 个元素,整个排序过程最少需要调用约 $O(N \log N)$ 次比较函数。若比较函数内部有复杂的计算,这些开销会被反复放大。
而在 Python 3 的 key 模式下:
- 键值缓存(Key Extraction):排序启动前,列表中的每个元素只调用一次
key(item)函数,提取出一个代理比较键(Key)。这只需花费 $N$ 次运算。 - 底阶快速比对:获取到键后,后续所有排序比较均在 C 语言底层的内置类型之间直接进行,不再频繁进入 Python 解释器的函数栈。
四、结果验证与常见陷阱提示
完成代码修改后,请使用以下检查项与测试脚本验证修复结果,确保业务逻辑未发生偏离。
1. 综合验证测试脚本
新建或在终端中运行以下脚本,测试基础比较、自定义排序以及边界情况:
import functools

# 1. 验证基础 cmp 替代函数
cmp = lambda a, b: (a > b) - (a < b)
assert cmp(10, 20) == -1
assert cmp(20, 20) == 0
assert cmp(30, 20) == 1

# 2. 验证多条件倒序排序
def compare_items(item1, item2):
    # 先按优先级倒序,优先级相同时按名称正序
    if item1["priority"] != item2["priority"]:
        return item2["priority"] - item1["priority"]
    return (item1["name"] > item2["name"]) - (item1["name"] < item2["name"])

tasks = [
    {"name": "TaskB", "priority": 1},
    {"name": "TaskA", "priority": 2},
    {"name": "TaskC", "priority": 2},
]

sorted_tasks = sorted(tasks, key=functools.cmp_to_key(compare_items))
print("排序结果:", [t["name"] for t in sorted_tasks])
# 输出示例: 排序结果: ['TaskA', 'TaskC', 'TaskB']
print("验证通过:所有比较与排序逻辑正常运行!")
2. 避坑指南
在 Python 2 中,
cmp(100, "abc") 不会报错,它会根据类型名称的字符串顺序给出一个确定的判定;而在 Python 3 中,不同非数值类型之间使用 >、< 会直接抛出 TypeError。如果你的旧代码依赖了这种跨类型的宽松比较,必须先手动完成类型清洗或对键进行显式类型转换。
虽然
cmp_to_key 可以快速兼容旧代码,但直接提供单参数 key=lambda x: ... 或使用 operator.itemgetter / operator.attrgetter 在性能和可读性上都显著优于 cmp_to_key。只有当比较规则涉及不可解耦的两个元素相对状态时,才必须使用 cmp_to_key。
五、代码模式转换速查表
下表归纳了由 Python 2 升级至 Python 3 时,与 cmp 相关的经典代码模式转换方式:
| 场景需求 | Python 2 代码写法(已失效) | Python 3 推荐修复写法 |
|---|---|---|
| 两值比较 | res = cmp(a, b) |
res = (a > b) - (a < b) |
| 列表逆序排序 | lst.sort(cmp=lambda x,y: y-x) |
lst.sort(reverse=True) |
| 复杂规则排序 | sorted(lst, cmp=my_cmp) |
sorted(lst, key=functools.cmp_to_key(my_cmp)) |
| 单字段排序 | lst.sort(cmp=lambda a,b: cmp(a.age, b.age)) |
lst.sort(key=lambda x: x.age) |
| 类支持排序 | 类中定义 __cmp__(self, other) |
使用 @total_ordering 并实现 __lt__、__eq__ |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















