


Python正则表达式re模块代码举例
深入解析Python内置re模块的核心用法,提供详尽的代码举例,涵盖re.search、re.match、re.findall、re.sub等常用函数、分组捕获机制、性能优化与常见陷阱规避。
re 模块为处理文本检索、模式校验、批量提取与字符串替换提供了标准实现,无需安装任何第三方库。在日常开发中,处理字符串往往涉及不同的边界条件与性能考量:例如从日志中搜寻关键字、批量抓取结构化标签、格式校验或敏感信息脱敏。本文围绕 re 模块的核心 API,结合规范且完整的代码示例逐一演示调用方法、返回值处理与边界区别,帮助读者清晰理解其实际用法。
一、re 模块的标准调用模式与预编译
在 Python 中编写正则表达式时,强烈建议在声明规则字符串时始终使用原生字符串(Raw String,即前缀 r"...")。这能够防止 Python 的字符串转义语法(如
、 )与正则表达式的元字符转义(如 \d、\w、\)发生混淆与二次转义。
re 模块提供两种执行策略:直接调用模块级函数(如 re.search()),或使用 re.compile() 先将正则表达式编译为 Pattern 对象后再执行检索。当同一个正则表达式需要在循环或多次函数调用中重复使用时,预编译能够避免重复解析正则语法树,从而显著提升执行效率。
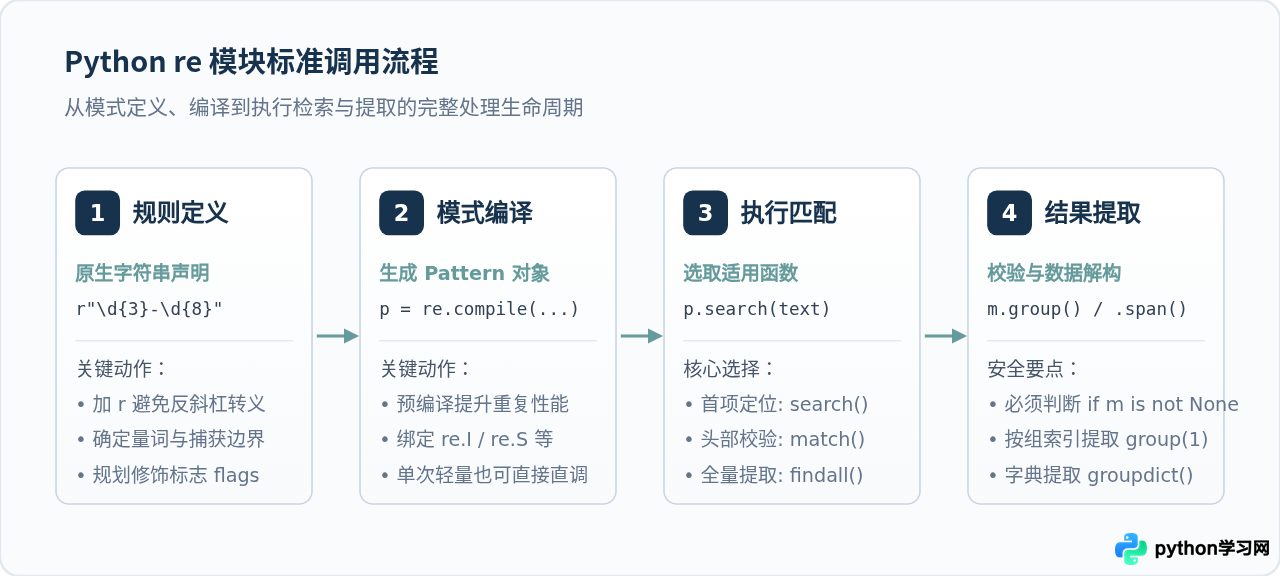
代码举例:预编译与模块函数直接调用对比
import re

text = "订单编号:ORD20261031-8848,创建时间:2026-10-31"

# 方式一:使用 re.compile 预编译模式(推荐重复使用场景)
order_pattern = re.compile(r"ORD\d{8}-\d{4}")
match_compiled = order_pattern.search(text)

if match_compiled:
    print("方式一提取成功:", match_compiled.group())

# 方式二:直接调用模块级函数(适合单次轻量处理)
match_direct = re.search(r"ORD\d{8}-\d{4}", text)

if match_direct:
    print("方式二提取成功:", match_direct.group())
方式二提取成功: ORD20261031-8848
二、核心单次检索函数:search()、match() 与 fullmatch()
初学者容易混淆 search()、match() 与 fullmatch() 的作用范围。它们都返回一个 re.Match 对象(未匹配时返回 None),但匹配的起始与覆盖范围截然不同:
- re.search(pattern, string):扫描整个字符串,直到找到第一个符合规则的子串。即使目标不在字符串开头,也能正常捕获。
- re.match(pattern, string):严格仅从字符串的第一个字符(索引 0)开始比对。若起始字符不吻合,即刻判定匹配失败并返回
None。 - re.fullmatch(pattern, string):要求整个输入字符串必须从头到尾与正则表达式完全一致,多余的任何前缀或后缀都会导致匹配失败,常用于表单数据严格校验。
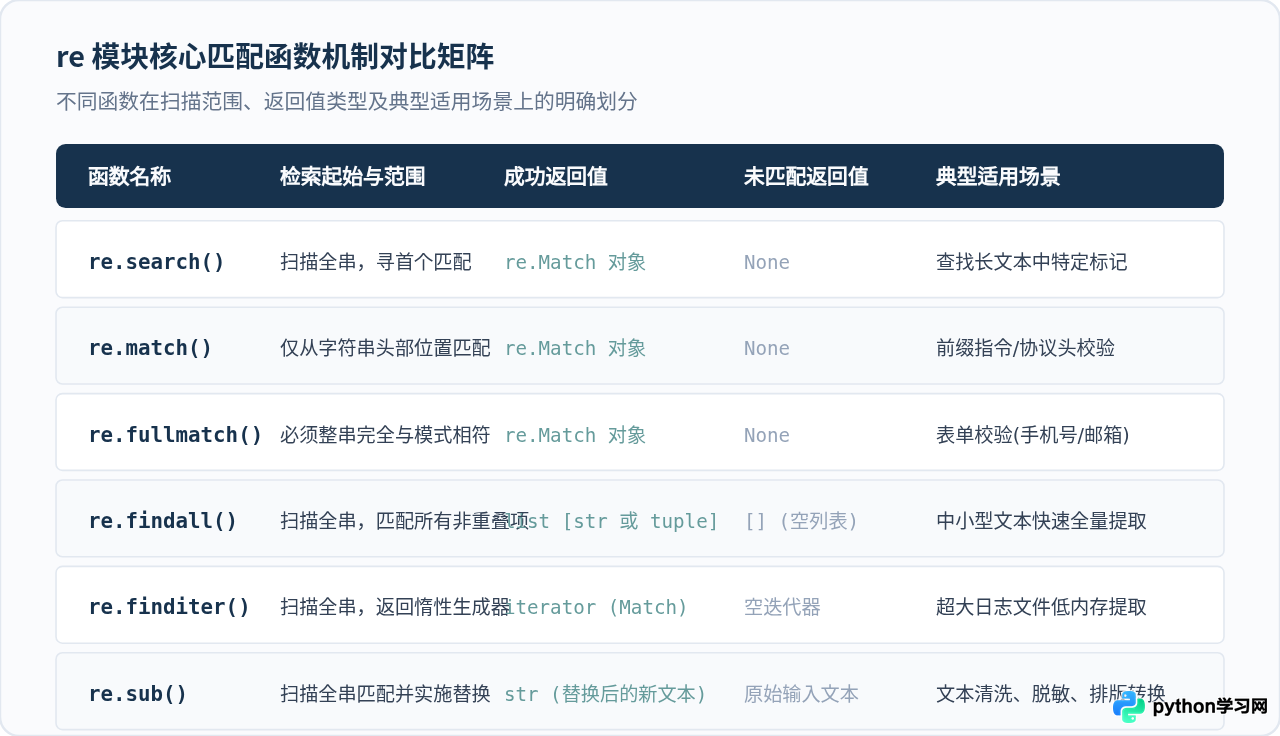
代码举例:三种检索函数的边界表现差异
import re

log_line = "2026-10-31 [ERROR] Database connection timed out."

# 1. re.search() 可以在任意位置捕获错误级别
res_search = re.search(r"\[(ERROR|WARNING|INFO)\]", log_line)
if res_search:
    print("search 捕获内容:", res_search.group(0))
    print("search 匹配跨度:", res_search.span())

# 2. re.match() 尝试匹配非首部的错误标签(必然失败返回 None)
res_match_fail = re.match(r"\[(ERROR|WARNING|INFO)\]", log_line)
print("match 检索非开头内容结果:", res_match_fail)

# 3. re.match() 匹配开头日期内容(匹配成功)
res_match_ok = re.match(r"\d{4}-\d{2}-\d{2}", log_line)
if res_match_ok:
    print("match 检索头部内容:", res_match_ok.group(0))

# 4. re.fullmatch() 严格校验手机号格式
phone_candidate = "13800138000"
is_valid_phone = re.fullmatch(r"1[3-9]\d{9}", phone_candidate)
print("标准手机号校验结果:", bool(is_valid_phone))

invalid_phone = "13800138000_extra"
print("附带额外字符校验:", bool(re.fullmatch(r"1[3-9]\d{9}", invalid_phone)))
search 匹配跨度: (11, 18)
match 检索非开头内容结果: None
match 检索头部内容: 2026-10-31
标准手机号校验结果: True
附带额外字符校验: False
三、全量检索与迭代:findall() 与 finditer()
当目标文本中存在多个符合规则的子串时,单次检索函数只能捕获第一项。此时可以使用 findall() 或 finditer()。
1. re.findall() 的返回结构特性
re.findall() 会一次性扫描整个字符串,并将所有非重叠的匹配内容作为 list 返回。若未找到匹配项则返回空列表 []。需要特别注意:
- 如果正则表达式中没有括号捕获组,返回的是匹配字符串列表:
['str1', 'str2', ...]。 - 如果包含一个捕获组,返回的是该组捕获的内容列表。
- 如果包含多个捕获组,返回的列表元素将变成元组:
[('group1', 'group2'), ...]。
2. re.finditer() 的流式遍历优势
当处理大规模日志文本或需要获取每个匹配项的具体字符起止下标(span)时,推荐使用 re.finditer()。它返回一个生成器,逐个产出 Match 对象,内存占用极低且保留了完整的对象方法。
代码举例:批量提取 IP 地址与服务器端口
import re

raw_cluster_info = """
MasterNode: 192.168.1.10:8080 active
WorkerNode1: 192.168.1.11:9092 active
WorkerNode2: 192.168.1.12:9092 offline
"""

# 使用 findall 提取所有完整 IP(无捕获分组)
ip_pattern = r"\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3}"
all_ips = re.findall(ip_pattern, raw_cluster_info)
print("提取到的全部 IP:", all_ips)

# 使用 finditer 遍历并提取详细位置与分组
node_pattern = re.compile(r"(?P<ip>\d{1,3}(?:\.\d{1,3}){3}):(?P<port>\d+)")
print("
使用 finditer 逐项迭代:")
for match in node_pattern.finditer(raw_cluster_info):
    node_ip = match.group("ip")
    node_port = match.group("port")
    start_pos, end_pos = match.span()
    print(f"- 发现节点:{node_ip} 端口:{node_port} 位置范围:[{start_pos}, {end_pos}]")
使用 finditer 逐项迭代:
- 发现节点:192.168.1.10 端口:8080 位置范围:[13, 31]
- 发现节点:192.168.1.11 端口:9092 位置范围:[52, 70]
- 发现节点:192.168.1.12 端口:9092 位置范围:[91, 109]
四、分组捕获与结构化解析
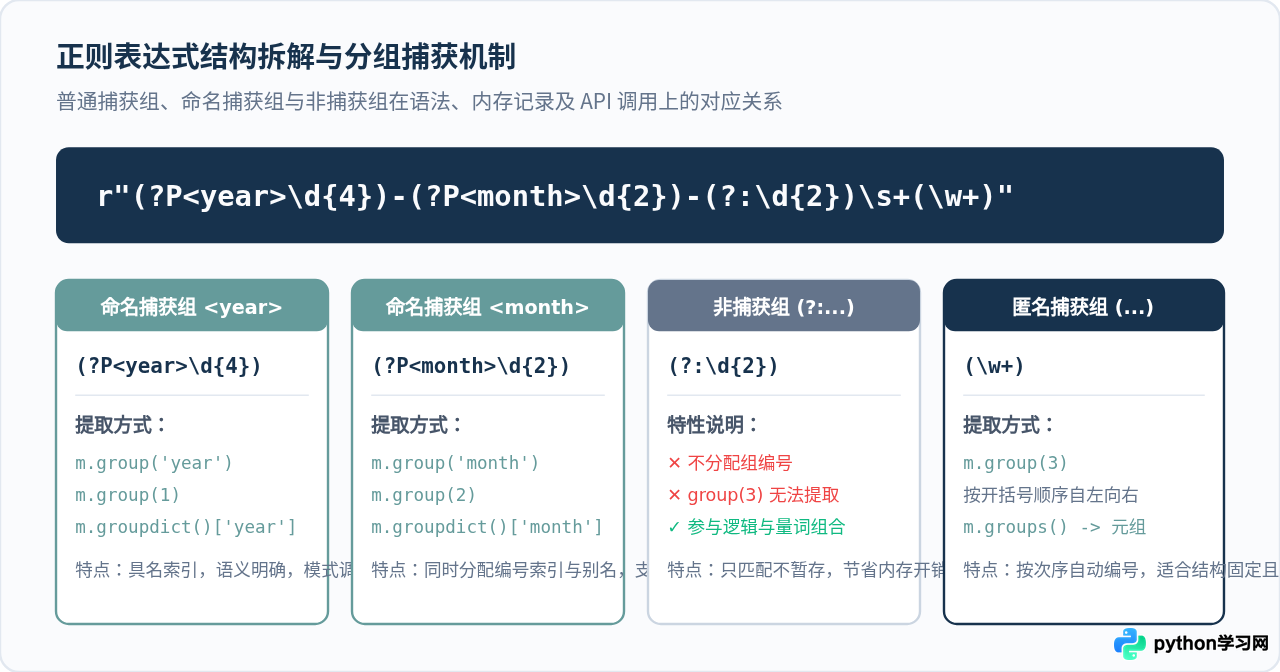
圆括号 (...) 在正则表达式中具有双重功能:改变运算优先级,以及将匹配到的子表达式进行分组捕获。Python 的 re 模块支持普通编号捕获组、命名捕获组以及非捕获组。
- 编号捕获组
(...):按照左括号出现的顺序,从 1 开始编号。m.group(0)表示整个匹配串,m.group(1)对应第一个括号。 - 命名捕获组
(?P<name>...):为捕获组赋予语义化名称。使用m.group('name')或直接调用m.groupdict()返回键值字典,极大提高代码可读性与健壮性。 - 非捕获组
(?:...):仅用于逻辑组合(如分支或附加量词),不保存匹配结果,不分配组编号,能减少引擎开销并避免干扰编号序列。
代码举例:解析结构化日志并转为字典
import re

log_record = "2026-10-31 09:30:15 [SERVICE_AUTH] User 'admin' logged in from 10.0.0.8"

# 使用命名捕获组与非捕获组定义解析规则
pattern = re.compile(
    r"^(?P<timestamp>\d{4}-\d{2}-\d{2}\s+\d{2}:\d{2}:\d{2})\s+"
    r"\[(?P<service>[A-Z_]+)\]\s+"
    r"User\s+'(?P<username>\w+)'\s+"
    r"(?:logged in from)\s+"  # 非捕获组,仅用于文本结构匹配
    r"(?P<ip>\d{1,3}(?:\.\d{1,3}){3})"
)

m = pattern.search(log_record)
if m:
    # 直接导出为结构化字典
    record_dict = m.groupdict()
    print("结构化解析结果:")
    for key, val in record_dict.items():
        print(f"  {key}: {val}")

    # 也可以按组名单独提取
    print("操作用户:", m.group("username"))
timestamp: 2026-10-31 09:30:15
service: SERVICE_AUTH
username: admin
ip: 10.0.0.8
操作用户: admin
五、文本替换与规则分割:sub() 与 split()
除了检索提取外,字符串清洗与替换也是 re 模块的核心应用场景。
1. re.sub() 替换与反向引用
re.sub(pattern, repl, string, count=0) 能够替换匹配项。repl 可以是普通字符串、带有反向引用的模板字符串(使用 或 \g<name>),甚至可以是一个回调函数,实现动态数值转换或脱敏计算。
2. re.split() 高级分割
Python 原生的 str.split() 只能按单一固定字符切分。当遇到多个连续空格、制表符、分号混杂的输入时,使用 re.split(r"[;\s,]+", text) 能干净利接地完成切分并过滤杂质。
代码举例:手机号掩码脱敏与动态价格换算
import re

# 1. 基础反向引用:手机号中间 4 位脱敏
phone_text = "用户 A: 13912345678, 用户 B: 18887654321"
masked_text = re.sub(r"(\d{3})\d{4}(\d{4})", r"****", phone_text)
print("脱敏后电话:", masked_text)

# 2. 回调函数动态替换:美元价格统一转换为人民币(汇率按 7.2)
price_data = "Item 1: $10.00, Item 2: $25.50, Item 3: $100.00"

def usd_to_cny(match_obj):
    usd_val = float(match_obj.group(1))
    cny_val = usd_val * 7.2
    return f"¥{cny_val:.2f}"

converted_prices = re.sub(r"\$(\d+(?:\.\d{2})?)", usd_to_cny, price_data)
print("汇率换算后:", converted_prices)

# 3. 多重分隔符分割
messy_input = "Python,  Java; C++ ;  Go,Rust"
clean_tags = re.split(r"[,;\s]+", messy_input.strip())
print("清洗分割后列表:", clean_tags)
汇率换算后: Item 1: ¥72.00, Item 2: ¥183.60, Item 3: ¥720.00
清洗分割后列表: ['Python', 'Java', 'C++', 'Go', 'Rust']
六、常用修饰符(Flags)与高频避坑清单
修饰符用于改变底层正则引擎的匹配策略,常用标志包括:
re.IGNORECASE(简写re.I):忽略英文字母大小写。re.DOTALL(简写re.S):使点号.能够匹配包括换行符re.MULTILINE(简写re.M):多行模式,使^和$能分别匹配每一行的开头和结尾,而非仅仅整段字符串的头部和尾部。
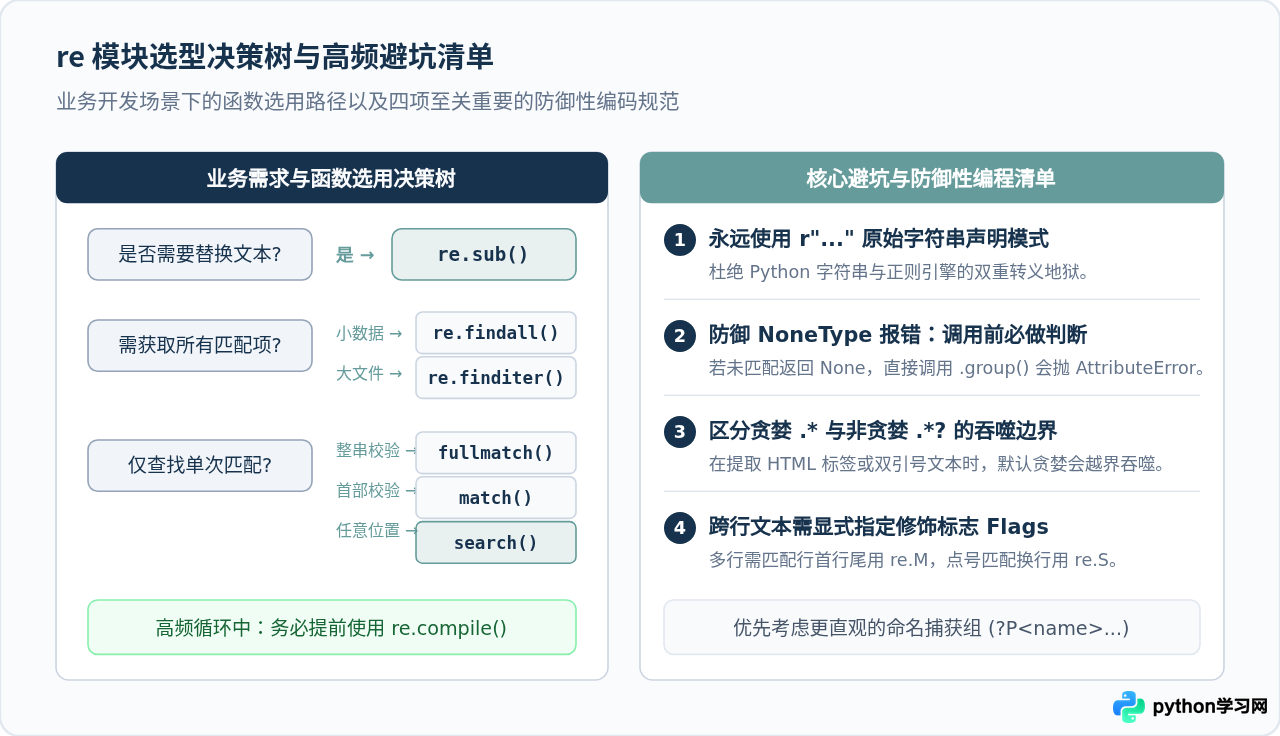
默认情况下,量词 *、+、?、{m,n} 都是贪婪的,它们会尽可能多地吞噬字符。例如对于字符串 <div>Hello</div><div>World</div>,如果使用模式 <div>.*</div>,它会从第一个 <div> 一路吞噬到最后一个 </div>。
若需要按最小边界匹配每个标签,必须在量词后加上 ? 声明为非贪婪匹配:<div>.*?</div>。
代码举例:修饰符与贪婪模式对比
import re

html_doc = """<div>段落一</div><div>段落二</div>"""

# 贪婪模式 vs 非贪婪模式
greedy_result = re.findall(r"<div>.*</div>", html_doc)
nongreedy_result = re.findall(r"<div>.*?</div>", html_doc)

print("贪婪模式提取结果(合并为一项):", greedy_result)
print("非贪婪模式提取结果(独立两项):", nongreedy_result)

# 跨行文本匹配(re.S 与 re.I 联合使用)
multiline_text = "STATUS:
SUCCESS"
# 默认点号无法匹配换行符
print("未加 re.S 结果:", re.search(r"STATUS:.*SUCCESS", multiline_text))
# 加上 re.S (DOTALL) 与 re.I
m_flags = re.search(r"status:.*success", multiline_text, re.IGNORECASE | re.DOTALL)
if m_flags:
    print("联合 Flags 匹配成功:", repr(m_flags.group(0)))
非贪婪模式提取结果(独立两项): ['<div>段落一</div>', '<div>段落二</div>']
未加 re.S 结果: None
联合 Flags 匹配成功: 'STATUS:\nSUCCESS'
七、总结
Python re 模块功能全面,使用时只需建立起清晰的选用路径:单次检索优先考虑 re.search()(任意位置)或 re.fullmatch()(严格格式校验);全量匹配在中小型文本下使用 re.findall() 快速获取列表,在大文本或需要位置信息时使用 re.finditer();文本修改借助 re.sub() 与回调函数完成复杂逻辑转换。配合原生字符串 r"" 与防御性的 if match: 检查,即可高效、安全地完成各种正则表达式处理任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















