


Python函数怎么定义和调用?参数传递机制解析
深入解析Python函数的定义与调用方式,系统剖析Python独特的对象引用传递(Call by Object Reference)机制,通过内存模型与完整代码对比不可变对象与可变对象的传参差异及避坑指南。
一、Python 函数的定义与调用语法
函数是将具有独立功能的代码块组织在一起、以便多次重复调用的程序结构。Python 使用清晰简洁的语法支持函数的定义与调用。
1. 定义函数:def 关键字与基本结构
定义函数必须以 def 开头,后跟函数名称、圆括号(括号内声明形参列表)以及必不可少的英文冒号 :。函数体内的代码必须统一缩进(通常为4个空格)。如果需要向调用者反馈计算结果,使用 return 语句;若省略 return,函数执行完毕后会默认隐式返回 None。
# 函数定义示例
def calculate_rectangle_area(width, height):
    """计算并返回矩形的面积(文档字符串 docstring)"""
    if width <= 0 or height <= 0:
        return 0.0
    area = width * height
    return area
2. 调用函数与生命周期执行过程
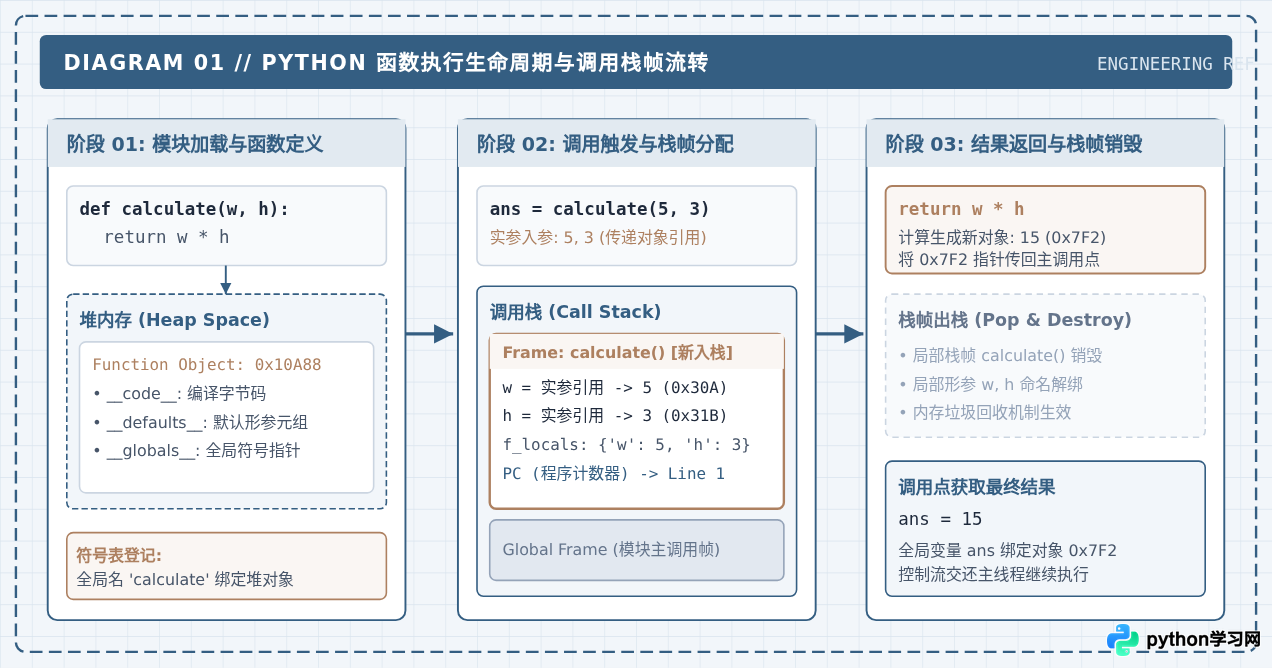
调用函数只需书写函数名并在括号中传入实参:calculate_rectangle_area(5.0, 3.0)。当 Python 解释器执行到调用语句时,其底层执行经历三个核心阶段:
- 分配栈帧(Call Stack Frame):解释器在调用栈上为当前函数创建专有的局部帧,保存局部变量和形参指针。
- 形参与实参绑定:实参对象的内存引用按规则赋给对应的形参名。
- 执行与退栈销毁:顺序执行函数体,遇到
return将结果对象返回给调用处,随后销毁该局部栈帧,释放其局部变量名字绑定。
二、函数参数的多样化形态与调用规范
在 Python 中,函数的形参与实参拥有高度灵活的语法机制。理解各类参数的接收方式,是编写健壮、可维护代码的前提。
1. 位置参数与关键字参数
位置参数(Positional Arguments):调用时实参与形参按照从左到右的位置严格一一对应。顺序错误会导致逻辑混乱甚至类型报错。
关键字参数(Keyword Arguments):调用时以 参数名=值 的形式传参。此时实参的传递顺序不再重要,大幅提升了代码的可读性。
def connect_server(host, port, timeout):
    return f"连接至 {host}:{port},超时设为 {timeout}s"

# 位置参数调用(顺序必须匹配:host, port, timeout)
connect_server("127.0.0.1", 8080, 30)

# 关键字参数调用(顺序可任意颠倒,明确意图)
connect_server(timeout=10, host="api.example.com", port=443)
2. 默认参数(Default Arguments)
在定义函数时,可以直接为形参赋予一个默认值。调用时如果省略该参数,函数自动使用预设的默认值;如果传入实参,则覆盖默认值。注意:在参数列表中,没有默认值的参数必须排在有默认值参数的前面。
# 正确:无默认值在前,有默认值在后
def create_user(username, role="standard", is_active=True):
    return {"user": username, "role": role, "active": is_active}
3. 可变参数:*args 与 **kwargs
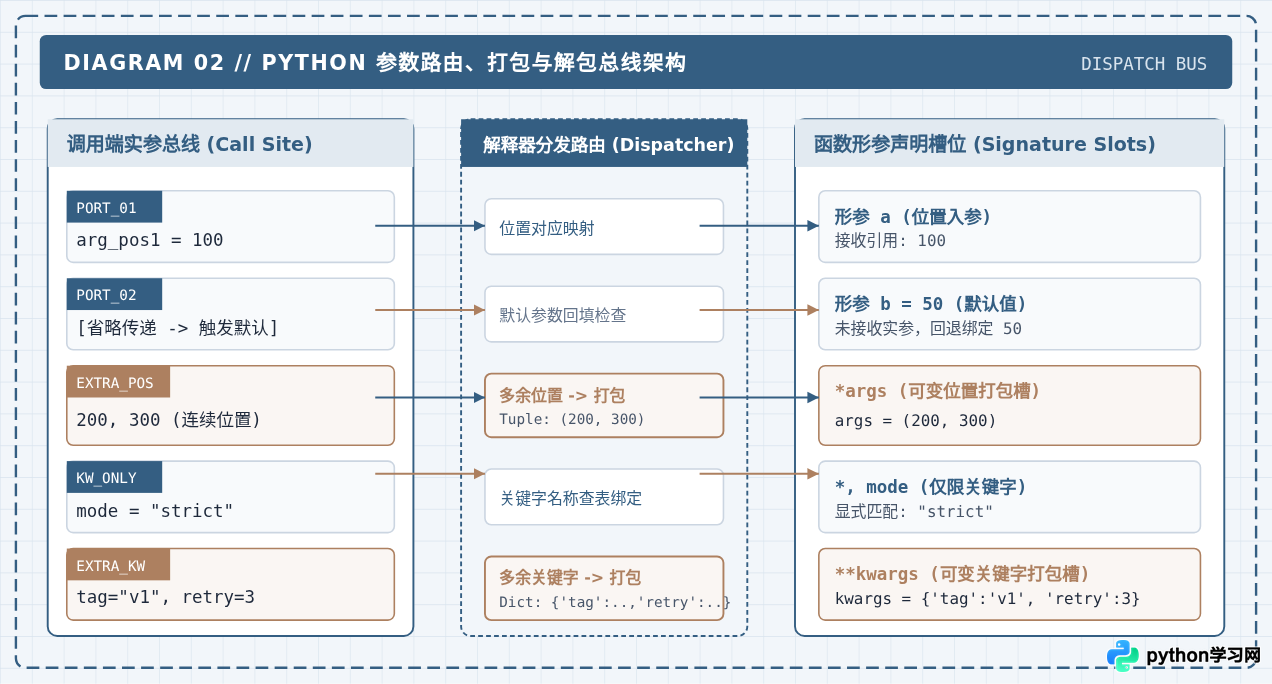
当预先无法确定调用者会传入多少个参数时,可使用包裹传参:
*args(可变位置参数):将调用时传入的多余位置参数自动打包为一个元组(tuple)。**kwargs(可变关键字参数):将调用时传入的多余关键字参数自动打包为一个字典(dict)。
4. 进阶边界:仅限位置参数(/)与仅限关键字参数(*)
Python 3.8+ 提供了参数边界修饰符:斜杠 / 之前的参数必须通过位置传递;星号 * 之后的参数必须通过关键字传递。这在接口库设计中能有效防止调用方硬编码参数名或传错位置。
| 参数定义形态 | 声明示例 | 调用传参限制 | 主要工程应用场景 |
|---|---|---|---|
| 位置参数 | def f(a, b): |
按位置依次填入,亦可用关键字 | 基础核心入参,顺序具备自解释性 |
| 默认参数 | def f(a, timeout=5): |
可省略;提供则覆盖默认值 | 常见配置项,减少常规调用冗余 |
| 可变位置 (*args) | def f(a, *args): |
接收任意数量多余的位置实参 | 数学统计(如 sum(1,2,3))、装饰器中转 |
| 仅限关键字 (KW-Only) | def f(a, *, mode="sync"): |
mode 必须以关键字形式显式传入 |
防止误传同类型的布尔值或关键配置 |
| 可变关键字 (**kwargs) | def f(a, **kwargs): |
接收任意多余的 k=v 参数 |
灵活配置扩展、透传到底层 API |
三、核心机制:参数传递的底层本质(对象引用传递)
理解 Python 的参数传递,必须先建立 Python 的核心内存概念:“一切皆对象,变量只是贴在对象上的名字标签(Name Binding)。”
许多编程语言有“值传递”(复制整个数据值)与“引用传递”(传递变量自身的物理地址指针)。而 Python 属于对象引用传递(Call by Object Reference / Call by Sharing)。当调用 func(arg) 时,Python 将实参所指向的对象的内存引用(地址指针)复制给形参。因此在函数刚进入时,形参与实参指向内存中完全相同的同一个对象。
随后函数内部的修改是否会影响外部,完全取决于该对象自身是否可变(Mutable vs Immutable),以及函数内部采用的是“重新赋值”还是“就地修改(In-place Mutation)”。
1. 不可变对象作为参数(int, str, float, tuple)
不可变对象在创建后,其内存中的值便不可变更。如果函数内部试图修改形参(如 x = x + 1 或 s = s + "tail"),Python 无法在原内存地址上修改对象,而是新建一个对象并将局部变量 x 重新绑定到新对象。此时外部的原始变量依然绑定在旧对象上,因此外部变量的值绝对不会被修改。
def modify_number(x):
    print(f"函数内部初始 x 的 id: {id(x)}")
    x = x + 10  # 重新赋值:开辟新对象,x 指向新地址
    print(f"重新赋值后 x 的 id: {id(x)},x 的值: {x}")

val = 100
print(f"调用前外部 val 的 id: {id(val)}")
modify_number(val)
print(f"调用后外部 val 的值: {val}")

# 运行结果说明:
# 调用前外部 val 的 id 与函数内部初始 x 的 id 完全一致(指向同一对象 100)
# x = x + 10 后,x 的 id 发生改变(指向新对象 110)
# 调用后外部 val 的值依然是 100,丝毫不受影响
2. 可变对象作为参数(list, dict, set)
可变对象支持在原内存地址上直接修改内容(就地修改)。当传入一个列表并在函数内调用 .append()、.extend() 或修改字典键值时,操作的是形参和实参共同引用的那块堆内存。因此,外部实参会同步反映出修改结果。
注意区分“就地修改”与“重新赋值”:如果函数内写的是 lst = [1, 2, 3],这是重新赋值操作,会使局部变量 lst 脱离原引用并绑定到新列表,此时外部实参不会受到影响。
def operate_list(in_place_demo, reassign_demo):
    # 1. 就地修改:直接在原对象堆内存追加元素
    in_place_demo.append("NEW_ITEM")

    # 2. 重新赋值:形参绑定到全新列表,切断了与外部的联系
    reassign_demo = ["COMPLETELY", "NEW"]

list_a = [1, 2]
list_b = ["A", "B"]

operate_list(list_a, list_b)
print(f"list_a 结果: {list_a}")  # 输出: [1, 2, 'NEW_ITEM'] -> 受就地修改影响!
print(f"list_b 结果: {list_b}")  # 输出: ['A', 'B'] -> 重新赋值未破坏原对象!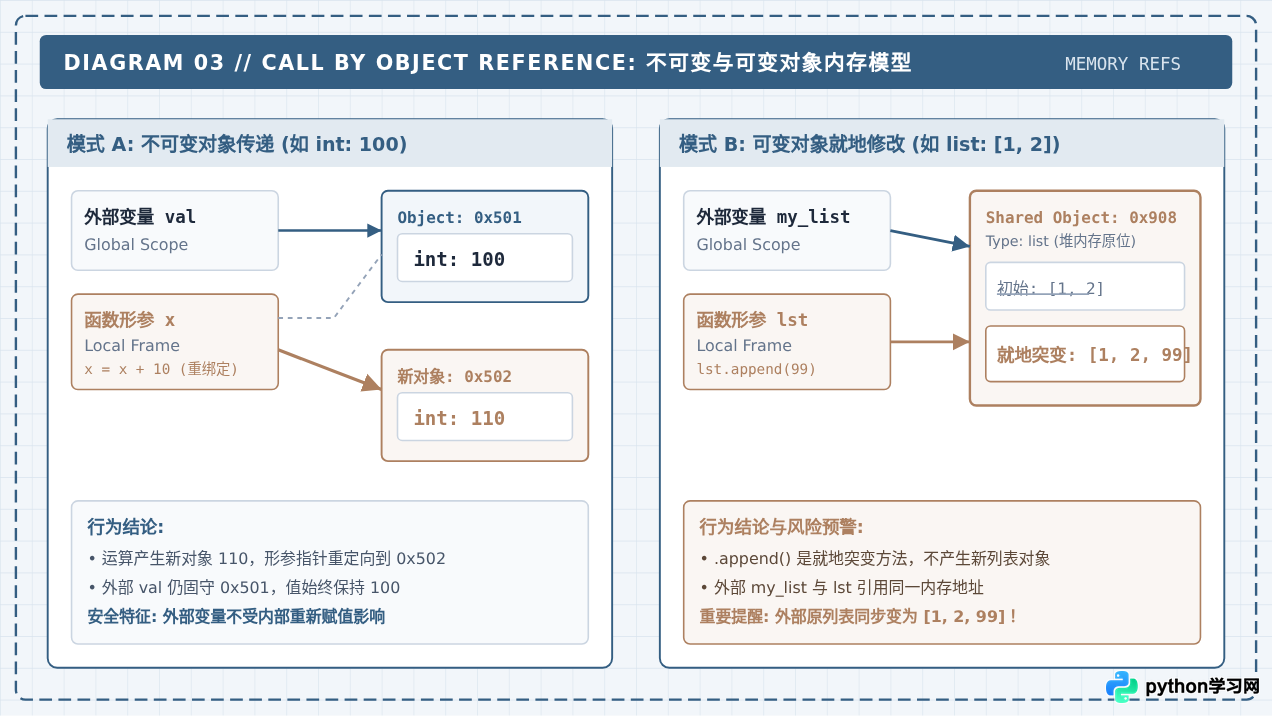
四、经典避坑:可变对象作为默认参数的陷阱与标准解法
在掌握了对象引用传递后,就能够轻松理解 Python 中最臭名昭著的经典陷阱——将空列表 [] 或空字典 {} 作为默认参数。
1. 陷阱现象:多次调用间的数据污染
观察以下常见初学者代码,本意是“如果不传列表,就自动新建一个空列表并添加元素”:
# 错误示范:默认参数使用了可变对象 list
def add_log(message, log_list=[]):
    log_list.append(message)
    return log_list

print(add_log("任务 A 启动"))  # 输出: ['任务 A 启动'],看似正常
print(add_log("任务 B 启动"))  # 意料之外输出: ['任务 A 启动', '任务 B 启动']!
print(add_log("任务 C 启动"))  # 意料之外输出: ['任务 A 启动', '任务 B 启动', '任务 C 启动']!
2. 底层机理解析:为什么默认值会被跨调用保留?
在 Python 中,def 是一条在模块初次加载/执行时运行的语句,而不是在每次调用时才去定义。因此,默认参数的表达式仅在函数定义时被求值一次,该列表对象被保存在函数对象的属性 __defaults__ 中。
无论后续调用该函数多少次,只要调用者没有显式传入新的实参,形参 log_list 就会被绑定到保存在 __defaults__ 中的那个唯一的同一个列表对象。log_list.append() 就地修改了这个共享列表,导致历史数据持续累加,造成难以排查的数据污染。
3. 工业级标准解决方案:None 哨兵值模式
解决该问题的工程规范是:默认参数使用不可变的单例对象 None,并在函数内部通过条件分支动态初始化全新的可变对象。
# 正确示范:使用 None 作为占位哨兵,内部按需动态新建
def add_log_safe(message, log_list=None):
    if log_list is None:
        log_list = []  # 每次调用在当前局部栈帧新建,彼此完全独立!
    log_list.append(message)
    return log_list

print(add_log_safe("任务 A 启动"))  # 输出: ['任务 A 启动']
print(add_log_safe("任务 B 启动"))  # 输出: ['任务 B 启动'] (符合预期,无串扰)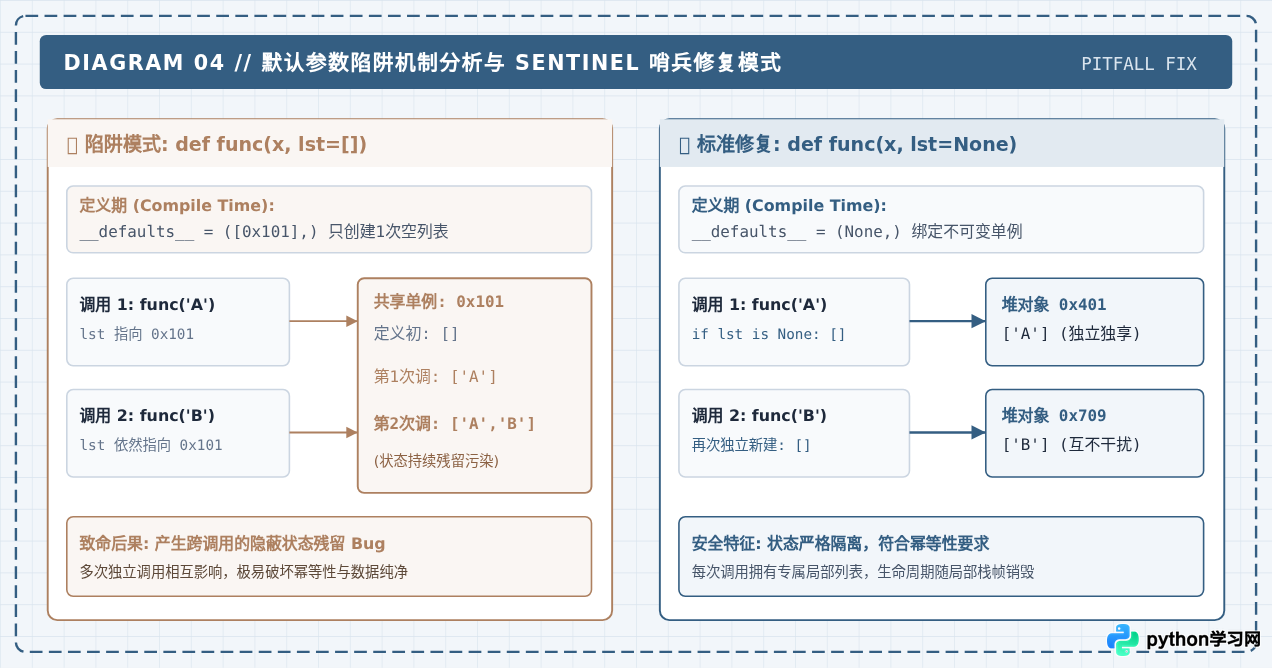
五、总结与工程最佳实践
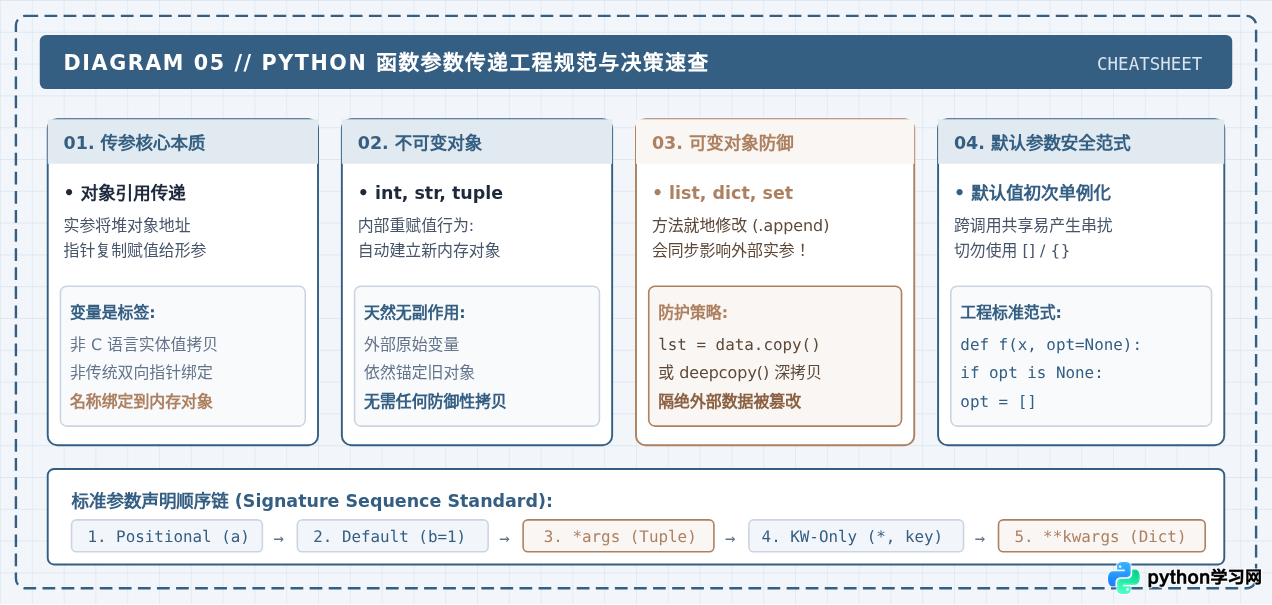
通过以上的原理探究与代码验证,我们可以将 Python 函数定义、调用及参数传递的核心要点提炼为以下 4 条工程准则:
- 牢记“对象引用传递”:实参向形参传参本质上是指针引用的赋值。函数刚启动时,形参与实参指向同一对象。
- 防范可变对象的就地副作用:若函数需要处理传入的列表或字典,且不希望外部原数据被改变,应当在函数开头进行浅拷贝(
lst = original.copy())或深拷贝(copy.deepcopy(original))。 - 严禁在默认参数中使用可变对象:一律采用
param=None模式,并在函数体内动态判断初始化。 - 保持参数签名逻辑清晰:在设计多参数接口时,严格遵守
位置参数 -> 默认参数 -> *args -> 仅限关键字参数 -> **kwargs的顺序,并建议通过 Type Hint(类型注解)标注参数与返回类型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















