


Python函数、类与包:不同粒度代码封装的选择策略
深入解析Python中函数、类与包三种不同粒度代码封装的选择策略。通过状态生命周期、依赖边界与典型反模式对比,帮助开发者在实际项目中做出清晰的架构选型。
一、封装粒度的本质:状态、生命周期与隔离边界
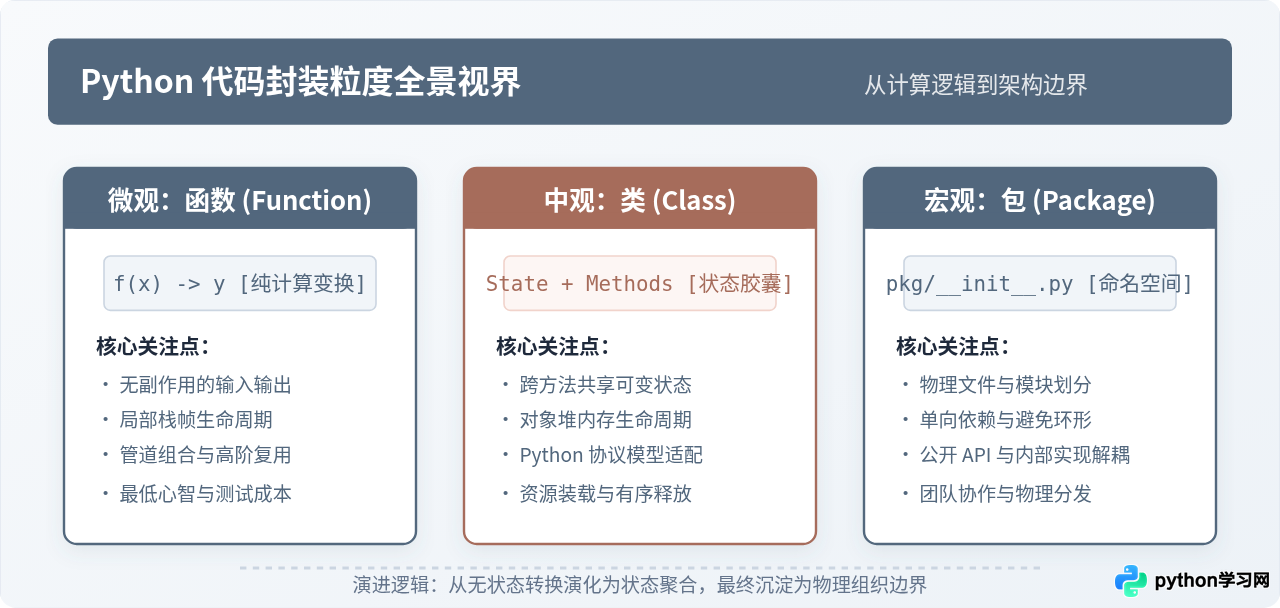
很多开发者在刚开始接触面向对象编程时,容易形成一种误区:认为“高级”的代码就应该把所有逻辑装进类里。但在 Python 这样支持多范式的动态语言中,函数是一等公民(First-class Citizen),模块(单个 .py 文件)本身就是一个独立的命名空间。代码封装的本质并非把代码装进不同的语法糖容器,而是管理状态可变性与生命周期。
从微观到宏观,Python 提供了三个层级的封装边界:
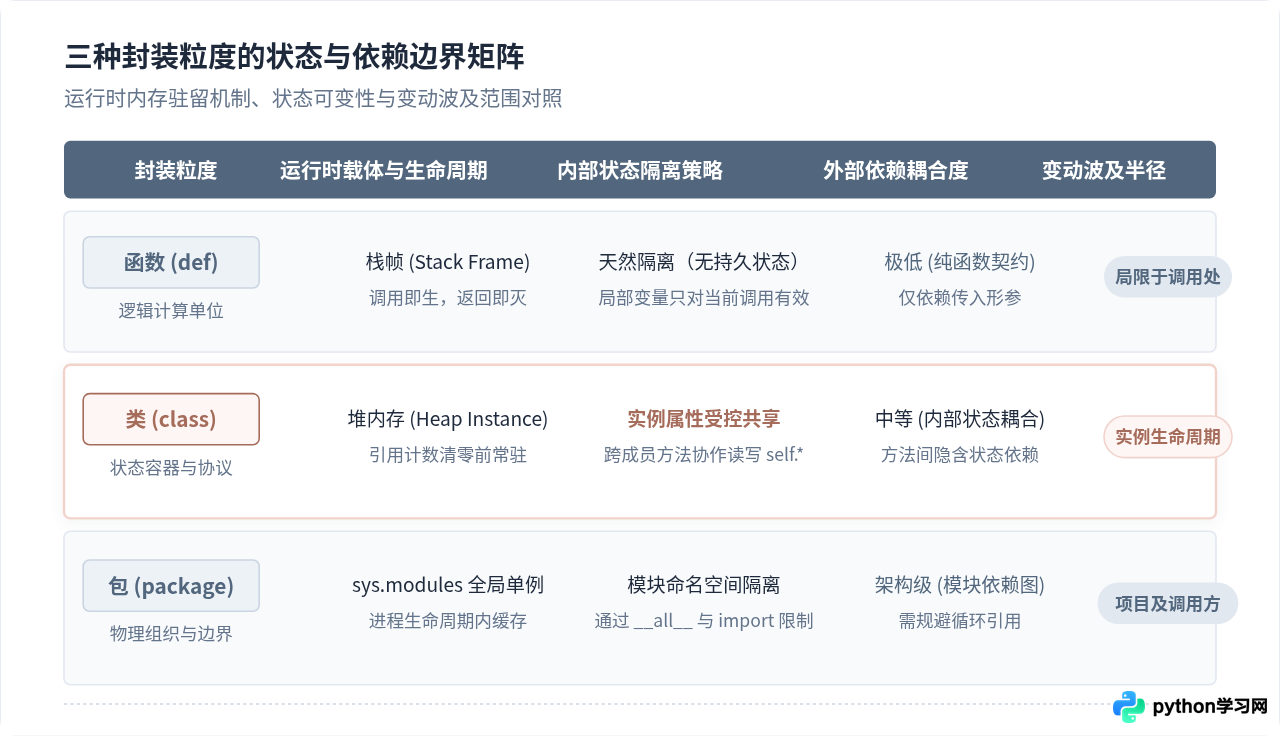
- 函数(Function):最小的可重用逻辑单元。它只关心输入与输出,内部变量分配在局部调用栈帧(Stack Frame)上,函数执行完毕后局部内存随即随栈帧销毁。它天然具备隔离性与无副作用的倾向。
- 类(Class):状态与行为的协同体。类的实例驻留在堆内存(Heap)中,只要存在引用,其实例属性就会长期保留。它负责解决“多个操作方法如何安全且方便地共享可变数据”以及“如何挂载 Python 运行时协议(如上下文管理、迭代协议)”的问题。
- 包(Package):物理工程与命名空间的组织层。以包含
__init__.py的目录呈现,生命周期与整个进程的sys.modules缓存一致。包解决了物理文件组织、防止全局命名冲突、隐藏内部实现细节以及单向依赖架构的落地。
二、第一级粒度:函数——无状态计算与管道式变换
当逻辑表现为明确的“数据流入、计算转换、结果流出”时,函数是最高效、心智负担最低的选择。纯函数(Pure Function)不依赖外部隐藏状态,也不修改传入的不可变参数,这让单元测试变得极为简单:传入特定输入,断言返回结果即可,完全不需要在测试前构造复杂的 mock 对象或前置上下文。
适用场景与典型实践
例如,我们需要对一批原始交易流水进行数据清洗、格式规范化并计算折扣。如果不需要在多次计算之间持久化任何会话,编写几个独立的函数并用组合方式调用是最优雅的做法:
from typing import NamedTuple
from decimal import Decimal

class Transaction(NamedTuple):
    order_id: str
    amount: Decimal
    currency: str
    discount_rate: Decimal

def validate_currency(tx: Transaction, allowed_currencies: set[str]) -> bool:
    """验证币种是否在合法结算范围内(纯函数验证)"""
    return tx.currency.upper() in allowed_currencies

def calculate_final_amount(tx: Transaction) -> Decimal:
    """计算折后净额,不产生外部副作用"""
    discount = tx.amount * tx.discount_rate
    return (tx.amount - discount).quantize(Decimal("0.01"))

def process_batch(transactions: list[Transaction], allowed_currencies: set[str]) -> list[Decimal]:
    """管道式组合函数,流水线式处理"""
    valid_txs = [tx for tx in transactions if validate_currency(tx, allowed_currencies)]
    return [calculate_final_amount(tx) for tx in valid_txs]
上述代码中,数据载体是不可变的 NamedTuple,处理逻辑分布在独立的顶层函数中。代码逻辑透明,既容易进行并发多线程处理(因为不存在任何可变竞争状态),也可以随意组合复用。
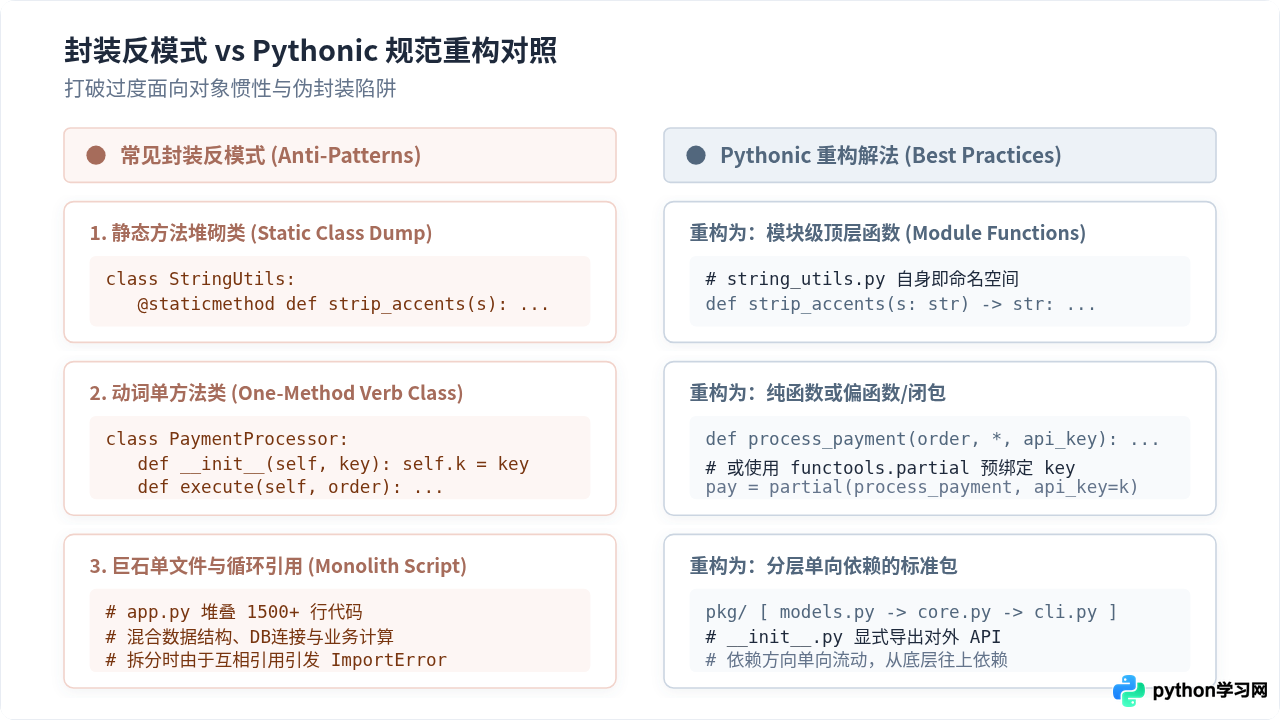
受其他纯面向对象语言习惯影响的开发者常会写出类似
class MathUtils: @staticmethod def add(a, b): ... 这样的代码。在 Python 中,每个 .py 文件自身就是一个天然的单例命名空间。引入一个仅包含静态方法的类,不仅没有任何封装收益,还会多耗费一层属性查找开销,完全应该改为模块顶层的普通函数。
三、第二级粒度:类——状态持久化与行为协议绑定
当多个函数之间必须频繁传递同一组互相影响的数据,且这组数据在不同的操作步骤中会被持续修改时,分散的函数就会导致代码冗余,形参列表迅速膨胀为“泥球”。此时,类就是最合适的抽象粒度。
类成立的两个关键充要条件
- 状态跨方法共享:同一个对象的多个方法需要协同读写
self中的属性。如果一个类实例化后内部属性从不改变,或者所有方法根本不需要读取self,那么这个类大概率是不必要的。 - 实现 Python 数据模型协议(Protocols):需要借力 Python 解释器的内置协议机制,例如支持
with上下文管理的__enter__/__exit__,支持惰性求值的__iter__/__next__,或者实现可调用对象的__call__。
规范实践示例:带连接池与滑动窗口重试的 API 客户端
如下所示,API 客户端需要维护底层的 HTTP 保持连接、访问令牌(Token)的刷新周期以及滑动窗口内的请求频次统计。这些状态无法用单次函数调用的栈帧容纳,必须依赖类实例的生命周期来进行长周期维护:
import time
from typing import Optional

class RateLimitedApiClient:
    """管理持久连接状态与滑动窗口频控的类"""
    def __init__(self, endpoint: str, api_key: str, max_calls_per_minute: int = 60):
        self.endpoint = endpoint
        self._api_key = api_key
        self.max_calls = max_calls_per_minute
        self._call_timestamps: list[float] = []
        self._session_active = False

    def __enter__(self):
        """上下文协议:初始化长连接会话"""
        self._session_active = True
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        """上下文协议:可靠释放资源"""
        self._call_timestamps.clear()
        self._session_active = False

    def _wait_for_rate_limit(self) -> None:
        """维护内部私有可变状态:滑动窗口计数"""
        now = time.time()
        # 清理 60 秒以前的陈旧时间戳
        self._call_timestamps = [t for t in self._call_timestamps if now - t < 60.0]
        if len(self._call_timestamps) >= self.max_calls:
            sleep_duration = 60.0 - (now - self._call_timestamps[0])
            if sleep_duration > 0:
                time.sleep(sleep_duration)
        self._call_timestamps.append(time.time())

    def fetch_data(self, query: str) -> dict:
        """对外暴露的方法,协同调用内部状态"""
        if not self._session_active:
            raise RuntimeError("必须在上下文管理器中调用 fetch_data")
        self._wait_for_rate_limit()
        # 模拟执行网络请求并返回结构化数据
return {"status": "ok", "query": query, "timestamp": time.time()}如果一个类仅包含
__init__ 和一个类似 run()、execute() 的方法,且每次使用都是 Worker(cfg).run() 随后立即弃置,这说明类并没有起到持久维护状态的作用。这本质上只是一个披着类外衣的函数,应当直接改写为带关键字参数的函数,或者使用 functools.partial 进行参数预绑定。
四、第三级粒度:包与模块——命名空间划分与物理隔离
当单个文件内的代码行数突破合理界限(通常在 300~500 行以上),或者模块内同时混杂了数据定义、外部服务集成、数据计算与命令行接口时,就达到了从“单文件模块”重构为“包”的临界点。
包的设计原则与目录演进
包的核心作用是定义物理组织边界与公开 API 门面(Facade)。一个设计良好的包应当允许内部实现根据需要自由重构,而外部调用方的导入路径保持稳定。
my_payment_sdk/
├── __init__.py           # 显式导出稳定公共接口,定义 __all__
├── _client.py            # 内部核心连接与客户端类(下划线标明私有)
├── _parser.py            # 内部报文编解码函数
├── exceptions.py         # 领域异常定义
└── models.py             # 纯数据结构(dataclass / Pydantic模型)
在 __init__.py 中,应当主动控制命名空间暴露,避免将内部辅助工具直接泄露给使用者:
# my_payment_sdk/__init__.py
from ._client import RateLimitedApiClient
from .exceptions import SdkError, AuthenticationFailed
from .models import PaymentOrder

__all__ = [
    "RateLimitedApiClient",
    "SdkError",
    "AuthenticationFailed",
    "PaymentOrder",
]在拆分包时,最常见的报错是
ImportError: cannot import name ... from partially initialized module。根治循环导入的关键在于维持依赖的单向流动:底层数据模型(如 models.py)绝不能反向导入上层业务逻辑模块;跨模块类型注解可以使用 from __future__ import annotations 与 if typing.TYPE_CHECKING: 避免运行时循环加载。
五、操作指南:代码封装形态决策工作流与演进路径
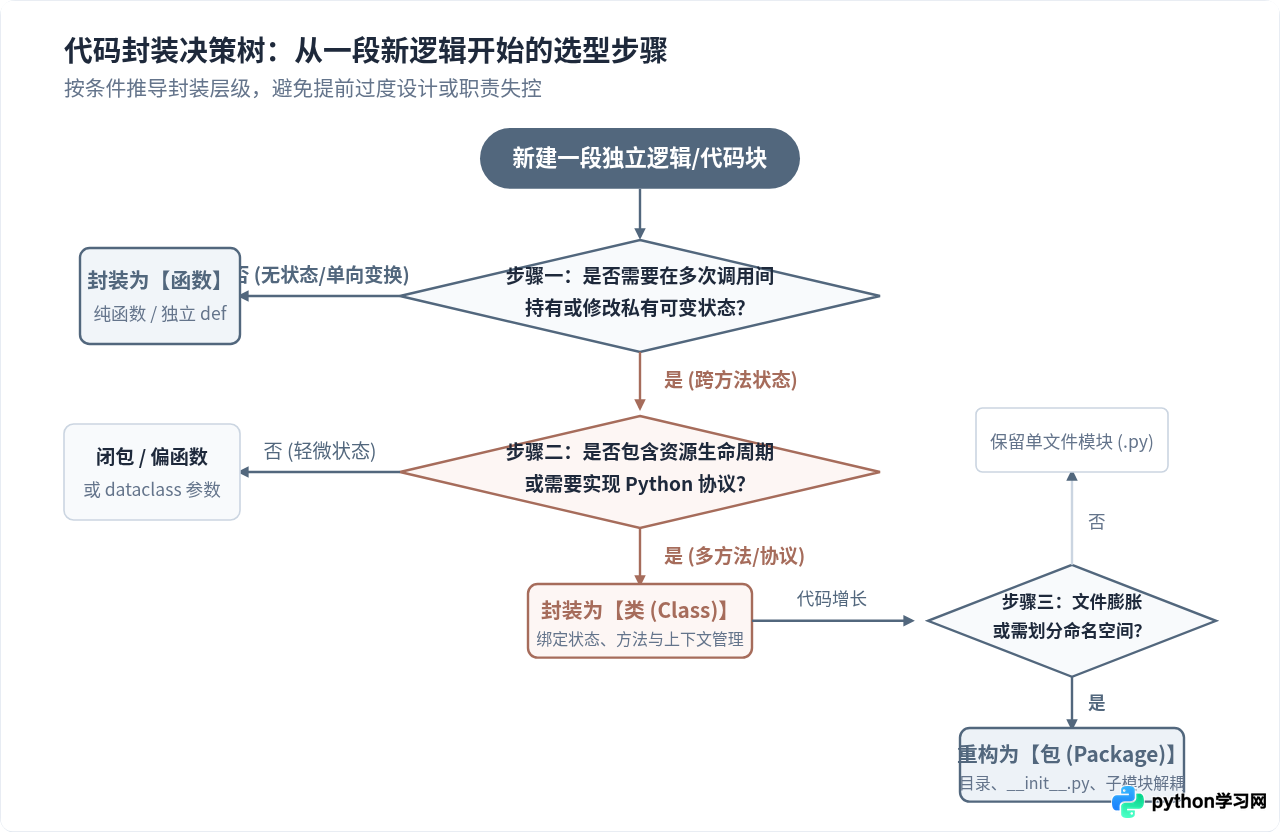
在实际编写或重构代码时,不必一开始就预判最终的包架构。遵循“从最小可行粒度向外扩张”的演进路线,可以通过下面清晰的三步决策树来判断:
具体的执行与重构步骤
- 第一步(评估状态持久度):阅读新逻辑。如果逻辑只需要接收几个参数并返回新数据,直接写成函数。如果出现多个函数都在修改传入的字典或全局变量,立刻将这批数据和函数提取为一个类。
- 第二步(评估协议与生命周期):检查该逻辑是否涉及资源的开启与关闭(如数据库事务、文件流、锁),如果是,立刻为类补齐
__enter__/__exit__上下文协议支持。 - 第三步(评估协作边界与文件膨胀):当单文件内出现超过 3 个彼此业务正交的类,或者其他项目需要复用其中某一部分基础模型时,创建同名目录与
__init__.py,将模型、异常、核心类拆解为平级模块。
六、封装策略综合对照与选型检查清单
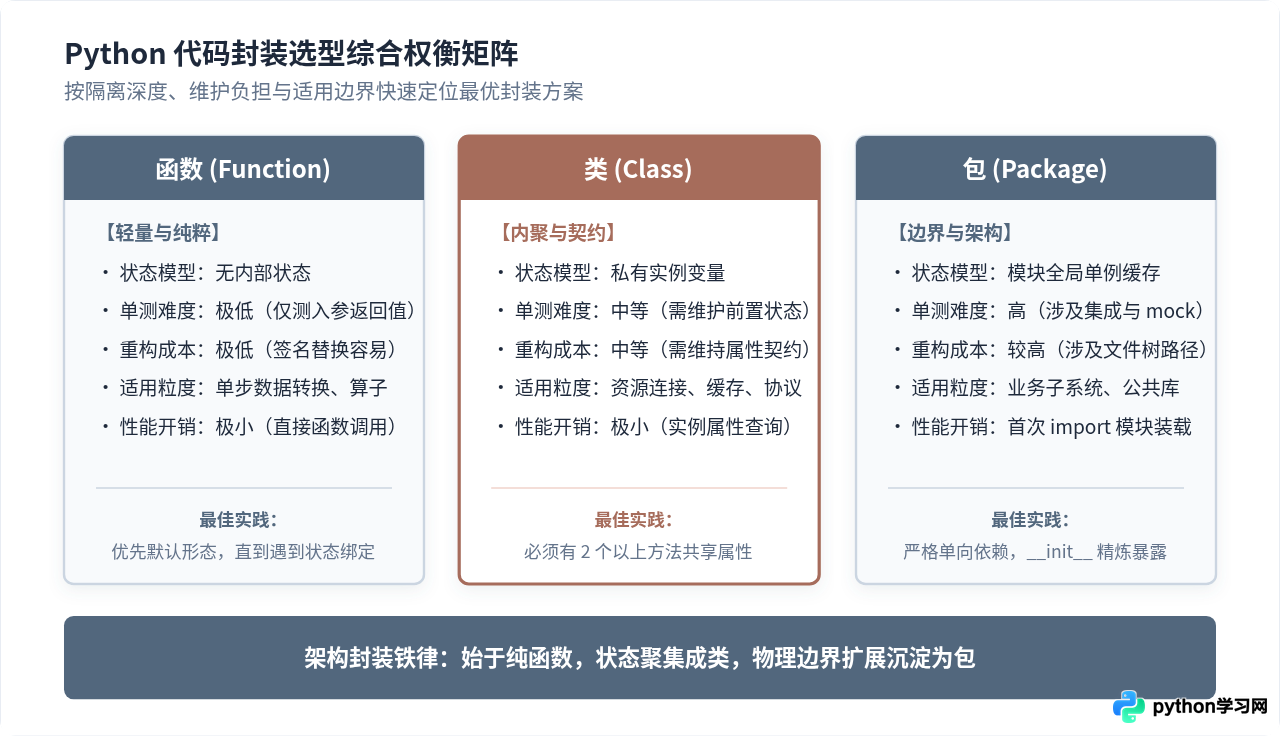
为了在日常代码评审(Code Review)或架构重构时建立快速共识,下表总结了函数、类与包在五个核心维度上的综合表现:
| 评估维度 | 函数 (Function) | 类 (Class) | 包 (Package) |
|---|---|---|---|
| 主要封装目的 | 逻辑复用与数据变换计算 | 可变内部状态管理与对象协议 | 物理模块解耦与公共 API 隔离 |
| 内部状态特征 | 无持久状态(栈帧随用随销毁) | 跨方法持久共享(堆内存实例持有) | 模块单例全局缓存(进程生命周期) |
| 单测容易程度 | 极高(仅测入参与出参) | 中等(需构造初始状态与依赖) | 需关注导入依赖链与集成环境 |
| 典型重构摩擦 | 极低(提取与内联最轻量) | 中等(需维护属性命名与方法契约) | 较高(涉及文件移动与 import 路径) |
| 典型反模式 | 参数爆炸过长(散落的字典传参) | 单方法动词类、静态工具类 | 深层嵌套目录、循环依赖环 |
落地自查清单(Checklist)
当你在写下一行 class 或 mkdir 时,可以通过以下 4 个问题做最后确认:
- 问 1:这个类里是否有至少两个方法在读写相同的
self.xxx属性?如果否,请降级为普通函数。 - 问 2:如果只使用顶层函数,是否会导致 5 个以上的函数都必须传递完全相同的三四个配置形参?如果是,请将配置与函数合并为类。
- 问 3:外部调用方是否需要知道这个模块是由 5 个子文件组成的?如果不需要,请在包的
__init__.py中定义__all__隐藏内部文件结构。 - 问 4:模块拆分后,是否能绘制出一张没有交叉回路的单向有向无环图(DAG)?如果存在双向导入,说明模块职责划分有误,应提取共同类型到底层
types.py。
优秀的 Python 代码往往具有清晰的渐进式特征:它从几个干净的顶层纯函数起步;随着业务对状态持有和资源生命周期提出要求,相关函数自然凝聚为类;当功能逐步发展为复杂的子系统时,再通过清晰的包边界对外提供极简的接口门面。掌握这三者的选择策略,不仅能避免过度设计的繁琐,也能防止代码失控滑向难以维护的泥潭。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















