


洛谷Python刷题:字典(dict)基础用法与典型例题解析
针对洛谷等算法评测平台的Python刷题实战,系统解析字典(dict)的哈希映射底层原理、常用语法、I/O性能调优,并深度剖析P5266学籍管理、P1102数对统计与P1097频数排序三道典型例题。
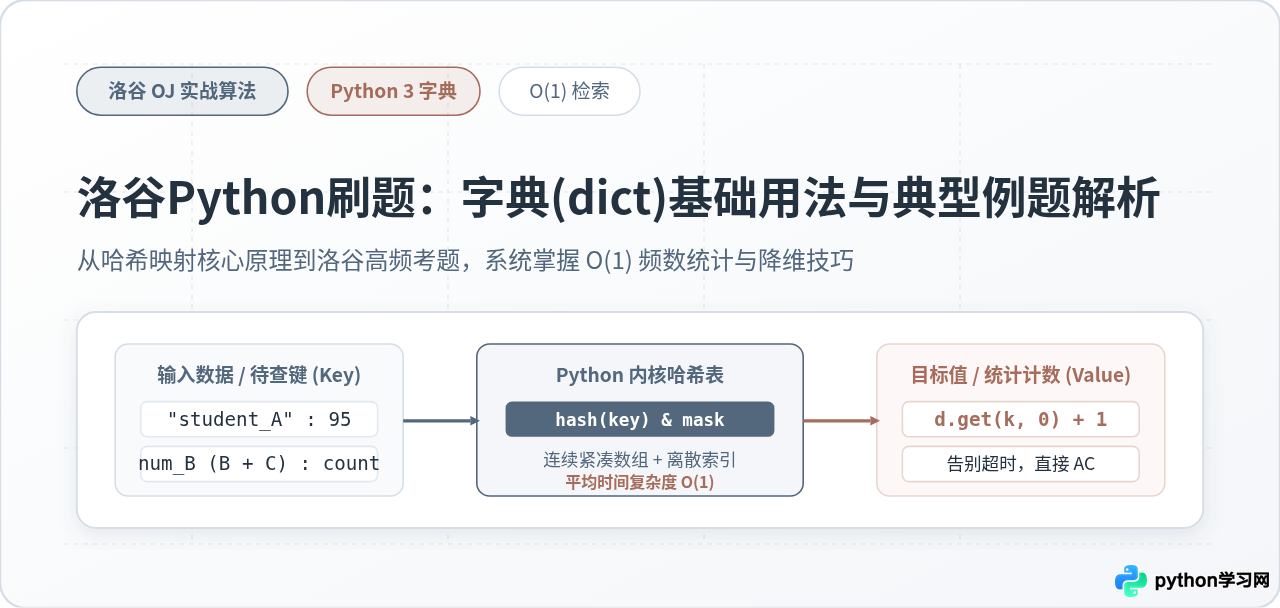
在洛谷等在线评测平台上使用 Python 刷题时,字典(dict)是解决频数统计、离散映射与数值配对问题的核心利器。凭借底层哈希表带来的平均 O(1) 查询与插入效率,字典能够直接将朴素循环的 O(N²) 复杂度压制到 O(N),彻底消除在应对 10⁵~10⁶ 规模输入时频繁出现的运行超时(Time Limit Exceeded, TLE)。本文梳理 Python 字典的关键机制与竞赛实战写法,并通过三道洛谷典型例题系统拆解解题流程。
一、字典在算法竞赛中的核心价值与底层特性
初涉算法题时,很多学习者习惯使用列表(list)保存输入数据,并通过 x in my_list 或 my_list.count(x) 来统计元素。在数据量小于几千时,这种写法能够正常通过;但一旦数据规模达到 10⁵(洛谷提高组与基础模拟题常见规模),列表遍历就会暴露致命短板。
列表基于连续物理内存,其检索本质是顺序遍历,单次判存耗时为 O(N)。若外层包裹循环,整体时间复杂度将膨胀至 O(N²)。而 Python 的字典基于高度优化的紧凑哈希表(Compact Hash Table),通过将键(Key)传入散列函数计算桶索引,绝大部分操作(插入、获取、存在性校验)均可在常数时间 O(1) 内完成。
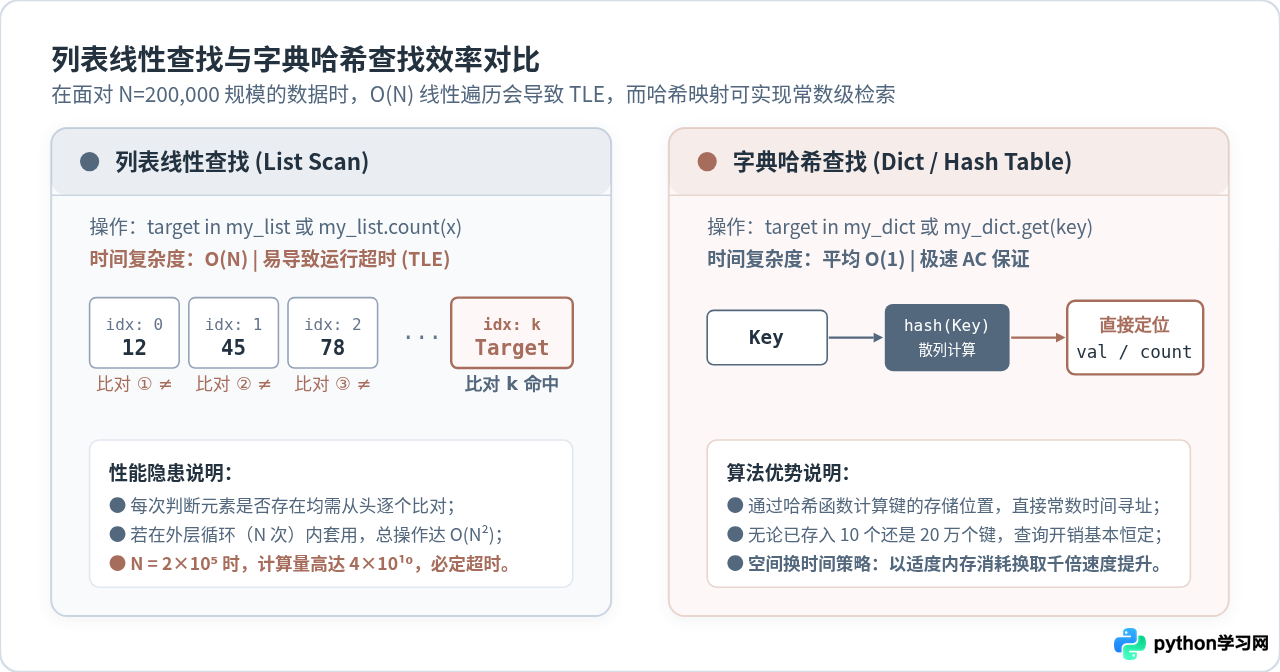
在竞赛中使用字典时,必须牢记其底层要求:
- 键必须是可哈希(Hashable)类型:整数、浮点数、字符串、元组(
tuple)均可作为合法键;而列表(list)、字典等可变对象不可哈希,若强行作键将触发TypeError: unhashable type: 'list'。当需要将坐标(x, y)存为键时,请务必使用元组形式(x, y)。 - 空间换时间权衡:哈希表为了降低冲突概率并维持极速寻址,内存开销约为等长紧凑列表的 3 至 4 倍。但在洛谷 128MB~256MB 的内存限制下,容纳 20 万至 50 万个键值对绰绰有余。
二、刷题常用的字典核心操作与书写模式
在洛谷限时评测环境下,代码除了追求正确性,还需兼顾执行效率与异常安全。以下是算法题中最常用且不易出错的代码范式。
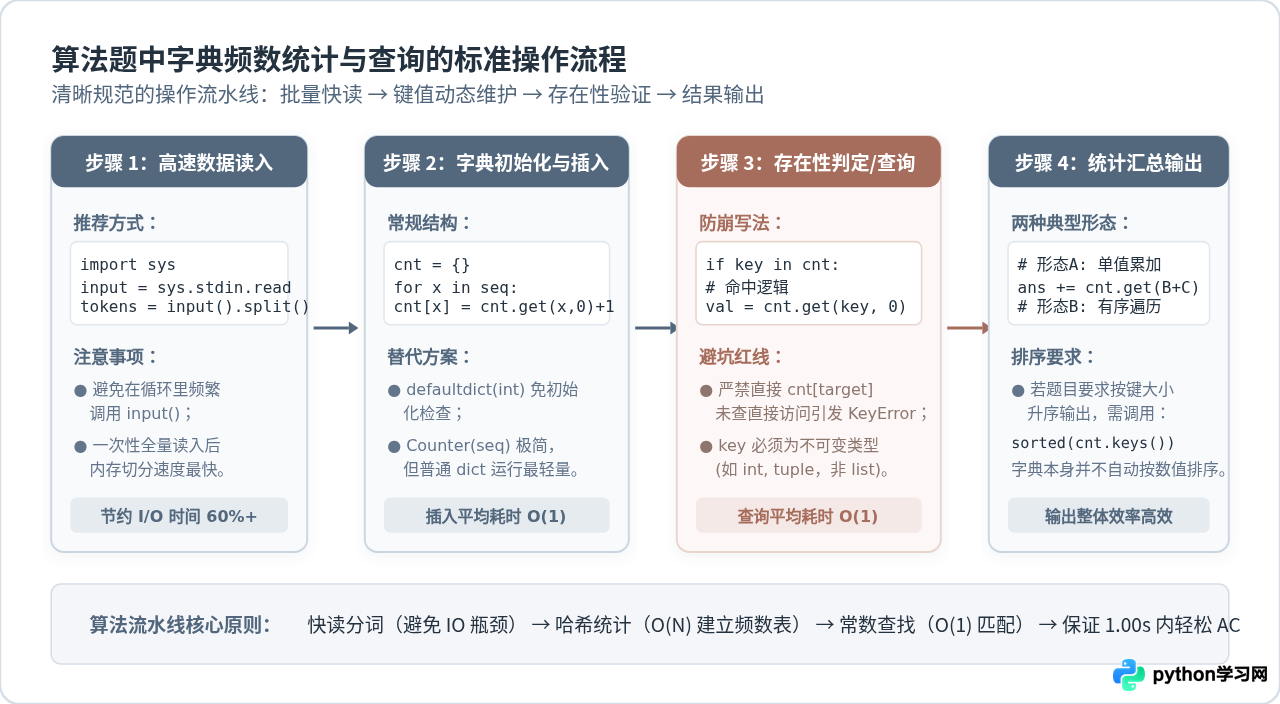
1. 安全频数累加:避免 KeyError
若直接书写 cnt[x] += 1,当 x 首次出现时,Python 会抛出 KeyError 导致程序异常终止(Runtime Error)。最推荐的简洁写法是使用字典内置的 get() 方法提供缺省值:
# 安全频数统计模板
cnt = {}
for x in nums:
    cnt[x] = cnt.get(x, 0) + 1
2. 存在性快速校验
检查某个数字或字符串是否已被记录,直接使用 in 运算符。该操作在字典上是 O(1) 耗时:
if target in cnt:
    ans += cnt[target]
3. 竞赛环境下的极速 I/O 搭配
在 Python 中,当输入行数达 10⁵ 级别时,逐行调用 input() 往往会在 I/O 阶段消耗超过 0.5 秒。必须在程序头部引入 sys.stdin.read().split() 实行全量切分:
import sys

def solve():
    # 一次性读入所有文本并按空白符切分为 token 列表
    input_data = sys.stdin.read().split()
    if not input_data:
        return
    # 顺序获取参数与后续数据
    n = int(input_data[0])
    ...
三、典型例题精析一:P5266【深基17.例6】学籍管理(字典模拟系统)
题目核心要求:设计一个学生信息管理系统,支持四种动态操作指令:
1 NAME SCORE:插入或更新学生NAME的成绩为SCORE,输出OK。2 NAME:查询学生NAME的成绩,若存在输出成绩,不存在输出Not found。3 NAME:从系统中删除学生NAME,若存在删除并输出Deleted,不存在输出Not found。4:输出当前系统内的学生总人数。
解题思路与复杂度分析
本题是典型的“增删改查”全功能模拟题。若使用列表保存二元组 [name, score],查找与删除需要遍历整个列表,总复杂度为 O(Q × N),在 Q=10⁵ 时必然超时。而使用字典 students = {},学生姓名作键,成绩作值:
- 操作 1 对应
students[name] = score,自动覆盖旧成绩,耗时O(1); - 操作 2 对应
if name in students,若命中则输出students[name],耗时O(1); - 操作 3 对应
del students[name],若命中则常数时间删除,耗时O(1); - 操作 4 对应
len(students),Python 字典内部实时维护长度字段,查询耗时直接为O(1)。
AC 代码实现
import sys

def main():
    input_tokens = sys.stdin.read().split()
    if not input_tokens:
        return

    q = int(input_tokens[0])
    ptr = 1
    students = {}
    output = []

    for _ in range(q):
        op = input_tokens[ptr]
        ptr += 1

        if op == '1':
            name = input_tokens[ptr]
            score = input_tokens[ptr + 1]
            ptr += 2
            students[name] = score
            output.append("OK")

        elif op == '2':
            name = input_tokens[ptr]
            ptr += 1
            if name in students:
                output.append(students[name])
            else:
                output.append("Not found")

        elif op == '3':
            name = input_tokens[ptr]
            ptr += 1
            if name in students:
                del students[name]
                output.append("Deleted")
            else:
                output.append("Not found")

        elif op == '4':
            output.append(str(len(students)))

    sys.stdout.write("
".join(output) + "
")

if __name__ == "__main__":
    main()
四、典型例题精析二:P1102 A-B 数对(哈希表降维统计)
题目核心要求:给出一个包含 N 个正整数的数列和一个常数 C,求满足 A - B = C 的数对 (A, B) 的总个数(不同位置的相同数字算作不同数对)。其中 N ≤ 2×10⁵,所有数均在 32 位有符号整数范围内。
数学转化与哈希优化
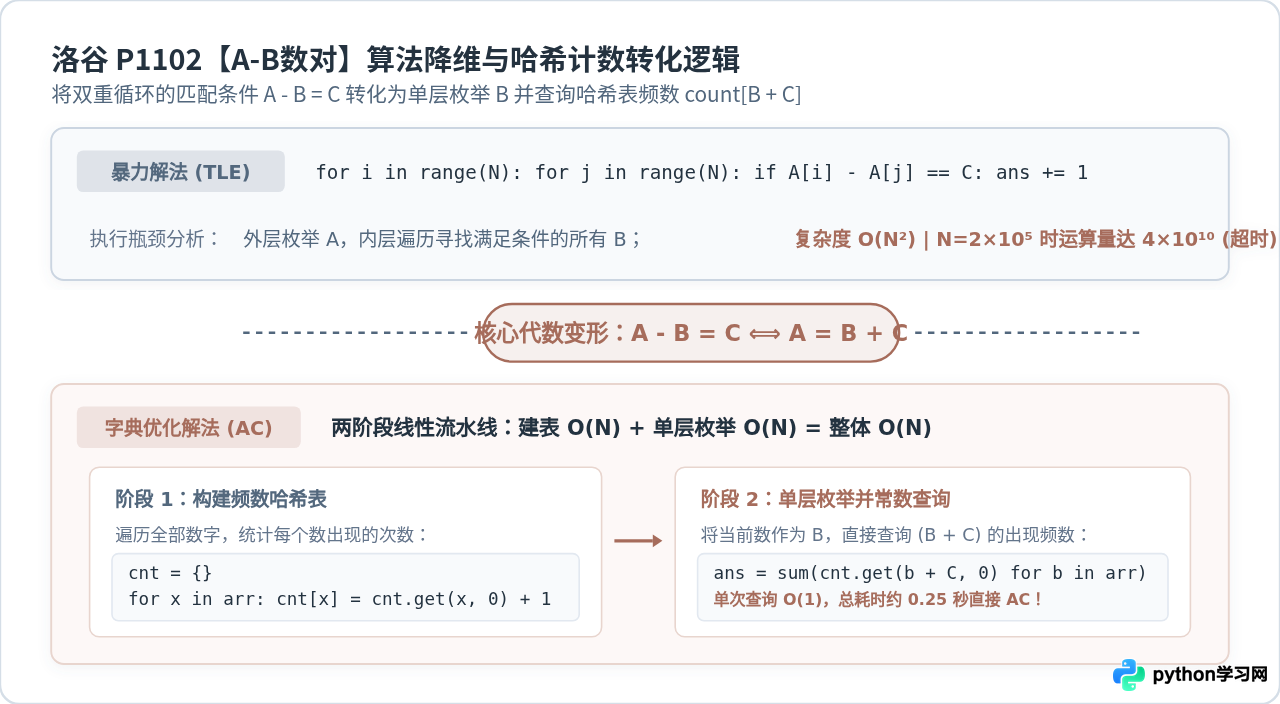
最直观的做法是双重循环枚举每个数作为 A,再枚举其余数作为 B,判断差值是否为 C。但此时计算步数达 N² = 4×10¹⁰,远超评测机 1 秒内约 10⁷~10⁸ 次操作的上限。
对等式进行简单代数变形:
A - B = C ⟺ A = B + C
这一变形将“两数关联判断”转换为“单值目标查找”:若我们固定每一个数作为 B,那么它所需要的 A 必须且只能是 B + C。序列中总共有多少个数值等于 B + C,当前这个 B 就能贡献多少组有效数对。
算法步骤与 AC 代码
- 利用字典
cnt遍历一遍输入序列,统计每个数值出现的次数; - 再次遍历输入序列中的每个数
b,直接通过cnt.get(b + C, 0)获取能与当前b配对的A的数量,累加至答案; - 总时间复杂度降至
O(N),空间复杂度O(N)。
import sys

def main():
    tokens = sys.stdin.read().split()
    if not tokens:
        return

    n = int(tokens[0])
    c = int(tokens[1])
    arr = [int(x) for x in tokens[2:2 + n]]

    # 阶段 1:频数统计 O(N)
    freq = {}
    for num in arr:
        freq[num] = freq.get(num, 0) + 1

    # 阶段 2:单层枚举并 O(1) 匹配累加
    ans = 0
    for b in arr:
        ans += freq.get(b + c, 0)

    print(ans)

if __name__ == "__main__":
    main()
注意本题允许不同位置的相同数值组合。遍历原始列表 arr 中的每一个元素作为 b 并累加 freq.get(b + c, 0),能精确计算出位置维度的全部组合数;无须担心重复统计,因为每个位置上的 b 是独立且唯一的枚举实体。
五、典型例题精析三:P1097【NOIP2007 提高组】统计数字(频数统计与有序输出)
题目核心要求:输入 N 个自然数(1 ≤ N ≤ 200,000,每个数不超过 1.5×10⁹),要求按照数值由小到大的顺序,输出每个不同的数以及它在原始数据中出现的总次数。
解题思路:字典聚合与有序键遍历
本题包含两个要求:频数统计 与 升序输出。由于数值高达 1.5×10⁹,不可能使用数组下标直接当作计数器(会引发超出内存或索引越界)。
解题方案分为两步:
- 使用字典
count_map快速汇总每个数值出现的频次,耗时O(N); - 获取字典所有的键进行排序:
keys = sorted(count_map.keys())。设不同的数字数量为 M(M ≤ N),排序开销为O(M log M); - 按排序后的键顺序输出对应的计数值。整体时间复杂度为
O(N + M log M),在 0.3 秒内即可平稳通过。
AC 代码实现
import sys

def main():
    tokens = sys.stdin.read().split()
    if not tokens:
        return

    n = int(tokens[0])
    nums = [int(x) for x in tokens[1:1 + n]]

    # 统计频数
    count_map = {}
    for x in nums:
        count_map[x] = count_map.get(x, 0) + 1

    # 仅对去重后的不同数值进行升序排序
    sorted_keys = sorted(count_map.keys())

    # 格式化输出
    out = []
    for k in sorted_keys:
        out.append(f"{k} {count_map[k]}")

    sys.stdout.write("
".join(out) + "
")

if __name__ == "__main__":
    main()
六、避坑指南与刷题总结
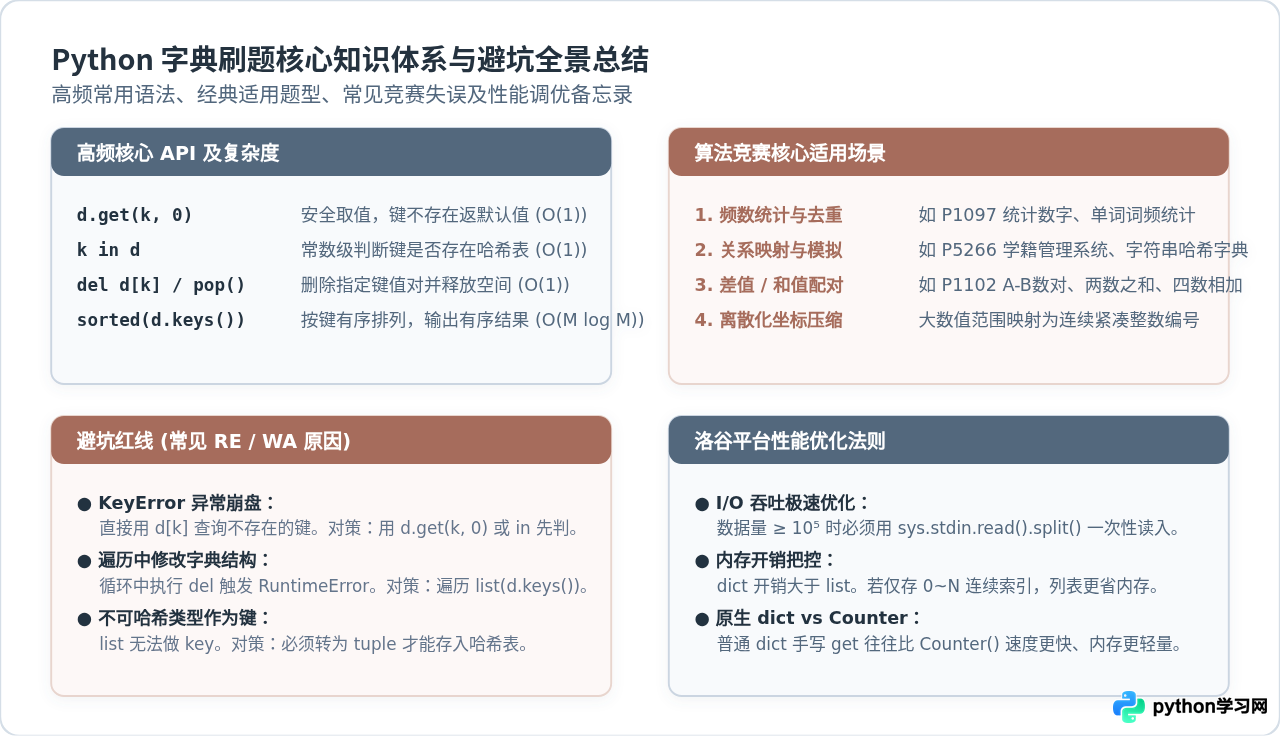
在洛谷日常提交中,Python 字典相关的常见失误通常集中在语法细节与边界处理上。
常见失误排查清单
| 常见失误表现 | 根本原因 | 标准解决措施 |
|---|---|---|
KeyError (RE) |
直接使用下标 d[k] 访问了尚未存入的键 |
改用 d.get(k, 0) 或提前使用 if k in d 校验 |
RuntimeError (RE) |
在 for k in d: 循环体内部执行了 del d[k] 或新增键 |
改用 for k in list(d.keys()): 遍历静态副本 |
TypeError (RE) |
尝试将二维列表 [x, y] 作为哈希键 |
转换为不可变类型元组 (x, y) 后再作为键存入 |
| 运行超时 (TLE) | 在大量查询中反复调用了 list.count() 或全量读入效率低 |
构建哈希字典进行 O(1) 检索,并配合 sys.stdin.read().split() |
掌握 Python 字典的核心逻辑不仅是解决初级模拟题的必备技能,更是后续深入学习图论邻接表构建、离散化坐标压缩、记忆化搜索(Memoization / lru_cache)以及滚动状态哈希判重的底层基石。在刷题过程中保持严谨的数据结构选型意识,优先使用哈希降低关键步骤的查询阶次,是在算法竞赛中写出高性能 Python 代码的关键所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















