


Python Scrapy框架详细教程:构建高效分布式爬虫
本教程详细讲解如何基于Python Scrapy框架与Scrapy-Redis构建高效稳定的分布式爬虫系统,涵盖架构改造原理、环境准备、核心配置、多节点协同与生产运维调优。
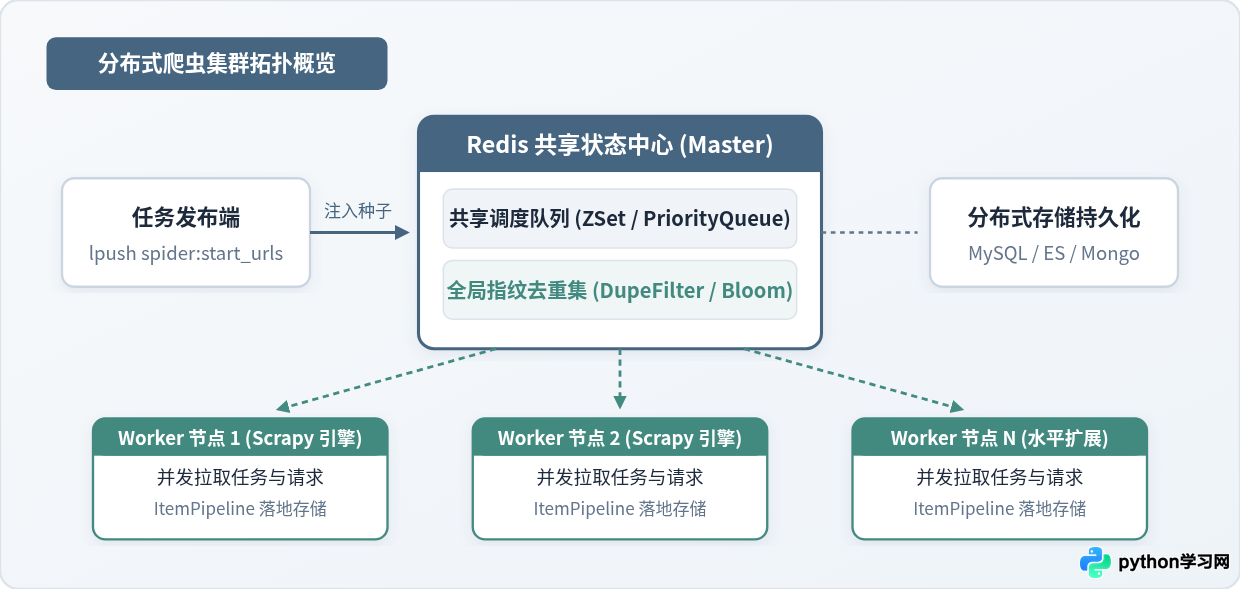
一、Scrapy单机架构瓶颈与分布式改造原理
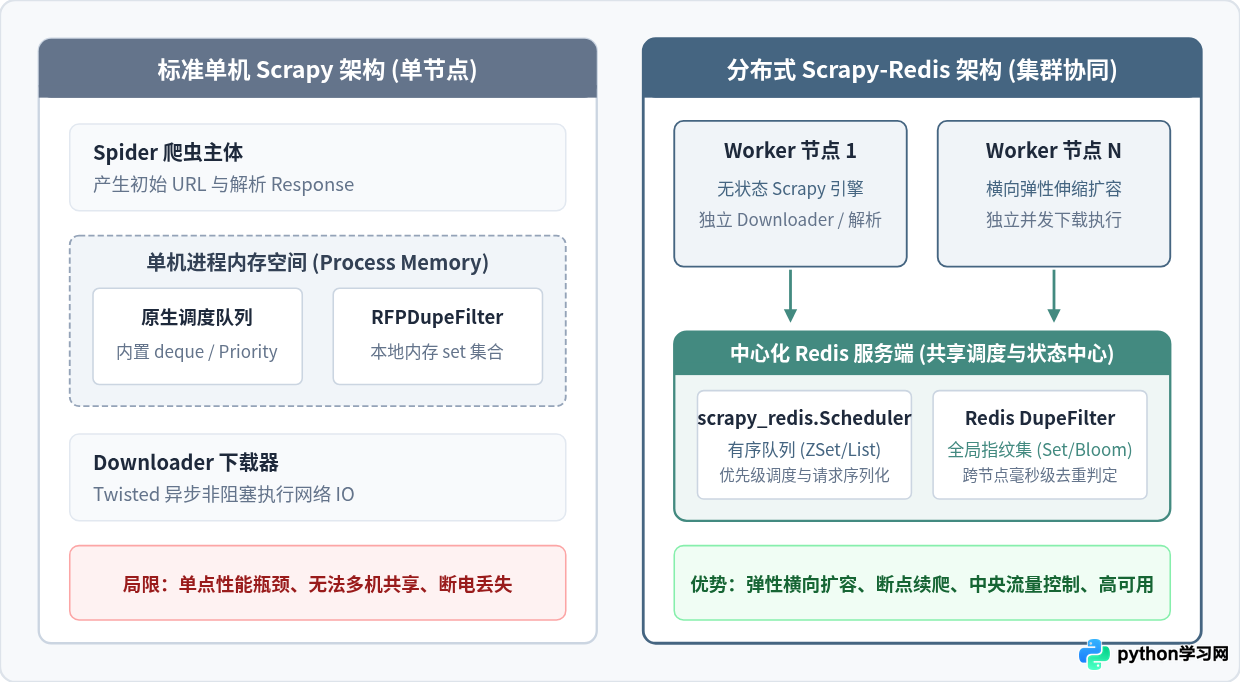
Scrapy 默认是一款基于 Twisted 异步事件驱动模型的高性能爬虫框架。在单机执行模式下,其核心组件包括引擎(Engine)、调度器(Scheduler)、下载器(Downloader)、爬虫主体(Spiders)以及数据处理管道(Item Pipelines)。单机运行时,Scrapy 的调度器与指纹去重器均工作在单进程内存空间中:
- 内存请求队列:调度器利用 Python 内存优先队列管理待下载的
Request对象,进程终止时内存队列即被清空; - 内存指纹集合:去重过滤器(
RFPDupeFilter)使用 Python 原生set集合保存已抓取请求的 SHA1 指纹,无法被宿主机上的其他进程或局域网内的其他物理节点读取; - 无状态协同缺失:当抓取规模达到千万级甚至亿级网页时,单台服务器的物理内存、带宽上限及 IP 访问频次阈值将直接成为系统瓶颈,且单机无法做到无缝断点续爬。
分布式爬虫的核心诉求是“多机协同、状态共享、互不重复”。基于 scrapy-redis 的解决方案通过重写 Scrapy 的调度器与去重器,将依赖本地内存的队列替换为远端 Redis 数据库中的数据结构,进而实现无状态 Worker 节点的任意横向扩容。
二、运行环境与基础工程准备
构建分布式爬虫需要准备两部分环境:一是作为中央调度核心的 Redis 服务,二是部署在各爬虫节点(Worker)上的 Python 运行环境。
1. 依赖库安装
在所有参与分布式集群抓取的机器上,均需要安装 Scrapy 及 Scrapy-Redis。建议使用 Python 3.8+ 虚拟环境以保证依赖环境纯净:
终端安装命令# 激活虚拟环境后安装基础组件
pip install scrapy==2.11.2 scrapy-redis==0.7.3 redis==5.0.42. Redis 调度服务端配置
作为分布式调度的中枢,Redis 必须允许各 Worker 节点远程连接。打开 Redis 配置文件(通常位于 /etc/redis/redis.conf),确保修改以下关键配置:
# 允许局域网或指定 IP 访问,生产环境请勿直接绑定 0.0.0.0
bind 0.0.0.0

# 关闭保护模式,允许跨主机连接
protected-mode no

# 开放指定端口(默认 6379)
port 6379

# 务必设置高强度访问密码
requirepass SecurePassword_2024!

# 开启 AOF 持久化,防止调度中断后任务丢失
appendonly yes
appendfsync everysec
配置保存后重启 Redis 服务,并在任意 Worker 节点上使用 redis-cli 测试连通性:
# 执行连通性测试
redis-cli -h 192.168.1.100 -p 6379 -a "SecurePassword_2024!" ping

# 正常返回示例
PONG
三、改造为分布式爬虫的关键步骤
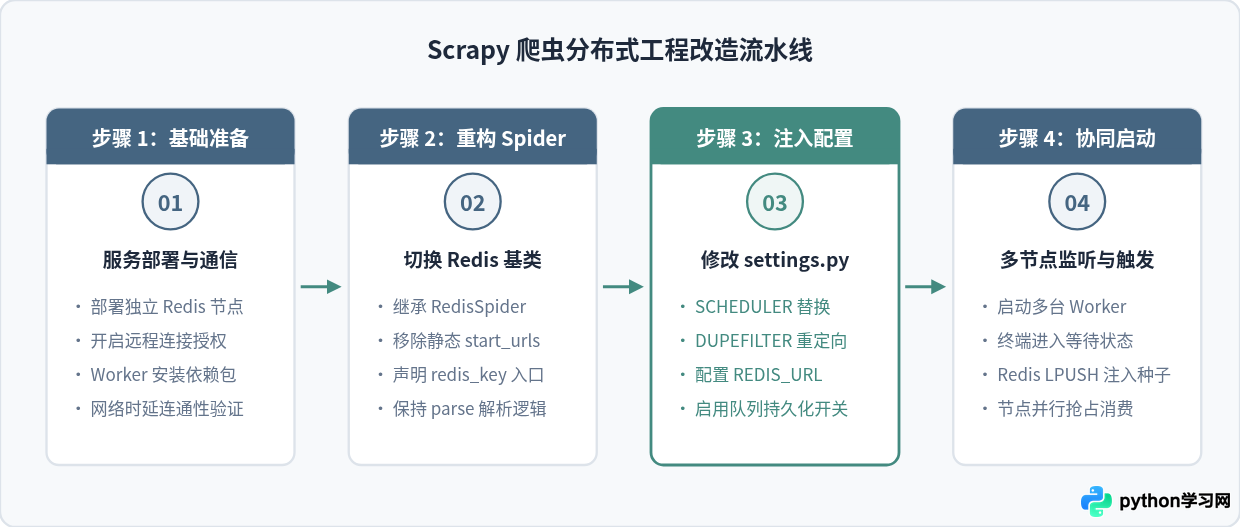
将现有的单机 Scrapy 爬虫改造为分布式爬虫,关键在于两处调整:其一是修改 Spider 的继承类与起始任务源;其二是在 settings.py 中重载调度器、去重器与管道配置。
1. 编写分布式 Spider 代码
创建名为 distributed_books.py 的爬虫文件。核心差异在于将继承类从 scrapy.Spider 修改为 scrapy_redis.spiders.RedisSpider,并移除固定的 start_urls 列表,改用 redis_key 定义任务消费入口:
import scrapy
from scrapy_redis.spiders import RedisSpider

class DistributedBooksSpider(RedisSpider):
    # 分布式爬虫主体:
    # 继承 RedisSpider 后,不再从 start_urls 读取起始链接,
    # 而是从 Redis 中名称为 books:start_urls 的列表中阻塞式弹出待抓取 URL。
    name = "distributed_books"
    redis_key = "books:start_urls"

    def parse(self, response):
        # 1. 提取当前页面图书列表条目
        book_links = response.css("article.product_pod h3 a::attr(href)").getall()
        for link in book_links:
            detail_url = response.urljoin(link)
            # 生成图书详情页 Request,会自动提交给 Redis 调度中心排重与入队
            yield scrapy.Request(url=detail_url, callback=self.parse_detail)

        # 2. 提取翻页链接,实现整站多层级持续抓取
        next_page = response.css("li.next a::attr(href)").get()
        if next_page:
            next_url = response.urljoin(next_page)
            yield scrapy.Request(url=next_url, callback=self.parse)

    def parse_detail(self, response):
        # 提取图书详细结构化数据
        title = response.css("div.product_main h1::text").get()
        price = response.css("p.price_color::text").get()
        stock = response.css("p.availability::text").re_first(r"\d+")

        yield {
            "title": title.strip() if title else "",
            "price": price.strip() if price else "",
            "stock": int(stock) if stock else 0,
            "url": response.url
        }
2. 重载 settings.py 关键调度参数
在项目配置文件 settings.py 中追加以下配置,完成调度器与去重逻辑的全局接管:
# 1. 指定 Scrapy-Redis 自定义调度器,替换原生本地调度器
SCHEDULER = "scrapy_redis.scheduler.Scheduler"

# 2. 指定 Scrapy-Redis 提供的指纹去重过滤器
DUPEFILTER_CLASS = "scrapy_redis.dupefilter.RFPDupeFilter"

# 3. 调度持久化配置:设置为 True 表示在爬虫停止时不清理 Redis 队列,支持暂停与断点续爬
SCHEDULER_PERSIST = True

# 4. 指定队列调度模式(默认优先队列:根据 Request priority 字段降序排列)
# 备选项:
# - 'scrapy_redis.queue.SpiderPriorityQueue' (默认,按优先级)
# - 'scrapy_redis.queue.SpiderQueue'         (先入先出 FIFO 队列)
# - 'scrapy_redis.queue.SpiderStack'         (后入先出 LIFO 栈)
SCHEDULER_QUEUE_CLASS = "scrapy_redis.queue.SpiderPriorityQueue"

# 5. Redis 连接字符串(格式:redis://[:password@]host:port/db)
REDIS_URL = "redis://:SecurePassword_2024!@192.168.1.100:6379/0"

# 6. 数据管道配置:将抓取到的 Item 统一推入 Redis,便于集中归档或清洗
ITEM_PIPELINES = {
    "scrapy_redis.pipelines.RedisPipeline": 300,
    # 如果本地还需要保存到数据库,可追加自定义 Pipeline,例如:
    # "myproject.pipelines.MongoPipeline": 400,
}

# 7. 并发与限速调节(依据目标站点反爬严格程度与 Worker 硬件调整)
CONCURRENT_REQUESTS = 16
DOWNLOAD_DELAY = 0.5SCHEDULER_PERSIST = True 非常关键。如果设置为 False,当任意一个 Worker 正常退出时,默认会执行清空 Redis 中对应爬虫队列的操作,导致其他正在运行的 Worker 任务被意外截断。
四、任务分发、调度与指纹去重机制
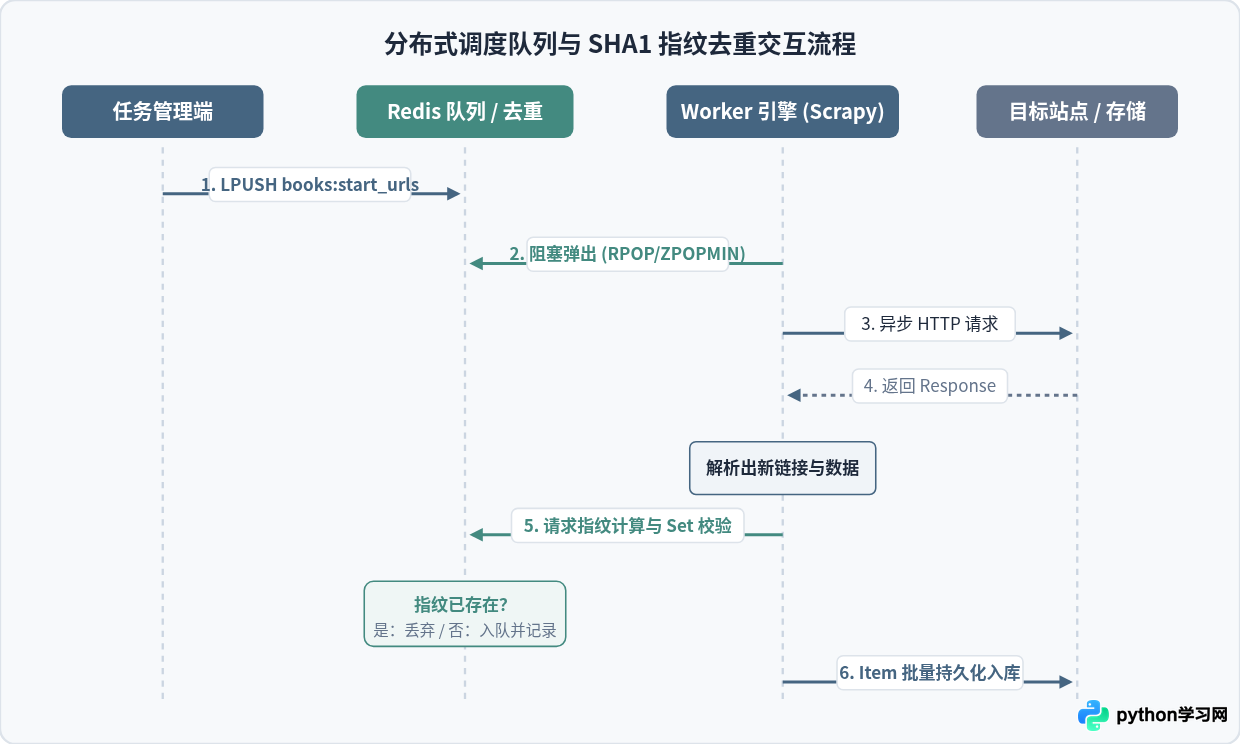
完成代码和配置改造后,各节点的协同工作遵循“启动监听 - 外部投递种子 - 抢占式消费 - 运行时指纹排重”的闭环机制。
1. 启动 Worker 监听
在各爬虫节点的主机上分别执行启动命令。此时由于 Redis 中尚无任务,爬虫将自动挂起,监听 Redis 队列中的新种子:
各 Worker 节点执行命令# 启动分布式爬虫
scrapy crawl distributed_books2024-10-31 07:10:00 [scrapy.utils.log] INFO: Scrapy 2.11.2 started (bot: myproject)
2024-10-31 07:10:00 [scrapy_redis.dupefilter] INFO: Using dupefilter class: scrapy_redis.dupefilter.RFPDupeFilter
2024-10-31 07:10:00 [scrapy_redis.scheduler] INFO: Using scheduler class: scrapy_redis.scheduler.Scheduler
2024-10-31 07:10:00 [distributed_books] INFO: Reading start URLs from redis key 'books:start_urls' (batch size: 16)
2024-10-31 07:10:01 [distributed_books] INFO: Listening for start URLs...2. 灌入起始种子 URL 触发抓取
在任一台可访问 Redis 的终端(如控制端或 CI/CD 调度器)中,通过 lpush 命令向定义的 redis_key 注入种子链接:
# 借助 redis-cli 写入初始抓取入口
redis-cli -h 192.168.1.100 -p 6379 -a "SecurePassword_2024!" lpush books:start_urls "https://books.toscrape.com/"
命令执行后,其中一个空闲 Worker 节点会立即通过原子性出队操作获取该 URL,执行首次页面请求;随后解析出的翻页 URL 与图书详情页 Request 会通过 SHA1 计算请求指纹,去重后写入 Redis 的 distributed_books:requests 优先队列中,被集群内所有 Worker 节点并行认领执行。
五、集群部署、性能调优与稳定性保障
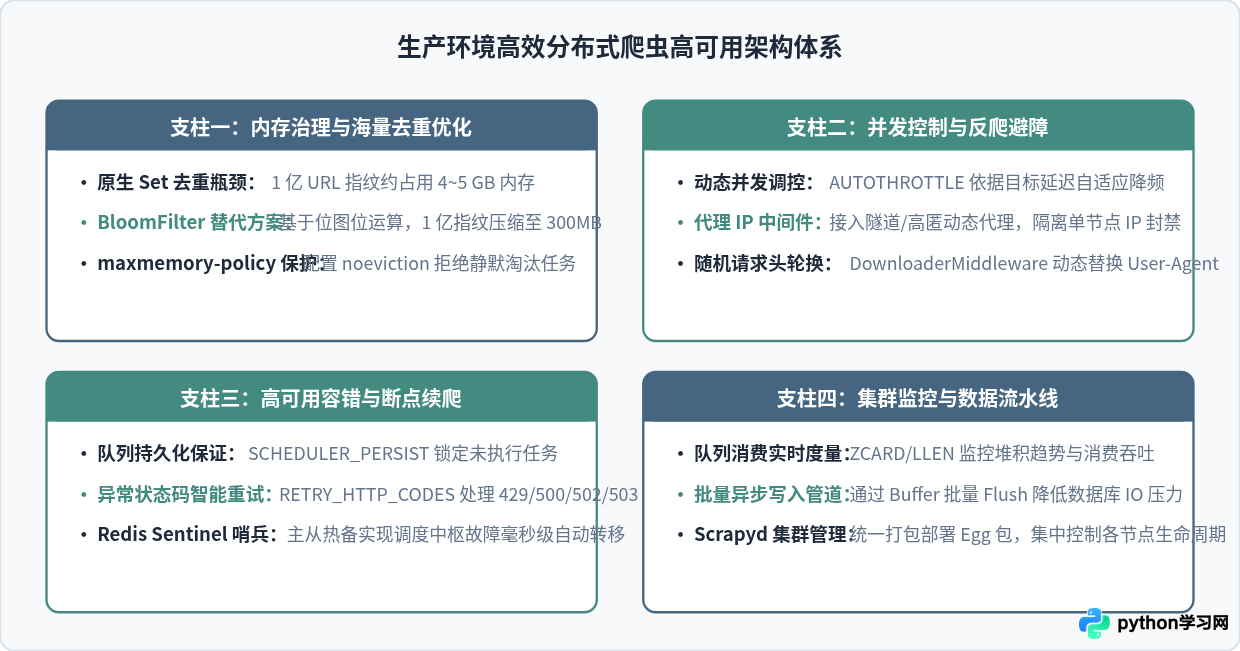
在面对上千万级别的高负载生产抓取任务时,单纯依靠默认配置往往会导致 Redis 内存超限、爬虫被封禁或节点雪崩。必须通过以下四项核心机制建立稳定运行保障:
1. 亿级海量去重:引入布隆过滤器(BloomFilter)
Scrapy-Redis 默认使用 Redis 原生 Set 存储 40 字节的 SHA1 请求指纹。若待抓取目标达到 1 亿个 URL,指纹集合需消耗 4GB 以上的 Redis 昂贵内存。若内存耗尽,Redis 将无法接受新请求。
针对亿级抓取场景,建议引入基于位图的布隆过滤器扩展(例如 scrapy-redis-bloomfilter),在 settings.py 中按如下方式配置:
# 替换为基于 BloomFilter 的去重过滤器
DUPEFILTER_CLASS = "scrapy_redis_bloomfilter.dupefilter.RFPDupeFilter"

# 散列函数个数(通常 6~8 个)与位图大小指数(默认 30,即 2^30 bit 占用 128MB)
BLOOMFILTER_HASH_NUMBER = 6
BLOOMFILTER_BIT = 30
DUPEFILTER_DEBUG = False
通过布隆过滤器,1 亿条 URL 指纹所占内存可压缩至 120MB~300MB,误判率控制在十万分之一以下,大幅降低了硬件成本。
2. 自动限速与异常重试机制
分布式节点并发激增极易触发目标服务器的风控封禁。需在 settings.py 启用智能自适应限速扩展(AutoThrottle):
# 开启 AutoThrottle 自动限速拓展
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 1.0
AUTOTHROTTLE_MAX_DELAY = 10.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 2.0

# 针对常见限流或网关抖动状态码开启重试
RETRY_ENABLED = True
RETRY_TIMES = 3
RETRY_HTTP_CODES = [500, 502, 503, 504, 429]
六、常见部署故障与排查清单
在实际搭建与联调分布式爬虫时,以下三类典型问题最为高发:
| 故障现象 | 诱发原因 | 验证与解决对策 |
|---|---|---|
| 爬虫启动后挂起,无任何请求输出 | 1. Spider 未正确从 RedisSpider 继承;2. Redis 对应 redis_key 尚无种子链接;3. 节点网络防火墙阻断了 6379 端口。 |
检查爬虫定义中的 redis_key 名称与推送命令是否完全一致;在 Worker 节点直接运行 redis-cli -h <ip> lrange books:start_urls 0 -1 核实队列是否存在数据。 |
| 爬虫停止后 Redis 队列被清空 | 未设置 SCHEDULER_PERSIST = True,或 Worker 在捕获到 SIGINT 退出信号时默认执行了清理。 |
在 settings.py 中明确声明 SCHEDULER_PERSIST = True,断点续爬时切勿使用 redis-cli flushall。 |
| Redis 报 OOM 错误且任务中断 | Redis 实例内存达到上限,且配置了 maxmemory-policy noeviction 导致写操作被拒绝。 |
评估去重集规模,改用布隆过滤器;检查爬虫是否因爬取死循环产生了无限递增的无意义 Request。 |
通过以上规范化的架构改造与参数配置,Scrapy 原生单机爬虫能够平滑演进为具备弹性扩缩容、断点续爬与千万级去重能力的高效分布式抓取系统。在实际工程落地中,结合 Scrapyd 进行集群代码版本发布,并配合 Redis 监控看板,即可搭建起稳健可靠的数据采集基础设施。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















